Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
JPA/JPQL一对多关联数据高效投影与聚合策略_创想鸟

JPA/JPQL一对多关联数据高效投影与聚合策略

JPA/JPQL一对多关联数据高效投影与聚合策略-1

本文探讨了在JPA/JPQL中处理一对多关联数据投影时的性能瓶颈,特别是当需要将子实体ID聚合为集合时。针对JPQL缺乏类似Oracle collect()函数的聚合能力,提出了一种高效的解决方案:通过JPQL查询返回扁平化的Tuple结果,然后利用Java流API(特别是并行流)在内存中进行高效的分组和聚合,从而显著提升数据映射和处理的性能。

JPA/JPQL复杂投影的挑战

在使用jpa/jpql进行数据查询时,将结果直接投影到自定义的dto(data transfer object)是一种常见的优化手段,可以避免加载整个实体对象,只获取所需字段,从而减少内存消耗和网络传输。然而,当涉及一对多关系,并且需要在父dto中包含子实体某个字段的集合时,传统的投影方式或直接在jpql中实现类似sql collect()的聚合功能会遇到挑战。

例如,我们可能需要一个包含父实体ID、名称以及其所有子实体ID集合的DTO:

class ParentDTO {   String id;   String name;   Collection childIds; // 期望聚合的子ID集合   public ParentDTO(String id, String name, Collection childIds) {       this.id = id;       this.name = name;       this.childIds = childIds;   }   // Getters}

在JPQL中,虽然可以通过SELECT NEW com.example.ParentDTO(p.id, p.name, c.id)进行投影,但这种方式通常会为每个子实体生成一行记录,导致父实体信息重复,并且无法直接聚合c.id为一个Collection。若要实现聚合,数据库层面的COLLECT()函数(如Oracle)在JPQL中没有直接的等价物。如果尝试通过复杂的关联查询和框架自动映射,可能会导致:

性能瓶颈: 框架在处理大量重复数据和复杂映射时消耗大量CPU和时间。数据冗余: 查询结果包含大量重复的父实体数据。内存开销: 不必要的字段或整个实体被加载。

优化策略:JPQL Tuple投影与Java内存聚合

为了解决上述问题,一种高效的策略是:首先利用JPQL查询获取扁平化的、仅包含必要字段的Tuple结果,然后将数据加载到内存中,利用Java 8及更高版本提供的流(Stream)API进行高效的分组和聚合。

1. JPQL查询:选择必要的扁平化数据

在JPQL查询阶段,我们不尝试在数据库层面进行复杂的集合聚合,而是选择父实体的主键、名称以及所有关联子实体的主键。这将返回一个扁平化的结果集,其中每一行代表一个父实体与一个子实体的关联。

假设我们有两个实体Parent和Child,Parent与Child之间是一对多关系:

// Parent.java@Entitypublic class Parent {    @Id    private String id;    private String name;    @OneToMany(mappedBy = "parent")    private Set children = new HashSet();    // Getters and Setters}// Child.java@Entitypublic class Child {    @Id    private String id;    private String value;    @ManyToOne    @JoinColumn(name = "parent_id")    private Parent parent;    // Getters and Setters}

我们的JPQL查询可以这样编写:

// 查询父实体ID、名称以及其关联子实体的IDString jpql = "SELECT p.id, p.name, c.id FROM Parent p JOIN p.children c ORDER BY p.id";// 执行查询并获取List// Tuple是JPA 2.0引入的接口,用于表示查询结果中的一行数据,// 可以通过索引或别名访问字段。List resultTuples = entityManager.createQuery(jpql, Tuple.class).getResultList();

通过Tuple投影,我们避免了JPA框架自动映射到复杂实体对象的开销,只获取了最原始、最需要的数据。

2. Java内存聚合:利用Stream API构建DTO

获取到List后,我们可以在Java应用程序内存中,使用Stream API的Collectors.groupingBy方法对数据进行分组和聚合,从而构建出所需的ParentDTO集合。

import javax.persistence.Tuple;import java.util.Collection;import java.util.List;import java.util.Map;import java.util.Set;import java.util.stream.Collectors;public class DataAggregator {    public static Collection aggregateToParentDTOs(List resultTuples) {        // 使用Collectors.groupingBy按父实体ID分组        Map parentDTOMap = resultTuples.stream()            .collect(Collectors.groupingBy(                tuple -> tuple.get(0, String.class), // 以父ID作为分组键                Collectors.reducing(                    // 初始值:创建一个新的ParentDTO,包含父ID和名称,子ID集合为空                    null, // 初始值可以为null,因为reducing的accumulator会处理                    tuple -> {                        String parentId = tuple.get(0, String.class);                        String parentName = tuple.get(1, String.class);                        String childId = tuple.get(2, String.class);                        ParentDTO dto = new ParentDTO(parentId, parentName, new java.util.ArrayList());                        if (childId != null) {                            dto.getChildIds().add(childId);                        }                        return dto;                    },                    // 合并器:合并两个ParentDTO,将子ID集合合并                    (dto1, dto2) -> {                        if (dto1 == null) return dto2; // 处理reducing的初始null值                        if (dto2 == null) return dto1;                        dto1.getChildIds().addAll(dto2.getChildIds());                        return dto1;                    }                )            ));        // 如果需要,可以进一步优化,避免在reducing中创建过多DTO实例,        // 而是先收集所有子ID,再统一构建DTO。        // 更简洁且推荐的方式:        Map<String, List> groupedByParentId = resultTuples.stream()            .collect(Collectors.groupingBy(tuple -> tuple.get(0, String.class)));        return groupedByParentId.entrySet().stream()            .map(entry -> {                String parentId = entry.getKey();                List tuplesForParent = entry.getValue();                // 假设同一父ID下的所有tuple的parentName相同                String parentName = tuplesForParent.get(0).get(1, String.class);                Set childIds = tuplesForParent.stream()                    .map(tuple -> tuple.get(2, String.class))                    .collect(Collectors.toSet()); // 使用Set避免重复,如果需要List则改为toList()                return new ParentDTO(parentId, parentName, new java.util.ArrayList(childIds));            })            .collect(Collectors.toList());    }    // ParentDTO 定义    static class ParentDTO {        String id;        String name;        Collection childIds;        public ParentDTO(String id, String name, Collection childIds) {            this.id = id;            this.name = name;            this.childIds = childIds;        }        public String getId() { return id; }        public String getName() { return name; }        public Collection getChildIds() { return childIds; }        @Override        public String toString() {            return "ParentDTO{" +                   "id='" + id + ''' +                   ", name='" + name + ''' +                   ", childIds=" + childIds +                   '}';        }    }}

在上述代码中,我们首先通过Collectors.groupingBy将扁平化的Tuple列表按照父实体ID进行分组。然后,对于每个父实体ID的分组,我们再次使用流操作提取所有子实体ID,并将其收集到一个Set(或List)中,最终构建出ParentDTO实例。

并行流(Parallel Stream)的考量:

对于非常大的数据集,可以考虑使用并行流resultTuples.parallelStream()来进一步提升聚合性能。并行流会自动将任务分解为多个子任务并在多个CPU核心上并行执行,但需要注意并行流的开销和线程安全问题。在实际应用中,应根据数据量和CPU资源进行测试和权衡。

性能优势与注意事项

这种“JPQL查询扁平数据 + Java内存聚合”的策略带来了显著的性能提升:

减少数据库负担: 数据库只负责简单的关联查询和数据提取,避免了复杂的聚合计算。优化数据传输: 只传输所需字段的原始数据,减少网络带宽消耗。提升映射效率: 将复杂的映射逻辑从框架的通用映射器转移到Java代码中,利用Java Stream API的高效处理能力,尤其在处理大量数据时,性能优势更为明显。灵活性: 可以在Java代码中灵活地进行数据转换和聚合,不受JPQL语法的限制。

注意事项:

内存消耗: 将所有相关数据加载到内存中进行聚合,对于极大规模的数据集(例如,数百万甚至上亿条记录)可能会导致内存溢出(OutOfMemoryError)。在这种情况下,需要考虑分批处理、游标查询或在数据库层面进行更细粒度的聚合。CPU开销: 内存聚合会消耗CPU资源,尤其是在使用并行流时。应监控CPU使用率,确保系统资源充足。数据一致性: 在查询和聚合过程中,如果底层数据发生变化,可能会导致不一致。对于对实时性要求极高的数据,可能需要更复杂的事务或缓存策略。

总结

当JPQL无法直接提供复杂的集合聚合功能,或直接投影导致性能瓶颈时,将JPQL查询结果扁平化为Tuple,然后在Java应用程序内存中利用Stream API进行高效的分组和聚合,是一种非常有效的优化策略。这种方法将数据处理的重心从数据库转移到应用层,充分利用了Java的强大处理能力,在许多场景下能够显著提升数据查询和映射的性能,是处理一对多关联数据投影的推荐实践。

以上就是JPA/JPQL一对多关联数据高效投影与聚合策略的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/119105.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
composer如何强制重新安装所有依赖包
上一篇 2025年11月30日 01:41:14
教你Windows7系统怎么设置共享打印机
下一篇 2025年11月30日 01:44:17

相关推荐

  • Java并发编程中Runnable接口使用方法

    Runnable接口用于定义线程任务,通过实现run()方法封装执行逻辑,不返回结果且不能抛出受检异常;可直接传给Thread实例启动线程,也可用Lambda表达式简化代码;推荐结合ExecutorService线程池使用,提升资源利用率;需注意无返回值、异常处理在内部完成、共享变量线程安全等问题。…

    2026年9月22日
    000
  • MySQL中如何使用存储过程提高业务逻辑复用_示例讲解?

    MySQL中如何使用存储过程提高业务逻辑复用_示例讲解?MySQL中如何使用存储过程提高业务逻辑复用_示例讲解?MySQL中如何使用存储过程提高业务逻辑复用_示例讲解?MySQL中如何使用存储过程提高业务逻辑复用_示例讲解?

    存储过程在 mysql 中用于封装业务逻辑,提升复用性并减少网络传输。它是一组预定义的 sql 语句集合,通过参数调用实现功能,如查询订单及计算消费总额。其优点包括提高执行效率、统一数据操作逻辑、增强安全性和便于维护。例如,输入客户 id 即可返回订单信息与总消费金额。优化方式有:1. 使用 out…

    2026年9月22日 用户投稿
    100
  • VSCode配置C++项目环境 新手必看VSCode搭建C++教程

    答案:在VSCode中配置C++环境需安装MinGW-w64编译器并将其路径加入系统环境变量,安装VSCode的C/C++扩展以支持代码补全和调试,通过tasks.json配置编译任务,指定g++路径及编译参数,再通过launch.json配置调试任务,设置gdb调试器路径和程序输出路径,确保头文件…

    2026年9月22日
    200
  • 如何使用DeepSpeed训练AI大模型?大规模模型训练的优化技巧

    DeepSpeed通过ZeRO等技术突破显存限制,实现大模型高效训练。它采用ZeRO-1/2/3分级优化,分别对优化器状态、梯度和参数进行分区,显著降低单卡显存占用;结合混合精度、梯度累积和CPU/NVMe卸载进一步节省资源。同时集成流水线并行与张量并行,支持多维并行策略协同,使万亿参数模型训练在普…

    2026年9月22日
    000
  • PHP 表单验证:确保 HTML select 下拉菜单已正确选择非默认选项

    本文将详细介绍如何在 PHP 后端对 HTML select 下拉菜单进行有效验证,确保用户选择了非默认选项。我们将探讨常见的验证误区,并提供一个简洁高效的解决方案,通过检查 $_POST 数据来判断用户是否已做出有效选择,从而避免表单提交无效数据,提升用户体验和数据准确性。 在构建 web 表单时…

    2026年9月22日
    200
  • python 基准测试(cProfile kcachegrind line_profiler memory_profiler)

    learn from 《python高性能(第2版)》 类似工具:pycharm profile对函数调用效率进行测试 1. 例子 一个圆周运动的动画 代码语言:javascript代码运行次数:0运行复制 from matplotlib import pyplot as pltfrom matpl…

    2026年9月22日
    200
  • 360浏览器怎么禁止网页自动刷新_360浏览器阻止页面定时刷新设置方法

    1、通过360浏览器开发者工具删除含http-equiv=”refresh”的meta标签可临时阻止刷新;2、启用弹窗拦截功能可屏蔽由脚本触发的自动刷新;3、使用无痕模式浏览可限制脚本运行,避免页面刷新;4、安装“Tampermonkey”等扩展并添加屏蔽规则可实现长期有效阻…

    2026年9月22日
    400
  • 在Java中如何通过Stream实现交集与差集

    交集可通过filter结合contains获取两集合共有元素,差集则保留一个集合中不在另一集合的元素,示例使用list1.stream().filter(list2::contains)得[3,4],filter(e->!list2.contains(e))得[1,2],建议将list2转为H…

    2026年9月22日
    000
  • Java Swing中按钮与文本框事件处理的实践指南

    本文将深入探讨Java Swing中ActionListener的正确使用方法,指导开发者如何为GUI按钮和文本框实现事件监听,从而处理用户输入、执行计算并实时更新界面。文章将重点讲解如何在actionPerformed方法中获取用户输入、进行类型转换、处理潜在异常,并提供一个完整的计算器示例来演示…

    2026年9月22日
    200
  • MySQL查询缓存配置及性能_MySQL重复查询响应速度提升

    MySQL查询缓存配置及性能_MySQL重复查询响应速度提升MySQL查询缓存配置及性能_MySQL重复查询响应速度提升MySQL查询缓存配置及性能_MySQL重复查询响应速度提升MySQL查询缓存配置及性能_MySQL重复查询响应速度提升

    mysql查询缓存已不适用于现代应用场景,尤其在8.0版本中被彻底移除。它仅适合读多写少、数据几乎不变的静态查询,通过内存直接返回结果提升性能;但在数据频繁更新时,因基于表级的缓存失效机制,每次写操作都会清空相关缓存,导致频繁重建缓存并消耗大量cpu资源,形成性能瓶颈。此外,sql语句匹配严格、内存…

    2026年9月22日 用户投稿
    400
  • 使用MockWebServer对FeignClient进行单元测试

    本文详细阐述了如何利用Spring Cloud LoadBalancer和MockWebServer对FeignClient进行高效单元测试。通过在测试配置中动态注册MockWebServer实例,并将其作为FeignClient的服务发现目标,开发者可以精确模拟后端API的行为,包括各种HTTP响…

    2026年9月22日
    000
  • Linux系统中文件属性和权限实战操作

    Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作

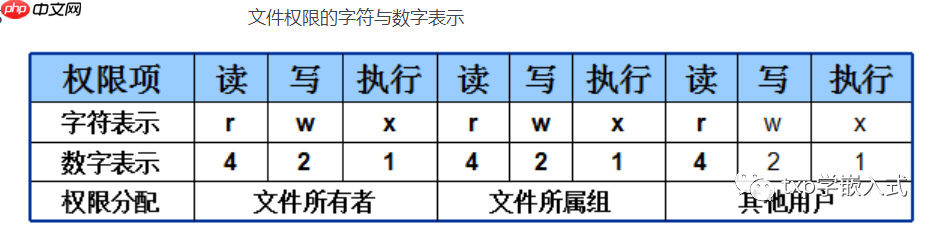
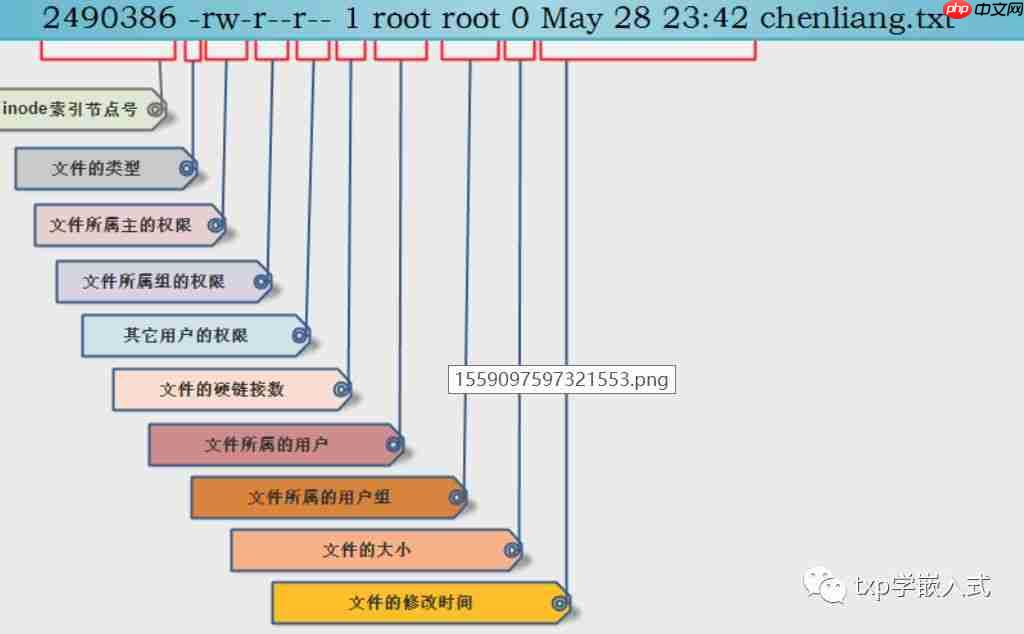
    —–原本今天的文章是昨天晚上就要更新的,但是由于昨天晚上下班回到住的地方,发现停电了,所以就没写成。今天是在上一篇文章–linux系统中文件类型的基础上,继续进行深入的学习。好了,直接开干。 一、文件的操作权限: 1、在这之前我想还是很有必要介绍对文件的操作权限(…

    2026年9月22日 用户投稿
    300
  • PHP中为数组元素设置默认值的最佳实践:使用Null合并运算符

    本教程将介绍如何在PHP中为数组元素设置默认值,尤其当源数据可能为空或缺失时。通过利用PHP 7+提供的Null合并运算符(??),可以简洁高效地实现这一需求,避免冗长的条件判断,提高代码可读性和健壮性。 引言:处理缺失或空值时的数组赋值 在Web开发中,我们经常需要从用户请求、数据库查询或其他外部…

    2026年9月22日
    000
  • Laravel 8 登录后重定向至仪表盘的策略与实践

    本教程详细阐述了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种策略。我们将探讨如何通过配置 LoginController 的 $redirectTo 属性、利用 RouteServiceProvider 定义常量以及在自定义登录方法中进行精确控制来管理重定向流程。文章还涵盖了相关中间…

    2026年9月22日
    000
  • Java中异常处理与方法返回值结合

    异常发生时不应返回默认值,而应通过抛出异常或使用Optional、自定义结果类等方式明确传递错误信息,确保调用方能正确处理失败情况,提升代码健壮性与可读性。 在Java中,异常处理与方法返回值的结合是一个常见的编程问题。理解它们之间的关系有助于写出更健壮、可读性更强的代码。当一个方法可能发生异常时,…

    2026年9月22日
    000
  • PHP如何利用缓存优化实时输出_PHP实时输出与缓存结合优化

    PHP实时输出需结合输出缓冲控制与flush()强制推送,同时考虑服务器和浏览器缓存影响;2. 长时间任务应使用APCu或Redis缓存频繁数据,避免重复计算;3. 动态页面可采用分块输出与片段缓存策略,静态内容从缓存读取,动态部分边生成边输出;4. 更优方案是通过异步任务与Redis存储进度,前端…

    2026年9月22日
    000
  • 递归实现列表排序检查与条件移除最大值

    本文详细介绍了如何使用Java递归方法处理整数列表。核心内容包括:首先检查列表是否已排序,如果已排序则直接返回false;如果未排序,则查找列表中的最大值。仅当最大值位于列表的起始或结束位置时,才将其移除并递归地继续处理列表。如果最大值位于列表中间,则打印当前列表并终止递归。 在数据处理和算法设计中…

    2026年9月22日
    000
  • UC浏览器为什么无法登录某些网站账号_UC浏览器部分网站无法登录原因及对策

    首先关闭广告过滤功能,清除缓存与Cookie,关闭云端加速,切换网络或DNS,最后尝试桌面模式或其他浏览器解决UC浏览器登录无响应问题。 如果您尝试在UC浏览器中登录某个网站账号,但页面无响应或提示错误,则可能是由于浏览器的安全策略、缓存问题或设置限制导致无法正常加载登录界面。以下是解决此问题的步骤…

    2026年9月22日
    100
  • 优化Spring Boot应用:构建高效通用的DTO与实体映射服务

    本文旨在解决Spring Boot项目中DTO与实体间重复映射的痛点。通过引入一个基于泛型的抽象服务层,结合ModelMapper工具,我们展示了如何构建一个类型安全、可重用的通用映射机制。此方案显著减少了样板代码,提升了代码的可维护性和开发效率,避免了手动类型转换的繁琐与潜在错误。 在构建基于sp…

    2026年9月22日
    100
  • Java中递归处理列表:条件性移除最大值策略与实现

    本教程深入探讨了如何在Java中使用递归方法,根据特定条件(如列表是否已排序、最大值是否位于列表的首尾)来移除列表中的最大值。文章将详细阐述如何设计一个高效的递归算法,包括排序检查、最大值定位以及条件性移除的实现细节,并提供完整的代码示例和注意事项,帮助读者掌握递归在复杂列表操作中的应用。 引言:递…

    2026年9月22日
    000

发表回复

登录后才能评论
关注微信