Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
掌握 Python 并发编程:利用先进技术提升性能_创想鸟

掌握 Python 并发编程:利用先进技术提升性能

掌握 python 并发编程:利用先进技术提升性能

python 的并发编程能力已经显着发展,为开发人员提供了编写高效、并行代码的强大工具。我花了相当多的时间探索这些先进技术,很高兴与您分享我的见解。

使用 asyncio 进行异步编程是 i/o 密集型任务的游戏规则改变者。它允许我们编写非阻塞代码,可以同时处理多个操作,而无需线程开销。下面是一个简单的示例,说明如何使用 asyncio 同时从多个 url 获取数据:

import asyncioimport aiohttpasync def fetch_url(session, url):    async with session.get(url) as response:        return await response.text()async def main():    urls = ['http://example.com', 'http://example.org', 'http://example.net']    async with aiohttp.clientsession() as session:        tasks = [fetch_url(session, url) for url in urls]        results = await asyncio.gather(*tasks)        for url, result in zip(urls, results):            print(f"content length of {url}: {len(result)}")asyncio.run(main())

这段代码演示了我们如何创建多个协程来同时从不同的 url 获取数据。 asyncio.gather() 函数允许我们等待所有协程完成并收集它们的结果。

虽然 asyncio 非常适合 i/o 密集型任务,但它不适合 cpu 密集型操作。为此,我们转向concurrent.futures模块,它提供了threadpoolexecutor和processpoolexecutor。 threadpoolexecutor 非常适合不释放 gil 的 i/o 密集型任务,而 processpoolexecutor 非常适合 cpu 密集型任务。

下面是使用 threadpoolexecutor 并发下载多个文件的示例:

import concurrent.futuresimport requestsdef download_file(url):    response = requests.get(url)    filename = url.split('/')[-1]    with open(filename, 'wb') as f:        f.write(response.content)    return f"downloaded {filename}"urls = [    'https://example.com/file1.pdf',    'https://example.com/file2.pdf',    'https://example.com/file3.pdf']with concurrent.futures.threadpoolexecutor(max_workers=3) as executor:    future_to_url = {executor.submit(download_file, url): url for url in urls}    for future in concurrent.futures.as_completed(future_to_url):        url = future_to_url[future]        try:            data = future.result()        except exception as exc:            print(f"{url} generated an exception: {exc}")        else:            print(data)

此代码创建一个包含三个工作线程的线程池,并为每个 url 提交一个下载任务。 as_completed() 函数允许我们在结果可用时对其进行处理,而不是等待所有任务完成。

立即学习“Python免费学习笔记(深入)”;

对于 cpu 密集型任务,我们可以使用 processpoolexecutor 来利用多个 cpu 核心。这是并行计算素数的示例:

import concurrent.futuresimport mathdef is_prime(n):    if n < 2:        return false    for i in range(2, int(math.sqrt(n)) + 1):        if n % i == 0:            return false    return truedef find_primes(start, end):    return [n for n in range(start, end) if is_prime(n)]ranges = [(1, 25000), (25001, 50000), (50001, 75000), (75001, 100000)]with concurrent.futures.processpoolexecutor() as executor:    results = executor.map(lambda r: find_primes(*r), ranges)all_primes = [prime for sublist in results for prime in sublist]print(f"found {len(all_primes)} prime numbers")

此代码将查找素数的任务分为四个范围,并使用单独的 python 进程并行处理它们。 map() 函数将 find_primes() 函数应用于每个范围并收集结果。

当使用多个进程时,我们经常需要在它们之间共享数据。多处理模块为此提供了多种选项,包括共享内存和队列。这是使用共享内存数组的示例:

from multiprocessing import process, arrayimport numpy as npdef worker(shared_array, start, end):    for i in range(start, end):        shared_array[i] = i * iif __name__ == '__main__':    size = 10000000    shared_array = array('d', size)    # create 4 processes    processes = []    chunk_size = size // 4    for i in range(4):        start = i * chunk_size        end = start + chunk_size if i < 3 else size        p = process(target=worker, args=(shared_array, start, end))        processes.append(p)        p.start()    # wait for all processes to finish    for p in processes:        p.join()    # convert shared array to numpy array for easy manipulation    np_array = np.frombuffer(shared_array.get_obj())    print(f"sum of squares: {np_array.sum()}")

此代码创建一个共享内存数组,并使用四个进程并行计算数字的平方。共享数组允许所有进程写入相同的内存空间,避免了进程间通信的需要。

虽然这些技术很强大,但它们也面临着一系列挑战。竞争条件、死锁和过多的上下文切换都会影响性能和正确性。仔细设计并发代码并在必要时使用适当的同步原语至关重要。

例如,当多个线程或进程需要访问共享资源时,我们可以使用lock来保证线程安全:

from threading import lock, threadclass counter:    def __init__(self):        self.count = 0        self.lock = lock()    def increment(self):        with self.lock:            self.count += 1def worker(counter, num_increments):    for _ in range(num_increments):        counter.increment()counter = counter()threads = []for _ in range(10):    t = thread(target=worker, args=(counter, 100000))    threads.append(t)    t.start()for t in threads:    t.join()print(f"final count: {counter.count}")

此代码演示了当多个线程同时递增共享计数器时,如何使用锁来保护共享计数器免受竞争条件的影响。

另一种先进技术是使用信号量来控制对有限资源的访问。下面是限制并发网络连接数的示例:

import asyncioimport aiohttpfrom asyncio import semaphoreasync def fetch_url(url, semaphore):    async with semaphore:        async with aiohttp.clientsession() as session:            async with session.get(url) as response:                return await response.text()async def main():    urls = [f'http://example.com/{i}' for i in range(100)]    semaphore = semaphore(10)  # limit to 10 concurrent connections    tasks = [fetch_url(url, semaphore) for url in urls]    results = await asyncio.gather(*tasks)    print(f"fetched {len(results)} urls")asyncio.run(main())

此代码使用信号量将并发网络连接数限制为 10,防止网络或服务器不堪重负。

使用并发代码时,正确处理异常也很重要。 asyncio 模块为 asyncio.gather() 函数提供了一个 return_exceptions 参数,该参数对此很有用:

import asyncioasync def risky_operation(i):    if i % 2 == 0:        raise valueerror(f"even number not allowed: {i}")    await asyncio.sleep(1)    return iasync def main():    tasks = [risky_operation(i) for i in range(10)]    results = await asyncio.gather(*tasks, return_exceptions=true)    for result in results:        if isinstance(result, exception):            print(f"got an exception: {result}")        else:            print(f"got a result: {result}")asyncio.run(main())

此代码演示了如何在不停止其他任务执行的情况下处理并发任务中的异常。

随着我们深入研究并发编程,我们会遇到更高级的概念,例如事件循环和协程链。这是一个演示如何链接协程的示例:

import asyncioasync def fetch_data(url):    print(f"fetching data from {url}")    await asyncio.sleep(2)  # simulate network delay    return f"data from {url}"async def process_data(data):    print(f"processing {data}")    await asyncio.sleep(1)  # simulate processing time    return f"processed {data}"async def save_result(result):    print(f"saving {result}")    await asyncio.sleep(0.5)  # simulate saving delay    return f"saved {result}"async def fetch_process_save(url):    data = await fetch_data(url)    processed = await process_data(data)    return await save_result(processed)async def main():    urls = ['http://example.com', 'http://example.org', 'http://example.net']    tasks = [fetch_process_save(url) for url in urls]    results = await asyncio.gather(*tasks)    for result in results:        print(result)asyncio.run(main())

此代码链接了三个协程(fetch_data、process_data 和 save_result),为每个 url 创建一个管道。然后 asyncio.gather() 函数同时运行这些管道。

在处理长时间运行的任务时,通常需要实现取消和超时机制。这是一个演示两者的示例:

import asyncioasync def long_running_task(n):    print(f"Starting long task {n}")    try:        await asyncio.sleep(10)        print(f"Task {n} completed")        return n    except asyncio.CancelledError:        print(f"Task {n} was cancelled")        raiseasync def main():    tasks = [long_running_task(i) for i in range(5)]    try:        results = await asyncio.wait_for(asyncio.gather(*tasks), timeout=5)    except asyncio.TimeoutError:        print("Operation timed out, cancelling remaining tasks")        for task in tasks:            task.cancel()        # Wait for all tasks to finish (they'll raise CancelledError)        await asyncio.gather(*tasks, return_exceptions=True)    else:        print(f"All tasks completed successfully: {results}")asyncio.run(main())

此代码启动五个长时间运行的任务,但设置所有任务的超时时间为 5 秒才能完成。如果达到超时,则会取消所有剩余任务。

总之,python 的并发编程功能为编写高效的并行代码提供了广泛的工具和技术。从使用 asyncio 的异步编程到 cpu 密集型任务的多处理,这些先进技术可以显着提高应用程序的性能。然而,了解基本概念、为每项任务选择正确的工具以及仔细管理共享资源和潜在的竞争条件至关重要。通过实践和精心设计,我们可以利用 python 中并发编程的全部功能来构建快速、可扩展且响应迅速的应用程序。

我们的创作

一定要看看我们的创作:

投资者中心 | 智能生活 | 时代与回声 | 令人费解的谜团 | 印度教 | 精英开发 | js学校

我们在媒体上

科技考拉洞察 | 时代与回响世界 | 投资者中央媒体 | 令人费解的谜团 | 科学与时代媒介 | 现代印度教

以上就是掌握 Python 并发编程:利用先进技术提升性能的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1354741.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
ChatsAPI — 世界上最快的人工智能代理框架
上一篇 2025年12月13日 18:46:12
使用 Python 请求模块使 HTTP 变得简单
下一篇 2025年12月13日 18:46:19

相关推荐

  • sublime怎么设置字体大小和样式_Sublime字体大小及样式配置方法

    sublime怎么设置字体大小和样式_Sublime字体大小及样式配置方法sublime怎么设置字体大小和样式_Sublime字体大小及样式配置方法sublime怎么设置字体大小和样式_Sublime字体大小及样式配置方法sublime怎么设置字体大小和样式_Sublime字体大小及样式配置方法

    调整Sublime Text字体大小和样式需修改用户设置文件,通过添加或修改font_size和font_face实现个性化配置,保存后实时生效。1. 打开Preferences -> Settings,编辑右侧用户设置;2. 添加”font_size”: 14、&#8…

    2026年9月28日 • 用户投稿
    100
  • Centos7.3环境下安装最新版的Python3.8.4

    Centos7.3环境下安装最新版的Python3.8.4Centos7.3环境下安装最新版的Python3.8.4Centos7.3环境下安装最新版的Python3.8.4Centos7.3环境下安装最新版的Python3.8.4

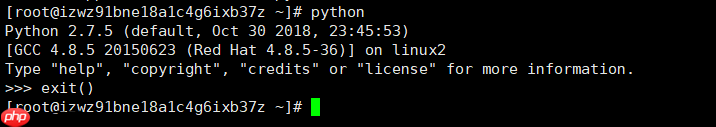
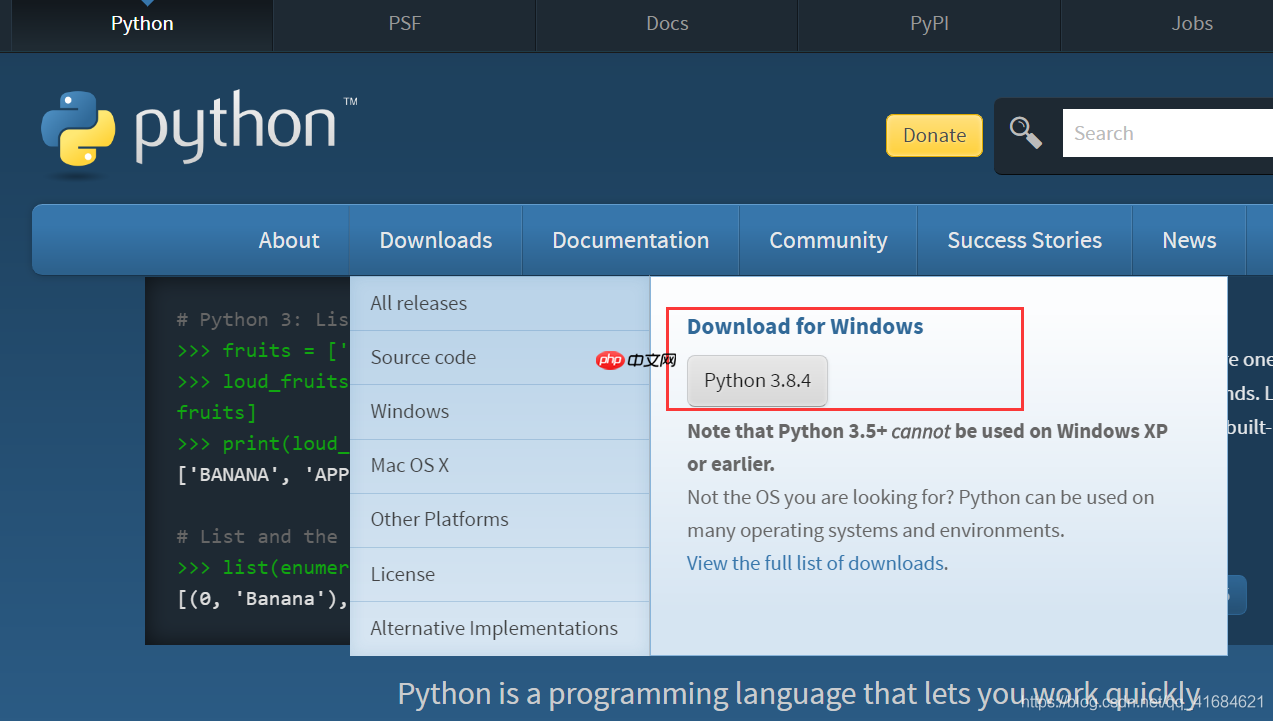
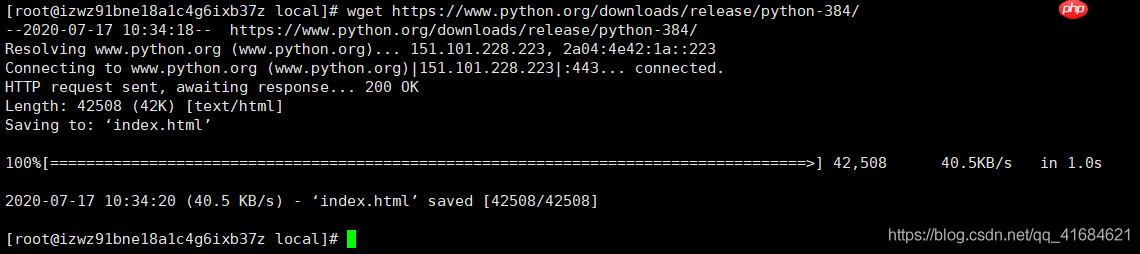
    在centos 7.3环境下安装最新版python 3.8.4的步骤如下: 首先,退出Python命令行的方法包括: 输入exit()并按回车键输入quit()并按回车键直接按Ctrl+Z 接下来,前往Python的官方网站下载Python包。 立即学习“Python免费学习笔记(深入)”; 每个版…

    2026年9月28日 • 用户投稿
    100
  • 如何在mysql中创建外键索引

    创建表时定义外键会自动创建索引,如CREATE TABLE orders含FOREIGN KEY(user_id)则user_id自动索引;2. 已有表添加外键前需先手动建索引,如CREATE INDEX idx_user_id ON orders(user_id),再ALTER TABLE加外键约…

    2026年9月28日
    300
  • 夸克AI最新官方主页地址 夸克AI人工智能助手直达入口链接

    夸克AI最新官方主页地址是https://www.quark.cn/,提供AI搜索、文档处理、云端存储及多端协同服务,支持格式转换、内容生成与智能摘要功能。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 夸克AI最新官方主页地址在哪里?这是…

    2026年9月28日
    000
  • 虚拟机安装以及PCL的配置(1)

    虚拟机安装以及PCL的配置(1)虚拟机安装以及PCL的配置(1)虚拟机安装以及PCL的配置(1)虚拟机安装以及PCL的配置(1)

    在windows系统下安装虚拟机的步骤如下(这些步骤同样适用于在虚拟机中配置ubuntu系统或双系统配置pcl环境): (1) 下载VMware并进行安装(可以通过百度搜索找到多个可供下载的资源)。 (2) 安装步骤: 双击下载的安装文件,按照提示点击“下一步”,无需更改默认安装路径(当然你也可以选…

    2026年9月28日 • 用户投稿
    200
  • 续航一般多久够用?友望洗地机:长续航+强性能,全屋清洁“一劳永逸”

    续航一般多久够用?友望洗地机:长续航+强性能,全屋清洁“一劳永逸”续航一般多久够用?友望洗地机:长续航+强性能,全屋清洁“一劳永逸”续航一般多久够用?友望洗地机:长续航+强性能,全屋清洁“一劳永逸”续航一般多久够用?友望洗地机:长续航+强性能,全屋清洁“一劳永逸”

    在家庭清洁场景中,洗地机凭借高效省力的特点,正逐步成为现代家庭的清洁“主力军”。然而面对琳琅满目的产品型号,消费者仍有不少疑问:洗地机究竟适合多大面积的空间?选购时应重点关注哪些功能?续航时间多久才够用?今天,我们将从真实用户需求出发,结合友望最新推出的大头pro洗地机,深入解析这些常见问题。 一、…

    2026年9月28日 • 用户投稿
    200
  • 如何在 Android 中保存动态创建的复选框状态

    如何在 Android 中保存动态创建的复选框状态如何在 Android 中保存动态创建的复选框状态如何在 Android 中保存动态创建的复选框状态如何在 Android 中保存动态创建的复选框状态

    本文介绍了如何在 Android 应用中保存动态创建的复选框的状态,以便用户在重新打开应用或界面后,复选框的选中状态能够保持不变。我们将探讨使用 SharedPreferences 来持久化复选框状态的方法,并提供示例代码帮助你理解和实现。 使用 SharedPreferences 持久化复选框状态…

    2026年9月28日 • 用户投稿
    000
  • 如何在Android中保存动态创建的CheckBox的状态

    如何在Android中保存动态创建的CheckBox的状态如何在Android中保存动态创建的CheckBox的状态如何在Android中保存动态创建的CheckBox的状态如何在Android中保存动态创建的CheckBox的状态

    本文旨在帮助开发者解决在Android应用中动态创建的CheckBox的状态保存问题。通过利用Shared Preferences,我们可以有效地存储CheckBox的选中状态,确保用户在重新进入应用或页面时,CheckBox的状态能够被正确恢复,从而提供更佳的用户体验。本文将提供详细的步骤和示例代…

    2026年9月28日 • 用户投稿
    100
  • 第五代高通骁龙8至尊版正式发布:全球最快移动SoC

    第五代高通骁龙8至尊版正式发布:全球最快移动SoC第五代高通骁龙8至尊版正式发布:全球最快移动SoC第五代高通骁龙8至尊版正式发布:全球最快移动SoC第五代高通骁龙8至尊版正式发布:全球最快移动SoC

    在今日举行的骁龙峰会上,高通正式发布了其最新旗舰移动平台——第五代骁龙 8 至尊版(Snapdragon 8 Elite Gen 5),并宣称该芯片为“全球速度最快的移动 SoC”。 此次发布的芯片基于台积电最新的第三代3nm N3P工艺打造,在CPU架构上采用了全新的Oryon核心设计,延续了2+…

    2026年9月28日 • 用户投稿
    000
  • Perplexity AI比Google好吗 与传统搜索引擎对比

    Perplexity AI比Google好吗 与传统搜索引擎对比Perplexity AI比Google好吗 与传统搜索引擎对比Perplexity AI比Google好吗 与传统搜索引擎对比Perplexity AI比Google好吗 与传统搜索引擎对比

    perplexity ai 的最大优势在于对话式搜索与实时检索的结合,能自然理解提问意图并提供结构化答案,适合快速获取信息;2. google 在全面性、稳定性与权威性方面仍占优势,适合深度调研和查找权威资料;3. 两者使用体验各有侧重,perplexity ai 提升效率,google 保障内容深…

    2026年9月28日 • 用户投稿
    100
  • Java中ArrayList引用传递陷阱:避免数据意外修改的策略

    Java中ArrayList引用传递陷阱:避免数据意外修改的策略Java中ArrayList引用传递陷阱:避免数据意外修改的策略Java中ArrayList引用传递陷阱:避免数据意外修改的策略Java中ArrayList引用传递陷阱:避免数据意外修改的策略

    本文探讨了Java中ArrayList作为引用类型在对象构造时可能导致的数据意外修改问题。当将同一个ArrayList实例传递给多个对象后,对该列表的后续操作(如清空或添加元素)会影响所有引用它的对象。核心解决方案是为每个需要独立数据副本的对象,实例化一个新的ArrayList,从而确保数据隔离和一…

    2026年9月28日 • 用户投稿
    000
  • 豆包AI如何实现图像识别?教你搭建计算机视觉模型

    豆包AI如何实现图像识别?教你搭建计算机视觉模型豆包AI如何实现图像识别?教你搭建计算机视觉模型豆包AI如何实现图像识别?教你搭建计算机视觉模型豆包AI如何实现图像识别?教你搭建计算机视觉模型

    豆包ai本身不直接提供图像识别模型训练功能,但可结合第三方工具实现。1. 准备数据集:收集高质量、多样化的图像并划分训练集与验证集,或使用公开数据集。2. 搭建模型结构:采用迁移学习方法,选用resnet等预训练模型,调整输出层并加入防止过拟合的机制,豆包ai可生成代码框架。3. 训练与调参:设置合…

    2026年9月28日 • 用户投稿
    100
  • 武侠世界起航指南:从萌新到高手的全章节精要攻略

    武侠世界起航指南:从萌新到高手的全章节精要攻略武侠世界起航指南:从萌新到高手的全章节精要攻略武侠世界起航指南:从萌新到高手的全章节精要攻略武侠世界起航指南:从萌新到高手的全章节精要攻略

    踏入江湖的第一步,如何走稳走远?这份深度章节指南助你精准规划,避开弯路,高效解锁绝世武功与隐藏机缘! 第一章:初入江湖 – 筑基破局 核心目标: 击败管家 + 两名教头(新手战力检验) 与张风对话并切磋取胜(开启江湖路) 隐藏门派的钥匙(散人必看): 在朱宇处习得一气功(基础内功)!这是…

    2026年9月28日 • 用户投稿
    000
  • Android动态复选框状态持久化:SharedPreferences实践指南

    Android动态复选框状态持久化:SharedPreferences实践指南Android动态复选框状态持久化:SharedPreferences实践指南Android动态复选框状态持久化:SharedPreferences实践指南Android动态复选框状态持久化:SharedPreferences实践指南

    本教程详细阐述了如何在Android应用中持久化动态创建的复选框状态。通过利用SharedPreferences这一轻量级数据存储机制,我们能够确保用户在勾选或取消勾选动态生成的复选框后,其状态即使在应用重启或Activity重建后也能得以保留。文章将提供具体的代码示例和实现步骤,帮助开发者构建更具…

    2026年9月28日 • 用户投稿
    000
  • 笔尖AI语音识别不灵敏:灵敏度调整与方言适配技巧

    笔尖AI语音识别不灵敏:灵敏度调整与方言适配技巧笔尖AI语音识别不灵敏:灵敏度调整与方言适配技巧笔尖AI语音识别不灵敏:灵敏度调整与方言适配技巧笔尖AI语音识别不灵敏:灵敏度调整与方言适配技巧

    笔尖ai语音识别不灵敏可通过调整灵敏度、优化环境设置、进行方言适配等方式解决。首先,检查设置中的语音识别选项,通过滑块或数值逐步提高或降低灵敏度,根据使用场景选择合适的配置文件,并确保麦克风位置正确或更换高质量麦克风;其次,进行方言适配时,先检查语言设置是否有方言选项,若无则可自定义词汇并建立方言与…

    2026年9月28日 • 用户投稿
    000
  • ChatSonic 创作 SEO 文案?关键词嵌入指令技巧​

    ChatSonic 创作 SEO 文案?关键词嵌入指令技巧​ChatSonic 创作 SEO 文案?关键词嵌入指令技巧​ChatSonic 创作 SEO 文案?关键词嵌入指令技巧​ChatSonic 创作 SEO 文案?关键词嵌入指令技巧​

    要写出高质量、能排名的 seo 文案,不能只依赖 chatsonic,还需掌握关键词嵌入技巧并对内容进行深度加工。1. 明确目标关键词与长尾关键词,专注几个核心词;2. 在 prompt 中明确指定关键词及出现位置,如标题、段首段尾等,但避免堆砌;3. 对生成内容进行润色,使其更自然流畅,并加入个人…

    2026年9月28日 • 用户投稿
    100
  • VSCode如何集成Git版本控制 VSCode中Git操作的便捷技巧

    首先确认git已安装并配置好用户名和邮箱;2. vscode通常自动检测git,若未检测到可手动在设置中指定git.path;3. 在vscode中打开项目并使用内置终端运行git init初始化仓库;4. 通过左侧源代码管理图标暂存、提交和推送更改;5. 遇到提交乱码时将files.encodin…

    2026年9月28日
    200
  • 和豆包一样的ai图片生成工具2025推荐top10

    2025年AI图片生成工具选择多样,boardmix因支持文生图、图生图、AI抠图、多种风格及在线协作,适合初学者与团队使用,且提供免费版,成为易用性高、功能全面的优选之一。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 2025年,想找个…

    2026年9月28日
    000
  • Android RecyclerView优化:通过DiffUtil实现增量更新

    Android RecyclerView优化:通过DiffUtil实现增量更新Android RecyclerView优化:通过DiffUtil实现增量更新Android RecyclerView优化:通过DiffUtil实现增量更新Android RecyclerView优化:通过DiffUtil实现增量更新

    本教程旨在解决RecyclerView在数据更新时(尤其是新增数据)出现的全量刷新和闪烁问题。通过详细介绍Android DiffUtil机制,我们将学习如何高效地进行列表项的增量更新,从而提升用户体验,避免不必要的UI重绘,特别适用于实时聊天等频繁数据变动的场景。 在开发Android应用时,Re…

    2026年9月28日 • 用户投稿
    100
  • sublime怎么配置clangd进行c++代码补全_Clangd插件C++环境配置

    sublime怎么配置clangd进行c++代码补全_Clangd插件C++环境配置sublime怎么配置clangd进行c++代码补全_Clangd插件C++环境配置sublime怎么配置clangd进行c++代码补全_Clangd插件C++环境配置sublime怎么配置clangd进行c++代码补全_Clangd插件C++环境配置

    配置Clangd实现C++智能补全,需安装LSP插件和Clangd服务器,并通过compile_commands.json告知编译信息,从而获得语义级代码补全、实时诊断与重构支持,显著提升Sublime Text的C++开发体验。 在Sublime Text里配置Clangd来搞定C++代码补全,说…

    2026年9月28日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信