快速而肮脏的文档分析:在 Python 中结合 GOT-OCR 和 LLama

让我们探索一种结合ocr和llm技术分析图像的方法。虽然这不是专家级方案,但它源于实际应用中的类似方法,更像是一个便捷的周末项目,而非生产就绪代码。让我们开始吧!

目标:

构建一个简单的管道,用于处理图像(或PDF),利用OCR提取文本,再用LLM分析文本以获取有价值的元数据。这对于文档自动分类、来信分析或智能文档管理系统非常有用。我们将使用一些流行的开源工具,简化流程。

前提:

本文假设您已熟悉Hugging Face Transformers库。如不熟悉,请参考Hugging Face Transformers快速入门。

立即学习“Python免费学习笔记(深入)”;

所需库:

我们将使用torch、transformers、pymupdf和rich库。rich用于提升控制台输出的可读性。

import jsonimport timeimport fitzimport torchfrom transformers import pipeline, AutoModelForCausalLM, AutoTokenizerfrom rich.console import Consoleconsole = Console()

图像准备:

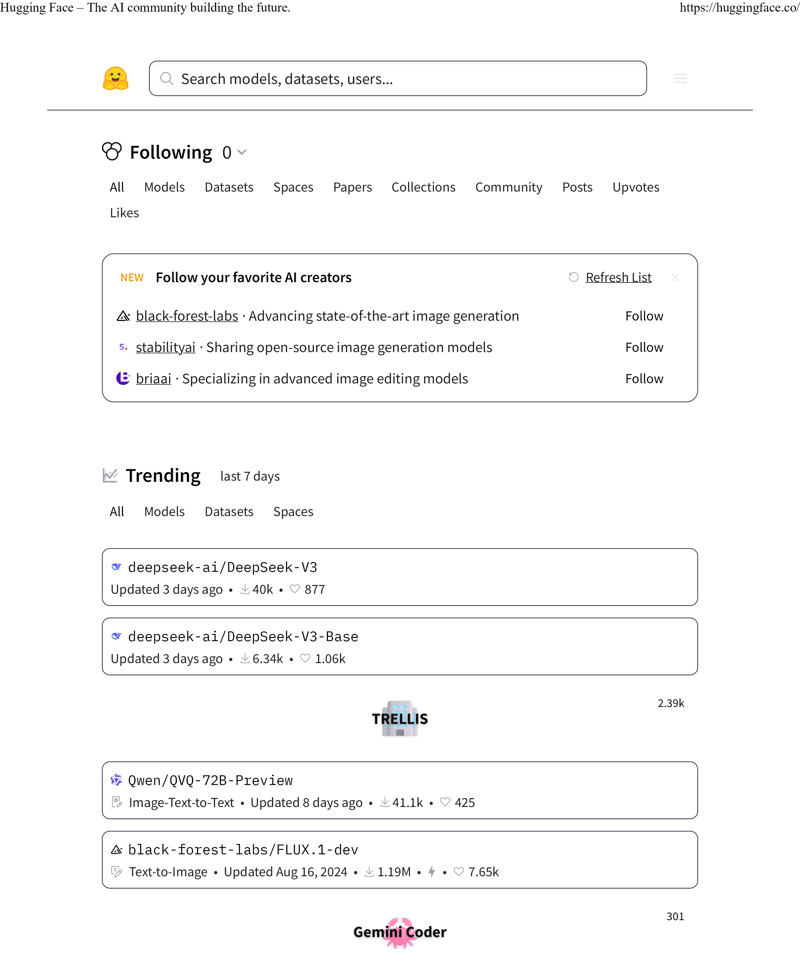
我们将使用Hugging Face官网首页作为测试样本。为了模拟实际应用场景,我们假设输入为PDF,需要将其转换为PNG格式以便模型处理:

input_pdf_file = "./data/ocr_hf_main_page.pdf"output_png_file = "./data/ocr_hf_main_page.png"doc = fitz.open(input_pdf_file)page = doc.load_page(0)pixmap = page.get_pixmap(dpi=300)img = pixmap.tobytes()with console.status("正在将PDF转换为PNG...", spinner="monkey"):    with open(output_png_file, "wb") as f:        f.write(img)
快速而肮脏的文档分析:在 Python 中结合 GOT-OCR 和 LLama

OCR处理:

我测试过多种OCR方案,最终选择ucaslcl/got-ocr2_0 (https://www.php.cn/link/c29568179ca4f6e62552f14d69b810b2) 效果最佳。

tokenizer = AutoTokenizer.from_pretrained(    "ucaslcl/got-ocr2_0",    device_map="cuda",    trust_remote_code=True,)model = AutoModelForCausalLM.from_pretrained(    "ucaslcl/got-ocr2_0",    trust_remote_code=True,    low_cpu_mem_usage=True,    use_safetensors=True,    pad_token_id=tokenizer.eos_token_id,)model = model.eval().cuda()def run_ocr(func: callable, text: str):    start_time = time.time()    res = func()    final_time = time.time() - start_time    console.rule(f"[bold red] {text} [/bold red]")    console.print(res)    console.rule(f"耗时: {final_time:.2f} 秒")    return resresult_text = Nonewith console.status(    "正在进行OCR处理...",    spinner="monkey",):    #  此处需要调整,根据got-ocr2_0的实际接口进行修改    result_text = run_ocr(        lambda: model.generate(            input_ids=tokenizer(output_png_file, return_tensors="pt").input_ids.cuda(),            max_length=512        ),        "纯文本OCR结果",    )

got-ocr2_0支持多种输出格式,包括HTML。 此处展示了纯文本输出示例:

hugging face- the al community building the future.  https: / / hugging face. co/  search models, datasets, users. . .  following 0...

LLM分析:

我们将使用meta-llama/llama-3.2-1b-instruct进行文本分析。 我们将进行文本分类、情感分析等基本操作。

prompt = f"分析以下文档文本,并生成包含以下字段的JSON元数据:标签(tags)、语言(language)、机密性(confidentiality)、优先级(priority)、类别(category)和摘要(summary)。只提供JSON数据,开头为{{,不包含任何解释。 文档文本:{result_text}"model_id = "meta-llama/llama-3.2-1b-instruct"pipe = pipeline(    "text-generation",    model=model_id,    torch_dtype=torch.bfloat16,    device_map="auto",)messages = [    {"role": "system", "content": "你将分析提供的文本并生成JSON输出。"},    {"role": "user", "content": prompt},]with console.status(    "正在使用LLM分析文本...",    spinner="monkey",):    outputs = pipe(        messages,        max_new_tokens=2048,    )result_json_str = outputs[0]["generated_text"].strip()#  移除可能存在的代码块标记if result_json_str.startswith("```json") and result_json_str.endswith("```"):    result_json_str = result_json_str[7:-3].strip()parsed_json = json.loads(result_json_str)with console.status(    "正在保存结果到文件...",    spinner="monkey",):    with open("result.json", "w") as f:        json.dump(parsed_json, f, indent=4)

示例输出:

{  "tags": ["Hugging Face", "AI", "machine learning", "models", "datasets"],  "language": "en",  "confidentiality": "public",  "priority": "normal",  "category": "technology",  "summary": "This text describes Hugging Face, a platform for AI models and datasets."}

总结:

我们构建了一个简单的管道,可以处理PDF,提取文本,并使用LLM进行分析。 这只是一个起点,可以根据实际需求进行扩展,例如添加更完善的错误处理、多页面支持,或尝试不同的LLM模型。 记住,这只是众多方法中的一种,选择最适合您特定用例的方法至关重要。

请注意,代码中部分内容需要根据got-ocr2_0的具体API进行调整。 此外,提示工程的优化可以显著提升LLM的输出质量。

以上就是快速而肮脏的文档分析:在 Python 中结合 GOT-OCR 和 LLama的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1355528.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python 与 SQLite 中的一对多和多对多关系
上一篇 2025年12月13日 19:16:47
__init__py 与 Python 有什么关系?
下一篇 2025年12月13日 19:17:06

相关推荐

  • 大窑“变脸”!国民汽水要被外资拿下了?

    大窑“变脸”!国民汽水要被外资拿下了?大窑“变脸”!国民汽水要被外资拿下了?大窑“变脸”!国民汽水要被外资拿下了?大窑“变脸”!国民汽水要被外资拿下了?

    此前备受关注的大窑或将被外资收购的传闻,近日出现了新的进展。 根据重庆市市场监管局发布的《2025年6月30日-2025年7月6日无条件批准经营者集中案件列表》,KKR收购远景国际股权案已于2025年7月4日完成审批。 公开资料显示,远景国际成立于2024年,注册地为开曼群岛,通过其关联公司在境内从…

    2026年9月29日 • 用户投稿
    000
  • 豆包AI生成商业计划书的技巧 快速梳理创业要点的AI方法

    豆包AI生成商业计划书的技巧 快速梳理创业要点的AI方法豆包AI生成商业计划书的技巧 快速梳理创业要点的AI方法豆包AI生成商业计划书的技巧 快速梳理创业要点的AI方法豆包AI生成商业计划书的技巧 快速梳理创业要点的AI方法

    用豆包ai生成商业计划书的关键在于结构引导与内容优化。首先明确核心内容结构,先提问获取通用框架,再结合项目实际逐项补充,控制在8个部分以内,突出重点并简化合并章节;其次使用关键词+语气提示引导ai写出专业内容,如“产品优势”可设定“以专业语气写一段关于智能喂食器的产品优势说明”;第三步借助ai生成财…

    2026年9月29日 • 用户投稿
    100
  • 李飞飞世界模型大更新! 实时生成 3D 世界,只要一块 GPU

    李飞飞世界模型大更新! 实时生成 3D 世界,只要一块 GPU李飞飞世界模型大更新! 实时生成 3D 世界,只要一块 GPU李飞飞世界模型大更新! 实时生成 3D 世界,只要一块 GPU李飞飞世界模型大更新! 实时生成 3D 世界,只要一块 GPU

    当 OpenAI 的奥特曼还在到处买显卡、买算力,来支撑他的 Sora 2 视频生成模型。 李飞飞的实验室 The World Labs,用一张显卡就能运行一个世界。他们今天发布了一项名为 RTFM ( Real-Time Frame Model ) 的新技术,一个全新的实时世界生成模型。 和九月中…

    2026年9月29日 • 用户投稿
    200
  • 桶排序是什么?桶排序的实现方法

    桶排序是什么?桶排序的实现方法桶排序是什么?桶排序的实现方法桶排序是什么?桶排序的实现方法桶排序是什么?桶排序的实现方法

    桶排序通过将数据分到多个桶内,对每个桶单独排序再合并,实现高效排序。其核心优势在于数据均匀分布时可达O(n+k)线性时间复杂度。与计数排序(统计频次)和基数排序(按位排序)不同,桶排序按值范围划分,适用于浮点数且更灵活,但性能依赖数据分布均匀性。实际应用中面临数据分布不均导致性能退化、内存开销大、桶…

    2026年9月29日 • 用户投稿
    100
  • 一门双至尊!荣耀MagicPad3 Pro平板首发第五代骁龙8至尊版:定义安卓最强平板

    一门双至尊!荣耀MagicPad3 Pro平板首发第五代骁龙8至尊版:定义安卓最强平板一门双至尊!荣耀MagicPad3 Pro平板首发第五代骁龙8至尊版:定义安卓最强平板一门双至尊!荣耀MagicPad3 Pro平板首发第五代骁龙8至尊版:定义安卓最强平板一门双至尊!荣耀MagicPad3 Pro平板首发第五代骁龙8至尊版:定义安卓最强平板

    9月25日,高通在骁龙峰会上正式揭晓了其最新旗舰移动平台——第五代骁龙8至尊版。这一发布瞬间点燃行业关注,而更引人瞩目的是,多家终端品牌随即宣布将推出搭载该芯片的新品,其中荣耀尤为抢眼。 荣耀产品线总裁方飞在峰会现场宣布:荣耀MagicPad3 Pro与荣耀Magic8系列将同步首发第五代骁龙8至尊…

    2026年9月29日 • 用户投稿
    100
  • 如何在Java中使用用户输入退出for或while循环

    如何在Java中使用用户输入退出for或while循环如何在Java中使用用户输入退出for或while循环如何在Java中使用用户输入退出for或while循环如何在Java中使用用户输入退出for或while循环

    本文旨在介绍如何在Java程序中,通过用户输入来灵活地中断for或while循环的执行。我们将探讨如何使用BufferedReader类来接收用户输入,并在循环内部判断输入是否为特定退出指令,从而实现程序的动态控制。同时,也会提供代码示例和注意事项,帮助你编写更健壮、更易维护的Java代码。 使用B…

    2026年9月29日 • 用户投稿
    000
  • 前端开发如何安装Sublime_Sublime前端环境搭建教程

    前端开发如何安装Sublime_Sublime前端环境搭建教程前端开发如何安装Sublime_Sublime前端环境搭建教程前端开发如何安装Sublime_Sublime前端环境搭建教程前端开发如何安装Sublime_Sublime前端环境搭建教程

    首先安装Sublime Text并配置Package Control插件管理器,接着安装Emmet、HTML-CSS-JS Prettify等前端插件,然后设置文件类型关联以正确识别.html、.css、.js文件语法,最后通过快捷键配置实现代码格式化功能。 如果您尝试在前端开发中使用 Sublim…

    2026年9月29日 • 用户投稿
    1700
  • GPU功耗超1000W 微软发布芯片级液冷散热技术:温度骤降65%

    GPU功耗超1000W 微软发布芯片级液冷散热技术:温度骤降65%GPU功耗超1000W 微软发布芯片级液冷散热技术:温度骤降65%GPU功耗超1000W 微软发布芯片级液冷散热技术:温度骤降65%GPU功耗超1000W 微软发布芯片级液冷散热技术:温度骤降65%

    9月24日,随着ai技术的快速发展,高性能芯片尤其是ai gpu的需求激增,但随之而来的功耗问题也日益严峻。下一代gpu的功耗预计将突破1000w,带来散热与能效方面的巨大挑战。 为应对这一难题,微软推出了一项创新的芯片级液冷解决方案——microfluidics(微流体)技术。该技术通过在硅芯片背…

    2026年9月29日 • 用户投稿
    100
  • 怎么用豆包AI帮我生成Docker配置 用AI快速创建最佳容器化方案的秘诀

    怎么用豆包AI帮我生成Docker配置 用AI快速创建最佳容器化方案的秘诀怎么用豆包AI帮我生成Docker配置 用AI快速创建最佳容器化方案的秘诀怎么用豆包AI帮我生成Docker配置 用AI快速创建最佳容器化方案的秘诀怎么用豆包AI帮我生成Docker配置 用AI快速创建最佳容器化方案的秘诀

    豆包ai能高效生成并优化docker配置,关键在于提问方式和信息完整度。1. 明确应用类型、依赖及部署需求,如服务语言、数据库、端口暴露等;2. 提供现有配置文件让ai检查安全与性能问题;3. 常见优化建议包括使用alpine镜像、多阶段构建、非root运行等;4. 可要求生成不同环境的配置文件(开…

    2026年9月29日 • 用户投稿
    100
  • Java中将当前时间转换为秒数

    Java中将当前时间转换为秒数Java中将当前时间转换为秒数Java中将当前时间转换为秒数Java中将当前时间转换为秒数

    本文介绍了如何在Java中将当前时间转换为自当天开始的秒数,并提供使用java.time.LocalTime类的示例代码。通过LocalTime.now()获取当前时间,并使用toSecondOfDay()方法将其转换为秒数。同时,还介绍了如何处理时区问题以及如何使用更易读的方式定义目标时间。 在J…

    2026年9月29日 • 用户投稿
    100
  • Mac如何设置静态IP地址_Mac网络手动配置静态IP教程

    Mac如何设置静态IP地址_Mac网络手动配置静态IP教程Mac如何设置静态IP地址_Mac网络手动配置静态IP教程Mac如何设置静态IP地址_Mac网络手动配置静态IP教程Mac如何设置静态IP地址_Mac网络手动配置静态IP教程

    首先将Mac的网络配置从DHCP改为手动,依次设置静态IP、子网掩码、路由器地址,并配置DNS服务器,最后通过终端ping命令验证网络连通性和域名解析是否正常。 如果您需要为您的Mac设备分配一个固定不变的网络地址以便于远程访问或服务器托管,那么您可能需要将网络配置从自动获取改为手动指定。以下是完成…

    2026年9月29日 • 用户投稿
    100
  • Safari浏览器怎么关闭标签页预览_Safari浏览器标签页缩略图预览关闭方法

    Safari浏览器怎么关闭标签页预览_Safari浏览器标签页缩略图预览关闭方法Safari浏览器怎么关闭标签页预览_Safari浏览器标签页缩略图预览关闭方法Safari浏览器怎么关闭标签页预览_Safari浏览器标签页缩略图预览关闭方法Safari浏览器怎么关闭标签页预览_Safari浏览器标签页缩略图预览关闭方法

    可通过Safari偏好设置关闭标签页预览功能,进入设置→标签页→取消勾选“在标签页中显示网站预览”;配合快捷键如Command+Shift+Tab切换标签,或启用系统辅助功能中的减少动态效果,进一步优化浏览体验。 如果您在使用Safari浏览器时发现标签页以缩略图形式预览显示,影响浏览效率或视觉体验…

    2026年9月29日 • 用户投稿
    200
  • windows怎么安装补丁包.msu文件_windows .msu格式补丁包的安装方法

    windows怎么安装补丁包.msu文件_windows .msu格式补丁包的安装方法windows怎么安装补丁包.msu文件_windows .msu格式补丁包的安装方法windows怎么安装补丁包.msu文件_windows .msu格式补丁包的安装方法windows怎么安装补丁包.msu文件_windows .msu格式补丁包的安装方法

    首先通过命令提示符使用wusa命令安装.msu补丁,其次可双击文件图形化安装,最后也可用PowerShell调用wusa.exe完成部署,三种方法均需按提示重启系统应用更新。 如果您下载了Windows系统的补丁包但不确定如何正确安装.msu格式的更新文件,可能是由于系统未正确识别或手动安装流程不熟…

    2026年9月29日 • 用户投稿
    100
  • 如何在Power BI中集成AI Power BI使用AI视觉分析数据

    如何在Power BI中集成AI Power BI使用AI视觉分析数据如何在Power BI中集成AI Power BI使用AI视觉分析数据如何在Power BI中集成AI Power BI使用AI视觉分析数据如何在Power BI中集成AI Power BI使用AI视觉分析数据

    在power bi中集成ai需多步骤实现,而非简单添加模块。1. 使用内置ai视觉分析功能如“分解树”和“关键影响因素”快速识别数据模式;2. 通过azure服务如anomaly detector进行复杂数据分析并可视化结果;3. 在power query中利用ai辅助清洗数据,提升效率;4. 自行…

    2026年9月29日 • 用户投稿
    100
  • 文心一言官方主页直达链接 文心一言语言模型主页官方访问地址

    文心一言官方主页可通过百度智能云平台访问,官网地址为https://yiyan.baidu.com,用户需用百度账号登录或注册后使用,可体验文本生成、图像创作、代码编写等功能,部分高级功能需开通会员或企业权限,注意辨别官网以防假冒。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使…

    2026年9月29日
    100
  • 摄像机怎么连接电视播放_摄像机连接电视播放视频的详细操作步骤

    摄像机怎么连接电视播放_摄像机连接电视播放视频的详细操作步骤摄像机怎么连接电视播放_摄像机连接电视播放视频的详细操作步骤摄像机怎么连接电视播放_摄像机连接电视播放视频的详细操作步骤摄像机怎么连接电视播放_摄像机连接电视播放视频的详细操作步骤

    可通过HDMI线、AV线、存储卡或无线投屏将摄像机连接电视播放。1、HDMI连接:用HDMI线连接摄像机与电视,切换至对应HDMI输入源并开启摄像机回放。2、AV线连接:使用三色AV线对接视频音频接口,电视切换至AV模式后播放。3、存储卡播放:将SD卡插入电视卡槽或通过读卡器U盘连接USB口直接播放…

    2026年9月29日 • 用户投稿
    200
  • 以“低价水果”诱导消费者下单,抖音电商公布打击提货卡引流诈骗进展

    以“低价水果”诱导消费者下单,抖音电商公布打击提货卡引流诈骗进展以“低价水果”诱导消费者下单,抖音电商公布打击提货卡引流诈骗进展以“低价水果”诱导消费者下单,抖音电商公布打击提货卡引流诈骗进展以“低价水果”诱导消费者下单,抖音电商公布打击提货卡引流诈骗进展

    感谢网友 hh_kk 的线索提供! 9 月 25 日消息,抖音电商安全与信任中心昨日发布通报称,近期平台积极协同相关执法部门,持续加码治理行动,严厉打击利用提货卡进行引流诈骗的违法行为。在向主管部门反馈线索后,于多地相关部门指导下,联合查处并捣毁多个涉嫌实施引流诈骗的物流中转点及印刷窝点,现场查扣大…

    2026年9月29日 • 用户投稿
    000
  • 使用 Java 比较版本号:一种更健壮的方法

    使用 Java 比较版本号:一种更健壮的方法使用 Java 比较版本号:一种更健壮的方法使用 Java 比较版本号:一种更健壮的方法使用 Java 比较版本号:一种更健壮的方法

    本文介绍了一种在 Java 中比较版本号的有效方法,避免了使用正则表达式进行复杂匹配的局限性。通过将版本号解析为整数数组并实现 Comparable 接口,我们可以轻松地比较版本号的大小,从而实现版本控制和依赖管理等功能。这种方法更易于理解、维护和扩展,且能更准确地处理各种版本号格式。 在软件开发中…

    2026年9月29日 • 用户投稿
    200
  • 怎么用豆包AI帮我修复安全漏洞代码 用豆包AI自动修复代码漏洞的实战方法

    怎么用豆包AI帮我修复安全漏洞代码 用豆包AI自动修复代码漏洞的实战方法怎么用豆包AI帮我修复安全漏洞代码 用豆包AI自动修复代码漏洞的实战方法怎么用豆包AI帮我修复安全漏洞代码 用豆包AI自动修复代码漏洞的实战方法怎么用豆包AI帮我修复安全漏洞代码 用豆包AI自动修复代码漏洞的实战方法

    豆包ai能有效辅助代码安全漏洞修复,尤其对sql注入、xss攻击等常见问题。一、可先将可疑代码发给豆包ai分析漏洞,如指出php中未过滤的get参数并建议使用预处理语句;二、再根据漏洞类型请求修复建议和示例代码,如防止xss时推荐htmlspecialchars函数;三、也可批量提交多个文件让ai初…

    2026年9月29日 • 用户投稿
    100
  • Qwen-TTS— 阿里通义推出的语音合成模型

    Qwen-TTS— 阿里通义推出的语音合成模型Qwen-TTS— 阿里通义推出的语音合成模型Qwen-TTS— 阿里通义推出的语音合成模型Qwen-TTS— 阿里通义推出的语音合成模型

    Qwen-TTS 是什么 qwen-tts是通义实验室研发的文本转语音模型,具备自然、稳定、快速的优势。该模型可根据输入文本及音色参数生成高质量音频,支持中文、英文以及多种方言,如北京话、上海话、四川话等。模型依托大规模语料训练,输出效果接近真人发音。qwen-tts支持流式音频输出,首包响应速度快…

    2026年9月29日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信