使用“加载更多”按钮抓取无限滚动页面:分步指南

应对动态网页加载数据的挑战:自动化“加载更多”按钮的网页抓取

您的网页抓取工具是否在尝试从动态网页加载数据时卡住了?那些恼人的“加载更多”按钮让您抓狂吗?别担心,您并非孤身一人!许多网站如今都使用这些设计来提升用户体验,但这对网络抓取工具来说却是个挑战。

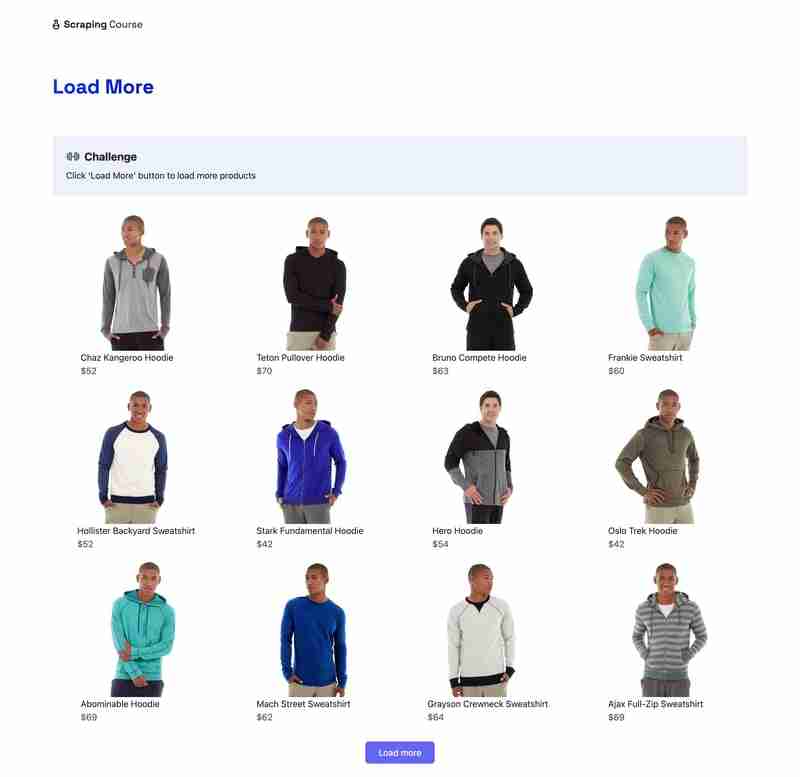
本教程将指导您完成一个针对初学者的循序渐进练习,使用“加载更多”按钮抓取一个演示页面。目标网页如下所示:
使用“加载更多”按钮抓取无限滚动页面:分步指南

通过本教程,您将学习如何:

配置Selenium进行网页抓取。自动化“加载更多”按钮的交互。提取产品数据,例如名称、价格和链接。

让我们开始吧!

步骤一:准备工作

开始之前,请确保您已完成以下准备工作:

已安装Python:从python.org下载并安装最新版本的Python,确保在安装过程中也安装了pip。基础知识:熟悉网页抓取的概念、Python编程以及使用requests、Beautiful Soup和Selenium等库。

所需的库:

requests:用于发送HTTP请求。Beautiful Soup:用于解析HTML内容。Selenium:用于模拟用户交互,例如在浏览器中点击按钮。

您可以使用以下命令在终端中安装这些库:

pip install requests beautifulsoup4 selenium

在使用Selenium之前,您必须安装与您的浏览器匹配的WebDriver。在本教程中,我们将使用Google Chrome和ChromeDriver。但是,您可以对Firefox或Edge等其他浏览器执行类似的步骤。

安装WebDriver

检查您的浏览器版本: 打开Google Chrome,从三点菜单导航到帮助 > 关于Google Chrome以查找Chrome版本。下载ChromeDriver: 访问ChromeDriver下载页面。下载与您的Chrome版本匹配的驱动程序版本。将ChromeDriver添加到您的系统路径: 解压下载的文件,并将其放置在/usr/local/bin(Mac/Linux)或C:WindowsSystem32(Windows)等目录中。

验证安装

在您的项目目录中创建一个名为scraper.py的Python文件,并运行以下代码片段来测试您的设置是否正确:

from selenium import webdriverdriver = webdriver.Chrome()  # 确保ChromeDriver已安装并位于路径中driver.get("https://www.scrapingcourse.com/button-click")print(driver.title)driver.quit()

您可以通过在终端中运行以下命令来执行上述文件代码:

python scraper.py

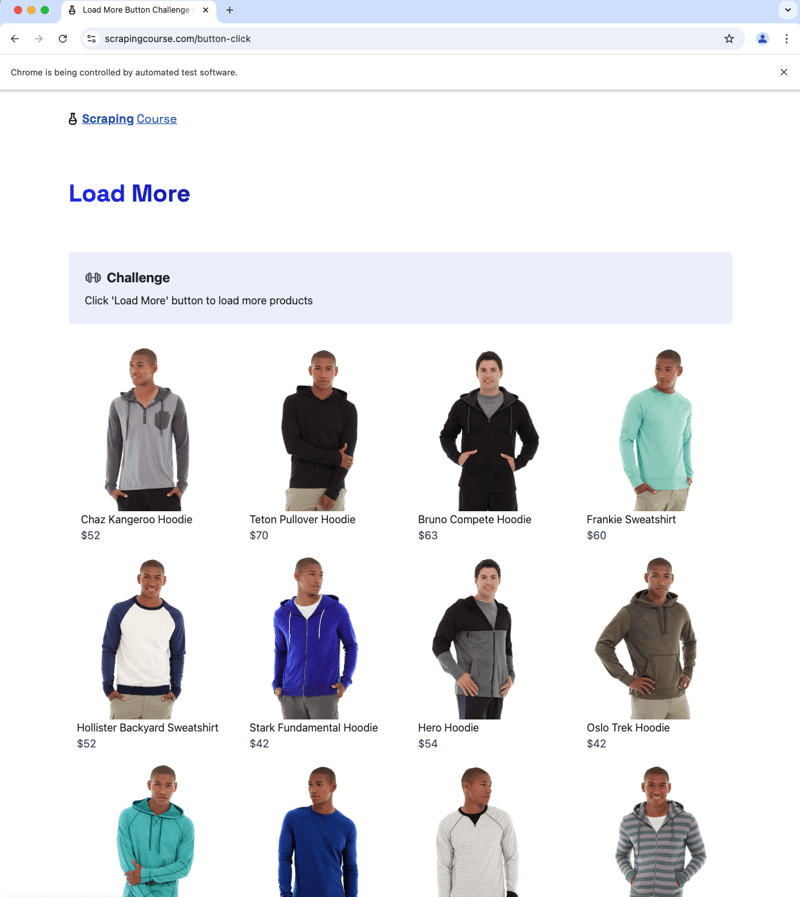
如果上述代码运行没有错误,它将启动浏览器窗口并打开演示页面的URL,如下所示:
使用“加载更多”按钮抓取无限滚动页面:分步指南

Selenium随后将提取HTML并打印页面标题。您将看到类似这样的输出:

Load More Button Challenge to Learn Web Scraping - ScrapingCourse.com

这将验证Selenium是否可以正常工作。安装所有必需的组件并准备好后,您可以开始访问演示页面的内容。

步骤二:访问内容

第一步是获取页面的初始内容,这将为您提供页面HTML的基线快照。这有助于您验证连接并确保抓取过程的有效起点。

您可以通过使用Python中的requests库发送GET请求来检索页面URL的HTML内容。代码如下:

import requests# 演示页面的URL,包含产品信息url = "https://www.scrapingcourse.com/button-click"# 发送GET请求到URLresponse = requests.get(url)# 检查请求是否成功if response.status_code == 200:    html_content = response.text    print(html_content)  # 可选:预览HTMLelse:    print(f"未能检索内容:{response.status_code}")

上述代码将输出包含前12个产品数据的原始HTML。

快速预览HTML可以确保请求成功,并且您正在使用有效的数据。

步骤三:加载更多产品

要访问其余的产品,您需要以编程方式点击页面上的“加载更多”按钮,直到没有更多产品可用为止。由于此交互涉及JavaScript,因此您将使用Selenium来模拟按钮点击。

在编写代码之前,让我们检查页面以定位:

“加载更多”按钮选择器(load-more-btn)。保存产品详细信息的div(product-item)。

通过加载更多产品,您可以获得所有产品,运行以下代码将为您提供更大的数据集:

from selenium import webdriverfrom selenium.webdriver.common.by import Byimport time# 设置WebDriver(确保您已安装相应的驱动程序,例如ChromeDriver)driver = webdriver.Chrome()# 打开页面driver.get("https://www.scrapingcourse.com/button-click")# 循环点击“加载更多”按钮,直到没有更多产品while True:    try:        # 通过其ID查找“加载更多”按钮并点击它        load_more_button = driver.find_element(By.ID, "load-more-btn")        load_more_button.click()        # 等待内容加载(根据需要调整时间)        time.sleep(2)    except Exception as e:        # 如果找不到“加载更多”按钮(产品结束),则跳出循环        print("没有更多产品可加载。")        break# 获取加载所有产品后的更新页面内容html_content = driver.page_source# 关闭浏览器窗口driver.quit()

这段代码打开浏览器,导航到页面,并与“加载更多”按钮进行交互。然后它提取更新后的HTML(现在包含更多产品数据)。

如果您不希望Selenium每次运行此代码时都打开浏览器,它还提供了headless(无头)浏览器功能。headless浏览器具有实际web浏览器的所有功能,但没有图形用户界面(GUI)。

您可以通过定义ChromeOptions对象并将其传递给webdriver.Chrome构造函数来在Selenium中启用Chrome的headless模式,如下所示:

from selenium import webdriverfrom selenium.webdriver.common.by import Byimport time# 实例化一个ChromeOptions对象options = webdriver.ChromeOptions()# 将选项设置为headless模式options.add_argument("--headless=new")# 以headless模式初始化Chrome驱动程序实例driver = webdriver.Chrome(options=options)...

当您运行上述代码时,Selenium将启动一个headless Chrome实例,因此您将不再看到Chrome窗口。这对于在服务器上运行抓取脚本,并且不想在GUI上浪费资源的生产环境来说是理想的选择。

现在已经检索到完整的HTML内容,是时候提取每个产品的具体详细信息了。

步骤四:解析产品信息

在此步骤中,您将使用Beautiful Soup解析HTML并识别产品元素。然后,您将提取每个产品的关键详细信息,例如名称、价格和链接。

from bs4 import BeautifulSoup# 使用Beautiful Soup解析页面内容soup = BeautifulSoup(html_content, 'html.parser')# 提取产品详细信息products = []# 查找网格中的所有产品项目product_items = soup.find_all('div', class_='product-item')for product in product_items:    # 提取产品名称    name = product.find('span', class_='product-name').get_text(strip=True)    # 提取产品价格    price = product.find('span', class_='product-price').get_text(strip=True)    # 提取产品链接    link = product.find('a')['href']    # 提取图片URL    image_url = product.find('img')['src']    # 创建一个包含产品详细信息的字典    products.append({        'name': name,        'price': price,        'link': link,        'image_url': image_url    })# 打印提取的产品详细信息for product in products[:2]:    print(f"名称:{product['name']}")    print(f"价格:{product['price']}")    print(f"链接:{product['link']}")    print(f"图片URL:{product['image_url']}")    print('-' * 30)

在输出中,您应该看到产品详细信息的结构化列表,包括名称、图片URL、价格和产品页面链接,如下所示:

名称:Chaz Kangeroo Hoodie价格:$52链接:https://scrapingcourse.com/ecommerce/product/chaz-kangeroo-hoodie图片URL:https://scrapingcourse.com/ecommerce/wp-content/uploads/2024/03/mh01-gray_main.jpg------------------------------名称:Teton Pullover Hoodie价格:$70链接:https://scrapingcourse.com/ecommerce/product/teton-pullover-hoodie图片URL:https://scrapingcourse.com/ecommerce/wp-content/uploads/2024/03/mh02-black_main.jpg------------------------------…

上述代码将原始HTML数据组织成结构化格式,使其更容易使用和准备输出数据以进行进一步处理。

步骤五:将产品信息导出到CSV

现在,您可以将提取的数据组织到CSV文件中,这使得分析或共享变得更加容易。Python的csv模块对此有所帮助。

import csv# 将产品信息写入CSV文件with open("products.csv", mode="w", newline="") as file:    writer = csv.DictWriter(file, fieldnames=["name", "image_url", "price", "link"])    writer.writeheader()    for product in products:        writer.writerow(product)

上述代码将创建一个新的CSV文件,其中包含所有必需的产品详细信息。

步骤六:获取热门产品的额外数据

现在,假设您想识别价格最高的前5个产品,并从其各个页面中提取其他数据(例如产品描述和SKU代码)。您可以使用以下代码来做到这一点:

# 按价格降序排列产品sorted_products = sorted(products, key=lambda x: float(x['price'].replace('$', '')), reverse=True)# 抓取前5个产品的额外详细信息driver = webdriver.Chrome()for product in sorted_products[:5]:    driver.get(product['link'])    time.sleep(3)    soup = BeautifulSoup(driver.page_source, 'html.parser')    description = soup.find('div', class_='product-description')    product['description'] = description.get_text(strip=True) if description else "无描述"    sku = soup.find('span', class_='sku')    product['sku'] = sku.get_text(strip=True) if sku else "无SKU"driver.quit()# 将包含额外数据的产品信息写入CSV文件with open("products.csv", mode="w", newline="") as file:    writer = csv.DictWriter(file, fieldnames=["name", "image_url", "price", "link", "description", "sku"])    writer.writeheader()    for product in products:        writer.writerow({            'name': product['name'],            'image_url': product['image_url'],            'price': product['price'],            'link': product['link'],            'description': product.get('description', ''),            'sku': product.get('sku', '')        })

这段代码按价格降序对产品进行排序。然后,对于价格最高的前5个产品,脚本打开其产品页面并使用Beautiful Soup提取产品描述和SKU。

结论

使用无限滚动或“加载更多”按钮抓取页面看起来具有挑战性,但使用requests、Selenium和Beautiful Soup等工具可以简化这个过程。

本教程展示了如何从演示页面检索和处理产品数据,并将其保存为结构化格式以便快速轻松地访问。

以上就是使用“加载更多”按钮抓取无限滚动页面:分步指南的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1355540.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
小型开发团队的 CI/CD 管道测试
上一篇 2025年12月13日 19:17:34
智能 PDF 数据提取和数据库创建
下一篇 2025年12月13日 19:17:55

相关推荐

  • vivoY系列摄像头设置怎么调以提升低光拍摄效果?低光模式的优化方法

    vivoY系列摄像头设置怎么调以提升低光拍摄效果?低光模式的优化方法vivoY系列摄像头设置怎么调以提升低光拍摄效果?低光模式的优化方法vivoY系列摄像头设置怎么调以提升低光拍摄效果?低光模式的优化方法vivoY系列摄像头设置怎么调以提升低光拍摄效果?低光模式的优化方法

    要提升vivo Y系列低光拍摄效果,需开启夜景模式,利用多帧合成提亮降噪,配合曝光补偿微调(如-0.3至-0.7EV)避免过曝,保持手机稳定防模糊,必要时用HDR平衡光比,慎用闪光灯,优先使用屏幕补光或外部光源,开启AI场景识别辅助优化,手动对焦确保清晰,并保持镜头清洁;在支持专业模式的机型上,可降…

    2026年9月29日 • 用户投稿
    000
  • 科隆2025获奖名单公布 《生化危机9》成最大赢家

    科隆2025获奖名单公布 《生化危机9》成最大赢家科隆2025获奖名单公布 《生化危机9》成最大赢家科隆2025获奖名单公布 《生化危机9》成最大赢家科隆2025获奖名单公布 《生化危机9》成最大赢家

    科隆游戏展每年都会揭晓其备受瞩目的奖项,这些荣誉由独立评审团通过投票方式决定。根据评选规则,该奖项旨在“嘉奖在游戏作品、扩展内容、参展品牌、展台设计、周边产品以及发布预告等方面表现卓越的项目”。 在2025年的科隆游戏展上,Capcom及其重磅作品《生化危机9:安魂曲》成为最大赢家,一举夺得最佳视觉…

    2026年9月28日 • 用户投稿
    300
  • windows怎么开启卓越性能模式_windows卓越性能模式的开启教程

    首先启用卓越性能模式可提升Windows系统性能,具体通过命令提示符输入powercfg命令激活隐藏模式,或使用注册表编辑器手动添加电源方案,还可利用PowerShell脚本实现批量部署,三种方法均需管理员权限操作。 如果您希望提升Windows系统的响应速度和整体性能,尤其是在运行高负载任务时,启…

    2026年9月28日
    200
  • Sublime如何为不同项目配置不同运行环境_项目专属构建系统设置

    Sublime如何为不同项目配置不同运行环境_项目专属构建系统设置Sublime如何为不同项目配置不同运行环境_项目专属构建系统设置Sublime如何为不同项目配置不同运行环境_项目专属构建系统设置Sublime如何为不同项目配置不同运行环境_项目专属构建系统设置

    通过创建项目专属构建系统并绑定到具体项目,可在Sublime中实现运行环境隔离。首先新建.sublime-build文件指定执行命令与参数,保存至项目目录或User包路径;随后在项目配置中添加build_systems字段引用该文件,使构建选项仅对该项目生效;进一步可在构建配置中设置env字段修改P…

    2026年9月28日 • 用户投稿
    200
  • 华为手机桌面布局设置与个性主题创作(打造独一无二的手机桌面风格)

    华为手机桌面布局设置与个性主题创作(打造独一无二的手机桌面风格)华为手机桌面布局设置与个性主题创作(打造独一无二的手机桌面风格)华为手机桌面布局设置与个性主题创作(打造独一无二的手机桌面风格)华为手机桌面布局设置与个性主题创作(打造独一无二的手机桌面风格)

    作为智能手机领域的领军企业,华为手机不仅在硬件性能上有着出色的表现,同时也提供了丰富多样的个性化设置,其中之一就是桌面布局设置和个性主题创作功能。通过灵活的设置,用户可以根据自己的喜好和需求,打造一个独一无二的手机桌面风格。本文将详细介绍华为手机桌面布局设置和个性主题创作的方法和技巧。 段落1了解华…

    2026年9月28日 • 用户投稿
    100
  • 最小化完成任务所需的时间:一种扫描线算法教程

    最小化完成任务所需的时间:一种扫描线算法教程最小化完成任务所需的时间:一种扫描线算法教程最小化完成任务所需的时间:一种扫描线算法教程最小化完成任务所需的时间:一种扫描线算法教程

    本文介绍了一种使用扫描线算法解决任务调度问题的有效方法。该问题涉及一系列具有开始时间、结束时间和所需完成时间的任务。目标是找到完成所有任务所需的最小总时间,允许同时处理多个任务,且任务完成时间可以是不连续的。本文将详细解释该算法的逻辑,并提供相应的代码示例,帮助读者理解和应用该方法。 问题描述 给定…

    2026年9月28日 • 用户投稿
    600
  • 多模态AI如何处理医学影像 多模态AI医疗诊断辅助方案

    多模态AI如何处理医学影像 多模态AI医疗诊断辅助方案多模态AI如何处理医学影像 多模态AI医疗诊断辅助方案多模态AI如何处理医学影像 多模态AI医疗诊断辅助方案多模态AI如何处理医学影像 多模态AI医疗诊断辅助方案

    本文将探讨多模态AI如何处理医学影像,并介绍其在医疗诊断辅助中的应用方案。我们将从理解多模态数据的重要性入手,逐步讲解AI处理这些数据的方法和技术,最后展示AI在医学影像诊断中的具体应用案例,以期为相关领域的研究和实践提供参考。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 …

    2026年9月28日 • 用户投稿
    100
  • 深度解析Linux为何稳定如山:技术与哲学的结合之道

    深度解析Linux为何稳定如山:技术与哲学的结合之道深度解析Linux为何稳定如山:技术与哲学的结合之道深度解析Linux为何稳定如山:技术与哲学的结合之道深度解析Linux为何稳定如山:技术与哲学的结合之道

    标题:深度解析Linux为何稳定如山:技术与哲学的结合之道 Linux作为开源操作系统的代表之一,以其稳定性和强大的功能受到广泛赞誉。许多人对Linux系统之所以如此稳定兴趣浓厚,这背后是技术与哲学的结合之道。本文将从技术和哲学两个角度深入分析Linux系统的稳定性,并通过具体代码示例来展示。 技术…

    2026年9月28日 • 用户投稿
    200
  • 求解完成任务的最短时间:一种基于扫描线的算法教程

    求解完成任务的最短时间:一种基于扫描线的算法教程求解完成任务的最短时间:一种基于扫描线的算法教程求解完成任务的最短时间:一种基于扫描线的算法教程求解完成任务的最短时间:一种基于扫描线的算法教程

    本文详细介绍了如何使用扫描线算法解决“求解完成任务的最短时间”问题。该问题涉及在给定的时间范围内完成多个任务,每个任务都有起始时间、结束时间和所需完成时间。本文将深入探讨算法逻辑,并通过Java代码示例展示如何有效地计算完成所有任务所需的最小时间。 问题描述 给定一个任务数组 tasks,其中每个任…

    2026年9月28日 • 用户投稿
    800
  • sublime怎么恢复因崩溃而关闭的窗口会话_会话恢复功能使用方法

    sublime怎么恢复因崩溃而关闭的窗口会话_会话恢复功能使用方法sublime怎么恢复因崩溃而关闭的窗口会话_会话恢复功能使用方法sublime怎么恢复因崩溃而关闭的窗口会话_会话恢复功能使用方法sublime怎么恢复因崩溃而关闭的窗口会话_会话恢复功能使用方法

    Sublime Text通过hot_exit和remember_open_files机制自动保存会话,崩溃后可自动或手动恢复未保存的文件与窗口布局。其核心是将工作状态写入Session.sublime_session文件,重启时加载该快照以还原现场。若自动恢复失败,用户可进入Local目录,用Aut…

    2026年9月28日 • 用户投稿
    200
  • 如何恢复印象笔记中被误删的笔记_印象笔记误删笔记找回与恢复步骤

    如何恢复印象笔记中被误删的笔记_印象笔记误删笔记找回与恢复步骤如何恢复印象笔记中被误删的笔记_印象笔记误删笔记找回与恢复步骤如何恢复印象笔记中被误删的笔记_印象笔记误删笔记找回与恢复步骤如何恢复印象笔记中被误删的笔记_印象笔记误删笔记找回与恢复步骤

    答案:可通过废纸篓还原笔记、历史版本恢复内容、撤销操作、查找冲突副本或切换正确账户找回误删数据。首先检查废纸篓并还原笔记;若部分内容丢失,进入笔记信息查看历史版本并还原;编辑时立即使用Ctrl+Z或Command+Z撤销删除;同步问题可查找“冲突的修改”笔记本获取副本;若登录错误账户,切换至中国版或…

    2026年9月28日 • 用户投稿
    400
  • windows蓝屏代码dpc_watchdog_violation怎么办_dpc_watchdog_violation蓝屏代码解决方法

    windows蓝屏代码dpc_watchdog_violation怎么办_dpc_watchdog_violation蓝屏代码解决方法windows蓝屏代码dpc_watchdog_violation怎么办_dpc_watchdog_violation蓝屏代码解决方法windows蓝屏代码dpc_watchdog_violation怎么办_dpc_watchdog_violation蓝屏代码解决方法windows蓝屏代码dpc_watchdog_violation怎么办_dpc_watchdog_violation蓝屏代码解决方法

    DPC_WATCHDOG_VIOLATION蓝屏错误通常由驱动不兼容或硬件问题引起。首先更新或回滚存储控制器驱动,若无效则禁用Intel RST VMD控制器;接着运行内存诊断工具检测RAM故障,并使用厂商工具检查SSD健康状态与固件;最后恢复BIOS默认设置,禁用超频以排除稳定性问题。 如果您在使…

    2026年9月28日 • 用户投稿
    200
  • 小红书视频违规检测工具有哪些?小红书检测

    小红书视频违规检测工具有哪些?小红书检测小红书视频违规检测工具有哪些?小红书检测小红书视频违规检测工具有哪些?小红书检测小红书视频违规检测工具有哪些?小红书检测

    随着短视频生态的不断壮大,小红书已逐渐成为用户记录生活、分享经验的重要社交平台。在尽情创作的同时,我们也需关注内容是否符合平台规范,防止因违规而影响账号运营。本文将为你梳理目前主流的小红书视频违规检测工具,助你轻松规避风险,实现内容合规发布。 一、小红书视频违规检测工具简介 所谓小红书视频违规检测工…

    2026年9月28日 • 用户投稿
    200
  • sublime怎么查看和管理已安装的插件列表_已安装插件管理方法

    sublime怎么查看和管理已安装的插件列表_已安装插件管理方法sublime怎么查看和管理已安装的插件列表_已安装插件管理方法sublime怎么查看和管理已安装的插件列表_已安装插件管理方法sublime怎么查看和管理已安装的插件列表_已安装插件管理方法

    答案:通过Package Control和命令面板可查看管理插件,输入“Package Control: List Packages”列出已安装插件;访问“Preferences > Browse Packages…”查看实际文件位置;使用“Install/Remove Packa…

    2026年9月28日 • 用户投稿
    200
  • 360极速浏览器如何导入Chrome书签_360极速浏览器从Chrome导入书签步骤

    360极速浏览器如何导入Chrome书签_360极速浏览器从Chrome导入书签步骤360极速浏览器如何导入Chrome书签_360极速浏览器从Chrome导入书签步骤360极速浏览器如何导入Chrome书签_360极速浏览器从Chrome导入书签步骤360极速浏览器如何导入Chrome书签_360极速浏览器从Chrome导入书签步骤

    首先通过HTML文件或直接导入功能将Chrome书签迁移到360极速浏览器。1、在Chrome中导出书签为HTML文件,再于360极速浏览器收藏夹管理中选择从HTML文件导入;2、或在360极速浏览器中点击“导入/导出”后选择“导入收藏夹”,直接选取Google Chrome并确认导入,即可完成书签…

    2026年9月28日 • 用户投稿
    200
  • win10怎么清理系统垃圾_Win10系统垃圾深度清理方法

    win10怎么清理系统垃圾_Win10系统垃圾深度清理方法win10怎么清理系统垃圾_Win10系统垃圾深度清理方法win10怎么清理系统垃圾_Win10系统垃圾深度清理方法win10怎么清理系统垃圾_Win10系统垃圾深度清理方法

    使用磁盘清理工具可删除临时文件、回收站及旧版系统备份;2. 启用存储感知实现自动清理;3. 手动清除%temp%目录释放空间;4. 卸载不常用软件并转移用户文件至非系统盘;5. 禁用休眠功能删除hiberfil.sys大文件,综合操作显著提升系统性能与磁盘可用空间。 如果您发现Windows 10系…

    2026年9月28日 • 用户投稿
    100
  • 什么是Linux Gem?探讨Linux Gem的意义与价值

    什么是Linux Gem?探讨Linux Gem的意义与价值什么是Linux Gem?探讨Linux Gem的意义与价值什么是Linux Gem?探讨Linux Gem的意义与价值什么是Linux Gem?探讨Linux Gem的意义与价值

    Linux Gem:开源世界的闪亮明珠 近年来,随着开源软件的迅猛发展,Linux系统已经成为越来越多软件开发者和IT从业者的首选平台。Linux以其稳定性、安全性和灵活性,在服务器端和嵌入式设备领域广受欢迎。在Linux的庞大生态系统中,有许多闪亮的明珠,其中之一便是Linux Gem,本文将探讨…

    2026年9月28日 • 用户投稿
    000
  • 快手小店如何打造爆款商品 快手小店选品与推广的秘诀

    快手小店如何打造爆款商品 快手小店选品与推广的秘诀快手小店如何打造爆款商品 快手小店选品与推广的秘诀快手小店如何打造爆款商品 快手小店选品与推广的秘诀快手小店如何打造爆款商品 快手小店选品与推广的秘诀

    精准定位目标用户需结合“感同身受”的观察与数据分析,先像用户一样浏览快手,参考同类优质账号的粉丝画像与内容互动模式,再利用快手小店后台的年龄、地域、兴趣等数据画像进行量化验证,并通过评论、私信、直播互动挖掘深层需求;2. 爆款选品核心原则包括高性价比(强调“值不值”而非单纯低价)、强视觉冲击力与易演…

    2026年9月28日 • 用户投稿
    100
  • 幕布文档怎么导出为PDF或图片

    幕布文档怎么导出为PDF或图片幕布文档怎么导出为PDF或图片幕布文档怎么导出为PDF或图片幕布文档怎么导出为PDF或图片

    1、在幕布中导出PDF可点击右上角「…」选择导出为PDF,设置页面方向等内容后下载;2、导出图片则在导出选项中选择PNG或JPEG格式生成长图;3、还可通过快捷键Command+P调出打印窗口,选择“另存为PDF”保存文件。 如果您在使用幕布文档时需要将内容分享给他人或进行打印,可能会遇到需要将文档…

    2026年9月28日 • 用户投稿
    300
  • sublime怎么卸载已经安装的插件_Sublime已安装插件的卸载与管理方法

    sublime怎么卸载已经安装的插件_Sublime已安装插件的卸载与管理方法sublime怎么卸载已经安装的插件_Sublime已安装插件的卸载与管理方法sublime怎么卸载已经安装的插件_Sublime已安装插件的卸载与管理方法sublime怎么卸载已经安装的插件_Sublime已安装插件的卸载与管理方法

    卸载Sublime Text插件最稳妥的方法是通过Package Control,打开后选择Remove Package并确认卸载;若需手动删除,可进入对应系统下的Packages目录操作,但可能残留配置引发异常;为彻底清理配置,可删除User文件夹或整个配置目录,但会重置所有用户设置,建议提前备份…

    2026年9月28日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信