Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python中如何进行文本分类?_创想鸟

Python中如何进行文本分类?

python中进行文本分类主要包括以下步骤:1. 数据预处理:使用nltk和spacy去除停用词、分词等。2. 特征提取:采用词袋模型、tf-idf或词嵌入方法。3. 模型选择和训练:可选用朴素贝叶斯、svm等模型。4. 模型评估和优化:通过交叉验证和调参提升性能。

Python中如何进行文本分类?

在Python中进行文本分类是一项非常有趣且实用的任务。今天我们就来聊聊如何利用Python来实现这个功能,以及在实际操作中可能会遇到的一些挑战和解决方案。

Python中进行文本分类,通常会涉及到以下几个步骤:数据预处理、特征提取、模型选择和训练、以及模型评估和优化。让我们从头开始,逐步深入探讨这个过程。

首先,我们需要对文本数据进行预处理。这包括去除停用词、分词、去除标点符号等操作。Python中常用的库如NLTK和spaCy可以帮助我们完成这些任务。预处理的质量直接影响后续的分类效果,所以这一步非常关键。

立即学习“Python免费学习笔记(深入)”;

import nltkfrom nltk.corpus import stopwordsfrom nltk.tokenize import word_tokenizenltk.download('punkt')nltk.download('stopwords')def preprocess_text(text):    # 分词    tokens = word_tokenize(text.lower())    # 去除停用词和标点符号    stop_words = set(stopwords.words('english'))    tokens = [token for token in tokens if token.isalnum() and token not in stop_words]    return ' '.join(tokens)# 示例文本text = "This is an example sentence for text classification."processed_text = preprocess_text(text)print(processed_text)

接下来是特征提取。常用的方法有词袋模型(Bag of Words)、TF-IDF(Term Frequency-Inverse Document Frequency)以及词嵌入(Word Embeddings)。这些方法各有优劣,词袋模型简单但丢失了词序信息,TF-IDF考虑了词的重要性,而词嵌入则能捕捉到词之间的语义关系。

from sklearn.feature_extraction.text import TfidfVectorizer# 假设我们有一组文本texts = ["This is the first document.", "This document is the second document.", "And this is the third one.", "Is this the first document?"]# 使用TF-IDF进行特征提取vectorizer = TfidfVectorizer()X = vectorizer.fit_transform(texts)print(X.toarray())

在选择模型方面,常用的有朴素贝叶斯、支持向量机(SVM)、决策树、随机森林以及深度学习模型如神经网络。每个模型都有其适用场景和优缺点。例如,朴素贝叶斯在处理小数据集时表现不错,而深度学习模型在处理大规模数据时更有优势。

from sklearn.naive_bayes import MultinomialNBfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import classification_report# 假设我们有对应的标签labels = ['class1', 'class2', 'class1', 'class2']# 划分训练集和测试集X_train, X_test, y_train, y_test = train_test_split(X, labels, test_size=0.2, random_state=42)# 训练模型clf = MultinomialNB()clf.fit(X_train, y_train)# 预测并评估y_pred = clf.predict(X_test)print(classification_report(y_test, y_pred))

在实际应用中,我们可能会遇到一些挑战。比如,数据不平衡问题会导致模型偏向于多数类别,这时可以使用过采样或欠采样技术来平衡数据集。另外,文本分类任务中,特征维度往往很高,这可能会导致过拟合问题,可以通过特征选择或降维技术来解决。

from imblearn.over_sampling import RandomOverSampler# 假设我们有一个不平衡的数据集X, y = ...  # 你的数据# 使用过采样来平衡数据集ros = RandomOverSampler(random_state=42)X_resampled, y_resampled = ros.fit_resample(X, y)# 重新训练模型X_train, X_test, y_train, y_test = train_test_split(X_resampled, y_resampled, test_size=0.2, random_state=42)clf.fit(X_train, y_train)y_pred = clf.predict(X_test)print(classification_report(y_test, y_pred))

最后,模型的评估和优化也是一个持续的过程。我们可以通过交叉验证来评估模型的泛化能力,并通过调参来优化模型的性能。Python中的GridSearchCV和RandomizedSearchCV可以帮助我们自动化这个过程。

from sklearn.model_selection import GridSearchCV# 定义参数网格param_grid = {    'alpha': [0.1, 0.5, 1.0],    'fit_prior': [True, False]}# 使用网格搜索进行调参grid_search = GridSearchCV(MultinomialNB(), param_grid, cv=5)grid_search.fit(X_train, y_train)# 输出最佳参数和最佳得分print("Best parameters:", grid_search.best_params_)print("Best cross-validation score:", grid_search.best_score_)# 使用最佳参数重新训练模型best_clf = grid_search.best_estimator_best_clf.fit(X_train, y_train)y_pred = best_clf.predict(X_test)print(classification_report(y_test, y_pred))

在实际项目中,我曾经遇到过一个有趣的案例。我们需要对用户评论进行情感分类,但发现传统的机器学习模型在处理长文本时效果不佳。于是我们尝试了BERT模型,结果发现其在捕捉长距离依赖关系方面表现出色,最终大幅提升了分类的准确率。

总的来说,Python中的文本分类是一个多步骤、多方法的过程。每个步骤都需要仔细考虑和优化,才能得到一个高效且准确的分类模型。希望这篇文章能为你提供一些有用的见解和实践经验。

以上就是Python中如何进行文本分类?的详细内容,更多请关注php中文网其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1362304.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
pycharm安装的库保存在哪 库文件存储位置
上一篇 2025年12月14日 01:41:20
怎样在Python中测试函数?
下一篇 2025年12月14日 01:41:25

相关推荐

  • 如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤

    如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤如何在VEED.io中制作AI视频?在线工具快速剪辑AI内容的步骤

    VEED.io通过“文本转视频”和“AI形象”功能,让视频制作变得简单高效。用户只需输入文本,即可生成带AI配音、字幕和匹配素材的视频,或选择AI虚拟人物进行口型同步播报。平台还提供AI语音合成、自动字幕、多语言支持及丰富编辑功能,便于后期精修。优化效果需从高质量文本入手,合理选择声音与形象,并通过…

    2026年9月22日 用户投稿
    000
  • Java中递归处理列表:条件性移除最大值策略与实现

    本教程深入探讨了如何在Java中使用递归方法,根据特定条件(如列表是否已排序、最大值是否位于列表的首尾)来移除列表中的最大值。文章将详细阐述如何设计一个高效的递归算法,包括排序检查、最大值定位以及条件性移除的实现细节,并提供完整的代码示例和注意事项,帮助读者掌握递归在复杂列表操作中的应用。 引言:递…

    2026年9月22日
    000
  • 玩转 Spring Boot 集成篇(定时任务框架Quartz)

    玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)玩转 Spring Boot 集成篇(定时任务框架Quartz)

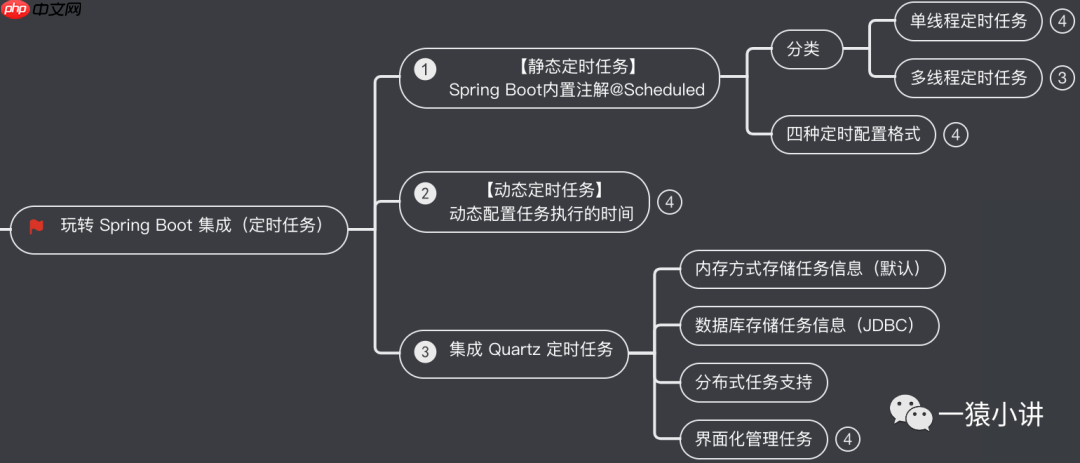
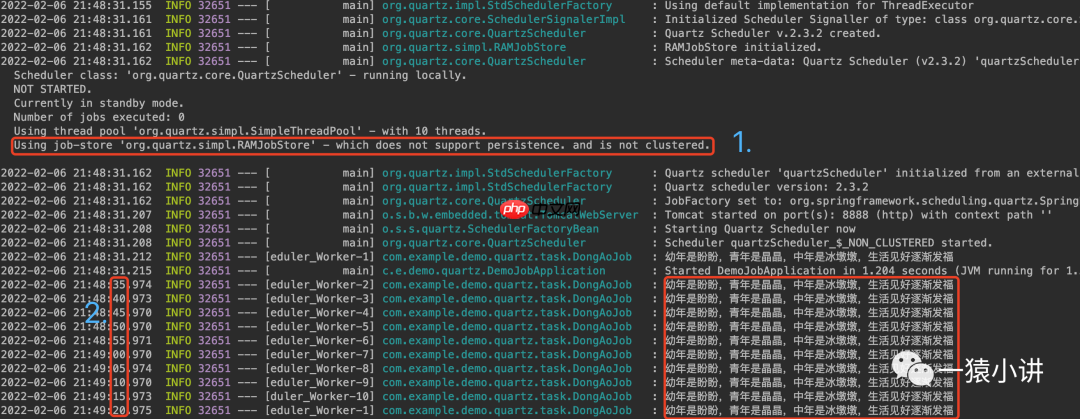
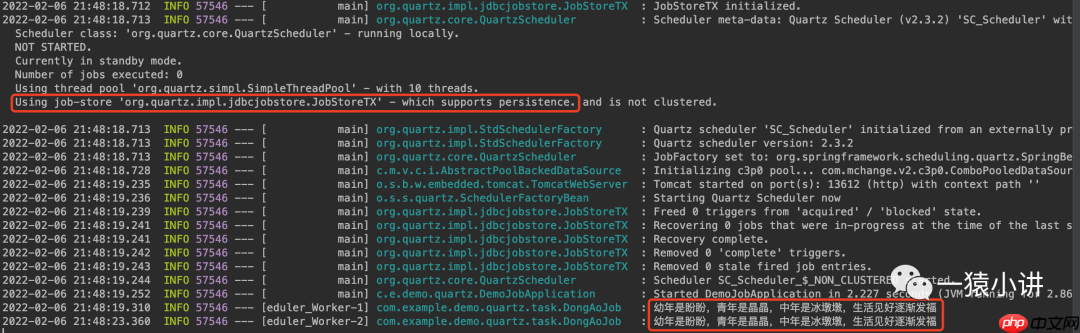
    在日常项目研发中,定时任务可谓是必不可少的一环,关于 spring boot 如何实现静态定时任务、动态定时任务以及如何开启多线程跑任务,均已在上篇分享过,不再赘述。 虽然 Spring Boot 内置注解方式实现的定时任务,在一定程度上也能解决一定的业务场景问题,但是若做更复杂的动作,例如启停任务…

    2026年9月22日 用户投稿
    100
  • Cortana如何连接邮箱_Cortana邮箱同步配置方法

    首先需将邮箱账户与Cortana连接,可通过Windows设置添加账户或在Cortana应用内手动配置,支持Outlook.com、Gmail及Exchange等类型;完成账户添加后,须在隐私权限中启用邮件读取和同步权限,确保Cortana可访问邮件、日历及联系人数据,从而实现智能提醒与信息同步功能…

    2026年9月22日
    000
  • 如何用Sublime导出MySQL数据表结构_生成Markdown或HTML格式文档

    要使用 sublime text 导出 mysql 数据表结构并生成 markdown 或 html 文档,需通过以下步骤操作:1. 使用 show create table 命令或 mysqldump 工具获取建表语句;2. 在 sublime 中整理字段信息,按字段名、类型、是否为空、键、默认值…

    2026年9月22日
    000
  • 三角洲行动S6九格保险任务速通指南

    三角洲行动S6九格保险任务速通指南三角洲行动S6九格保险任务速通指南三角洲行动S6九格保险任务速通指南三角洲行动S6九格保险任务速通指南

    在《三角洲行动》s6赛季中,九格保险任务成了不少玩家头疼的难题,耗时久、节奏慢,稍不注意就被卡住。其实只要掌握策略,合理安排任务顺序,高效推进并非难事!接下来这份分阶段速通攻略,将帮你理清思路,快速通关九格保险任务! 三角洲行动S6赛季九格保险任务高效速通指南 第一阶段:聚焦主线与关键前置 优先完成…

    2026年9月22日 用户投稿
    100
  • 解决PHP应用中本地文件更新后网页视图不刷新的缓存问题

    本文探讨了PHP应用中,本地JSON或图片文件更新后,网页视图无法实时刷新的常见问题。核心原因在于浏览器缓存机制。文章将提供多种解决方案,包括强制刷新、隐身模式诊断、以及通过URL参数、服务器配置(.htaccess)和文件版本控制来有效管理缓存,确保用户始终获取最新数据。 理解问题:本地文件更新与…

    2026年9月22日
    200
  • VSCode如何安装和使用插件 VSCode插件管理的高效方法

    安装插件需通过vscode扩展视图搜索并点击安装,部分插件需重启或配置后生效;2. 使用插件时可通过命令面板、上下文菜单、状态栏或自动语言特性调用功能,并在设置中自定义行为;3. 高效管理应定期审视插件使用频率,禁用或卸载不常用者,关注性能影响,利用“开发者: 显示正在运行的扩展”识别资源占用高的插…

    2026年9月22日
    200
  • Java Stream API:从嵌套集合中提取唯一值的高效实践

    本文深入探讨如何利用Java Stream API,从包含嵌套集合的对象列表中高效地提取唯一的字符串值。我们将重点介绍flatMap()和mapMulti()这两种强大的流操作,演示它们如何替代传统的嵌套循环,从而实现代码的简洁性、可读性以及潜在的性能优化。 在java应用开发中,我们经常会遇到处理…

    2026年9月22日
    100
  • safari浏览器如何将网页保存为PDF_safari浏览器网页保存为PDF方法

    Safari浏览器支持将网页保存为PDF,可通过三种方式实现:1. 使用打印功能,点击“文件”→“打印”,选择“另存为PDF”并设置参数后保存;2. 点击共享按钮,选择“创建PDF”,生成后存储到指定位置;3. 利用快捷指令应用创建自动化流程,获取当前网页并转换为PDF自动归档。 如果您在浏览网页时…

    2026年9月22日
    100
  • CapCut的AI混合工具如何使用?快速制作高质量短视频的教程

    CapCut的AI混合工具通过智能算法将多段素材自然融合,支持画中画、双重曝光、背景替换等效果,提升视频创意与质感;使用时需导入素材并分层,选择“混合模式”如滤色、叠加等,结合不透明度、位置调整实现融合;可打造情绪隐喻、时间流逝等叙事效果,增强艺术表达;避免过度使用、素材冲突等问题,善用蒙版、色彩调…

    2026年9月22日
    500
  • 使用Java Selenium验证表格数据排序:金额列的升序与降序检查

    本教程详细介绍了如何利用Java Selenium WebDriver验证网页表格中金额列的排序功能。文章涵盖了从环境配置、登录应用到数据提取、清洗、数值转换,再到实现表格数据(特别是金额数据)的升序或降序验证的完整流程。通过示例代码,演示了如何获取页面元素、处理文本数据,并使用JUnit进行断言,…

    2026年9月22日
    100
  • 抖音播放量是什么意思?抖音播放量如何变现呢

    短视频平台已成为当下最受欢迎的传播媒介之一。作为国内领先的短视频平台,抖音凭借其强大的算法推荐机制和丰富的内容生态,吸引了大量用户。而抖音播放量,作为衡量短视频传播效果的重要指标,也逐渐成为创作者和品牌方关注的重点。本文将深入解析抖音播放量的含义,探讨其背后的逻辑及影响因素,为短视频内容生产者提供有…

    2026年9月22日
    000
  • Could NOT find Doxygen (missing: DOXYGEN_EXECUTABLE)

    could not find doxygen (missing: doxygen_executable)  使用cmake .. 有时候会遇到如下问题: 代码语言:javascript代码运行次数:0运行复制 $ cmake ..– The CXX compiler identification …

    2026年9月22日
    100
  • 解决Spring Boot Actuator升级后Tomcat指标缺失问题

    本文旨在解决Spring Boot Actuator升级至2.7.0及更高版本后,部分Tomcat指标(如tomcat.cache.access、tomcat.global.error)在MetricsEndpoint中缺失的问题。通过在application.properties中配置server…

    2026年9月22日
    600
  • Laravel 8 登录后重定向到仪表盘:完整教程

    本教程详细阐述了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种方法。我们将探讨 Laravel 默认的重定向机制、如何正确配置仪表盘路由及其中间件,并提供通过自定义 LoginController 实现精确重定向的示例代码。通过本文,您将全面掌握 Laravel 认证后的重定向流程,并…

    2026年9月22日
    500
  • Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」

    Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」Ubuntu VMware Tools安装详细过程(非常靠谱)「建议收藏」

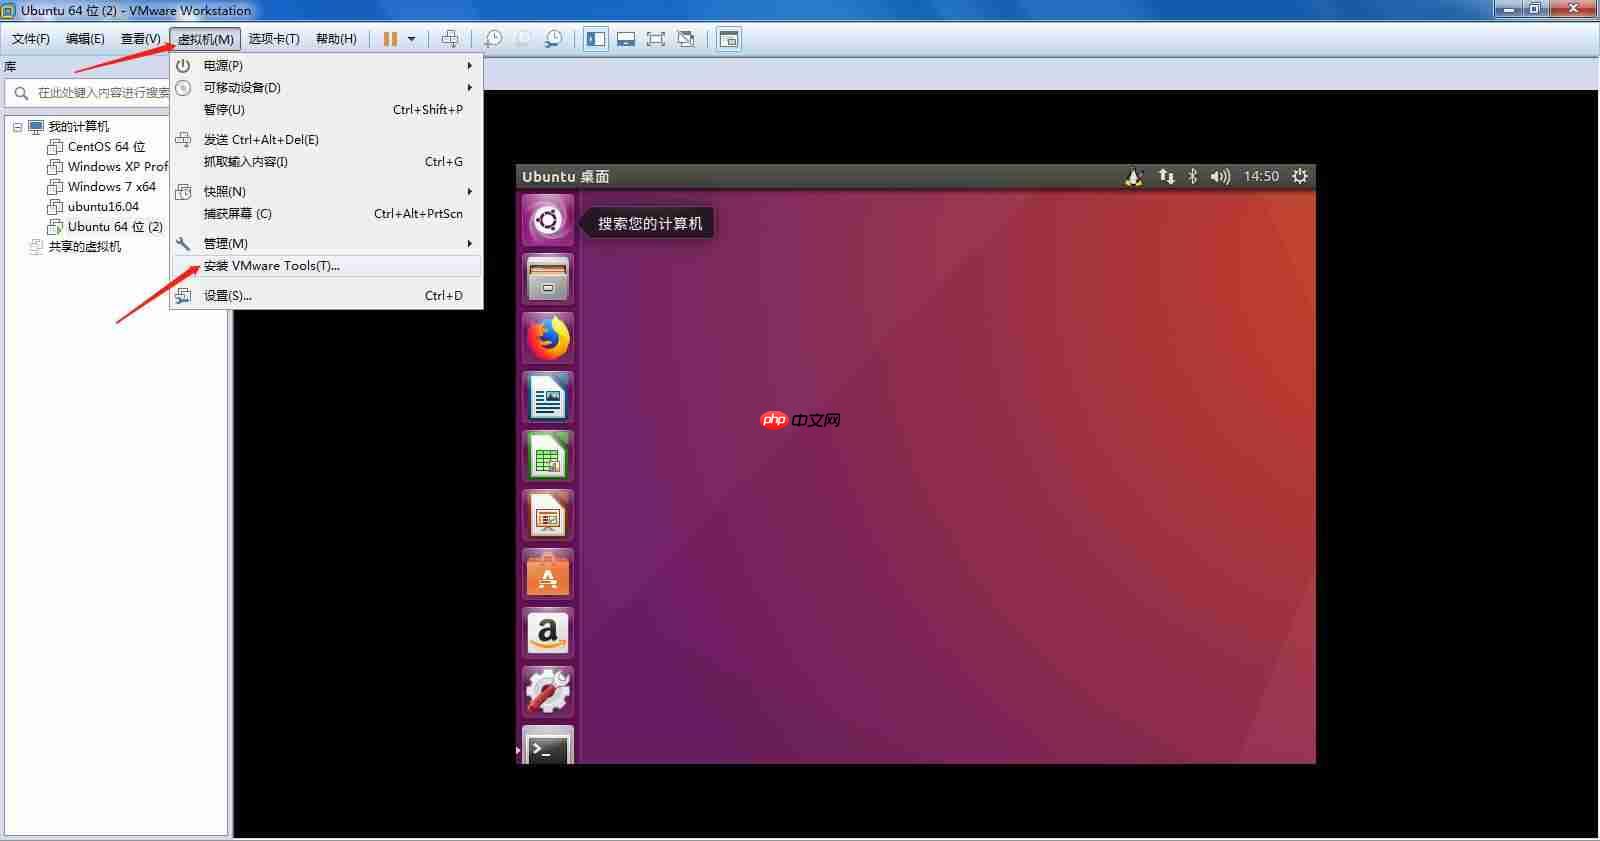
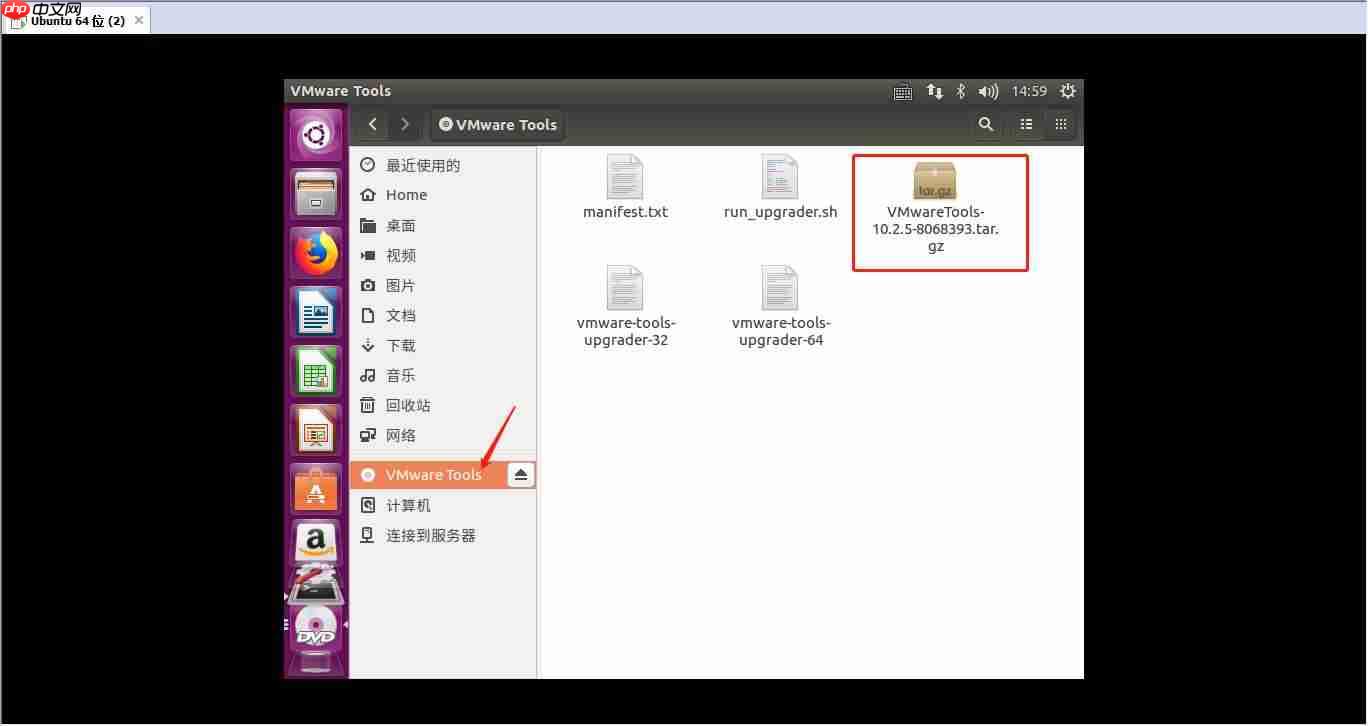
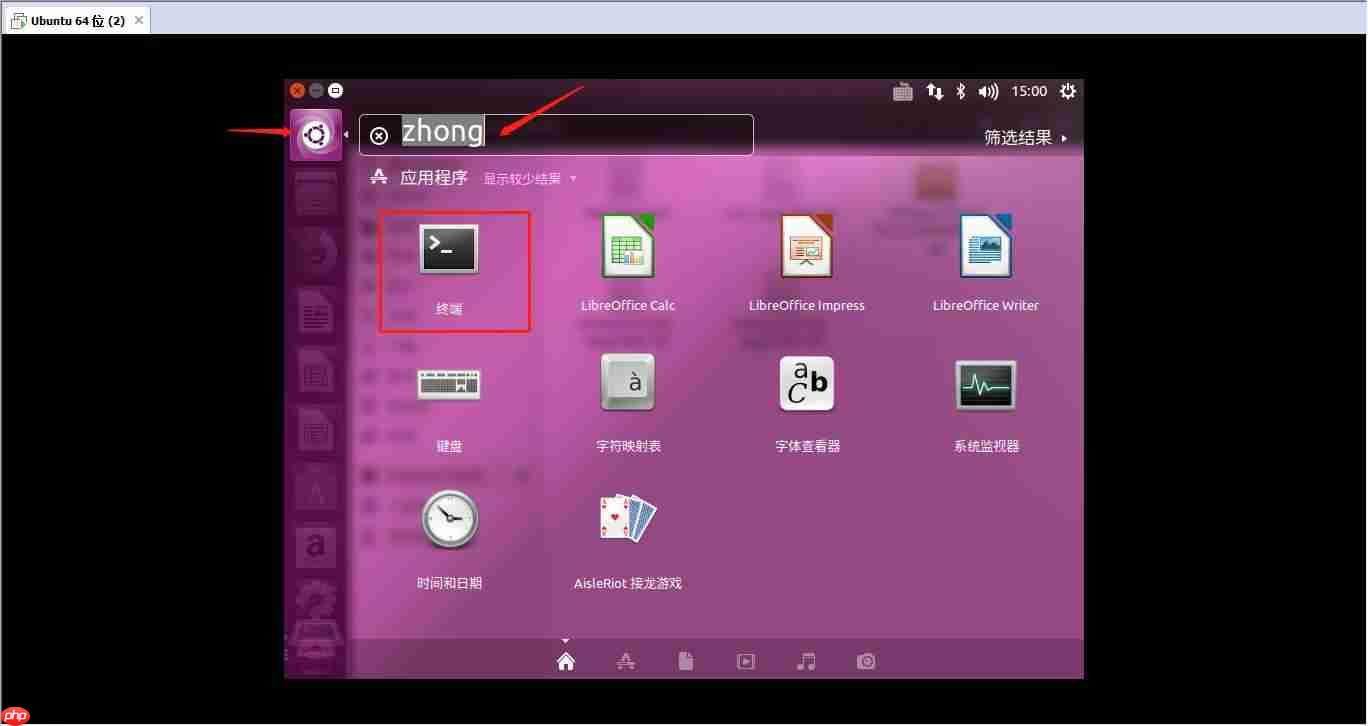
    大家好,很高兴再次与大家见面,我是你们的朋友全栈君。 说明:这篇博客是博主亲自编写的,内容独特,辛苦付出,请大家尊重原创,感谢支持! 一.前言VMware Ubuntu安装的详细指南:https://www.php.cn/link/35e7132c1742eaa9dacfedd5607b5f94。 …

    2026年9月22日 用户投稿
    900
  • VSCode如何集成Jai游戏开发环境 VSCode配置高性能游戏编程工作流

    配置#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8集成jai游戏开发环境的核心在于正确设置编译器与调试器并利用扩展提升效率,1. 配置settings.json指定jai.compilerpath、builddirectory、in…

    2026年9月22日
    500
  • mac怎么使用iMovie剪辑视频_mac使用iMovie剪辑视频教程

    首先打开iMovie并导入视频素材,然后将视频拖入时间线进行裁剪与分割,接着为片段间添加转场效果,再插入背景音乐并调节音量,最后设置参数导出视频。 如果您想在Mac上对视频进行剪辑和编辑,但不知道如何使用系统自带的iMovie应用完成操作,可以按照以下步骤进行。iMovie提供了直观的界面和基础剪辑…

    2026年9月22日
    600
  • TensorFlow的AI混合工具怎么操作?构建机器学习模型的详细步骤

    TensorFlow的混合编程核心在于结合Keras的高级抽象与TensorFlow底层API的灵活性,实现高效模型开发。首先使用tf.data构建高性能数据管道,通过map、batch、shuffle和prefetch等操作优化数据预处理;接着利用Keras快速搭建模型结构,同时通过继承tf.ke…

    2026年9月21日
    400

发表回复

登录后才能评论
关注微信