Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
如何正确读取和处理文本文件中的数据并进行计算_创想鸟

如何正确读取和处理文本文件中的数据并进行计算

如何正确读取和处理文本文件中的数据并进行计算

本文旨在帮助读者理解如何从文本文件中读取数据,进行数据处理和计算,并将结果写入新的文件。重点讲解了文本文件读取、数据分割、类型转换、字典创建、数据计算以及文件写入等关键步骤,并提供代码示例和注意事项,帮助读者避免常见的错误,从而实现高效的数据处理。

在处理文本文件中的数据时,经常需要读取文件内容,然后对每一行的数据进行分割、转换和计算。以下将详细介绍如何实现这个过程,并解决代码中可能出现的问题。

文件读取和数据分割

首先,需要正确地读取文本文件。原始代码中使用了line.strip(‘n’).split(‘n’),这可能导致每行数据被分割成包含单个字符串的列表。正确的做法是使用空格作为分隔符,并且在分割前去除行尾的空白字符。

with open(r"score1.txt",'r') as f:    a = []    for line in f:        a.append(line.strip().split()) # 使用strip()去除空白,使用split()以空格分割    print(a)

这段代码首先打开名为”score1.txt”的文件,并以只读模式(‘r’)打开。然后,它遍历文件的每一行,使用strip()方法去除行首和行尾的空白字符(包括换行符),再使用split()方法以空格为分隔符将每一行分割成一个字符串列表。最后,将这个列表添加到a列表中。

注意事项:

确保文件路径正确,如果文件不在当前工作目录下,需要提供完整的文件路径。strip()方法默认去除所有空白字符,包括空格、制表符和换行符。split()方法默认以空格为分隔符,如果文件中的数据使用其他分隔符(如逗号),则需要指定分隔符,例如split(‘,’)。

数据处理和计算

接下来,需要将分割后的数据转换为合适的数据类型,并进行计算。原始代码中使用字典来存储数据,这是一个很好的选择,但需要确保字典的键和值正确对应。此外,需要将数据类型转换为数值类型,才能进行计算。

with open(r"score1.txt",'r') as f:    student_scores = []    for line in f:        data = line.strip().split()        try:            student_id = data[0]            usual_score = int(data[1])            final_score = int(data[2])            overall_score = round(0.4 * usual_score + 0.6 * final_score)            student_scores.append((student_id, overall_score)) # 将学生ID和总评成绩添加到列表中        except (IndexError, ValueError) as e:            print(f"Error processing line: {line.strip()} - {e}")            continue  # 跳过错误行# 写入score2.txtwith open(r"score2.txt", 'w') as p:    for student_id, score in student_scores:        p.write(f"{student_id} {score}n") # 将学生ID和总评成绩写入文件

这段代码首先创建一个空列表student_scores,用于存储学生ID和总评成绩。然后,它遍历文件的每一行,将每一行分割成一个字符串列表。使用try-except块来处理可能出现的IndexError(当行的元素少于3个时)和ValueError(当无法将字符串转换为整数时)异常。在try块中,将字符串转换为整数,计算总评成绩,并将其添加到student_scores列表中。最后,将学生ID和总评成绩写入”score2.txt”文件。

注意事项:

使用try-except块来处理可能出现的异常,例如数据类型转换错误。确保数据类型转换正确,例如将字符串转换为整数或浮点数。使用round()函数对总评成绩进行四舍五入。

数据统计和输出

最后,需要统计各个分数段的学生人数,并计算平均分。

# 统计分数段人数grade_counts = {    "90+": 0,    "80-89": 0,    "70-79": 0,    "60-69": 0,    "= 90:        grade_counts["90+"] += 1    elif score >= 80:        grade_counts["80-89"] += 1    elif score >= 70:        grade_counts["70-79"] += 1    elif score >= 60:        grade_counts["60-69"] += 1    else:        grade_counts[" 0 else 0# 输出结果print(f"Total number of students: {num_students}")print("Grade distribution:")for grade, count in grade_counts.items():    print(f"{grade}: {count}")print(f"Average score: {average_score:.1f}")

这段代码首先创建一个字典grade_counts,用于存储各个分数段的学生人数。然后,它遍历student_scores列表,统计各个分数段的学生人数,并计算总分。最后,计算平均分,并输出结果。

注意事项:

确保在计算平均分之前,检查学生人数是否为0,以避免除以0的错误。使用f-string格式化输出结果,使其更易读。使用:.1f格式化平均分,保留一位小数。

完整代码示例

下面是完整的代码示例,包含了文件读取、数据处理、计算和输出:

# 读取数据with open(r"score1.txt",'r') as f:    student_scores = []    for line in f:        data = line.strip().split()        try:            student_id = data[0]            usual_score = int(data[1])            final_score = int(data[2])            overall_score = round(0.4 * usual_score + 0.6 * final_score)            student_scores.append((student_id, overall_score)) # 将学生ID和总评成绩添加到列表中        except (IndexError, ValueError) as e:            print(f"Error processing line: {line.strip()} - {e}")            continue  # 跳过错误行# 写入score2.txtwith open(r"score2.txt", 'w') as p:    for student_id, score in student_scores:        p.write(f"{student_id} {score}n") # 将学生ID和总评成绩写入文件# 统计分数段人数grade_counts = {    "90+": 0,    "80-89": 0,    "70-79": 0,    "60-69": 0,    "= 90:        grade_counts["90+"] += 1    elif score >= 80:        grade_counts["80-89"] += 1    elif score >= 70:        grade_counts["70-79"] += 1    elif score >= 60:        grade_counts["60-69"] += 1    else:        grade_counts[" 0 else 0# 输出结果print(f"Total number of students: {num_students}")print("Grade distribution:")for grade, count in grade_counts.items():    print(f"{grade}: {count}")print(f"Average score: {average_score:.1f}")

总结:

通过本文的学习,你应该能够掌握从文本文件中读取数据,进行数据处理和计算,并将结果写入新的文件。记住,正确的文件读取、数据类型转换和异常处理是成功实现数据处理的关键。

以上就是如何正确读取和处理文本文件中的数据并进行计算的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1364696.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

Python如何连接MySQL数据库?PyMySQL详细使用教程
上一篇 2025年12月14日 04:09:47
Python处理学生成绩数据:计算总评、统计分数段及计算平均分
下一篇 2025年12月14日 04:10:04

相关推荐

  • 如何在Java中实现简单的输入输出

    使用Scanner类读取键盘输入,需导入java.util.Scanner并创建实例;2. 调用nextInt、nextLine等方法获取不同类型数据,注意nextInt不读取换行符可能导致nextLine读取空字符串;3. 推荐使用后关闭Scanner;4. 输出通过System.out.prin…

    2026年9月21日
    000
  • time函数处理时间在mysql中如何操作

    MySQL中的时间函数用于处理时间数据,如获取当前时间用NOW()或CURTIME(),提取时间部分用TIME(),格式化输出用TIME_FORMAT(),时间计算可用TIMEADD()、TIMEDIFF()等函数,支持加减和差值运算,需注意字段类型与格式匹配。 在 MySQL 中,time 函数和…

    2026年9月20日
    100
  • JAXB中动态获取Java对象QName并创建JAXBElement的反射策略

    本文探讨了在jaxb中,当`jaxbintrospector.getelementname`无法获取java对象对应的`qname`时,如何通过反射机制调用`objectfactory`中生成的`create`方法来动态创建`jaxbelement`。该方法避免了大量类型判断,提高了代码的灵活性和可…

    2026年9月20日
    100
  • Python中print函数使用详解

    Python中print函数使用详解Python中print函数使用详解Python中print函数使用详解Python中print函数使用详解

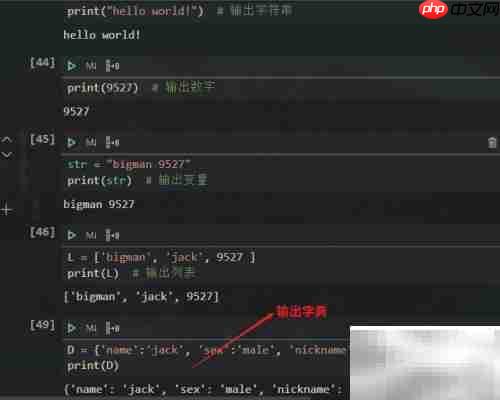
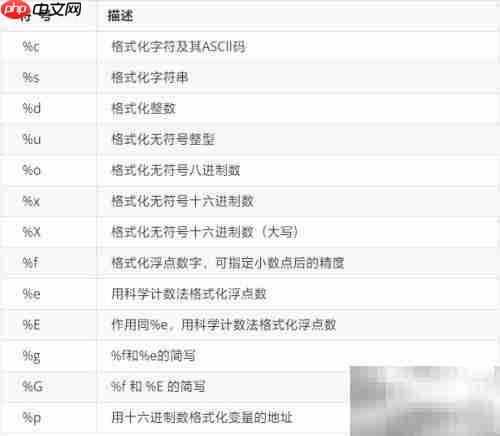
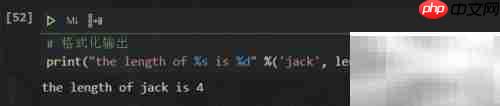
    1、 输出常见数据类型如字符串与整数 2、 对输出结果进行格式化处理 立即学习“Python免费学习笔记(深入)”; 3、 实现浮点数的格式化输出 4、 关闭自动换行功能 以上就是Python中print函数使用详解的详细内容,更多请关注创想鸟其它相关文章!

    2026年9月20日 用户投稿
    200
  • Linux输出文本echo命令应用

    echo命令不仅能输出文本,还可结合变量、转义序列和重定向实现动态内容生成、文件创建与追加、配置修改、管道处理及脚本调试,其行为在Bash、Zsh和Dash等shell中因内置实现不同而存在差异,尤其在转义序列处理上需注意使用-e选项或改用printf以保证一致性。 echo 命令在 Linux 中…

    2026年9月20日
    000
  • 如何在mysql中使用日期函数处理时间数据

    MySQL常用日期函数包括:NOW()、CURDATE()、CURTIME()获取当前时间;YEAR()、MONTH()、DAY()等提取日期部分;DATE_FORMAT()自定义格式化输出;DATE_ADD()、DATE_SUB()进行日期加减;DATEDIFF()和TIMESTAMPDIFF()…

    2026年9月12日
    100
  • 如何使用Java的LocalDate与LocalDateTime类

    LocalDate和LocalDateTime是Java 8引入的不带时区的日期时间类,分别表示年月日和年月日时分秒,适用于生日、订单时间等场景,提供now()、of()、plus/minus、isBefore/isAfter等方法支持创建、计算和比较操作,通过ChronoUnit可计算日期间隔,配…

    2026年9月11日
    100
  • 如何在Java中格式化输出内容

    最常用Java格式化输出方式是System.out.printf()和String.format()。前者直接输出到控制台,后者生成字符串;支持%d、%f、%s等占位符,可控制宽度、对齐(如%-10s)和精度(如%.2f),推荐用%n换行,结合DateTimeFormatter可格式化时间。 在Ja…

    2026年9月11日
    000
  • Java中二维数组的格式化输出:实现对齐的乘法表打印

    本文旨在指导java开发者如何优雅地格式化输出二维数组,特别是乘法表,以实现数字的整齐对齐。通过分析`arrays.tostring()`的局限性,我们将重点介绍并演示如何利用`system.out.printf()`方法及其格式化字符串功能,精确控制输出的字段宽度和对齐方式,从而生成美观且易读的表…

    2026年9月11日
    100
  • Laravel模型时间戳?时间戳怎样管理使用?

    Laravel模型默认使用时间戳以实现“约定优于配置”,自动记录数据的创建和更新时间,通过created_at和updated_at字段提供数据追踪能力。框架底层将时间戳存储为DATETIME或TIMESTAMP类型,并在模型中转换为Carbon实例,便于格式化和比较。可通过对模型设置$timest…

    2026年9月11日
    100
  • Java中DecimalFormat数字格式化详解

    答案:DecimalFormat通过模式字符串格式化浮点数,支持占位符如0、#、.、,、%等,可自定义小数位、千分位、百分比输出,示例中1234.5678用”0.00″保留两位小数得1234.57,用”#,##0.##”加千分位并省略末尾零得1,234…

    2026年9月9日
    000
  • Java中如何创建一个简易的公告发布工具

    答案:通过定义Notice类封装公告信息,使用Scanner获取用户输入标题、内容和时间,并调用toString方法格式化输出;接着利用FileWriter将公告追加写入notice.txt文件实现持久化存储;最后可扩展循环发布、历史查看和菜单功能。该工具结合类设计、控制台输入与文件I/O操作,适合…

    2026年9月9日
    000
  • Java Swing中实现按钮事件与用户输入处理的完全指南

    本教程详细介绍了如何在Java Swing应用程序中为多个按钮和文本输入框实现ActionListener。我们将学习如何通过ae.getSource()识别事件源,在actionPerformed方法中正确获取并解析用户输入,执行计算,并将结果显示到GUI界面,同时涵盖必要的错误处理机制,确保程序…

    2026年9月8日
    600
  • Vue.js中如何通过两个接口渲染表格数据并进行数据格式化?

    Vue.js:高效渲染双接口表格数据并进行格式化 本文将演示如何在Vue.js应用中,利用两个不同的接口数据渲染表格,并对其中一个接口的返回数据进行精细化格式化处理。 挑战:整合与格式化来自不同数据源的数据 我们的目标是创建一个表格,它同时显示来自两个独立API接口的数据。其中一个接口提供表格的主体…

    2026年9月7日
    200
  • JPA 中如何格式化IDEA控制台打印的SQL语句?

    优化IDEA控制台JPA SQL打印输出 使用JPA时,启用show-sql: true可以在控制台查看执行的SQL语句。然而,默认输出为单行显示,可读性差。本文介绍如何格式化SQL输出,提升可读性。 关键在于Hibernate的hibernate.format_sql属性。默认值为false,导致…

    2026年9月4日
    100
  • 告别繁琐的货币转换:Laravel Currency Converter 的高效应用

    在开发一个全球化的电商平台时,我遇到了一个棘手的问题:需要根据用户的所在地显示商品的当地货币价格。起初,我尝试使用第三方api进行汇率转换,但api的稳定性、调用频率限制以及额外的费用让我非常头疼。代码也变得冗长复杂,可维护性差。 于是我开始寻找更优雅的解决方案,最终发现了 mgcodeur/lar…

    用户投稿 2026年9月3日
    1000
  • 如何将扁平的章节数据转换为嵌套的树形结构?

    本文介绍如何将扁平的章节数据转换为嵌套的树形结构。假设我们有一个扁平数组,每个对象包含 level(层级)、content(内容)和 url(链接)字段,表示章节的层级、内容和 URL。我们需要将其转换为嵌套的树形结构,其中每个父节点包含其子节点,子节点的 level 值大于父节点。 原始数据结构:…

    2026年9月3日
    000
  • CodeIgniter4中通过服务优化内存:实现库的共享实例管理

    在CodeIgniter4应用中,当存在大量跨控制器和库使用的通用逻辑文件(如数据处理、内容过滤、表单计算等)时,频繁实例化这些类可能导致内存浪费。本文将介绍如何利用CodeIgniter4的服务(Services)机制,为这些通用库提供共享实例,从而有效优化内存使用,提高应用性能,并确保逻辑的一致…

    2026年9月2日
    100
  • Next.js Route Handlers 中console.log打印对象为何出现[Symbol(state)]和[Request]等特殊属性?

    深入探讨 node.js 中终端对象打印的细节 在 Next.js 的 Route Handlers 中,使用 console.log 打印对象时,常常会遇到一些令人困惑的输出格式,例如打印 request 对象时,输出结果包含了诸如 [Symbol(state)]、[Request] 等特殊属性和…

    用户投稿 2026年8月31日
    100
  • # Laravel 中高效加载关联模型 ID 数组的实践指南

    本文旨在介绍如何在 Laravel 中高效地加载关联模型的 ID 数组,避免多次使用 `transform` 函数,并通过 `pluck` 方法、循环处理以及使用查询构建器等多种方式,优化数据查询性能,最终提供简洁且高效的代码示例。在 Laravel 开发中,经常会遇到需要加载关联模型,并且只需要关…

    2026年8月29日
    400

发表回复

登录后才能评论
关注微信