Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
使用 Python 递归处理结构化文本文件并提取特定数据_创想鸟

使用 Python 递归处理结构化文本文件并提取特定数据

使用 Python 递归处理结构化文本文件并提取特定数据

本文详细介绍了如何使用 Python 递归遍历目录下的 .txt 文件,并高效地解析其中结构化的网络速度数据。通过将文件内容按固定行数分块处理,并结合专门的函数进行数据提取、类型转换和格式化输出,实现对下载和上传速度的精确分析与报告。该方法适用于处理具有一致内部结构的大量文本文件。

1. 问题背景与分析

在日常的数据处理任务中,我们经常需要从大量具有相似结构但内容各异的文本文件中提取特定信息。本教程将以一个具体场景为例:从一个包含多层子目录的系统中,查找所有 .txt 文件。每个 .txt 文件都包含两个逻辑部分,每个部分由固定数量的行组成,并以特定标识符(例如 >)分隔。我们的目标是从每个部分的特定行中,提取“下载速度”和“上传速度”的数据,并根据其数值进行条件判断和格式化输出。

示例文件结构如下,其中每个逻辑部分(由 > 引导)固定包含 8 行:

> this is first output and some another contentsthese aresome test linesto fill the fileTesting download speedDownload: 0.00 Mbit/sTesting upload speedUpload: 0.00 Mbit/s> this is second output but other texts go here toothese aresome test linesto fill the fileTesting download speedDownload: 1200.58 Mbit/sTesting upload speedUpload: 857.25 Kbit/s

我们需要对每个文件的每个部分的“Download:”和“Upload:”行进行解析,提取速度值和单位,并根据预设的条件(例如速度为零、小于 600 Mbit/s 等)输出不同的信息。

2. 解决方案概述

为了高效且健壮地解决此类问题,我们采用以下策略:

递归文件查找: 使用 pathlib 库递归地查找所有目标文件。文件内容分块: 由于文件结构一致,每个逻辑部分行数固定,我们可以将文件内容按固定大小分块,将每个逻辑部分视为一个独立的数据块。数据提取与转换: 编写辅助函数,从指定行中解析出速度值(浮点数)和单位(字符串)。结果格式化: 编写辅助函数,根据提取的速度值和单位,生成符合要求的输出字符串。模块化设计: 将不同的功能封装在独立的函数中,提高代码的可读性和可维护性。

3. 具体实现步骤

3.1 定义常量与文件查找

首先,我们需要定义文件中每个逻辑部分的行数以及文件包含的逻辑部分数量。然后,使用 pathlib 库进行递归文件查找。

立即学习“Python免费学习笔记(深入)”;

import sysfrom pathlib import Path# 定义常量:每个逻辑部分的行数,以及文件包含的逻辑部分数量LINES_PER_PART = 8PARTS_PER_FILE = 2 # 根据示例文件,每个文件有两部分def main():    # 递归查找当前目录及其子目录下所有 .txt 文件    result = list(Path(".").rglob("*.txt"))    for filename in result:        with open(filename, 'r') as file:            # 读取文件所有行            lines = file.readlines()            # ... 后续处理 ...

3.2 文件内容分块函数

为了将文件的所有行按固定大小(LINES_PER_PART)分割成多个逻辑部分,我们定义一个 chunks 函数。

def chunks(arr, chunk_size):    """    将列表 arr 分割成大小为 chunk_size 的块。    """    result = []    for i in range(0, len(arr), chunk_size):        result.append(arr[i:i+chunk_size])    return result

在 main 函数中调用此函数:

# ... (在 main 函数内部)            lines = file.readlines()            parts = chunks(lines, LINES_PER_PART) # 将文件内容分块# ...

3.3 速度信息解析函数

parse_speed_info 函数负责从包含速度信息的字符串中提取数值和单位。它假定速度值是字符串的第二个单词,单位是第三个单词。

def parse_speed_info(string):    """    从速度信息字符串中解析出速度值(浮点数)和单位。    示例输入: "Download: 1200.58 Mbit/sn"    示例输出: (1200.58, "Mbit/s")    """    # 忽略 "Download:" 或 "Upload:" 部分,从第二个单词开始解析    speed_info_list = string.split()[1::]    # 返回速度值(转换为浮点数)和单位    return (        float(speed_info_list[0]),        speed_info_list[1].strip() # 移除单位末尾的换行符    )

3.4 速度信息格式化函数

stringify_speed_info 函数根据解析出的速度值和单位,生成符合特定条件(如零、小于 600)的报告字符串。

def stringify_speed_info(speed, unit):    """    根据速度值和单位,生成格式化的输出字符串。    """    if speed == 0:        return "zero"    elif unit == "Mbit/s" and speed < 600.0: # 仅对 Mbit/s 单位进行小于600的判断        return f"less than 600 {unit}"    else:        return f"{speed} {unit}"

注意: 原始问题中对“小于 600”的判断仅针对 Mbit/s 单位,此处已在代码中体现。

3.5 遍历分块并输出结果

在 main 函数中,遍历 parts 列表,对每个逻辑部分提取并处理下载和上传速度信息。根据示例文件结构,下载速度信息在倒数第 3 行 (part[-3]),上传速度信息在最后一行 (part[-1])。

# ... (在 main 函数内部)            parts = chunks(lines, LINES_PER_PART)            for i, part in enumerate(parts, 1): # i 从 1 开始计数,表示第几部分                # 下载速度信息在当前部分的倒数第三行                download_info = parse_speed_info(part[-3])                # 上传速度信息在当前部分的最后一行                upload_info = parse_speed_info(part[-1])                # 打印格式化后的结果                print(f"Download{i} speed of {filename} is {stringify_speed_info(*download_info)}.")                print(f"Upload{i} speed of {filename} is {stringify_speed_info(*upload_info)}.")                print() # 每处理完一个文件的一部分后打印空行# ...

3.6 完整代码

将上述所有部分整合,形成完整的 Python 脚本。

#!/usr/bin/python3from pathlib import Path# 定义常量:每个逻辑部分的行数LINES_PER_PART = 8def chunks(arr, chunk_size):    """    将列表 arr 分割成大小为 chunk_size 的块。    """    result = []    for i in range(0, len(arr), chunk_size):        result.append(arr[i:i+chunk_size])    return resultdef parse_speed_info(string):    """    从速度信息字符串中解析出速度值(浮点数)和单位。    示例输入: "Download: 1200.58 Mbit/sn"    示例输出: (1200.58, "Mbit/s")    """    speed_info_list = string.split()[1::] # 忽略 "Download:" 或 "Upload:" 部分    return (        float(speed_info_list[0]),        speed_info_list[1].strip() # 移除单位末尾的换行符    )def stringify_speed_info(speed, unit):    """    根据速度值和单位,生成格式化的输出字符串。    """    if speed == 0:        return "zero"    elif unit == "Mbit/s" and speed < 600.0:        return f"less than 600 {unit}"    else:        return f"{speed} {unit}"def main():    """    主函数:执行文件查找、解析和结果输出。    """    # 递归查找当前目录及其子目录下所有 .txt 文件    result = list(Path(".").rglob("*.txt"))    for filename in result:        try:            with open(filename, 'r') as file:                lines = file.readlines()                # 将文件内容按固定行数分块                parts = chunks(lines, LINES_PER_PART)                # 遍历每个逻辑部分                for i, part in enumerate(parts, 1):                    # 检查部分行数是否符合预期,避免索引错误                    if len(part) != LINES_PER_PART:                        print(f"Warning: File {filename}, Part {i} has unexpected line count ({len(part)} lines). Skipping.")                        continue                    # 下载速度信息在当前部分的倒数第三行                    download_info = parse_speed_info(part[-3])                    # 上传速度信息在当前部分的最后一行                    upload_info = parse_speed_info(part[-1])                    # 打印格式化后的结果                    print(f"Download{i} speed of {filename} is {stringify_speed_info(*download_info)}.")                    print(f"Upload{i} speed of {filename} is {stringify_speed_info(*upload_info)}.")                    print() # 每处理完一个文件的一部分后打印空行        except Exception as e:            print(f"Error processing file {filename}: {e}", file=sys.stderr)if __name__ == "__main__":    main()

4. 注意事项与总结

文件结构一致性: 本方案的核心假设是所有 .txt 文件都具有严格一致的内部结构,即每个逻辑部分都包含固定数量的行(LINES_PER_PART),并且速度信息始终位于这些部分的固定相对位置。如果文件结构不一致,例如行数不固定或信息位置变化,则需要更复杂的解析逻辑(如基于正则表达式或关键词搜索)。错误处理: 在完整代码中加入了简单的 try-except 块来捕获文件打开或处理过程中的异常,并增加了对 part 长度的检查,以提高程序的健壮性。在实际应用中,可以根据需求增加更详细的错误日志记录和处理机制。内存效率: 对于非常大的文件,file.readlines() 会一次性将所有内容加载到内存中。如果文件大小达到 GB 级别,这可能会导致内存溢出。对于此类情况,可以考虑逐行读取文件,并使用一个缓冲区来构建每个 part,或者使用生成器(yield)来优化 chunks 函数,实现惰性加载。但对于本例中每个文件只有两部分、每部分 8 行的场景,readlines() 是完全可接受的。可扩展性: 通过将解析和格式化逻辑封装在单独的函数中,代码的可读性和可维护性得到了显著提升。如果未来需要提取其他类型的数据或改变输出格式,只需修改相应的函数即可,而无需改动主处理逻辑。

通过上述方法,我们能够高效、准确地从结构化文本文件中提取所需数据,并根据业务逻辑进行灵活的展示。这种分而治之、模块化设计的思想在处理复杂数据解析任务时尤为重要。

以上就是使用 Python 递归处理结构化文本文件并提取特定数据的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1364739.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python教程:递归解析分段日志文件中的性能数据
上一篇 2025年12月14日 04:11:50
Tkinter中为单个字符设置不同字体大小的实现方法
下一篇 2025年12月14日 04:11:59

相关推荐

  • Linux平台下的Eclipse配置

    在linux平台上配置eclipse时,可能会遇到一些常见的问题和优化需求。本文将详细介绍如何解决这些问题,并提供优化eclipse的建议。 启动Eclipse报错 启动Eclipse时,如果遇到以下错误: A Java Runtime Environment (JRE) or Java Devel…

    2026年9月22日
    000
  • 怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法

    怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法

    最实用的方法是使用iCloud共享相簿,它支持情侣间视频快速上传与实时同步。首先双方需开启iCloud照片中的共享相簿功能,然后创建专属相簿并邀请对方加入。此后,任一方添加的视频会自动同步至对方设备,且不占用个人iCloud空间。相比AirDrop(限近距离)、即时通讯工具(压缩画质)或云盘(占存储…

    2026年9月22日 • 用户投稿
    000
  • AdobeIllustrator如何导出AI生成的图片?矢量图像保存的步骤

    首先明确输出需求,再选择“文件>导出>导出为…”或“文件>存储为…”,根据用途选取合适格式如SVG、PDF或AI,确保矢量信息保留,参数设置需匹配目标平台要求。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Adob…

    2026年9月22日
    000
  • PHP面向对象开发:解决父类构造器参数在嵌套子对象方法中丢失的问题

    在PHP面向对象编程中,我们经常会遇到类继承和对象组合的场景。一个常见的问题是,当父类构造函数接收参数并用于初始化内部的子对象时,该子对象的方法在后续调用中可能无法正确访问到这些参数,甚至显示为null。本文将深入探讨这一问题,并提供两种有效的解决方案。 引言与问题阐述 考虑一个典型的web应用架构…

    2026年9月22日
    000
  • 使用MockWebServer对FeignClient进行单元测试

    本文详细阐述了如何利用Spring Cloud LoadBalancer和MockWebServer对FeignClient进行高效单元测试。通过在测试配置中动态注册MockWebServer实例,并将其作为FeignClient的服务发现目标,开发者可以精确模拟后端API的行为,包括各种HTTP响…

    2026年9月22日
    000
  • Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力

    Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力Sublime快速定位MySQL死锁与阻塞问题_提高系统稳定性与并发处理能力

    mysql死锁和阻塞问题可通过sublime分析日志排查。1.使用关键词搜索及正则匹配快速定位死锁信息块;2.通过查找waiting状态事务并折叠无关内容聚焦阻塞链;3.结合general log与事务id查找sql执行顺序;4.利用语法高亮、列选择等功能提升日志可读性。这些方法能有效提高排查效率。…

    2026年9月22日 • 用户投稿
    100
  • Canva中AI生成图片如何导出?教你快速保存设计作品的方法

    答案:Canva中导出AI生成图片的操作与普通图片相同,点击右上角“分享”按钮,选择“下载”,可选PNG、JPG、PDF、SVG、MP4或GIF等格式;为保证画质,建议优先选用PNG格式,避免有损压缩,同时选择高分辨率和合适尺寸,Pro用户可进一步调整质量与透明背景设置;除下载外,还可通过分享链接、…

    2026年9月22日
    800
  • Linux系统中文件属性和权限实战操作

    Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作Linux系统中文件属性和权限实战操作

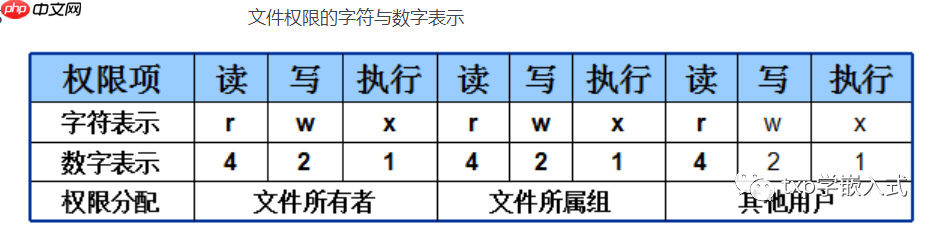
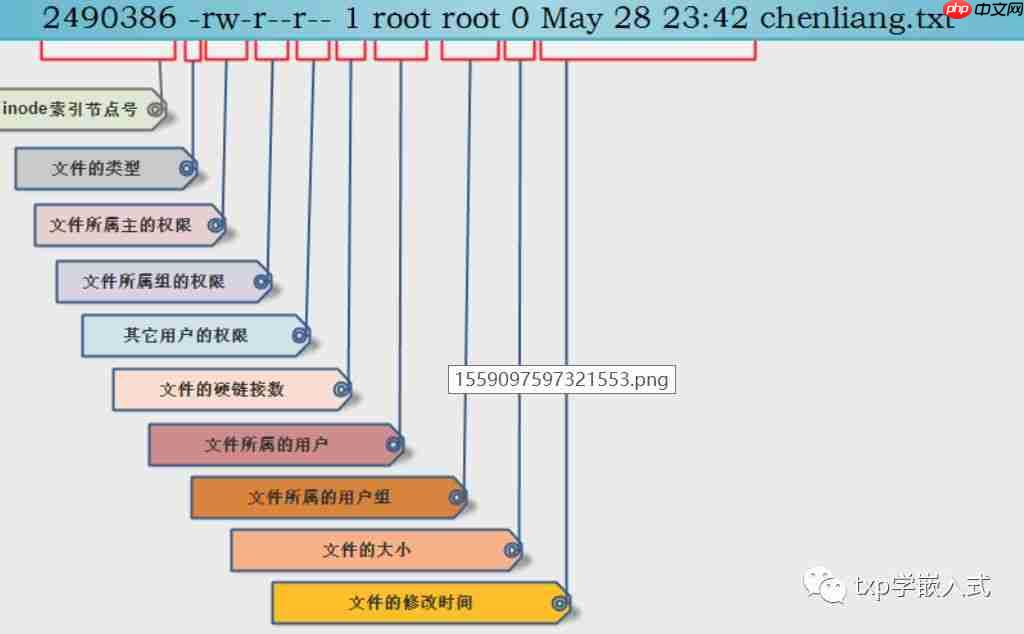
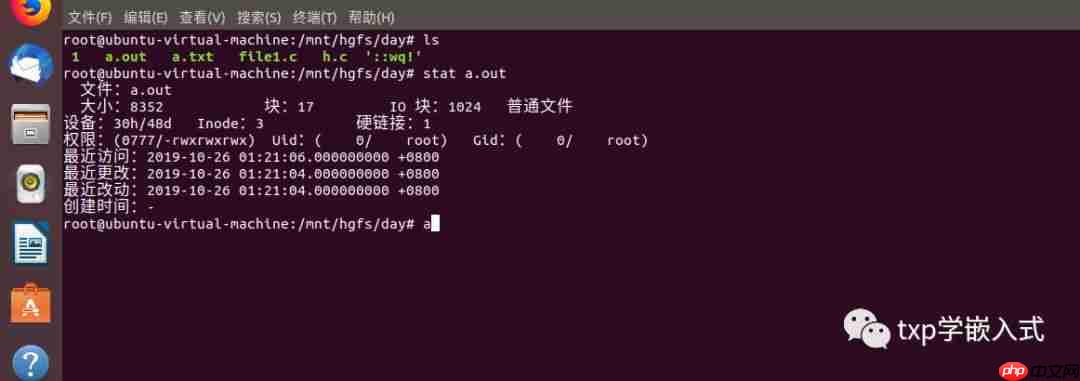
    —–原本今天的文章是昨天晚上就要更新的,但是由于昨天晚上下班回到住的地方,发现停电了,所以就没写成。今天是在上一篇文章–linux系统中文件类型的基础上,继续进行深入的学习。好了,直接开干。 一、文件的操作权限: 1、在这之前我想还是很有必要介绍对文件的操作权限(…

    2026年9月22日 • 用户投稿
    000
  • PHP中为数组元素设置默认值的最佳实践:使用Null合并运算符

    本教程将介绍如何在PHP中为数组元素设置默认值,尤其当源数据可能为空或缺失时。通过利用PHP 7+提供的Null合并运算符(??),可以简洁高效地实现这一需求,避免冗长的条件判断,提高代码可读性和健壮性。 引言:处理缺失或空值时的数组赋值 在Web开发中,我们经常需要从用户请求、数据库查询或其他外部…

    2026年9月22日
    000
  • VSCode快速配置Dart:Flutter开发、中文提示、热加载

    安装vscode并下载flutter sdk,解压至无中文或特殊字符的路径;2. 将flutter sdk的bin目录添加到系统环境变量path中;3. 打开新终端执行flutter doctor,根据提示安装缺失的依赖;4. 在vscode扩展商店安装dart和flutter扩展;5. 确保在调试…

    2026年9月22日
    200
  • Inkscape如何导出AI生成的矢量图片?教你快速保存图像的步骤

    答案:在Inkscape中导出矢量图需根据用途选择格式,网页用优化SVG并转文本为路径,印刷则导出为PDF/EPS、转文字为路径、确保高分辨率位图,同时注意颜色模式与出血设置。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在Inkscap…

    2026年9月22日
    700
  • Laravel 8 登录后重定向至仪表盘的策略与实践

    本教程详细阐述了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种策略。我们将探讨如何通过配置 LoginController 的 $redirectTo 属性、利用 RouteServiceProvider 定义常量以及在自定义登录方法中进行精确控制来管理重定向流程。文章还涵盖了相关中间…

    2026年9月22日
    000
  • VSCode配置GDB调试器 深入掌握VSCode调试C程序技巧

    配置vscode中gdb调试c程序的核心是正确设置tasks.json和launch.json;2. tasks.json负责使用gcc -g编译生成带调试信息的可执行文件,确保prelaunchtask与launch.json中的program路径一致;3. launch.json指定调试器gdb…

    2026年9月22日
    100
  • java定时任务之quartz

    大家好,很高兴再次与大家见面,我是你们的朋友全栈君。 一、Quartz简介 在企业应用中,我们常常需要处理定时任务调度,比如每天凌晨生成前一天的报表,每小时生成一次汇总数据等。Quartz是一个著名的任务调度框架,它可以与J2SE和J2EE应用结合,功能非常强大,易于与Spring集成,使用起来非常…

    2026年9月22日
    100
  • Sublime支持MySQL触发日志写入模块_便于数据变更监控与溯源分析

    Sublime支持MySQL触发日志写入模块_便于数据变更监控与溯源分析Sublime支持MySQL触发日志写入模块_便于数据变更监控与溯源分析Sublime支持MySQL触发日志写入模块_便于数据变更监控与溯源分析Sublime支持MySQL触发日志写入模块_便于数据变更监控与溯源分析

    sublime可通过插件实现与mysql联动监控触发器日志写入。具体步骤如下:1.安装package control、mysql语法高亮、构建系统等插件;2.创建日志表并编写触发器记录数据变更;3.配置.sublime-build文件调用mysql命令行执行sql脚本;4.使用快捷键提升日志查询和处…

    2026年9月22日 • 用户投稿
    000
  • Java中异常处理与方法返回值结合

    异常发生时不应返回默认值,而应通过抛出异常或使用Optional、自定义结果类等方式明确传递错误信息,确保调用方能正确处理失败情况,提升代码健壮性与可读性。 在Java中,异常处理与方法返回值的结合是一个常见的编程问题。理解它们之间的关系有助于写出更健壮、可读性更强的代码。当一个方法可能发生异常时,…

    2026年9月22日
    000
  • tk做养生类目起号前期发什么视频?tk表示什么类目?

    在TikTok上运营养生类账号,起号阶段的内容策略尤为关键。优质的内容不仅能快速吸引目标用户,还能为后续发展奠定良好基础。本文将深入解析初期应发布的视频类型,并澄清“TK”所指的平台属性及内容分类体系。 一、养生类目起号初期适合发布哪些视频内容? 刚开始做养生赛道时,重点不在于变现,而在于建立专业形…

    2026年9月22日
    000
  • PHP如何利用缓存优化实时输出_PHP实时输出与缓存结合优化

    PHP实时输出需结合输出缓冲控制与flush()强制推送,同时考虑服务器和浏览器缓存影响;2. 长时间任务应使用APCu或Redis缓存频繁数据,避免重复计算;3. 动态页面可采用分块输出与片段缓存策略,静态内容从缓存读取,动态部分边生成边输出;4. 更优方案是通过异步任务与Redis存储进度,前端…

    2026年9月22日
    000
  • 华为天际通Go将支持eSIM:设备在路上了

    华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了华为天际通Go将支持eSIM:设备在路上了

    9月3日消息,今年的iphone 17 air将仅支持esim,彻底移除实体sim卡槽结构。随着新品发布日期的临近,国内esim政策的进展也愈发引人关注。 然而综合多方信息来看,iPhone 17 Air国行版本可能无法赶上首发,因前期在国内无法使用eSIM服务,导致该机型短期内难以在国内上市。 相…

    2026年9月22日 • 用户投稿
    000
  • VSCode配置C语言调试环境 从零开始VSCode搭建C开发工具

    要从零开始在#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8中搭建c语言开发和调试环境,首先需安装vscode本体、c/c++编译器(如mingw或gcc)并配置系统环境变量,接着安装vscode的c/c++扩展,然后创建项目并编写c…

    2026年9月22日
    000

发表回复

登录后才能评论
关注微信