Python Asyncio 中背景任务的顺序执行与并发管理

Python Asyncio 中背景任务的顺序执行与并发管理

本文探讨在 Python asyncio 应用中,如何有效管理并发背景任务,确保特定任务(如数据保存)按顺序执行,避免任务重叠。我们将介绍两种核心策略:通过等待前一个任务完成来阻塞后续启动,以及利用 asyncio.Queue 解耦生产者与消费者,实现任务的有序处理。这两种方法有助于在保持异步优势的同时,解决资源竞争和逻辑顺序问题,确保数据完整性和系统稳定性。

在异步编程中,我们经常需要在后台执行耗时操作,以避免阻塞主程序的运行。python 的 asyncio 库提供了强大的协程和事件循环机制来实现这一目标。然而,当多个相同的后台任务可能并发执行时,有时我们需要确保这些任务按照特定顺序或一次只运行一个实例,以避免资源冲突或数据混乱。

考虑一个常见场景:应用程序持续收集数据,并在每个批次收集完成后将其保存。为了提高效率,数据保存操作被设计为后台任务。但如果数据收集速度快于数据保存速度,或者批次大小差异大,可能导致新的保存任务在旧的保存任务完成之前就开始执行,从而引发问题。例如,当 save_data() 协程被多次并发调用时,我们希望它能像单例模式一样,确保前一个保存操作完成后,下一个才能开始。

import asyncioimport randomasync def save_data():    """模拟数据保存操作"""    print("我正在保存一个批次的数据...")    await asyncio.sleep(2) # 模拟IO耗时    print("一个批次的数据保存完成。")async def collect_data_problematic():    """存在并发保存问题的示例"""    event_loop = asyncio.get_event_loop()    while True:        print("我正在收集数据...")        await asyncio.sleep(random.randint(1, 5)) # 模拟数据收集耗时        # 直接创建任务,可能导致多个save_data并发运行        event_loop.create_task(save_data())# asyncio.run(collect_data_problematic())

上述代码中,save_data() 可能会被多次并发调用,导致数据保存逻辑混乱。为了解决这个问题,我们可以采用以下两种策略。

策略一:等待前一个任务完成(阻塞式协调)

这种方法的核心思想是:在启动新的后台任务之前,先检查是否存在一个正在运行的同类型任务。如果存在,则等待它完成。这类似于双缓冲机制,确保每次只有一个保存任务在活动。

import asyncioimport randomasync def save_data():    """模拟数据保存操作"""    print("我正在保存一个批次的数据...")    await asyncio.sleep(2) # 模拟IO耗时    print("一个批次的数据保存完成。")async def collect_data_await_previous():    """通过等待前一个任务完成来协调"""    event_loop = asyncio.get_event_loop()    last_save_task = None # 用于跟踪上一个保存任务    while True:        print("我正在收集数据...")        await asyncio.sleep(random.randint(1, 5)) # 模拟数据收集耗时        if last_save_task: # 如果存在上一个保存任务            print("等待上一个保存任务完成...")            await last_save_task # 阻塞直到上一个保存任务完成            print("上一个保存任务已完成,可以开始新的保存。")        # 启动新的保存任务并更新last_save_task        last_save_task = event_loop.create_task(save_data())    # 循环结束后,确保最后一个保存任务也完成    if last_save_task:        await last_save_task# 运行示例# asyncio.run(collect_data_await_previous())

优点:

立即学习“Python免费学习笔记(深入)”;

简单直观: 实现逻辑相对简单,易于理解。顺序保证: 严格保证了 save_data 任务的顺序执行,不会出现重叠。

缺点:

性能瓶颈: 如果数据收集速度远快于数据保存速度,或者保存任务耗时很长,collect_data_await_previous 协程会被 await last_save_task 阻塞,导致数据收集也停滞,影响整体吞吐量。这使得并发优势部分丧失。不适用于多任务队列: 无法在后台排队处理多个待保存批次。

策略二:使用 asyncio.Queue 实现解耦(生产者-消费者模式)

为了解决阻塞问题并提高并发效率,同时仍保证保存任务的顺序性,我们可以采用生产者-消费者模式,利用 asyncio.Queue 来解耦数据收集和数据保存过程。数据收集器作为生产者,将待保存的数据批次放入队列;一个或多个消费者(这里我们只用一个,以保证顺序)从队列中取出数据并执行保存操作。

import asyncioimport randomasync def save_data_batch(batch_data):    """模拟数据保存操作,接受批次数据"""    print(f"我正在保存批次: {batch_data}...")    await asyncio.sleep(2) # 模拟IO耗时    print(f"批次: {batch_data} 保存完成。")async def collect_data_with_queue():    """使用asyncio.Queue协调数据收集与保存"""    event_loop = asyncio.get_event_loop()    # 创建一个有最大容量的队列,防止内存耗尽    # maxsize=16 表示队列最多能存储16个待处理的批次    queue = asyncio.Queue(maxsize=16)     async def save_all_batches():        """消费者协程:从队列中取出数据并保存"""        while True:            try:                batch = await queue.get() # 等待并获取一个批次                await save_data_batch(batch) # 执行保存操作                queue.task_done() # 标记该任务已完成            except asyncio.CancelledError:                # 协程被取消时退出循环,实现优雅关闭                print("保存任务被取消,退出。")                break            except Exception as e:                print(f"保存任务发生错误: {e}")                queue.task_done() # 即使出错也要标记完成,防止queue.join()死锁    # 启动后台保存任务    saving_task = event_loop.create_task(save_all_batches())    batch_counter = 0    while True:        print("我正在收集数据...")        await asyncio.sleep(random.randint(1, 5)) # 模拟数据收集耗时        batch_counter += 1        batch_data = f"Batch-{batch_counter}" # 模拟收集到的数据批次        # 将数据放入队列,如果队列满则等待        print(f"将 {batch_data} 放入队列...")        await queue.put(batch_data)         print(f"{batch_data} 已放入队列。")    # 优雅关闭:等待所有队列中的任务完成,然后取消保存任务    # 注意:实际应用中,通常会有一个外部信号来触发退出循环    # await queue.join() # 等待所有放入队列的任务被处理    # saving_task.cancel() # 取消后台保存任务    # await saving_task # 确保取消操作完成

优点:

立即学习“Python免费学习笔记(深入)”;

高吞吐量: 数据收集和数据保存可以并发进行,互不阻塞,只要队列不满,收集器就可以持续工作。解耦: 生产者和消费者之间通过队列完全解耦,提高了模块的独立性。流量控制: maxsize 参数可以限制队列的内存占用,防止收集速度过快导致内存耗尽(背压机制)。顺序保证: 尽管是并发的,但由于只有一个消费者 save_all_batches 实例从队列中取数据,因此保存操作仍然是严格顺序的。

缺点及注意事项:

复杂度增加: 相较于第一种方法,需要管理队列、消费者协程以及更复杂的错误处理和优雅关闭逻辑。死锁风险: 如果消费者协程 save_all_batches 因异常退出,而 queue.task_done() 未被调用,或者 queue.join() 被调用时队列中仍有未处理的任务,可能导致 queue.join() 永久等待,造成死锁。因此,在 try…except 块中确保 queue.task_done() 被调用至关重要。优雅关闭: 实际应用中,需要一个机制来停止 collect_data_with_queue 的无限循环,并在程序退出前确保所有队列中的数据都被保存。这通常涉及捕获信号或使用事件标志来协调协程的退出。

总结与选择

选择哪种策略取决于具体的应用场景和性能需求:

选择策略一(等待前一个任务完成):

当需要严格控制并发实例数量,且允许主流程在后台任务完成时短暂暂停时。当后台任务的执行频率不高,或者其耗时相对较短,不会对主流程造成明显阻塞时。追求代码实现简洁性时。

选择策略二(使用 asyncio.Queue):

当数据收集和处理流程需要高度解耦,以实现最大化吞吐量时。当后台任务可能耗时较长,且希望主流程(如数据收集)尽可能不被阻塞时。需要实现背压机制,防止系统过载时。愿意接受更高的代码复杂度,以换取更好的并发性能和系统健壮性。

在大多数需要高并发和高吞吐量的 asyncio 应用中,使用 asyncio.Queue 的生产者-消费者模式是更推荐的方案,因为它提供了更灵活的并发控制和更强的系统韧性。但无论选择哪种方法,都应仔细考虑错误处理和程序的优雅关闭,以确保系统的稳定运行。

以上就是Python Asyncio 中背景任务的顺序执行与并发管理的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1364791.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
解决Django Djongo连接MongoDB时PyMongo版本兼容性问题
上一篇 2025年12月14日 04:14:28
Python Asyncio:确保后台任务顺序执行的策略
下一篇 2025年12月14日 04:14:44

相关推荐

  • 联想城市超级智能体荣获”2025数字政府创新解决方案”奖 引领智慧城市4.0新时代

    联想城市超级智能体荣获”2025数字政府创新解决方案”奖 引领智慧城市4.0新时代联想城市超级智能体荣获”2025数字政府创新解决方案”奖 引领智慧城市4.0新时代联想城市超级智能体荣获”2025数字政府创新解决方案”奖 引领智慧城市4.0新时代联想城市超级智能体荣获”2025数字政府创新解决方案”奖 引领智慧城市4.0新时代

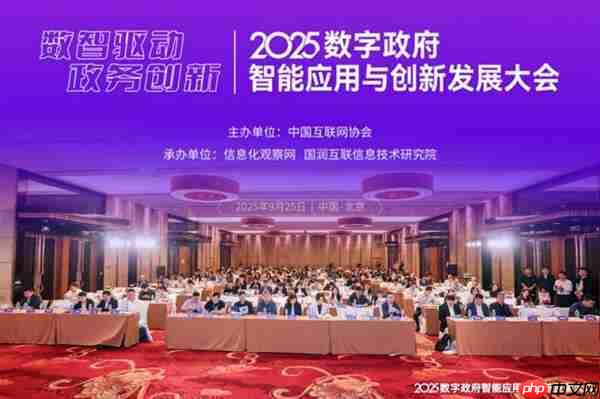
    9月25日,由中国互联网协会主办的“2025数字政府智能应用与创新发展大会”隆重召开。联想城市超级智能体凭借其领先的技术架构和广泛的实践成果,荣获“2025数字政府创新解决方案”大奖,成为推动数字政府建设的典范案例。 权威认证加持,“联想方案”引领全球智慧城市建设风向 本届大会以“数智驱动 政务创新…

    2026年9月27日 • 用户投稿
    000
  • 联想小新平板Pro GT配置公布:搭载第三代骁龙8旗舰SOC

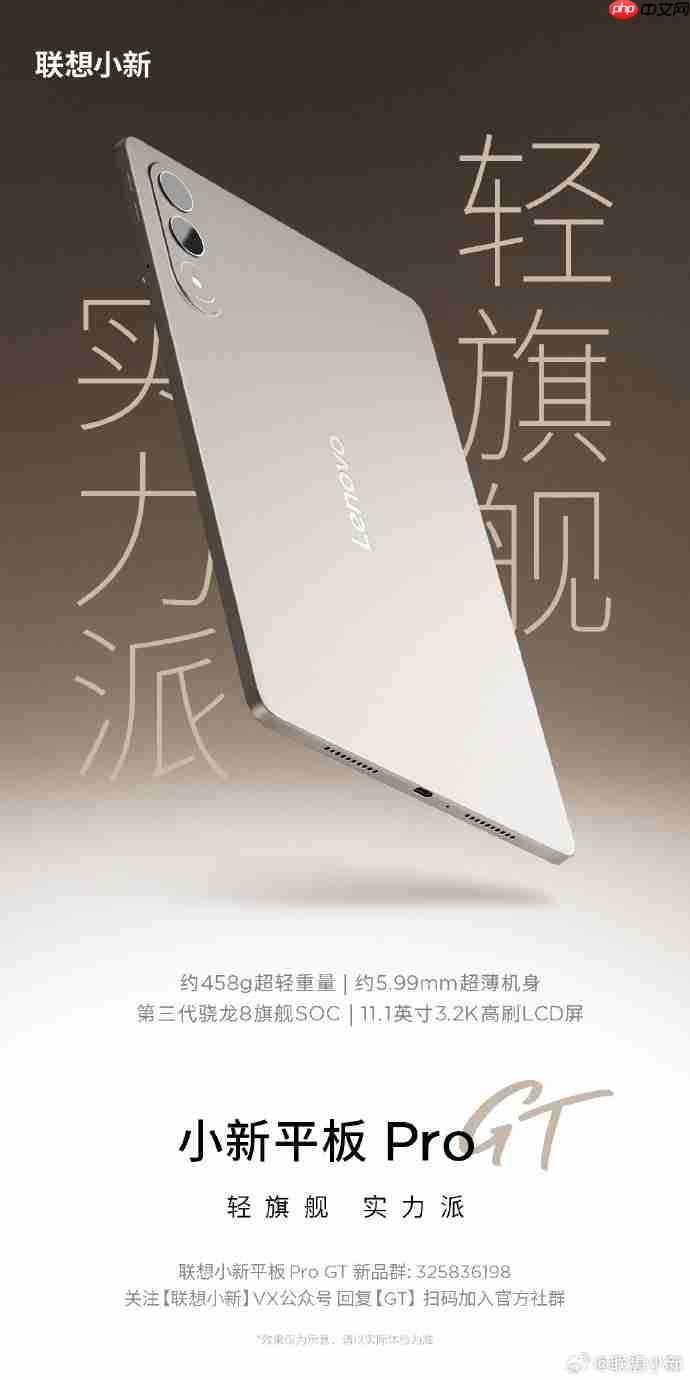
    联想小新平板Pro GT配置公布:搭载第三代骁龙8旗舰SOC联想小新平板Pro GT配置公布:搭载第三代骁龙8旗舰SOC联想小新平板Pro GT配置公布:搭载第三代骁龙8旗舰SOC联想小新平板Pro GT配置公布:搭载第三代骁龙8旗舰SOC

    凤凰网科技讯 7月8日,联想小新官方发布消息,公布了小新平板 pro gt 的部分配置信息。这款新品确认将搭载第三代骁龙8旗舰soc,并配备一块11.1英寸的3.2k高刷lcd屏幕。 小新平板Pro GT被定义为“轻旗舰 实力派”,其机身重量约为458g,厚度约为5.99mm。 ☞☞☞AI 智能聊天…

    2026年9月27日 • 用户投稿
    100
  • cpu排行榜2025 2025电脑cpu性能处理器前十名最新排名

    cpu排行榜2025 2025电脑cpu性能处理器前十名最新排名cpu排行榜2025 2025电脑cpu性能处理器前十名最新排名cpu排行榜2025 2025电脑cpu性能处理器前十名最新排名cpu排行榜2025 2025电脑cpu性能处理器前十名最新排名

    最佳处理器选择依据需求:1. 游戏玩家选AMD Ryzen 7 9800X3D或Ryzen 9 9950X3D;2. 内容创作者选Intel Core i9-14900K或AMD Ryzen 9 9950X;3. 多任务用户选AMD Ryzen 9 7950X3D或Intel Core Ultra …

    2026年9月27日 • 用户投稿
    300
  • sublime怎么高亮显示匹配的括号_Sublime括号匹配高亮功能设置

    sublime怎么高亮显示匹配的括号_Sublime括号匹配高亮功能设置sublime怎么高亮显示匹配的括号_Sublime括号匹配高亮功能设置sublime怎么高亮显示匹配的括号_Sublime括号匹配高亮功能设置sublime怎么高亮显示匹配的括号_Sublime括号匹配高亮功能设置

    Sublime Text默认支持括号匹配高亮,需确认设置中启用”match_brackets”及相关选项,建议安装BracketHighlighter插件增强功能,并检查主题颜色是否影响显示效果。 Sublime Text 默认就支持括号匹配高亮,当你将光标放在一个括号(如 …

    2026年9月27日 • 用户投稿
    300
  • 使用Spring Boot构建JSON格式的算术操作POST API教程

    使用Spring Boot构建JSON格式的算术操作POST API教程使用Spring Boot构建JSON格式的算术操作POST API教程使用Spring Boot构建JSON格式的算术操作POST API教程使用Spring Boot构建JSON格式的算术操作POST API教程

    本教程将指导您如何使用Spring Boot框架创建一个接收JSON格式请求的POST API端点。该API能够根据请求中的操作类型(加、减、乘)对两个整数执行算术运算,并返回包含操作结果和指定用户名的JSON响应。文章将详细介绍如何定义数据传输对象(DTOs)、枚举类型、实现业务逻辑服务以及构建R…

    2026年9月27日 • 用户投稿
    100
  • 豆包AI怎么转换语言 豆包AI语言转换方法

    豆包AI怎么转换语言 豆包AI语言转换方法豆包AI怎么转换语言 豆包AI语言转换方法豆包AI怎么转换语言 豆包AI语言转换方法豆包AI怎么转换语言 豆包AI语言转换方法

    豆包ai切换界面语言及指定回复语言的方法如下:1. 打开豆包app或网页版,进入“设置” → “通用设置” → “语言”,选择所需语言保存即可切换界面语言;2. 提问时明确说明所需回复语言,如“请用英文回答”,或使用提示词“[en]”、“[fr]”等,ai将按要求输出对应语言。界面语言更改不影响ai…

    2026年9月27日 • 用户投稿
    100
  • cpu天梯图最新排名2025 手机cpu处理器排行榜天梯图top10

    cpu天梯图最新排名2025 手机cpu处理器排行榜天梯图top10cpu天梯图最新排名2025 手机cpu处理器排行榜天梯图top10cpu天梯图最新排名2025 手机cpu处理器排行榜天梯图top10cpu天梯图最新排名2025 手机cpu处理器排行榜天梯图top10

    骁龙 8 Gen4、天玑 9400、A18 Pro 和 Exynos 2400 是当前旗舰处理器,分别适用于高端游戏、AI 创作、iOS 生态和游戏玩家。 立即进入“各种好用的网站点击进入”; 一、旗舰处理器(性能天花板) 1. 高通骁龙 8 Gen4 核心配置:1×Cortex-X5(3.8GHz…

    2026年9月27日 • 用户投稿
    100
  • Gemini可以预测超新星爆发吗 Gemini天体事件预警系统

    Gemini可以预测超新星爆发吗 Gemini天体事件预警系统Gemini可以预测超新星爆发吗 Gemini天体事件预警系统Gemini可以预测超新星爆发吗 Gemini天体事件预警系统Gemini可以预测超新星爆发吗 Gemini天体事件预警系统

    谷歌gemini 2.5在超新星爆发预测中展现出强大能力,其通过分析历史数据与实时观测信息识别关键特征,如恒星亮度变化、光谱演变和环境扰动;构建天体事件预警系统需五个步骤:1.数据收集,2.数据处理,3.模式识别,4.实时监控,5.快速响应;然而实际应用中仍面临数据质量不一、标准不统一、训练样本不足…

    2026年9月27日 • 用户投稿
    100
  • Claude如何优化多语言翻译 Claude语言模型微调方法

    Claude如何优化多语言翻译 Claude语言模型微调方法Claude如何优化多语言翻译 Claude语言模型微调方法Claude如何优化多语言翻译 Claude语言模型微调方法Claude如何优化多语言翻译 Claude语言模型微调方法

    优化claude多语言翻译能力的核心在于理解其运作机制并结合数据与策略进行干预,主要通过提示工程和模型微调两个层面实现。1. 提示工程是第一把利器,通过提供上下文、明确指令和高质量示例提升表现,例如指定翻译风格、受众或术语处理方式,并采用少样本学习引导模型理解偏好。2. 当面对专业领域或低资源语言时…

    2026年9月27日 • 用户投稿
    200
  • LINUX怎么修改SSH服务的默认端口_LINUX SSH端口修改配置教程

    修改SSH端口可提升服务器安全。先备份/etc/ssh/sshd_config,再编辑文件启用新端口(如2222),保存后配置防火墙放行新端口,CentOS/RHEL需用semanage更新SELinux策略,重启sshd服务并测试新端口连接,确认无误后可禁用默认22端口。 修改Linux系统中SS…

    2026年9月27日
    200
  • 夸克怎么设置默认搜索引擎_夸克浏览器默认搜索工具修改方法

    夸克怎么设置默认搜索引擎_夸克浏览器默认搜索工具修改方法夸克怎么设置默认搜索引擎_夸克浏览器默认搜索工具修改方法夸克怎么设置默认搜索引擎_夸克浏览器默认搜索工具修改方法夸克怎么设置默认搜索引擎_夸克浏览器默认搜索工具修改方法

    1、打开夸克浏览器,点击右下角三横线菜单;2、进入设置→通用或搜索与浏览→搜索引擎;3、选择百度、谷歌、必应或夸克AI搜索设为默认,新标签页和地址栏将同步生效。 如果您在使用夸克浏览器时希望更改默认的搜索服务,以便每次输入关键词时自动调用您偏好的搜索引擎,可以按照以下步骤进行调整。此设置将直接影响新…

    2026年9月27日 • 用户投稿
    300
  • sublime如何设置python的flake8检查_sublime Python Flake8配置方法

    sublime如何设置python的flake8检查_sublime Python Flake8配置方法sublime如何设置python的flake8检查_sublime Python Flake8配置方法sublime如何设置python的flake8检查_sublime Python Flake8配置方法sublime如何设置python的flake8检查_sublime Python Flake8配置方法

    首先安装SublimeLinter和SublimeLinter-flake8插件,再通过pip install flake8安装工具,配置flake8可执行文件路径,保存.py文件时自动检查代码风格并显示错误,支持自定义规则。 安装 Flake8 插件 在 Sublime Text 中使用 Flak…

    2026年9月27日 • 用户投稿
    100
  • DeepSeek如何配置灰度发布 DeepSeek渐进式更新策略

    DeepSeek如何配置灰度发布 DeepSeek渐进式更新策略DeepSeek如何配置灰度发布 DeepSeek渐进式更新策略DeepSeek如何配置灰度发布 DeepSeek渐进式更新策略DeepSeek如何配置灰度发布 DeepSeek渐进式更新策略

    灰度发布的配置应从模型版本管理、流量路由控制、实时监控与反馈、自动回滚机制等关键步骤入手。首先,确保新旧模型可并行部署并能按规则切换;其次,通过ingress控制器按比例分配流量;接着,持续监控qps、错误率等指标;最后,设置自动回滚机制以便异常时快速切换。此外,渐进式学习率预热有助于训练阶段的稳定…

    2026年9月27日 • 用户投稿
    000
  • 请写一个必然会产生死锁的示例程序

    请写一个必然会产生死锁的示例程序请写一个必然会产生死锁的示例程序请写一个必然会产生死锁的示例程序请写一个必然会产生死锁的示例程序

    死锁必然发生,因代码满足互斥、持有并等待、不可抢占和循环等待四条件:线程1持lock_a等lock_b,线程2持lock_b等lock_a,形成循环依赖,导致双方永久阻塞。 死锁,在多线程编程里,它就像一个狡猾的陷阱,一旦触发,程序就会陷入无尽的等待。它不是一个“可能”发生的问题,而是在特定条件下“…

    2026年9月27日 • 用户投稿
    100
  • 作业帮App如何使用AI答疑功能解答难题_作业帮App AI答疑的精准应用技巧

    作业帮App如何使用AI答疑功能解答难题_作业帮App AI答疑的精准应用技巧作业帮App如何使用AI答疑功能解答难题_作业帮App AI答疑的精准应用技巧作业帮App如何使用AI答疑功能解答难题_作业帮App AI答疑的精准应用技巧作业帮App如何使用AI答疑功能解答难题_作业帮App AI答疑的精准应用技巧

    作业帮App的AI答疑功能可通过拍照搜题、手动输入、语音提问和AI精准学四种方式高效解决学习难题,先提供答案再详解步骤,助力学生快速掌握知识点。 如果您在学习过程中遇到难以理解的题目,作业帮App的AI答疑功能可以提供快速且详细的解题思路与答案。以下是几种使用该功能的精准方法,帮助您高效解决各类学科…

    2026年9月27日 • 用户投稿
    1000
  • sublime怎么配置lua lsp_sublime Lua LSP配置教程

    sublime怎么配置lua lsp_sublime Lua LSP配置教程sublime怎么配置lua lsp_sublime Lua LSP配置教程sublime怎么配置lua lsp_sublime Lua LSP配置教程sublime怎么配置lua lsp_sublime Lua LSP配置教程

    首先安装LSP和LuaExtended插件,再安装sumneko/lua-language-server,最后在LSP设置中配置正确路径,即可实现智能提示、跳转定义等功能。 要让 Sublime Text 支持 Lua 语言的智能提示、跳转定义、自动补全等高级功能,配置 LSP(Language S…

    2026年9月27日 • 用户投稿
    200
  • 《2XKO》公布亚索实机预告片 风墙突刺攻防一体

    《2XKO》公布亚索实机预告片 风墙突刺攻防一体《2XKO》公布亚索实机预告片 风墙突刺攻防一体《2XKO》公布亚索实机预告片 风墙突刺攻防一体《2XKO》公布亚索实机预告片 风墙突刺攻防一体

    《2xko》今日发布了亚索的实机演示预告,这款由radiant entertainment携手拳头游戏共同打造的2v2对战格斗新作再度引发玩家关注。 实机预告片: 在本作中,亚索将作为可操作角色登场。这位以迅捷剑术著称的战士,不仅能施展流畅连击,还可借助风之力改变战场局势,展现出极具观赏性的战斗风格…

    2026年9月27日 • 用户投稿
    100
  • Java 中的异常体系结构是怎样的?Error和Exception有什么区别?

    Java 中的异常体系结构是怎样的?Error和Exception有什么区别?Java 中的异常体系结构是怎样的?Error和Exception有什么区别?Java 中的异常体系结构是怎样的?Error和Exception有什么区别?Java 中的异常体系结构是怎样的?Error和Exception有什么区别?

    Java异常体系以Throwable为根,分为Error和Exception:Error表示JVM无法恢复的严重问题,如OutOfMemoryError,通常不捕获;Exception表示可处理的异常,又分受检异常(如IOException,编译器强制处理)和非受检异常(如NullPointerEx…

    2026年9月27日 • 用户投稿
    200
  • 语音转字幕+画面匹配:AI剪辑工具的核心功能揭秘

    语音转字幕+画面匹配:AI剪辑工具的核心功能揭秘语音转字幕+画面匹配:AI剪辑工具的核心功能揭秘语音转字幕+画面匹配:AI剪辑工具的核心功能揭秘语音转字幕+画面匹配:AI剪辑工具的核心功能揭秘

    语音转字幕和画面匹配的核心在于利用语音识别技术和智能分析实现字幕与画面同步。首先,选择支持自定义词库和高稳定性的语音识别工具可提升识别准确率;其次,ai通过分析画面变化、识别说话人及调整字幕位置实现精准匹配;最后,实际应用中需注意时间轴微调、多语言支持、导出格式兼容性及样式统一等细节,以确保最终效果…

    2026年9月27日 • 用户投稿
    100
  • 如何理解Claude的伦理限制 Claude伦理政策与使用规范解读

    如何理解Claude的伦理限制 Claude伦理政策与使用规范解读如何理解Claude的伦理限制 Claude伦理政策与使用规范解读如何理解Claude的伦理限制 Claude伦理政策与使用规范解读如何理解Claude的伦理限制 Claude伦理政策与使用规范解读

    claude 的伦理限制体现了其设计背后的价值观与逻辑,旨在引导负责任的 ai 使用。1. 对有害内容敏感是因为其内部指令机制强调拒绝虚假信息、歧视性言论及伤害性建议,并非简单过滤,而是基于任务是否有害做出判断;2. 不模仿名人说话是为了规避法律与伦理风险,鼓励原创而非复制真实人物;3. 团队协作功…

    2026年9月27日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信