怎样用Python构建实时异常报警系统?消息队列集成

构建实时异常报警系统需结合消息队列实现解耦与高效处理。首先,原始数据需推送到消息队列(如kafka或rabbitmq),作为统一数据源;其次,python异常检测服务作为消费者从队列拉取数据,执行基于阈值、统计模型或机器学习的异常检测逻辑,并将结果发布到异常事件队列;最后,报警分发服务监听异常事件队列,执行邮件、slack或api等通知操作,确保报警可靠送达。系统具备高可用性、可扩展性及组件解耦特性,适用于不同数据量和业务场景。

怎样用Python构建实时异常报警系统?消息队列集成

构建一个实时异常报警系统,并结合消息队列,核心在于将数据流、异常检测逻辑以及报警通知机制通过一个高效、解耦的消息总线串联起来。这就像是搭建一套自动化的预警雷达,持续扫描数据天空,一旦发现异常信号,立即通过无线电波(消息队列)通知到各个指挥中心。

怎样用Python构建实时异常报警系统?消息队列集成

工作流程

好的,我们来聊聊怎样用Python构建一个实时异常报警系统,同时把消息队列这个好东西集成进来。我个人觉得,要做好这事儿,消息队列不只是个可选组件,它简直就是整个系统的“脊梁骨”。它能把各个环节解耦,让整个系统变得异常健壮和灵活。

通常我会这么干:

立即学习“Python免费学习笔记(深入)”;

怎样用Python构建实时异常报警系统?消息队列集成

首先,数据得先进入一个消息队列。你的原始数据,无论是服务器日志、应用指标、用户行为事件还是传感器读数,都应该先推送到一个消息队列里。比如,如果你追求高吞吐量和流式处理能力,Kafka是我的首选;如果你的场景更偏向于可靠的任务分发和复杂的路由,RabbitMQ可能会更顺手。这个队列就成了所有后续处理的单一数据源,你的数据生产者只需要关心把数据扔进去,而不需要知道后面会发生什么。

接下来,就是Python异常检测服务登场了。你会用Python写一个应用程序,它作为这个数据队列的消费者。它会持续地从队列中拉取消息,可能是单条,也可能是一批。在这个Python服务内部,你就要实现你的核心异常检测逻辑了。这可以很简单,比如设定一个阈值(“CPU使用率连续5分钟超过90%”),也可以非常复杂,运用统计模型、时间序列分析,甚至是一些轻量级的机器学习算法。

怎样用Python构建实时异常报警系统?消息队列集成

这里有个小细节,但很重要:状态管理。如果你的异常检测是基于时间序列的(比如,检测一个指标的“突然下降”),你的Python服务可能需要维护一些历史数据或计算出的状态(比如滑动平均值)。这部分状态可以放在内存里(如果数据量不大且可以接受服务重启丢失),或者更稳妥地,放到外部的键值存储(比如Redis)里,这样多个Python实例也能共享状态,并且状态更持久。

当Python服务成功识别出异常后,它不会直接发邮件或者钉钉消息。不,那太直接了,而且容易出问题。我的做法是,它会发布一个“异常事件”到 另一个 消息队列(或者同一个队列的另一个主题/分区)。这个“异常事件”队列就成了报警事件的集中地。

最后,是报警分发服务。这通常是另一个独立的Python应用,它专门监听“异常事件”队列。当它收到一个异常事件消息时,它才会真正地执行报警动作:发送邮件、推送到Slack、触发PagerDuty事件,或者调用某个API来启动自动化修复流程。这种分层设计的好处是显而易懂的:即使你的Slack集成暂时挂了,异常事件依然安全地躺在队列里,等待被处理,而不会丢失。

这种以消息队列为核心的架构,让整个系统变得异常健壮。组件之间高度解耦,一个环节出问题,其他环节还能继续工作,队列会作为天然的缓冲。而且,它的扩展性极佳,数据量大了?加几个Python检测服务的实例就行;报警渠道多了?加几个报警分发服务的实例就行。

选择合适的消息队列:Kafka还是RabbitMQ?

这问题啊,每次新项目启动,我都会在心里盘算一番。Kafka和RabbitMQ,它们都是消息队列界的明星,但用起来的感觉和适合的场景,真的大相径庭,就像是为不同路况设计的车辆。

Kafka,在我看来,它更像是一个为大数据流和事件流设计的“高速公路”。它的核心是分布式日志,追求的是高吞吐量、持久化、以及事件的可回溯性。如果你面对的是海量的、持续不断的数据流,比如数以万计的日志条目、实时用户行为数据、物联网传感器数据,并且你未来可能需要对这些数据进行复杂的实时分析或者历史回溯,那么Kafka几乎是你的不二之选。它的分区(partition)机制和消费者组(consumer group)模型,天生就适合构建大规模、可伸缩的并行处理系统。对于实时异常报警,如果你的数据源本身就是高并发的流,Kafka能让你轻松地通过增加Python异常检测服务的消费者实例来并行处理不同的数据分区。它提供的是“至少一次”的投递语义,这意味着你可能需要处理重复消息,但在很多实时分析场景下,这通常是可以接受的。

而RabbitMQ,它更像是一个传统的、功能强大的“消息邮局”。它非常擅长消息的路由、分发和可靠投递。它的优势在于灵活的路由规则、多种交换机类型(direct, fanout, topic, headers),以及对AMQP协议的全面支持。如果你需要的是可靠的点对点通信、任务队列、或者需要根据消息内容进行非常精细的路由到特定消费者,RabbitMQ会让你感到非常得心应手。对于异常报警系统,如果你的数据量不是那么爆炸性,或者你更看重消息的严格可靠投递和复杂的路由逻辑(比如根据异常类型将报警路由到不同的团队或渠道),RabbitMQ会是一个非常稳健的选择。它也支持多种消息确认机制,可以提供更强的消息可靠性保证,甚至在某些配置下能接近“恰好一次”的语义。

我的个人偏好呢? 如果是构建一个全新的、面向未来可能大规模扩展的实时流式异常检测系统,我通常会倾向于Kafka。它的流式特性和高吞吐能力,能更好地应对未来的数据增长挑战。但如果我只是想快速搭建一个针对特定事件的报警系统,或者现有架构中已经有RabbitMQ并且团队熟悉它,那我肯定会选择RabbitMQ,因为它上手更快,对于中小型系统来说,管理也相对简单。说到底,没有绝对的最佳选择,只有最适合你当前业务场景、数据量和团队技术栈的那个。

异常检测算法的选择与实现:不仅仅是阈值

一提到异常检测,很多人脑海里第一个浮现的可能就是“阈值”,比如“CPU利用率超过90%就报警”。这确实是最简单直接的方式,但说实话,在真实世界里,这远远不够。仅仅依靠固定阈值,你很快就会被一堆烦人的误报淹没,或者更糟糕的是,错过那些“悄无声息”的、更具破坏性的异常。

我们得拓宽思路。异常,很多时候是数据“行为”上的出乎意料,而不是简单地“数值”上的越界。

统计学方法是比固定阈值更进一步的选择。你可以计算数据的移动平均值和标准差。一个数据点如果偏离其近期移动平均值好几个标准差(比如Z-score大于3),那它就可能是个异常。这种方法比固定阈值灵活得多,因为它能适应数据的季节性变化或趋势。在Python里,pandas库的rolling方法结合scipy.stats库就能轻松实现。举个例子,一个简单的Z-score检测:

import pandas as pdfrom scipy.stats import zscorefrom collections import deque# 假设这是一个模拟的实时数据流data_buffer = deque(maxlen=200) # 保持最近200个数据点def detect_zscore_anomaly(current_data_point, buffer_data, window_size=100, threshold=3.0):    """    基于滑动窗口的Z-score异常检测。    :param current_data_point: 当前新到达的数据点    :param buffer_data: 存储历史数据的deque    :param window_size: 计算均值和标准差的窗口大小    :param threshold: Z-score阈值    :return: (是否异常, Z-score值)    """    buffer_data.append(current_data_point)    if len(buffer_data) < window_size:        return False, None # 数据不足以计算    # 从deque获取最近的window_size数据点    recent_data = pd.Series(list(buffer_data)[-window_size:])    current_mean = recent_

以上就是怎样用Python构建实时异常报警系统?消息队列集成的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1365374.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何用CausalML实现因果视角的异常检测?
上一篇 2025年12月14日 04:34:03
Python如何实现工业设备振动信号的异常模式识别?
下一篇 2025年12月14日 04:34:16

相关推荐

  • 《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!

    《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!《忍者龙剑传4》现已偷跑 玩家称战斗系统非常惊艳!

    《忍者龙剑传4》将于10月21日正式发售,登陆ps5、xsx|s以及pc平台,并将在首发当日加入xgp游戏库。本作支持难度自定义,无论你是系列老将还是初次接触的新手,都有机会通过挑战赢得“超忍”称号。剧情方面,隼龙与八云之间的对立成为核心冲突——八云试图解除暗黑神龙的封印,而这直接违背了神龙教阻止恶…

    2026年9月26日 • 用户投稿
    100
  • VSCode如何实现脑机接口编程 VSCode神经信号分析工具集成

    vscode本身没有内置脑机接口功能,而是通过其扩展性支持bci编程。1. 安装python扩展并配置虚拟环境以管理依赖;2. 使用brainflow采集数据、mne-python处理eeg/meg信号,并通过jupyter notebook在vscode中进行交互式分析;3. 利用vscode调试…

    2026年9月26日
    100
  • sublime如何禁用拼写检查_sublime关闭拼写检查方法

    sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法

    Sublime Text默认开启拼写检查,可用红色波浪线标记疑似错误;2. 可通过菜单临时关闭当前文件的拼写检查;3. 修改用户设置添加”spell_check”: false可永久全局关闭;4. 针对特定语言语法文件添加该配置则仅关闭对应类型文件的检查;5. 关闭后红色波浪…

    2026年9月26日 • 用户投稿
    100
  • 用豆包AI生成Python数据挖掘代码

    用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码

    想用豆包ai生成python数据挖掘代码的关键在于明确任务目标和数据结构。1. 首先明确数据挖掘任务类型,如分类、聚类或回归,并具体描述需求,例如“根据用户年龄、消费金额和购买频率做客户分群”。2. 接着提供清晰的数据格式与来源,比如说明csv文件中的字段信息,以便ai进行数据预处理和建模。3. 要…

    2026年9月25日 • 用户投稿
    900
  • RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    10月13日,当汽车与高性能计算相遇,会激发出怎样的创意奇迹?nvidia在最新一期geforce garage节目中揭晓了答案。 这一次,他们携手改装界传奇人物JCustom(Justin Chu),将一台完整的RTX 5080游戏主机巧妙植入保时捷911的轮毂之中,实现了汽车工艺与电脑科技的惊艳…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么折叠所有代码_sublime代码折叠快捷方法

    sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法

    Sublime Text 支持多种代码折叠快捷键,Windows/Linux 使用 Ctrl + Shift + [/] 折叠/展开代码块,Ctrl + K, Ctrl + 1 展开所有用 Ctrl + K, Ctrl + J,macOS 用户将 Ctrl 替换为 Command。 在 Sublim…

    2026年9月25日 • 用户投稿
    200
  • 政府机构 5000 万台电脑将替换为国产 Linux

    政府机构 5000 万台电脑将替换为国产 Linux政府机构 5000 万台电脑将替换为国产 Linux政府机构 5000 万台电脑将替换为国产 Linux政府机构 5000 万台电脑将替换为国产 Linux

    点击上方“芋道源码”,选择“设为星标” 无论是前浪,还是后浪? 只要能浪,就是好浪! 每日 10:33 更新文章,让你每天都有点点收获… 精选源码专栏 原创 | Java 2021 超神之路,很肝~带中文详细注释的开源项目Dubbo RPC 框架源码解析Netty 网络应用框架源码解析R…

    2026年9月25日 • 用户投稿
    400
  • 想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    ai模型组装工具与豆包联用是可行且高效的,关键在于接口兼容性、数据流转和部署方式。具体步骤如下:1. 理解豆包的模型接入规范,包括支持的模型格式、api调用方式及资源需求;2. 在组装工具中完成模型构建、训练与导出,确保符合平台要求;3. 如需转换模型格式(如pytorch转onnx),使用相应工具…

    2026年9月25日 • 用户投稿
    100
  • 如何利用Debian Apache日志提升网站性能

    如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能

    本文将阐述如何通过分析Debian系统下的Apache日志来提升网站性能。 一、日志分析基础 Apache日志记录了所有HTTP请求的详细信息,包括IP地址、时间戳、请求URL、HTTP方法和响应代码等。在Debian系统中,这些日志通常位于/var/log/apache2/access.log和/…

    2026年9月25日 • 用户投稿
    100
  • DNF手游:首批“75级武器”曝光,自带四属性攻击

    DNF手游:首批“75级武器”曝光,自带四属性攻击DNF手游:首批“75级武器”曝光,自带四属性攻击DNF手游:首批“75级武器”曝光,自带四属性攻击DNF手游:首批“75级武器”曝光,自带四属性攻击

    从策划在前期见面会透露的信息以及玩家“十四”爆料的内容来看,九月份DNF手游上线安图恩团本基本上已经是板上钉钉的事了,大概率会和金秋礼包同步更新。而安图恩团本的开启,势必会对游戏环境造成巨大冲击,首当其冲的就是玩家们即将迎来新一轮的武器毕业更替。 作为地下城系列最具代表性的团队副本之一,安图恩产出的…

    2026年9月25日 • 用户投稿
    000
  • 怎么用豆包AI帮我优化NumPy运算 3个技巧让AI加速科学计算

    怎么用豆包AI帮我优化NumPy运算 3个技巧让AI加速科学计算怎么用豆包AI帮我优化NumPy运算 3个技巧让AI加速科学计算怎么用豆包AI帮我优化NumPy运算 3个技巧让AI加速科学计算怎么用豆包AI帮我优化NumPy运算 3个技巧让AI加速科学计算

    豆包ai可通过三个技巧优化numpy计算效率。1. 描述逻辑让ai生成高效向量化表达式,如用np.mean(arr * (arr > 0), axis=1)替代循环求每行正数均值;2. 提供现有代码让ai分析瓶颈并提出优化建议,如将显式循环改为np.where(np.sum(arr, axis…

    2026年9月25日 • 用户投稿
    100
  • Java数据类型溢出:原理、预测与避免

    Java数据类型溢出:原理、预测与避免Java数据类型溢出:原理、预测与避免Java数据类型溢出:原理、预测与避免Java数据类型溢出:原理、预测与避免

    本文旨在深入解析Java中数据类型溢出的现象,阐述其背后的二进制补码原理,并提供预测溢出结果的方法。通过理解数据在计算机中的存储方式,以及溢出时数值的循环特性,开发者可以更好地掌握Java中的数据类型,避免潜在的错误。 数据在计算机中的存储:二进制补码 计算机底层使用二进制(bits)来表示所有数据…

    2026年9月25日 • 用户投稿
    100
  • 解决JavaFX应用导出为可运行JAR后FXMLLoader资源加载失败的问题

    解决JavaFX应用导出为可运行JAR后FXMLLoader资源加载失败的问题解决JavaFX应用导出为可运行JAR后FXMLLoader资源加载失败的问题解决JavaFX应用导出为可运行JAR后FXMLLoader资源加载失败的问题解决JavaFX应用导出为可运行JAR后FXMLLoader资源加载失败的问题

    本文旨在解决JavaFX应用在Eclipse中正常运行,但导出为可运行JAR包后,因FXMLLoader无法找到FXML资源文件而抛出IllegalStateException: Location is not set异常的问题。核心解决方案是调整FXMLLoader.setLocation()方法…

    2026年9月25日 • 用户投稿
    200
  • Debian Apache日志对SEO有何影响

    debian apache日志记录了网站的所有访问请求,包括ip地址、请求类型、响应状态等详细信息。这些日志对于seo有以下几个方面的影响: SEO GPT 免费的白帽SEO,PPC和网站经销商平台 17 查看详情 Apache日志对SEO的重要性 监控网站流量和用户行为:通过分析Apache访问日…

    2026年9月25日
    100
  • 2025 上半年中国蓝牙耳机市场份额出炉:小米第一

    2025 上半年中国蓝牙耳机市场份额出炉:小米第一2025 上半年中国蓝牙耳机市场份额出炉:小米第一2025 上半年中国蓝牙耳机市场份额出炉:小米第一2025 上半年中国蓝牙耳机市场份额出炉:小米第一

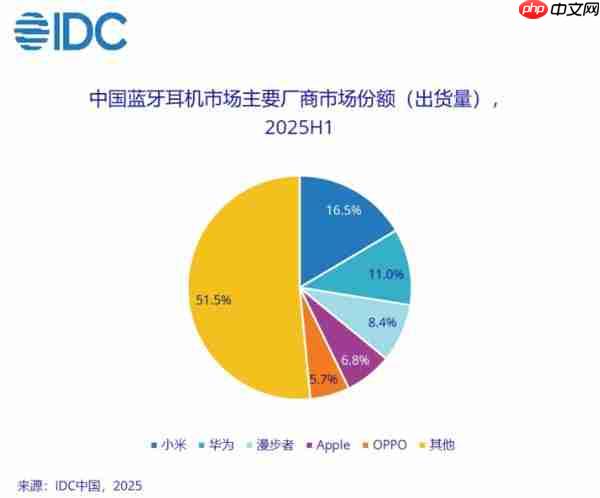
    根据 idc 最新发布的数据,2025 年上半年中国蓝牙耳机市场出货量约为 5998 万台,同比增长 7.5%。其中,小米以 16.5% 的市场份额位居榜首。值得注意的是,耳夹式耳机在 2025 年上半年的市场规模与增速首次超越耳挂式产品,实现出货量 651 万台,同比增长高达 41.0%。 小米耳…

    2026年9月25日 • 用户投稿
    300
  • 7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二

    7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二

    8 月 13 日,洛图科技(runto)发布《中国电视市场品牌出货月度快报》。2025 年 7 月,中国电视市场品牌整机出货量为 186.0 万台,较去年同期下降 14.3%,创下近 13 个月来最大的单月同比跌幅;同时,环比 6 月大幅下降 28.2%。 电视 CNMO 注意到,2025 年 7 …

    2026年9月25日 • 用户投稿
    100
  • VSCode如何通过SSH连接远程开发 VSCode远程SSH开发的配置与调试技巧

    安装“remote – ssh”扩展是实现vscode远程开发的基础;2. 配置ssh连接需在~/.ssh/config中设置host、hostname、user、port和identityfile等参数以实现快速连接;3. 连接成功后vscode会自动在远程安装vs code serv…

    2026年9月25日
    500
  • 快速搭建一个管理App数据和用户的界面

    快速搭建一个管理App数据和用户的界面快速搭建一个管理App数据和用户的界面快速搭建一个管理App数据和用户的界面快速搭建一个管理App数据和用户的界面

    在电商、教育、企业服务等关键领域,app的数据管理效率与系统用户体验已成为决定产品市场竞争力的核心因素。本文将为开发者提供一套从需求分析到技术落地的完整路径,助你快速构建一个高效且易用的管理类app界面。 一、厘清需求:聚焦数据与用户场景的深度融合 构建管理型App的第一步是精准把握业务本质。必须深…

    2026年9月25日 • 用户投稿
    700
  • 如何使用Keras快速构建模型 Keras神经网络搭建入门教程

    如何使用Keras快速构建模型 Keras神经网络搭建入门教程如何使用Keras快速构建模型 Keras神经网络搭建入门教程如何使用Keras快速构建模型 Keras神经网络搭建入门教程如何使用Keras快速构建模型 Keras神经网络搭建入门教程

    使用 keras 快速搭建神经网络模型需掌握以下步骤:1. 安装 keras 并确认后端环境,推荐通过 tensorflow.keras 导入模块;2. 使用 sequential 模型堆叠层,定义输入形状、神经元数量和激活函数;3. 编译模型时选择合适的损失函数、优化器和评估指标;4. 准备数据并…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法

    sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法

    Sublime Text可通过插件与Docker集成实现编译运行。1. 安装Terminus和Build Systems插件;2. 项目根目录创建Dockerfile定义环境;3. 配置自定义构建系统调用docker build和run命令;4. 可选使用Terminus面板查看输出,注意路径映射与…

    2026年9月25日 • 用户投稿
    800

发表回复

登录后才能评论
关注微信