Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
使用Python NumPy构建行列和均等定值的随机矩阵_创想鸟

使用Python NumPy构建行列和均等定值的随机矩阵

使用Python NumPy构建行列和均等定值的随机矩阵

本文详细介绍了如何使用Python和NumPy库生成一个指定尺寸的随机矩阵,并确保其每一行和每一列的和都等于一个预设的常数Z。通过迭代比例调整的策略,可以有效地解决同时满足行和列和约束的挑战,并提供了实际的代码示例及注意事项,帮助读者理解并实现这一复杂的数据生成需求。

引言

在数据模拟、游戏开发或科学计算等领域,我们有时需要生成特定结构的随机矩阵。一个常见的需求是创建一个x行y列的矩阵,其中所有元素为随机数,但同时要求矩阵的每一行的和以及每一列的和都等于一个特定的值z。直接使用简单的随机数生成并进行一次性缩放往往只能满足行和或列和其中之一,无法同时满足两者。本文将介绍一种迭代的解决方案,利用numpy库的强大功能实现这一目标。

核心原理:迭代比例调整

要同时满足行和与列和的约束,我们可以采用一种迭代比例调整(Iterative Proportional Fitting, IPF)的方法。其基本思想是:

初始化:首先生成一个任意的随机矩阵。行归一化:将矩阵的每一行按比例缩放,使其和等于Z。列归一化:在行归一化之后,矩阵的列和可能不再等于Z。此时,我们将矩阵的每一列按比例缩放,使其和等于Z。重复:重复步骤2和步骤3。每次迭代都会使行和与列和更接近目标值Z。经过足够多的迭代,矩阵的行和与列和将趋近于Z。

这种方法之所以有效,是因为每次调整虽然会影响到另一维度的和,但整体上会使矩阵更接近目标分布。

实现方法与示例代码

下面是使用NumPy库实现上述迭代方法的Python代码:

import numpy as npdef generate_constrained_matrix(rows, cols, target_sum, max_iterations=100, tolerance=1e-6):    """    生成一个指定尺寸的随机矩阵,确保每行和每列的和都等于 target_sum。    参数:    rows (int): 矩阵的行数。    cols (int): 矩阵的列数。    target_sum (float): 目标行和与列和。    max_iterations (int): 最大迭代次数,防止无限循环。    tolerance (float): 检查收敛的容差值。    返回:    numpy.ndarray: 满足条件的随机矩阵。    """    # 1. 初始化矩阵,元素为0到1之间的随机数    matrix = np.random.rand(rows, cols)    for i in range(max_iterations):        # 2. 行归一化:使每行的和等于 target_sum        row_sums = matrix.sum(axis=1, keepdims=True)        # 避免除以零,对于和为零的行,其元素应保持为零        row_sums[row_sums == 0] = 1.0 # 临时处理,避免NaN,实际情况应确保初始随机数不全为零        matrix = matrix / row_sums * target_sum        # 3. 列归一化:使每列的和等于 target_sum        col_sums = matrix.sum(axis=0, keepdims=True)        # 避免除以零        col_sums[col_sums == 0] = 1.0        matrix = matrix / col_sums * target_sum        # 4. 检查收敛性(可选,但推荐用于更精确的控制)        # 检查所有行和列是否都已接近 target_sum        if np.allclose(matrix.sum(axis=1), target_sum, atol=tolerance) and            np.allclose(matrix.sum(axis=0), target_sum, atol=tolerance):            # print(f"Matrix converged after {i+1} iterations.")            break    else:        # 如果循环结束但未收敛,可以发出警告或采取其他措施        print(f"Warning: Matrix did not fully converge after {max_iterations} iterations.")    # 验证最终结果    assert np.allclose(matrix.sum(axis=1), target_sum, atol=tolerance), "Row sums are not equal to target_sum!"    assert np.allclose(matrix.sum(axis=0), target_sum, atol=tolerance), "Column sums are not equal to target_sum!"    # 返回结果,通常会进行小数位数的四舍五入以提高可读性    return matrix.round(2)# 示例用法x = 3y = 3z = 1result_matrix = generate_constrained_matrix(x, y, z)print("生成的矩阵:")print(result_matrix)print("n每行之和:")print(result_matrix.sum(axis=1).round(2))print("每列之和:")print(result_matrix.sum(axis=0).round(2))# 另一个示例x = 2y = 4z = 10result_matrix_2 = generate_constrained_matrix(x, y, z, max_iterations=50)print("n生成的矩阵 (2x4, sum=10):")print(result_matrix_2)print("n每行之和:")print(result_matrix_2.sum(axis=1).round(2))print("每列之和:")print(result_matrix_2.sum(axis=0).round(2))

代码解析

np.random.rand(rows, cols): 初始化一个rows行cols列的矩阵,其元素在[0.0, 1.0)之间均匀分布。matrix.sum(axis=1, keepdims=True): 计算每行的和。axis=1表示沿列方向求和(即求每行的和),keepdims=True保持结果的维度,以便于广播操作。*`matrix / row_sums target_sum**: 这是行归一化的核心。将矩阵的每个元素除以其所在行的当前和,然后乘以目标和target_sum。这样,该行的所有元素之和就变为target_sum`。matrix.sum(axis=0, keepdims=True): 类似地,计算每列的和。*`matrix / col_sums target_sum`**: 列归一化,与行归一化原理相同。max_iterations: 设置最大迭代次数,以防止在某些极端情况下无法完全收敛而导致无限循环。对于大多数情况,10到100次迭代通常足够。tolerance 和 np.allclose: 由于浮点数的精度问题,我们不能直接比较两个浮点数是否相等。np.allclose(a, b, atol=tolerance)用于检查a和b是否在给定容差atol内“足够接近”。这是判断矩阵是否收敛的关键。matrix.round(2): 最后将矩阵元素四舍五入到两位小数,提高输出的可读性。

注意事项

收敛性:这种迭代方法通常能够收敛,但收敛速度取决于初始随机矩阵和target_sum的值。对于某些病态情况,可能需要更多的迭代次数。max_iterations参数应根据实际需求进行调整。浮点数精度:由于计算机内部浮点数的表示限制,最终的行和与列和可能不会精确地等于target_sum,而是非常接近。因此,在验证结果时,应使用np.allclose而不是==。负数或零元素:本教程生成的矩阵元素都是非负的。如果需要生成包含负数的矩阵,初始化方式和迭代逻辑可能需要调整。当行和或列和为零时,需要特别处理以避免除以零的错误。代码中已包含简单的避免除以零的逻辑。矩阵尺寸:此方法适用于任意rows和cols的矩阵,不限于x=y的方阵。目标和Z的合理性:如果Z为0,则最终矩阵的所有元素都将是0。如果Z为负数,则矩阵元素也将是负数。

总结

通过迭代比例调整方法,我们可以有效地生成一个随机矩阵,同时满足其行和与列和都等于一个指定常数Z的需求。这种方法在需要模拟具有特定边缘分布的数据集时非常有用。理解其迭代原理和NumPy的广播机制是掌握此技术的关键。在实际应用中,根据精度要求和计算资源,合理设置迭代次数和容差值,能够确保获得高质量的模拟结果。

立即学习“Python免费学习笔记(深入)”;

以上就是使用Python NumPy构建行列和均等定值的随机矩阵的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1366307.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
解决ONNX Runtime与TensorRT共存时的CUDA资源冲突
上一篇 2025年12月14日 05:05:31
Python如何操作Redis?高效缓存技术指南
下一篇 2025年12月14日 05:05:44

相关推荐

  • AdobePremierePro的AI混合工具怎么用?简化视频编辑的实用方法

    Adobe Premiere Pro的AI混合工具通过变形剪辑、重混音、自动重构图和颜色匹配等功能,显著提升剪辑效率。变形剪辑智能平滑跳剪,使转场更自然;重混音自动调整音乐长度,适配视频节奏;自动重构图利用AI跟踪主体,快速适配多平台比例;颜色匹配则快速统一多素材色彩基调。这些AI功能虽非万能,但在…

    2026年9月22日
    100
  • 爱应用pc版官方网址入口 爱应用pc版平台访问官网直达链接

    爱应用PC版官方网址是https://www.aiyingyong.com,该平台提供Win10应用推荐、游戏中心及软件下载服务,设有每日精品、分类合集、专题评测等功能板块,并支持用户互动交流与资源更新。 爱应用pc版官方网址入口在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来爱应用pc版…

    2026年9月22日
    000
  • MySQL执行时间分析与诊断_MySQL性能瓶颈精准定位

    MySQL执行时间分析与诊断_MySQL性能瓶颈精准定位MySQL执行时间分析与诊断_MySQL性能瓶颈精准定位MySQL执行时间分析与诊断_MySQL性能瓶颈精准定位MySQL执行时间分析与诊断_MySQL性能瓶颈精准定位

    mysql性能瓶颈定位与分析需从慢查询日志、执行计划、实时监控等多维度入手。1. 开启慢查询日志,设置slow_query_log=1、指定日志路径及阈值long_query_time,通过mysqldumpslow分析日志找出最慢sql;2. 使用explain命令查看sql执行计划,重点关注ty…

    2026年9月22日 • 用户投稿
    200
  • if sql语句_SQL IF语句介绍和概述

    if sql语句_SQL IF语句介绍和概述if sql语句_SQL IF语句介绍和概述if sql语句_SQL IF语句介绍和概述if sql语句_SQL IF语句介绍和概述

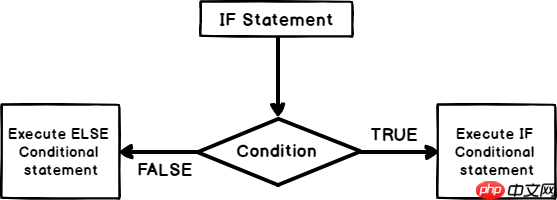
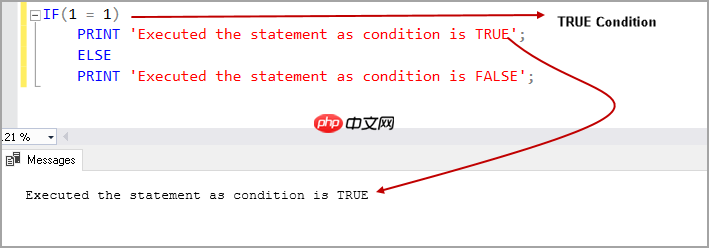
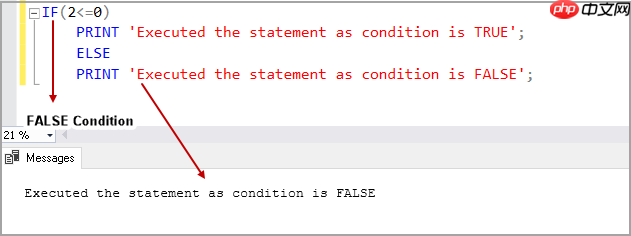
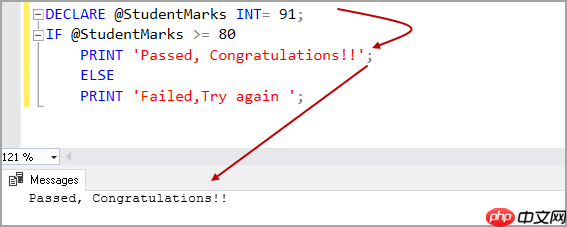
    大家好,又见面了,我是你们的朋友全栈君。 本文将深入探讨SQL Server中实用的SQL IF语句功能。 介绍 (Introduction) 在现实生活中,我们根据条件做出决定。例如,以下情况: 如果我今年获得绩效奖金,我将选择国际度假,否则我将选择国内度假。如果天气变好,我会计划骑自行车旅行,否…

    2026年9月22日 • 用户投稿
    000
  • VSCode连接Modelsim仿真工具(调试技巧分享,波形分析指南)

    首先确保Modelsim路径加入系统PATH,安装VSCode的HDL扩展,配置tasks.json定义编译、仿真任务,并编写Tcl脚本自动化add wave、run等操作,通过问题匹配器解析错误,利用Tcl实现参数化仿真与自动化测试,结合Makefile或脚本提升大型项目管理效率。 将VSCode…

    2026年9月22日
    400
  • Invideo的AI混合工具怎么用?快速生成专业视频的实用教程

    Invideo的AI混合工具通过智能生成视频初稿并允许创作者精细调整,显著降低制作门槛、提升效率,其优势在于快速生成、易用性强、激发创意,用户可通过优化输入、替换素材、注入个性声音和保持风格统一来最大化潜力,同时需应对素材模式化、理解偏差等挑战。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索,…

    2026年9月22日
    500
  • Java并发编程中Runnable接口使用方法

    Runnable接口用于定义线程任务,通过实现run()方法封装执行逻辑,不返回结果且不能抛出受检异常;可直接传给Thread实例启动线程,也可用Lambda表达式简化代码;推荐结合ExecutorService线程池使用,提升资源利用率;需注意无返回值、异常处理在内部完成、共享变量线程安全等问题。…

    2026年9月22日
    100
  • ChatExcel进行数据分类_ChatExcel数据自动分类与标签管理

    答案:通过内置规则、AI智能打标、多维度交叉分类及手动修正四步实现ChatExcel自动分类与标签管理。首先设定字段匹配规则自动归类数据;其次启用智能打标功能分析文本生成语义标签;再通过组合多个属性构建交叉分类矩阵实现精细化管理;最后支持人工干预修正异常项并同步更新数据库,提升分类准确性与管理效率。…

    2026年9月22日
    000
  • VSCode配置C++项目环境 新手必看VSCode搭建C++教程

    答案:在VSCode中配置C++环境需安装MinGW-w64编译器并将其路径加入系统环境变量,安装VSCode的C/C++扩展以支持代码补全和调试,通过tasks.json配置编译任务,指定g++路径及编译参数,再通过launch.json配置调试任务,设置gdb调试器路径和程序输出路径,确保头文件…

    2026年9月22日
    200
  • 如何使用DeepSpeed训练AI大模型?大规模模型训练的优化技巧

    DeepSpeed通过ZeRO等技术突破显存限制,实现大模型高效训练。它采用ZeRO-1/2/3分级优化,分别对优化器状态、梯度和参数进行分区,显著降低单卡显存占用;结合混合精度、梯度累积和CPU/NVMe卸载进一步节省资源。同时集成流水线并行与张量并行,支持多维并行策略协同,使万亿参数模型训练在普…

    2026年9月22日
    100
  • Sublime使用MySQL实现数据权限控制模块_根据用户角色限制访问范围

    Sublime使用MySQL实现数据权限控制模块_根据用户角色限制访问范围Sublime使用MySQL实现数据权限控制模块_根据用户角色限制访问范围Sublime使用MySQL实现数据权限控制模块_根据用户角色限制访问范围Sublime使用MySQL实现数据权限控制模块_根据用户角色限制访问范围

    在sublime中实现数据权限控制模块的核心在于根据用户角色动态拼接sql语句,具体步骤如下:1. 建立角色表、用户表和权限规则表,明确角色与数据的对应关系;2. 用户登录后获取其角色id,并查询该角色可访问的数据范围;3. 根据权限动态构建sql查询条件,限制访问范围;4. 使用python等语言…

    2026年9月22日 • 用户投稿
    200
  • PHP 表单验证:确保 HTML select 下拉菜单已正确选择非默认选项

    本文将详细介绍如何在 PHP 后端对 HTML select 下拉菜单进行有效验证,确保用户选择了非默认选项。我们将探讨常见的验证误区,并提供一个简洁高效的解决方案,通过检查 $_POST 数据来判断用户是否已做出有效选择,从而避免表单提交无效数据,提升用户体验和数据准确性。 在构建 web 表单时…

    2026年9月22日
    200
  • python 基准测试(cProfile kcachegrind line_profiler memory_profiler)

    learn from 《python高性能(第2版)》 类似工具:pycharm profile对函数调用效率进行测试 1. 例子 一个圆周运动的动画 代码语言:javascript代码运行次数:0运行复制 from matplotlib import pyplot as pltfrom matpl…

    2026年9月22日
    200
  • NvidiaCanvas的AI混合工具如何使用?创作智能画作的详细教程

    NVIDIA Canvas是一款基于AI的智能图像生成器,它将用户涂鸦的材质色块实时转化为逼真风景,核心在于语义理解与风格化合成。其工作流程包括选择材质笔刷、在输入画布绘制概念图、利用图层与风格预设快速迭代,并导出成果。相比传统绘画工具,Canvas优势在于高效生成、降低创作门槛、支持快速探索与创意…

    2026年9月22日
    300
  • VSCode安装C/C++开发环境 最新VSCode配置C语言教程详解

    答案:搭建VSCode的C/C++环境需安装编译器、C/C++扩展并配置项目文件。首先安装MinGW(Windows)、Clang(macOS)或GCC(Linux),配置环境变量并验证;然后在VSCode中安装Microsoft的C/C++扩展;最后创建.c_cpp_properties.json…

    2026年9月22日
    300
  • 在Java中如何通过Stream实现交集与差集

    交集可通过filter结合contains获取两集合共有元素,差集则保留一个集合中不在另一集合的元素,示例使用list1.stream().filter(list2::contains)得[3,4],filter(e->!list2.contains(e))得[1,2],建议将list2转为H…

    2026年9月22日
    100
  • Java Swing中按钮与文本框事件处理的实践指南

    本文将深入探讨Java Swing中ActionListener的正确使用方法,指导开发者如何为GUI按钮和文本框实现事件监听,从而处理用户输入、执行计算并实时更新界面。文章将重点讲解如何在actionPerformed方法中获取用户输入、进行类型转换、处理潜在异常,并提供一个完整的计算器示例来演示…

    2026年9月22日
    200
  • MySQL查询缓存配置及性能_MySQL重复查询响应速度提升

    MySQL查询缓存配置及性能_MySQL重复查询响应速度提升MySQL查询缓存配置及性能_MySQL重复查询响应速度提升MySQL查询缓存配置及性能_MySQL重复查询响应速度提升MySQL查询缓存配置及性能_MySQL重复查询响应速度提升

    mysql查询缓存已不适用于现代应用场景,尤其在8.0版本中被彻底移除。它仅适合读多写少、数据几乎不变的静态查询,通过内存直接返回结果提升性能;但在数据频繁更新时,因基于表级的缓存失效机制,每次写操作都会清空相关缓存,导致频繁重建缓存并消耗大量cpu资源,形成性能瓶颈。此外,sql语句匹配严格、内存…

    2026年9月22日 • 用户投稿
    500
  • Linux平台下的Eclipse配置

    在linux平台上配置eclipse时,可能会遇到一些常见的问题和优化需求。本文将详细介绍如何解决这些问题,并提供优化eclipse的建议。 启动Eclipse报错 启动Eclipse时,如果遇到以下错误: A Java Runtime Environment (JRE) or Java Devel…

    2026年9月22日
    000
  • 怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法

    怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法怎样在iPhone情侣模式中分享视频?快速上传和同步的实用方法

    最实用的方法是使用iCloud共享相簿,它支持情侣间视频快速上传与实时同步。首先双方需开启iCloud照片中的共享相簿功能,然后创建专属相簿并邀请对方加入。此后,任一方添加的视频会自动同步至对方设备,且不占用个人iCloud空间。相比AirDrop(限近距离)、即时通讯工具(压缩画质)或云盘(占存储…

    2026年9月22日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信