如何用Python源码分析电影台词 Python源码识别剧本文本主题

核心答案是通过python读取、清洗、分词、统计词频、过滤停用词、情感分析和主题建模来分析电影台词;2. 首先用read_script读取utf-8编码的剧本文件;3. 用正则表达式clean_script移除场景描述、人物名及空行;4. 使用word_tokenize分词并用counter统计高频词;5. 通过stopwords过滤无意义词后再次统计;6. 调用vader进行情感分析获得四类得分;7. 可选lda模型挖掘深层主题;8. 不同剧本格式需定制正则或转为统一文本;9. 提升情感准确性可自定义词典、用深度学习模型或结合剧情;10. 还可拓展分析人物关系、剧情起伏、语言风格和文化背景,完整实现机器对电影内容的理解。
如何用Python源码分析电影台词 Python源码识别剧本文本主题

用Python源码分析电影台词,核心在于提取、清洗、分析文本数据,进而识别剧本的主题和情感。简单来说,就是让机器读懂电影在说什么。
如何用Python源码分析电影台词 Python源码识别剧本文本主题

解决方案

首先,你需要一个电影剧本的文本文件。别指望直接从视频里提取台词,那得用到更复杂的语音识别技术,咱们先从简单的开始。

立即学习“Python免费学习笔记(深入)”;

如何用Python源码分析电影台词 Python源码识别剧本文本主题读取剧本文件:

def read_script(filepath):    with open(filepath, 'r', encoding='utf-8') as f:        script = f.read()    return scriptscript = read_script('your_movie_script.txt') # 替换成你的剧本文件路径

这里用了utf-8编码,因为很多剧本文件都包含特殊字符。

文本清洗:

剧本里除了台词,还有人物名字、场景描述等等。我们需要把这些噪音去掉。
如何用Python源码分析电影台词 Python源码识别剧本文本主题

import redef clean_script(script):    # 移除场景描述(假设场景描述都在方括号里)    script = re.sub(r'[.*?]', '', script)    # 移除人物名字(假设人物名字后面跟着冒号)    script = re.sub(r'^[A-Zs]+:', '', script, flags=re.MULTILINE)    # 移除多余的空行    script = re.sub(r'n+', 'n', script).strip()    return scriptcleaned_script = clean_script(script)

这个清洗方法比较粗糙,可能需要根据你的剧本格式进行调整。比如,人物名字的格式可能不一样,场景描述也可能用其他符号。

分词:

把清洗后的文本分割成一个个单词。

import nltkfrom nltk.tokenize import word_tokenizenltk.download('punkt') # 首次运行需要下载punkttokens = word_tokenize(cleaned_script)

词频统计:

统计每个单词出现的次数。

from collections import Counterword_counts = Counter(tokens)# 打印出现频率最高的10个词print(word_counts.most_common(10))

通过词频统计,你可以初步了解剧本的主题。比如,如果”love”、”heart”、”forever”出现频率很高,那很可能是一个爱情故事。

停用词过滤:

像”the”、”a”、”is”这些词对分析主题没什么帮助,需要过滤掉。

from nltk.corpus import stopwordsnltk.download('stopwords') # 首次运行需要下载stopwordsstop_words = set(stopwords.words('english'))filtered_tokens = [w for w in tokens if not w in stop_words]filtered_word_counts = Counter(filtered_tokens)print(filtered_word_counts.most_common(10))

情感分析:

可以使用现成的情感分析库,比如VADER

from nltk.sentiment.vader import SentimentIntensityAnalyzernltk.download('vader_lexicon') # 首次运行需要下载vader_lexiconsid = SentimentIntensityAnalyzer()def analyze_sentiment(text):    scores = sid.polarity_scores(text)    return scoressentiment_scores = analyze_sentiment(cleaned_script)print(sentiment_scores)

VADER会返回一个包含积极、消极、中性和复合情感得分的字典。

主题建模(进阶):

如果想更深入地挖掘主题,可以使用主题建模技术,比如Latent Dirichlet Allocation (LDA)。这需要用到gensim库。

from gensim import corpora, models# 创建词典dictionary = corpora.Dictionary([filtered_tokens])# 创建文档词袋模型doc_term_matrix = [dictionary.doc2bow(tokens) for tokens in [filtered_tokens]]# LDA模型lda_model = models.LdaModel(doc_term_matrix, num_topics=3, id2word=dictionary, passes=15)# 打印主题topics = lda_model.print_topics(num_words=5)for topic in topics:    print(topic)

LDA会将剧本分成几个主题,并列出每个主题相关的关键词。

如何处理不同格式的剧本文件?

剧本格式五花八门,有的用 Courier New 字体,有的用 Final Draft 软件,所以清洗文本这一步非常关键。你需要仔细观察剧本的结构,找到人物名字、场景描述、台词的规律,然后编写相应的正则表达式。如果剧本格式非常复杂,可以考虑使用专门的剧本解析库,比如screenplain,但这类库可能需要付费。另一个思路是,手动将剧本转换成统一的格式,比如 Markdown 或纯文本,再进行分析。

如何提高情感分析的准确性?

VADER虽然简单易用,但它的情感词典是通用的,可能不适用于所有电影。比如,一些电影里可能会出现反讽、幽默等特殊情况,导致VADER的分析结果不准确。为了提高准确性,你可以尝试以下方法:

自定义情感词典: 根据电影的特点,添加或修改VADER的情感词典。使用更高级的情感分析模型: 比如,使用基于深度学习的情感分析模型,这些模型通常能够更好地理解上下文。结合其他信息: 比如,结合人物关系、剧情发展等信息,进行更全面的情感分析。

除了主题和情感,还能分析什么?

除了主题和情感,还可以分析以下内容:

人物关系: 分析人物之间的对话,构建人物关系网络。剧情发展: 分析不同场景的情感变化,了解剧情的起伏。语言风格: 分析人物的用词习惯,了解人物的性格特点。文化背景: 分析剧本中出现的文化元素,了解电影的文化背景。

例如,你可以统计每个角色说的台词数量,看看谁是主角;你可以分析不同角色之间的对话情感,看看他们之间的关系是友好还是敌对;你还可以分析剧本中出现的地点、时间等信息,了解故事发生的背景。

以上就是如何用Python源码分析电影台词 Python源码识别剧本文本主题的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1366440.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python源码实现电影评分自动抓取 自动提取IMDB数据的Python源码方式
上一篇 2025年12月14日 05:11:46
怎么使用CatBoost检测分类数据异常?
下一篇 2025年12月14日 05:11:52

相关推荐

  • 抖音辅助账号上限怎么解除?抖音辅助账号上限解除最简单方法

    抖音辅助账号上限怎么解除?抖音辅助账号上限解除最简单方法抖音辅助账号上限怎么解除?抖音辅助账号上限解除最简单方法抖音辅助账号上限怎么解除?抖音辅助账号上限解除最简单方法抖音辅助账号上限怎么解除?抖音辅助账号上限解除最简单方法

    在如今火爆的短视频领域,抖音已成为众多内容创作者和商家运营的首选平台。为了实现更高效的推广与内容分发,不少人选择使用辅助账号来配合主账号运营。然而,“抖音辅助账号上限”这一问题常常让用户感到困扰。本文将为你全面解析抖音辅助账号上限怎么解除,并分享最实用、最简单的解决策略,助你轻松突破限制,玩转抖音生…

    2026年9月24日 用户投稿
    000
  • ubuntu如何安装vnc客户端

    在ubuntu上安装vnc客户端有多种方法,以下是几种常见的方法: 方法一:使用APT包管理器 更新包列表: sudo apt update 安装VNC客户端: sudo apt install xtightvncviewer 方法二:使用Snap包管理器 如果你更喜欢使用Snap包管理器,可以按照…

    2026年9月24日
    800
  • 下一代GPU的功耗会突破1000W吗?

    下一代GPU的功耗会突破1000W吗?下一代GPU的功耗会突破1000W吗?下一代GPU的功耗会突破1000W吗?下一代GPU的功耗会突破1000W吗?

    消费级GPU尚未突破1000W,RTX 5090约575W–600W;而数据中心AI芯片如英伟达B200已达1000W,GB200模块超1700W,进入“千瓦时代”。 下一代GPU的功耗是否会突破1000W,要分消费级和数据中心两个层面来看。目前来看,消费级显卡尚未达到这一水平,但数据中心级的AI芯…

    2026年9月24日 用户投稿
    200
  • sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置

    sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置

    Sublime Text需安装插件实现Markdown图片预览:1. 通过Package Control安装MarkdownEditing、MarkdownPreview或OmniMarkupPreviewer;2. 使用MarkdownPreview在浏览器中预览,确保图片路径正确;3. Omni…

    2026年9月24日 用户投稿
    000
  • 马斯克第六次起诉 OpenAI,指控窃取商业机密

    马斯克第六次起诉 OpenAI,指控窃取商业机密马斯克第六次起诉 OpenAI,指控窃取商业机密马斯克第六次起诉 OpenAI,指控窃取商业机密马斯克第六次起诉 OpenAI,指控窃取商业机密

    马斯克再度将 openai 告上法庭,这是他在过去十八个月内第六次针对这家人工智能公司发起法律行动。此次,由马斯克创立的人工智能企业 xai 已向加利福尼亚北区联邦法院提交诉状,指控 openai 大规模挖角其关键技术人才,并涉嫌非法获取商业机密。 随着双方矛盾不断升级,诉讼内容也从最初的合同纠纷逐…

    2026年9月24日 用户投稿
    000
  • VibeVoice— 微软推出的开源文本转语音模型

    VibeVoice— 微软推出的开源文本转语音模型VibeVoice— 微软推出的开源文本转语音模型VibeVoice— 微软推出的开源文本转语音模型VibeVoice— 微软推出的开源文本转语音模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 微软文字转语音 微软文本转语音,支持选择多种语音风格,可调节语速。 0 查看详情 VibeVoice是什么 vibevoice 是微软最新推出的文本到语音(tts)模型,能够生成具有丰富情感、支…

    2026年9月24日 用户投稿
    700
  • 如何断开mysql数据库连接

    如何断开mysql数据库连接如何断开mysql数据库连接如何断开mysql数据库连接如何断开mysql数据库连接

    为了断开 MySQL 数据库连接,需要按以下步骤进行:创建连接对象获取连接游标关闭游标关闭连接 如何断开 MySQL 数据库连接 要断开 MySQL 数据库连接,可以使用以下步骤: 1. 创建连接对象 首先,使用 connect() 函数创建到数据库的连接对象,该函数需要一个数据库连接参数字符串作为…

    2026年9月24日 用户投稿
    100
  • AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”

    AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”

    10 月 15 日,荣耀即将正式推出 magic8 系列新机。在发布会前夕,官方持续释放预热信息。据 cnmo 获悉,最新一轮预热中,荣耀强调:magic8 系列配备品牌史上最强的硬件组合,通过 ai 深度赋能硬件系统,打造八大行业领先技术,树立新一代旗舰标杆。 荣耀 Magic8 系列 那么,这“…

    2026年9月24日 用户投稿
    100
  • 创建包含列表对象的Java对象时,避免列表为空的技巧

    创建包含列表对象的Java对象时,避免列表为空的技巧创建包含列表对象的Java对象时,避免列表为空的技巧创建包含列表对象的Java对象时,避免列表为空的技巧创建包含列表对象的Java对象时,避免列表为空的技巧

    在Java中,如果一个类的属性是列表类型,在创建该类的实例时,如果没有显式地初始化该列表,那么该属性的默认值将会是null。这可能会导致在后续操作中出现空指针异常。为了避免这种情况,我们需要确保在创建对象时,列表属性被初始化为一个空列表,而不是null。 解决方案一:显式初始化列表 最直接的方法是在…

    2026年9月24日 用户投稿
    000
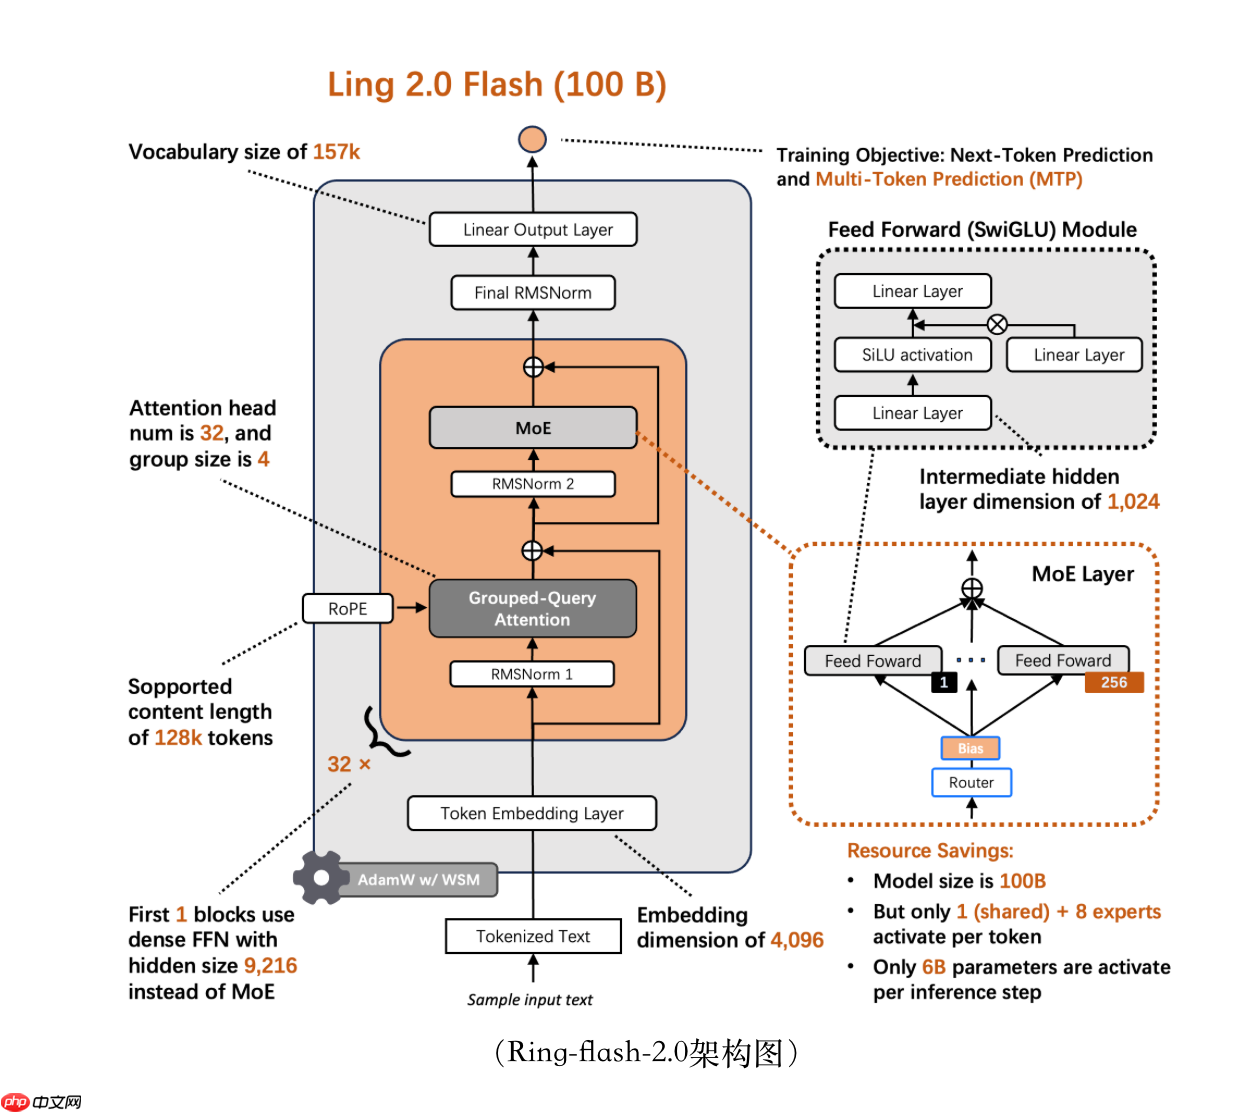
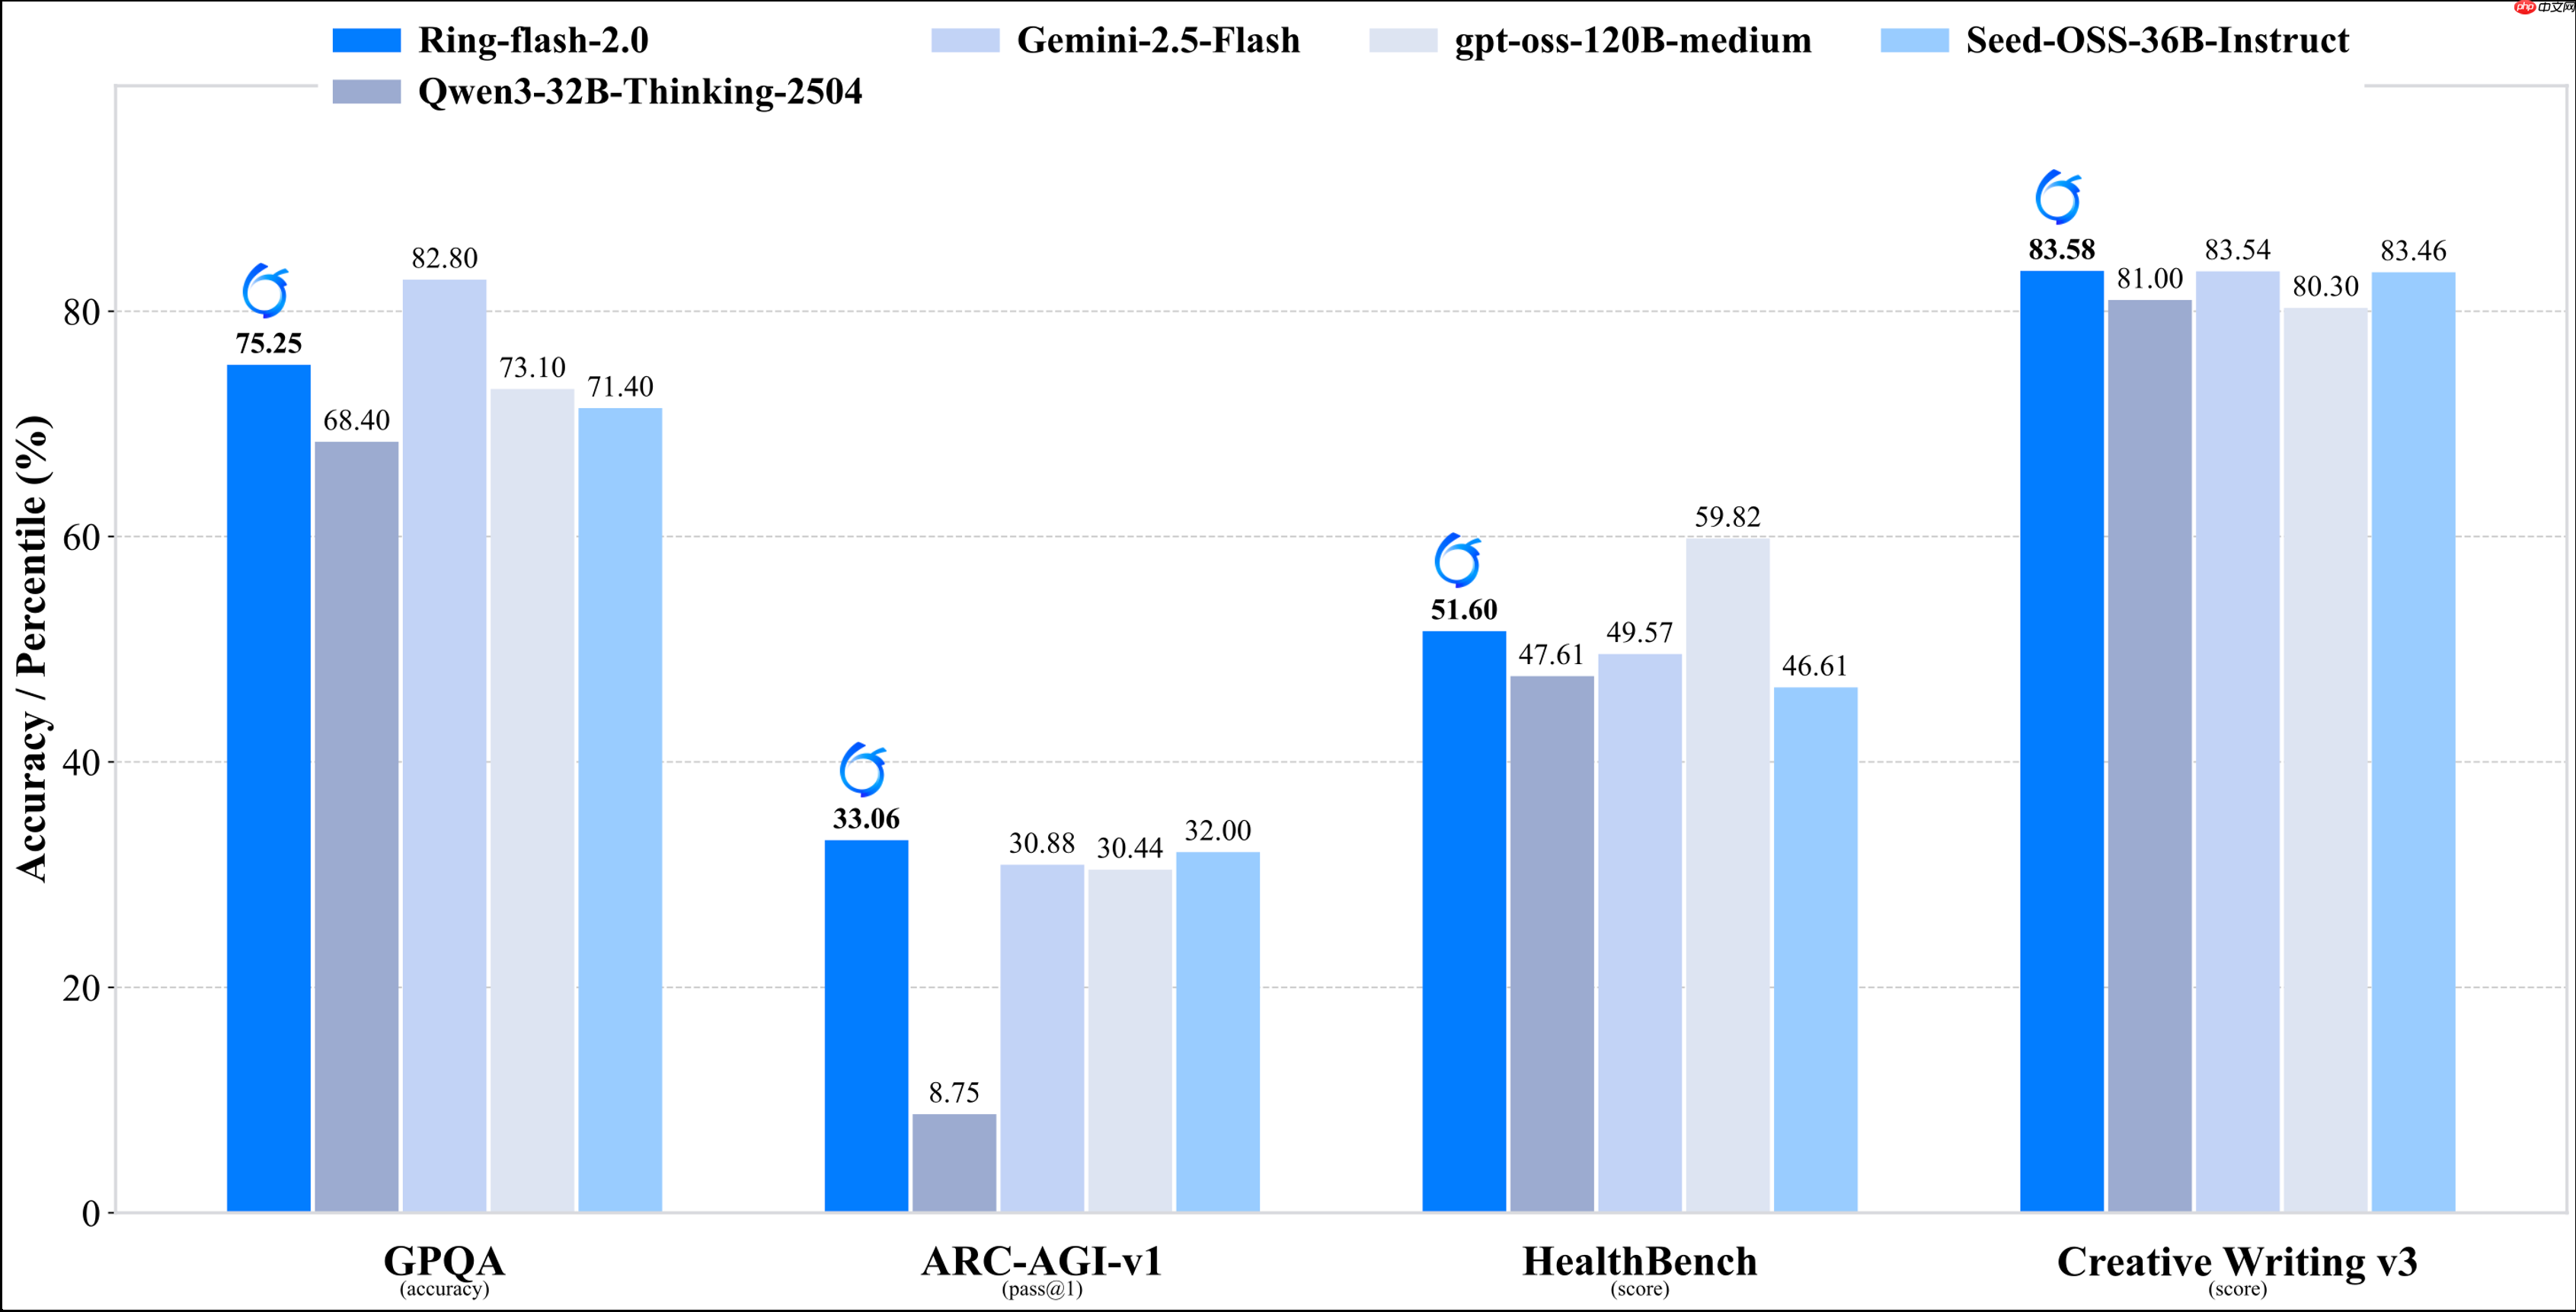
  • 蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0

    蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0

    蚂蚁百灵大模型团队宣布正式开源 ring-flash-2.0,这是一款基于 ling-flash-2.0-base 深度优化的高效思考模型。与 ling-flash-2.0 一致,ring-flash-2.0 拥有总计 100b 参数,但在每次推理过程中仅激活 6.1b 参数,显著提升计算效率。 R…

    2026年9月24日 用户投稿
    000
  • 多模态AI如何处理射电望远镜数据 多模态AI深空探测应用

    多模态AI如何处理射电望远镜数据 多模态AI深空探测应用多模态AI如何处理射电望远镜数据 多模态AI深空探测应用多模态AI如何处理射电望远镜数据 多模态AI深空探测应用多模态AI如何处理射电望远镜数据 多模态AI深空探测应用

    多模态ai通过融合多种数据提升射电望远镜数据分析能力。它将无线电信号转化为频谱图、时间序列等形式,并结合光学图像等信息综合判断信号频率、强度、出现时间与方向;1.时空对齐匹配不同设备数据;2.特征级融合提取关键特征;3.决策级融合综合多个模型结果;实际应用于“突破聆听计划”筛选射电信号,面临数据格式…

    2026年9月24日 用户投稿
    200
  • sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法

    sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法

    首先手动设置SQL语法高亮,点击右下角语言模式选择SQL;接着将.sql文件默认关联为SQL语法打开;然后通过Package Control安装SQLTools等插件增强功能;最后可自定义颜色主题优化显示效果。 Sublime Text 默认支持多种编程语言的语法高亮,但对 SQL 文件的支持可能不…

    2026年9月24日 用户投稿
    000
  • 怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型

    怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型

    实现cqrs模式可通过三步借助豆包ai快速完成:一、理清业务场景,将写操作(如用户下单)与读操作(如查看订单列表)分离,可复制代码给豆包ai分析归类;二、让豆包ai生成基础结构代码,输入类似“基于cqrs的订单管理系统,用python flask实现”的指令,获取命令处理器、查询处理器等模块模板;三…

    2026年9月24日 用户投稿
    000
  • WPS如何制作个人简历_WPS简历模板选择与内容填写教程

    WPS如何制作个人简历_WPS简历模板选择与内容填写教程WPS如何制作个人简历_WPS简历模板选择与内容填写教程WPS如何制作个人简历_WPS简历模板选择与内容填写教程WPS如何制作个人简历_WPS简历模板选择与内容填写教程

    使用WPS制作简历需先选择合适模板,填写个人信息、求职意向、教育背景、工作经历等内容,突出成果与技能,调整格式后导出为PDF。关键在于内容真实、条理清晰、重点突出,便于HR快速识别优势。 在求职过程中,一份清晰、专业的简历至关重要。WPS Office 提供了多种简历模板和便捷的编辑功能,帮助用户快…

    2026年9月24日 用户投稿
    300
  • 星纪魅族万志强回应魅族 22 影像升级:10 月还会有 OTA

    星纪魅族万志强回应魅族 22 影像升级:10 月还会有 OTA星纪魅族万志强回应魅族 22 影像升级:10 月还会有 OTA星纪魅族万志强回应魅族 22 影像升级:10 月还会有 OTA星纪魅族万志强回应魅族 22 影像升级:10 月还会有 OTA

    10 月 13 日,星纪魅族集团中国区 cmo 万志强对用户认可魅族 22 手机影像表现作出回应。他表示,本月还将迎来一次 ota 更新,届时魅族 22 的影像能力有望再度升级。 魅族 22 据 CNMO 消息,有用户反馈称:尽管魅族 22 在拍照方面并非顶尖水准,但在短短几个月内已达到主流影像旗舰…

    2026年9月24日 用户投稿
    000
  • 袋鼠数据库工具 8.90.1 版已上线

    袋鼠数据库工具 8.90.1 版已上线袋鼠数据库工具 8.90.1 版已上线袋鼠数据库工具 8.90.1 版已上线袋鼠数据库工具 8.90.1 版已上线

    袋鼠数据库工具 是一款由 ai 驱动的主流数据库系统客户端,支持多种数据库类型,包括 mariadb、mongodb、mysql、oracle、postgresql、redis、sqlite、sqlserver 等,具备建表、数据查询、模型设计、结构同步、数据导入导出等丰富功能。兼容 windows…

    2026年9月24日 用户投稿
    000
  • 使用 Appium 实现 Gmail OTP 验证自动化

    使用 Appium 实现 Gmail OTP 验证自动化使用 Appium 实现 Gmail OTP 验证自动化使用 Appium 实现 Gmail OTP 验证自动化使用 Appium 实现 Gmail OTP 验证自动化

    本文档旨在指导开发者如何使用 Appium 自动化测试移动应用中的 Gmail OTP (One-Time Password) 验证流程。我们将探讨如何通过 Appium 定位 OTP 输入框,并使用获取到的 OTP 值进行输入,从而完成验证流程的自动化。 定位 OTP 输入框 在 Appium 中…

    2026年9月24日 用户投稿
    200
  • AI工具+自动发布系统:打造不熬夜的新媒体工作流

    AI工具+自动发布系统:打造不熬夜的新媒体工作流AI工具+自动发布系统:打造不熬夜的新媒体工作流AI工具+自动发布系统:打造不熬夜的新媒体工作流AI工具+自动发布系统:打造不熬夜的新媒体工作流

    ai工具和自动发布系统能高效提升新媒体运营效率,解放时间和精力。①ai可生成文案、分析数据、优化内容;②自动发布系统支持定时发布,避免遗漏;③选择ai工具需明确需求、试用对比;④使用时注意平台兼容性、账号安全;⑤配合标准化流程、批量处理等技巧,兼顾质量与效率。 ☞☞☞AI 智能聊天, 问答助手, A…

    2026年9月24日 用户投稿
    000
  • VSCode如何设置代码缩进和制表符 VSCode缩进与制表符的自定义调整方法

    要解决vscode缩进混乱问题,需将”editor.detectindentation”设为false,避免自动检测干扰;2. 统一使用空格或制表符的关键在于团队一致性,推荐通过settings.json明确设置”editor.insertspaces&#8221…

    2026年9月24日
    100
  • DeepSeek-V3.2-Exp 发布,训练推理提效,API 同步降价

    DeepSeek-V3.2-Exp 发布,训练推理提效,API 同步降价DeepSeek-V3.2-Exp 发布,训练推理提效,API 同步降价DeepSeek-V3.2-Exp 发布,训练推理提效,API 同步降价DeepSeek-V3.2-Exp 发布,训练推理提效,API 同步降价

    深度求索正式推出 deepseek-v3.2-exp 模型,该版本为实验性(experimental)更新。 作为通向新一代架构的过渡性尝试,V3.2-Exp 在 V3.1-Terminus 的基础上集成了 DeepSeek Sparse Attention(DSA),引入了一种创新的稀疏注意力机制…

    2026年9月24日 用户投稿
    700

发表回复

登录后才能评论
关注微信