Python高效处理.txt文件中的数值数据

python高效处理.txt文件中的数值数据

本教程详细介绍了如何使用Python从结构化文本文件中提取数值并进行计算。我们将学习如何安全地读取文件、利用字符串分割技术(如split()方法)解析数据行,将提取的字符串转换为数值类型,并对每个数据组进行求和操作。通过实际代码示例,您将掌握处理类似数据格式的有效方法,确保文件操作的健壮性。

1. 理解数据结构与处理挑战

在日常数据处理中,我们经常会遇到需要从文本文件中提取特定信息并进行计算的场景。例如,一个.txt文件可能包含如下格式的数据:

Monday: 12,34,-90Saturday: 32,-23,20

每一行都由一个标签(如“Monday”)、一个冒号(:)和一组用逗号(,)分隔的数值组成。我们的目标是分别计算每个标签下所有数值的总和。

处理这类数据的挑战在于:

文件内容是字符串形式,数值需要转换为可计算的数字类型。一行中混合了字符串(标签)和数值。数值之间有特定的分隔符(逗号)。需要逐行处理文件。

2. 核心处理步骤

为了有效地从上述文件中提取并计算数值,我们需要遵循以下步骤:

立即学习“Python免费学习笔记(深入)”;

2.1 安全的文件读取

在Python中,推荐使用with open(…)语句来打开文件。这种方式被称为上下文管理器,它能确保文件在操作完成后(无论是否发生错误)被正确关闭,从而避免资源泄露。

with open('TB1.txt', 'r') as file:    # 文件处理逻辑    pass

这里,’TB1.txt’是文件路径,’r’表示以只读模式打开文件。文件对象被赋值给变量file。

2.2 逐行读取与字符串分割

文件对象是可迭代的,可以直接通过for循环逐行读取。对于每一行,我们需要进行两次字符串分割:

第一次分割: 使用冒号:作为分隔符,将标签和数值字符串分离。第二次分割: 对数值字符串部分,使用逗号,作为分隔符,将其拆分成独立的数值字符串列表。

    for line in file:        # 移除行尾的换行符,避免影响后续处理        line = line.strip()         if not line: # 跳过空行            continue        label, fields_str = line.split(':')        values_str_list = fields_str.split(',')

line.strip()方法用于移除字符串开头和结尾的空白字符,特别是行尾的换行符(n),这对于后续的字符串处理非常重要。

2.3 数据类型转换与求和

从文本中分割出来的数值仍然是字符串类型,不能直接进行数学运算。我们需要使用int()函数将这些字符串转换为整数。然后,遍历转换后的整数,将它们累加起来。

        current_sum = 0        for v_str in values_str_list:            try:                # 尝试将字符串转换为整数                value = int(v_str.strip()) # 再次strip以防数值前后有空格                current_sum += value            except ValueError:                # 处理非数字字符的情况,例如日志记录或跳过                print(f"警告: 无法将 '{v_str}' 转换为数字,已跳过。")                continue

这里加入了try-except块,这是一个良好的编程实践。它能够捕获ValueError异常,以防文件中出现非数字的字符串(例如,”abc”),从而避免程序崩溃。

3. 完整代码示例

结合上述步骤,以下是用于计算TB1.txt文件中数值总和的完整Python代码:

def calculate_sums_from_file(filepath):    """    从指定文本文件中读取数据,计算每个标签下的数值总和,并打印结果。    Args:        filepath (str): 待处理的文本文件路径。    """    try:        with open(filepath, 'r') as file:            print(f"正在处理文件: {filepath}")            for line in file:                # 移除行首尾的空白字符,包括换行符                line = line.strip()                 # 跳过空行                if not line:                    continue                # 第一次分割:按冒号分离标签和数值字符串                if ':' not in line:                    print(f"警告: 行格式不正确,缺少冒号: '{line}',已跳过。")                    continue                label, fields_str = line.split(':', 1) # 使用split(delimiter, 1)确保只按第一个冒号分割                # 第二次分割:按逗号分离各个数值字符串                values_str_list = fields_str.split(',')                current_sum = 0                for v_str in values_str_list:                    try:                        # 转换字符串为整数,再次strip以防数值前后有空格                        value = int(v_str.strip())                        current_sum += value                    except ValueError:                        print(f"警告: 在行 '{line}' 中,无法将 '{v_str.strip()}' 转换为数字,已跳过。")                        continue                # 打印结果                print(f"{label.strip()}: {current_sum}")    except FileNotFoundError:        print(f"错误: 文件 '{filepath}' 未找到。请检查文件路径。")    except Exception as e:        print(f"发生未知错误: {e}")# 假设文件名为 TB1.txt 且与脚本在同一目录下# 创建一个示例文件 TB1.txt 以供测试# with open('TB1.txt', 'w') as f:#     f.write("Monday: 12,34,-90n")#     f.write("Saturday: 32,-23,20n")#     f.write("Tuesday: 1,2,3,4,5n")#     f.write("Invalid: abc,10,20n")#     f.write("n") # 空行#     f.write("NoColonHeren") # 格式错误行# 调用函数进行计算calculate_sums_from_file('TB1.txt')

4. 代码解析与最佳实践

with open(…)语句: 这是Python中处理文件的标准和推荐方式。它创建了一个上下文,确保文件在使用完毕后(无论是正常结束还是发生异常)都会被自动关闭,从而避免了手动调用file.close()可能带来的遗漏和资源泄露问题。line.strip(): 在处理从文件中读取的每一行时,strip()方法至关重要。它会移除字符串两端的空白字符,包括常见的换行符(n)和回车符(r),确保后续的split()操作不会因为这些隐藏字符而产生意料之外的结果。split(‘:’)和split(‘,’): split()方法是字符串处理的利器。它根据指定的分隔符将字符串拆分成一个列表。line.split(‘:’, 1):这里的1是一个可选参数,表示最多只进行一次分割。这在确保只按第一个冒号分割时非常有用,即使数据部分也包含冒号(尽管在本例中不太可能)。fields_str.split(‘,’):将数值字符串按逗号分割,得到一个包含所有数值字符串的列表。int(v_str.strip()): 在将字符串转换为整数之前,再次对v_str进行strip()操作是一个好习惯。这可以防止因数值字符串中可能存在的额外空格(例如” 12″或”34 “)而导致的ValueError。错误处理 (try-except):try-except ValueError:用于捕获当int()函数尝试将非数字字符串转换为整数时抛出的错误。这使得程序在遇到脏数据时不会崩溃,而是能够跳过或记录问题。try-except FileNotFoundError:用于捕获文件不存在时的错误,给用户提供明确的提示。try-except Exception as e:一个通用的异常捕获,用于捕获其他未预料到的错误,提高程序的健壮性。f-string格式化输出: print(f”{label.strip()}: {current_sum}”)使用了f-string(格式化字符串字面量),这是一种简洁高效的字符串格式化方式,可以直接在字符串中嵌入表达式。

5. 注意事项与扩展

数据清洗: 实际数据往往比示例更复杂。在进行int()转换前,可能需要更复杂的正则表达式或字符串处理方法来清洗数据,确保只有纯数字字符。浮点数处理: 如果文件中包含小数,应使用float()而不是int()进行类型转换。分隔符变化: 如果文件中的分隔符可能变化(例如,有时是逗号,有时是分号),则需要更灵活的解析逻辑,例如通过检查行内容来动态确定分隔符。空值处理: 如果数值部分可能为空(例如”Monday: 12,,34″),split(‘,’)会产生空字符串,int(”)会报错。此时,需要额外判断v_str是否为空。数据存储: 如果需要将计算结果保存起来,可以将结果存储到一个字典中(键为标签,值为总和),或者写入另一个文件。

6. 总结

通过本教程,我们学习了如何使用Python高效、安全地从结构化文本文件中提取数值并进行计算。核心在于利用with open()进行文件管理,结合strip()和split()方法进行字符串解析,并通过int()或float()进行类型转换,同时使用try-except进行健壮的错误处理。掌握这些技巧,将使您能够处理各种复杂的文本数据提取和计算任务。

以上就是Python高效处理.txt文件中的数值数据的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1366765.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Spark 并行读取但写入分区时仅使用单核的解决方案
上一篇 2025年12月14日 06:51:03
Pydantic V2 判别式联合:解决多态数据模型解析歧义
下一篇 2025年12月14日 06:51:12

相关推荐

  • 豆包AI是否能生成代码 豆包代码生成功能及其适用范围分析

    本文将围绕豆包AI是否能生成代码这一问题展开探讨。我们将首先确认其代码生成能力,随后详细讲解如何有效利用此功能,并通过步骤拆解,帮助用户掌握操作过程。最后,会分析该功能的适用场景与潜在局限,以便用户能更全面地理解和运用。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Deep…

    2026年9月26日
    100
  • 优化VSCode远程SSH开发体验与高性能扩展加载方案

    通过优化SSH连接复用、按需加载扩展、预启动远程服务及本地协同调优,可显著提升VSCode远程开发体验。具体包括:配置ControlMaster实现连接共享,减少重复认证;使用高效加密算法加快传输;通过extensionKind分离本地与远程扩展,降低远程负载;设置VSCODE_AGENT_FOLD…

    2026年9月26日
    000
  • 怎么让豆包AI生成Python数据可视化代码

    怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码

    明确需求、指定图表类型和库、提供数据结构或示例,能高效让豆包ai生成python可视化代码。1. 先说明要画什么图,如“柱状图”;2. 指定用哪个库,如matplotlib或seaborn;3. 提供数据结构或部分数据;4. 检查生成代码是否完整,必要时补充导入语句或显示命令。 ☞☞☞AI 智能聊天…

    2026年9月26日 • 用户投稿
    000
  • sublime怎么配置python开发环境_sublime搭建Python开发环境教程

    sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程sublime怎么配置python开发环境_sublime搭建Python开发环境教程

    首先安装Sublime Text并配置Package Control,接着安装Anaconda等插件以实现代码补全与检查,然后设置Python编译系统运行脚本,最后通过代码格式化、多光标编辑等功能提升开发效率。 Sublime Text 是一款轻量级但功能强大的代码编辑器,适合快速编写和调试 Pyt…

    2026年9月26日 • 用户投稿
    100
  • 如何通过豆包AI进行异常检测?离群值分析实战

    如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战如何通过豆包AI进行异常检测?离群值分析实战

    异常检测是识别数据集中不符合预期模式的数据点的过程,这些“异常”可能由错误、欺诈、设备故障等引起,在金融、网络安全、制造质量控制等领域具有重要意义。常见方法包括基于统计的z-score、iqr法;基于距离的knn;孤立森林;one-class svm;以及深度学习中的自编码器。其中孤立森林因高效性和…

    2026年9月26日 • 用户投稿
    100
  • 解决Android计算器应用崩溃问题:字符串解析与空值处理

    解决Android计算器应用崩溃问题:字符串解析与空值处理解决Android计算器应用崩溃问题:字符串解析与空值处理解决Android计算器应用崩溃问题:字符串解析与空值处理解决Android计算器应用崩溃问题:字符串解析与空值处理

    本文旨在帮助开发者解决Android计算器应用中因字符串解析导致的崩溃问题。通过检查计算器屏幕显示结果的空值情况并进行适当处理,可以避免Double.parseDouble()方法在解析空字符串时引发的异常,从而提升应用的稳定性和用户体验。本文将提供详细的解决方案和代码示例,帮助你构建更健壮的And…

    2026年9月26日 • 用户投稿
    000
  • sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法

    sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法sublime怎么查看函数列表_sublime显示函数或方法导航列表的方法

    使用 Ctrl+R(或 Cmd+R)可打开符号面板查看函数列表,支持搜索并跳转;确保文件类型正确识别以启用解析;搭配 CTags 插件可增强索引与跨文件导航能力。 在 Sublime Text 中查看函数或方法列表,可以通过内置的侧边栏符号导航功能快速实现。这个功能会自动分析当前文件中的函数、类、方…

    2026年9月26日 • 用户投稿
    100
  • 用豆包AI实现Python内存管理优化

    用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化

    豆包ai可通过分析内存使用模式、优化数据结构与对象创建、辅助编写内存友好代码帮助python内存管理优化。1. 发送代码片段给豆包ai,询问潜在内存问题,如循环引用或缓存未释放,并获得使用gc模块或弱引用的建议;2. 让豆包ai识别低效对象创建和不恰当数据结构,推荐生成器、itertools函数、节…

    2026年9月26日 • 用户投稿
    100
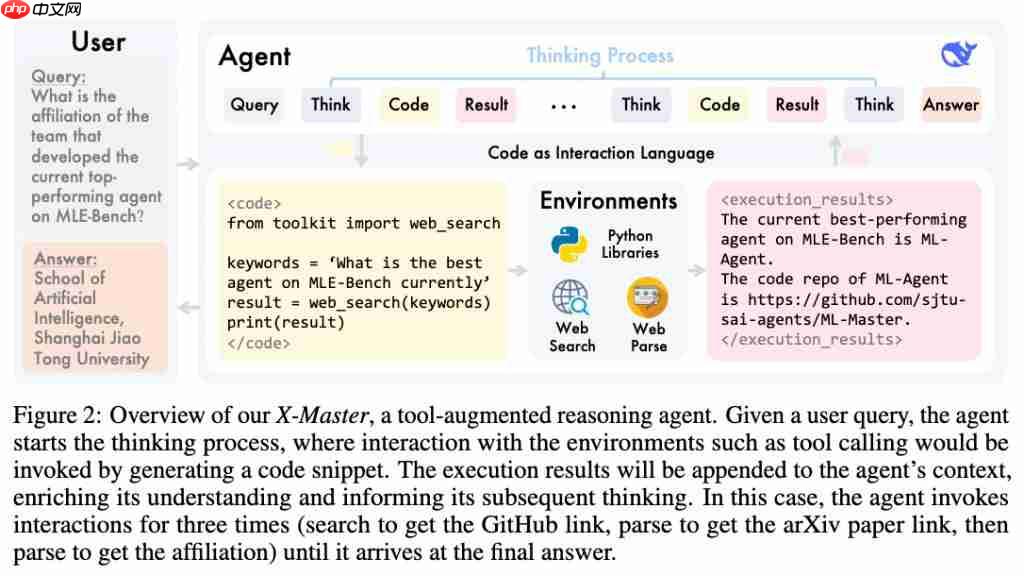
  • DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌

    DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌

    ” 人类最后的考试 ” 首次突破 30 分,还是咱国内团队干的! 该测试集是出了名的超难,刚推出时无模型得分能超过 10 分。 直到最近,最高分也不过 26.9,由 Kimi-Research 和 Gemini Deep Research 并列取得。 现在,上海交大联合深势科…

    2026年9月26日 • 用户投稿
    200
  • 时间处理最佳实践:UTC 与时区转换

    时间处理最佳实践:UTC 与时区转换时间处理最佳实践:UTC 与时区转换时间处理最佳实践:UTC 与时区转换时间处理最佳实践:UTC 与时区转换

    本文旨在阐述在应用程序中处理日期和时间的最佳实践,尤其是在 UI 和后端之间传递时间信息时。核心思想是坚持使用 UTC 作为数据存储和交换的通用标准,并在用户界面展示或特定业务逻辑需要时才进行时区转换。本文将深入探讨如何使用 java.time 库中的 Instant 和 ZonedDateTime…

    2026年9月26日 • 用户投稿
    400
  • VSCode如何实现脑机接口编程 VSCode神经信号分析工具集成

    vscode本身没有内置脑机接口功能,而是通过其扩展性支持bci编程。1. 安装python扩展并配置虚拟环境以管理依赖;2. 使用brainflow采集数据、mne-python处理eeg/meg信号,并通过jupyter notebook在vscode中进行交互式分析;3. 利用vscode调试…

    2026年9月26日
    200
  • sublime如何禁用拼写检查_sublime关闭拼写检查方法

    sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法sublime如何禁用拼写检查_sublime关闭拼写检查方法

    Sublime Text默认开启拼写检查,可用红色波浪线标记疑似错误;2. 可通过菜单临时关闭当前文件的拼写检查;3. 修改用户设置添加”spell_check”: false可永久全局关闭;4. 针对特定语言语法文件添加该配置则仅关闭对应类型文件的检查;5. 关闭后红色波浪…

    2026年9月26日 • 用户投稿
    300
  • 用豆包AI生成Python数据挖掘代码

    用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码

    想用豆包ai生成python数据挖掘代码的关键在于明确任务目标和数据结构。1. 首先明确数据挖掘任务类型,如分类、聚类或回归,并具体描述需求,例如“根据用户年龄、消费金额和购买频率做客户分群”。2. 接着提供清晰的数据格式与来源,比如说明csv文件中的字段信息,以便ai进行数据预处理和建模。3. 要…

    2026年9月25日 • 用户投稿
    1000
  • RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    10月13日,当汽车与高性能计算相遇,会激发出怎样的创意奇迹?nvidia在最新一期geforce garage节目中揭晓了答案。 这一次,他们携手改装界传奇人物JCustom(Justin Chu),将一台完整的RTX 5080游戏主机巧妙植入保时捷911的轮毂之中,实现了汽车工艺与电脑科技的惊艳…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么折叠所有代码_sublime代码折叠快捷方法

    sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法

    Sublime Text 支持多种代码折叠快捷键,Windows/Linux 使用 Ctrl + Shift + [/] 折叠/展开代码块,Ctrl + K, Ctrl + 1 展开所有用 Ctrl + K, Ctrl + J,macOS 用户将 Ctrl 替换为 Command。 在 Sublim…

    2026年9月25日 • 用户投稿
    200
  • 想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    ai模型组装工具与豆包联用是可行且高效的,关键在于接口兼容性、数据流转和部署方式。具体步骤如下:1. 理解豆包的模型接入规范,包括支持的模型格式、api调用方式及资源需求;2. 在组装工具中完成模型构建、训练与导出,确保符合平台要求;3. 如需转换模型格式(如pytorch转onnx),使用相应工具…

    2026年9月25日 • 用户投稿
    100
  • 如何利用Debian Apache日志提升网站性能

    如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能如何利用Debian Apache日志提升网站性能

    本文将阐述如何通过分析Debian系统下的Apache日志来提升网站性能。 一、日志分析基础 Apache日志记录了所有HTTP请求的详细信息,包括IP地址、时间戳、请求URL、HTTP方法和响应代码等。在Debian系统中,这些日志通常位于/var/log/apache2/access.log和/…

    2026年9月25日 • 用户投稿
    100
  • Java字符串高级解析:使用正则表达式处理复杂指令模式

    Java字符串高级解析:使用正则表达式处理复杂指令模式Java字符串高级解析:使用正则表达式处理复杂指令模式Java字符串高级解析:使用正则表达式处理复杂指令模式Java字符串高级解析:使用正则表达式处理复杂指令模式

    本教程演示如何使用Java的java.util.regex包,通过正则表达式高效解析包含多条调音指令的复杂字符串。我们将学习构建匹配特定模式的正则表达式,并利用Pattern和Matcher类从输入字符串中准确提取乐器名称、调音方向和数值,从而将原始指令转换为清晰可读的输出格式。 1. 问题背景与挑…

    2026年9月25日 • 用户投稿
    100
  • Debian Apache日志对SEO有何影响

    debian apache日志记录了网站的所有访问请求,包括ip地址、请求类型、响应状态等详细信息。这些日志对于seo有以下几个方面的影响: SEO GPT 免费的白帽SEO,PPC和网站经销商平台 17 查看详情 Apache日志对SEO的重要性 监控网站流量和用户行为:通过分析Apache访问日…

    2026年9月25日
    100
  • Java 中处理货币数据的正确方式

    Java 中处理货币数据的正确方式Java 中处理货币数据的正确方式Java 中处理货币数据的正确方式Java 中处理货币数据的正确方式

    在 Java 应用程序中,尤其是在处理财务数据时,选择正确的数据类型至关重要。货币数据通常以特定的格式呈现,例如包含货币符号(如美元符号 $)和千位分隔符(如逗号 ,)。直接将这些数据映射到 DTO 类时,我们需要仔细考虑数据类型的选择,以避免潜在的精度损失和计算错误。 货币数据类型选择考量 常见的…

    2026年9月25日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信