Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python函数如何用生成器函数处理大数据 Python函数生成器内存优化的应用技巧​_创想鸟

Python函数如何用生成器函数处理大数据 Python函数生成器内存优化的应用技巧​

生成器函数能有效避免处理大数据时的内存溢出问题,核心在于使用yield实现按需生成数据。1. 传统方法如readlines()会一次性将全部数据加载进内存,导致tb级文件或数据流处理时内存耗尽;2. 生成器函数通过yield返回生成器对象,每次调用next()或在for循环中迭代时才生成一个值,用完即释放,显著降低内存占用;3. 适用于超大文件逐行读取、流式数据处理、无限序列生成及构建数据处理管道等场景;4. 编写高效生成器需明确yield职责、用try…finally确保资源释放、通过链式生成器实现模块化处理、善用yield from简化嵌套逻辑、优先使用生成器表达式提升简洁性。因此,生成器是处理大规模数据时内存友好且pythonic的核心解决方案。

Python函数如何用生成器函数处理大数据 Python函数生成器内存优化的应用技巧​

Python函数在处理大数据时,生成器函数无疑是内存优化的一个核心利器。它不是把所有数据一次性加载到内存里,而是像一个勤劳的搬运工,需要一点就生成一点,用完就扔掉,这样就避免了内存被撑爆的风险,特别适合那些TB级别的文件或者永无止境的数据流。

解决方案

要用生成器函数处理大数据,核心就是理解并运用

yield

关键字。当你定义一个函数,里面包含

yield

语句时,这个函数就不再是普通的函数,而变成了一个生成器函数。它不会立即执行函数体内的所有代码,而是返回一个生成器对象。每次你对这个生成器对象调用

next()

方法(或者在

for

循环中使用),它才会执行到下一个

yield

语句,并返回

yield

后面的值。这样一来,数据是按需生成的,内存占用自然就小了。

比如说,我们要处理一个巨大的日志文件,一行行地读取。如果用

readlines()

一次性读完,内存可能就吃不消了。但用生成器,我们可以这么写:

立即学习“Python免费学习笔记(深入)”;

def read_large_file(filepath):    with open(filepath, 'r', encoding='utf-8') as f:        for line in f:            yield line.strip() # 每次只返回一行# 使用时# log_lines = read_large_file('very_big_log.txt')# for line in log_lines:#     process_line(line) # 处理一行,释放一行

你看,

read_large_file

函数每次只返回一行,处理完这一行,内存里就只剩下当前处理的这一行数据,而不是整个文件。这对于我来说,简直是处理海量数据的救星。

为什么传统方法在处理大数据时会“爆内存”?

这个问题,其实挺直观的。我们平时习惯了把数据一股脑儿地读进来,比如

list(file_object)

或者

file_object.readlines()

,这些操作都会尝试把文件的所有内容,或者数据库查询的所有结果,统统塞进内存里。你想想,如果一个文件有几十GB,甚至上百GB,而你的服务器内存可能只有几十GB,那它不“爆”才怪呢。

举个例子,假设你有一个10GB的CSV文件,里面全是用户行为记录。你写了个脚本,想把所有行读到一个列表里,然后慢慢处理。

# 假设这是传统方式处理大文件# data_rows = []# with open('big_data.csv', 'r', encoding='utf-8') as f:#     for line in f:#         data_rows.append(line.strip().split(','))# # 此时 data_rows 可能已经占用了巨大的内存

这段代码执行的时候,

data_rows

这个列表会随着文件内容的读取而不断膨胀,直到所有行都被添加进去。如果文件实在太大,你的内存条很快就会被填满,然后系统就开始使用交换空间(swap),这会大大降低程序的运行速度,甚至直接导致程序崩溃。我遇到过好几次这样的情况,看着内存占用飙升然后程序直接挂掉,那种感觉真是让人头疼。生成器就是为了避免这种尴尬局面而生的。

生成器函数在哪些场景下能发挥最大优势?

在我看来,生成器函数简直是为以下几种场景量身定制的:

处理超大文件:这绝对是生成器的主场。无论是日志文件、CSV数据、JSON Lines文件,只要是需要逐行或逐块处理的,用生成器来读取,内存占用会非常友好。你不需要关心文件到底有多大,只需要知道每次处理一小部分就行。流式数据处理:比如从网络接口接收实时数据流,或者处理消息队列里的消息。这些数据是源源不断到来的,你不可能等到所有数据都来了再处理。生成器可以让你边接收边处理,实现真正的流式计算。生成无限序列:有些数学序列,比如斐波那契数列,或者质数序列,理论上是无限的。你不可能生成一个包含所有斐波那契数的列表。但生成器可以轻松做到,每次

yield

一个,需要多少就生成多少。

def fibonacci_sequence():    a, b = 0, 1    while True:        yield a        a, b = b, a + b# f = fibonacci_sequence()# for _ in range(10):#     print(next(f))

构建数据处理管道:当你的数据处理流程比较复杂,需要经过多道工序(比如读取、清洗、转换、过滤),生成器可以很好地串联这些步骤。每个生成器处理完一部分数据,就传递给下一个生成器,形成一个高效的、内存友好的数据管道。这比中间生成大量临时列表要优雅得多。

如何编写高效且易于维护的生成器函数?

编写生成器函数,除了用好

yield

,还有一些细节我觉得挺重要的:

明确

yield

的职责:你的

yield

语句应该只返回你真正需要的数据。避免在

yield

之前做太多不必要的计算,或者返回一些暂时用不到的数据。让每个

yield

的输出都尽可能精简和直接。

处理异常和资源释放:尽管生成器是惰性的,但它也可能在运行过程中遇到异常。如果你的生成器函数打开了文件句柄、数据库连接等资源,一定要记得用

try...finally

块来确保这些资源在生成器执行完毕(无论是正常结束还是异常退出)后能被正确关闭。

def read_and_process_file(filepath):    f = None # 初始化    try:        f = open(filepath, 'r', encoding='utf-8')        for line in f:            # 假设这里对每一行进行一些复杂处理,可能抛出异常            processed_line = line.strip().upper()            yield processed_line    finally:        if f:            f.close() # 确保文件总是被关闭

链式生成器(Generator Chaining):这是一种非常强大的模式,允许你将多个生成器连接起来,形成一个数据处理流水线。一个生成器的输出可以直接作为另一个生成器的输入。这不仅提高了代码的可读性,也保持了内存效率。

def filter_long_lines(lines, min_len):    for line in lines:        if len(line) >= min_len:            yield linedef add_prefix(lines, prefix):    for line in lines:        yield prefix + line# 使用# raw_lines = read_large_file('data.txt')# filtered_lines = filter_long_lines(raw_lines, 50)# final_output = add_prefix(filtered_lines, "PROCESSED: ")# for item in final_output:#     print(item)

这种方式让每个生成器只负责一个单一的任务,代码模块化程度很高。

yield from

的使用:当你的生成器需要从另一个可迭代对象中

yield

出所有值时,

yield from

语法会比简单的

for item in iterable: yield item

更简洁高效,尤其是在处理嵌套的生成器或者协程时。它能有效地将控制权委托给子生成器。

生成器表达式(Generator Expressions):对于一些简单的、一行就能搞定的生成器需求,生成器表达式是比完整函数定义更轻量级的选择。它们的语法和列表推导式很像,只是用圆括号而不是方括号。

# 对一个大列表进行过滤和转换,不创建中间列表# processed_data = (item.upper() for item in large_list if len(item) > 10)

我觉得这在快速实现一些临时的数据转换时非常方便,代码看起来也更紧凑。

总之,生成器函数不仅仅是内存优化的工具,它还是一种非常Pythonic的编程范式,能让你的代码在处理大数据时更加优雅、高效和健壮。

以上就是Python函数如何用生成器函数处理大数据 Python函数生成器内存优化的应用技巧​的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1367420.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python怎样实现数据标准化?MinMaxScaler
上一篇 2025年12月14日 07:55:01
利用 NLTK RegexpTokenizer 提取所有单词和一个特定短语
下一篇 2025年12月14日 07:55:13

相关推荐

  • Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法

    Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法Chrome浏览器怎么卸载不需要的扩展_Chrome浏览器扩展程序卸载与管理方法

    首先打开Chrome浏览器,通过点击右上角三点图标进入“更多工具-扩展程序”页面,或直接在地址栏输入chrome://extensions快速访问;找到目标扩展后点击“移除”按钮即可卸载;若仅需临时停用,可点击扩展右侧开关将其关闭,灰色状态表示已禁用;对于多个扩展,建议定期进入管理页面批量清理不常用…

    2026年9月24日 • 用户投稿
    000
  • AI工具如何整合Notion/ChatGPT打造智能工作流

    AI工具如何整合Notion/ChatGPT打造智能工作流AI工具如何整合Notion/ChatGPT打造智能工作流AI工具如何整合Notion/ChatGPT打造智能工作流AI工具如何整合Notion/ChatGPT打造智能工作流

    notion与chatgpt结合能解决信息过载、内容创作效率低和重复任务自动化三大核心痛点。1)chatgpt可快速摘要冗长文本,将提炼后的精华导入notion形成结构化知识条目;2)chatgpt生成初稿作为内容起点,提升写作效率,再通过notion组织成流程化内容日历;3)ai动态填充模板,实现…

    2026年9月24日 • 用户投稿
    200
  • 公众号如何进行用户画像分析_公众号用户画像分析的实用技巧

    公众号如何进行用户画像分析_公众号用户画像分析的实用技巧公众号如何进行用户画像分析_公众号用户画像分析的实用技巧公众号如何进行用户画像分析_公众号用户画像分析的实用技巧公众号如何进行用户画像分析_公众号用户画像分析的实用技巧

    通过分析用户属性、互动行为、问卷反馈及第三方工具,可构建动态更新的公众号用户画像。首先利用后台数据掌握性别、年龄、地域等基础特征;再结合文章阅读、点赞、分享行为提炼兴趣标签;随后通过问卷收集职业、需求等主观信息,形成典型用户原型;接着运用RFM模型对用户分层,识别高价值群体;最后每月定期更新画像,确…

    2026年9月24日 • 用户投稿
    200
  • 苹果Mac Studio是创意工作者的最佳选择?

    苹果Mac Studio是创意工作者的最佳选择?苹果Mac Studio是创意工作者的最佳选择?苹果Mac Studio是创意工作者的最佳选择?苹果Mac Studio是创意工作者的最佳选择?

    Mac Studio凭借M1 Max或M1 Ultra芯片的强劲性能、丰富的接口配置、静音设计及苹果生态无缝协作,成为专业创作者高效处理高负载任务的理想选择。 苹果Mac Studio凭借其强大的性能和专业级配置,确实成为许多创意工作者关注的焦点。它是否真的是最佳选择,取决于具体的工作需求和个人预算…

    2026年9月24日 • 用户投稿
    000
  • 拼多多搜索关键词在哪儿看?如何筛选关键词?拼多多关键词挖掘神器!3步筛选高转化词库,流量翻倍!

    拼多多搜索关键词在哪儿看?如何筛选关键词?拼多多关键词挖掘神器!3步筛选高转化词库,流量翻倍!拼多多搜索关键词在哪儿看?如何筛选关键词?拼多多关键词挖掘神器!3步筛选高转化词库,流量翻倍!拼多多搜索关键词在哪儿看?如何筛选关键词?拼多多关键词挖掘神器!3步筛选高转化词库,流量翻倍!拼多多搜索关键词在哪儿看?如何筛选关键词?拼多多关键词挖掘神器!3步筛选高转化词库,流量翻倍!

    想在拼多多快速提升商品曝光?关键词的选择至关重要!本文将手把手教你如何查找拼多多的搜索关键词,并通过科学的筛选方法,精准锁定高转化词库。从商家后台数据看板到竞品标题拆解,再到搜索下拉框深度挖掘,我们将为你揭秘最有效的关键词获取渠道。同时,分享四步筛选技巧,帮你避开低效词,专注高潜力关键词,让店铺流量…

    2026年9月24日 • 用户投稿
    300
  • Linux回收站能恢复已格式化的文件吗

    在 linux 系统中,没有传统意义上的回收站。当你使用 rm 命令删除文件时,文件会直接从文件系统中删除,而不会经过回收站。因此,已格式化的文件在 linux 中是无法通过回收站恢复的。以下是相关信息的介绍: Linux 删除文件的方式 rm 命令:在 Linux 中,rm 命令用于删除文件。使用…

    2026年9月24日
    100
  • AI开发平台有哪些_好用的AI开发平台大全

    AI开发平台有哪些_好用的AI开发平台大全AI开发平台有哪些_好用的AI开发平台大全AI开发平台有哪些_好用的AI开发平台大全AI开发平台有哪些_好用的AI开发平台大全

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Coze:提供大量AI智能体免费使用,已集成DeepSeek满血版 SiliconFlow:专注于生成式AI计算的基础设施平台 码上飞:支持免费生成小程序/APP/网页,通过一句话快速生成应用 …

    2026年9月24日 • 用户投稿
    100
  • win8系统怎么安装xp虚拟机_Win8 XP虚拟机安装方法

    win8系统怎么安装xp虚拟机_Win8 XP虚拟机安装方法win8系统怎么安装xp虚拟机_Win8 XP虚拟机安装方法win8系统怎么安装xp虚拟机_Win8 XP虚拟机安装方法win8系统怎么安装xp虚拟机_Win8 XP虚拟机安装方法

    首先启用CPU虚拟化功能,进入BIOS开启Intel VT-x或AMD-V;然后安装VMware Player或VirtualBox,创建自定义虚拟机并选择Windows XP系统类型,分配1024MB内存和至少20GB硬盘,设置硬盘控制器为IDE;接着加载XP ISO镜像启动安装,按提示分区并完成…

    2026年9月24日 • 用户投稿
    000
  • Java Optional与可空集合排序:深度解析与高效实践

    Java Optional与可空集合排序:深度解析与高效实践Java Optional与可空集合排序:深度解析与高效实践Java Optional与可空集合排序:深度解析与高效实践Java Optional与可空集合排序:深度解析与高效实践

    本文探讨了在Java中处理嵌套可空对象及列表排序的常见问题,特别是Optional的错误用法。强调了通过良好设计避免可空集合的重要性,并提供了在无法修改现有结构时,利用Stream.ofNullable()和Stream.mapMulti()进行安全高效排序的解决方案。旨在提升代码健壮性和可读性。 …

    2026年9月24日 • 用户投稿
    000
  • 抖音店铺层级从低到高怎么设置?抖音怎么创建店铺位置

    抖音电商逐渐崛起,成为众多商家争相入驻的舞台。抖音店铺层级设置作为商家在抖音平台上的重要环节,直接影响着店铺的运营效果和品牌形象。本文将从低到高详细解析抖音店铺层级设置,帮助商家打造优质电商品牌。 一、抖音店铺层级概述 抖音店铺层级分为五个等级,从低到高依次为:新手店铺、成长店铺、成熟店铺、优质店铺…

    2026年9月24日
    1200
  • 京东商家开放平台如何进入?相关术语有哪些?京东商家开放平台入驻指南:流程解析与核心术语解读!

    京东商家开放平台如何进入?相关术语有哪些?京东商家开放平台入驻指南:流程解析与核心术语解读!京东商家开放平台如何进入?相关术语有哪些?京东商家开放平台入驻指南:流程解析与核心术语解读!京东商家开放平台如何进入?相关术语有哪些?京东商家开放平台入驻指南:流程解析与核心术语解读!京东商家开放平台如何进入?相关术语有哪些?京东商家开放平台入驻指南:流程解析与核心术语解读!

    在电商行业蓬勃发展的今天,京东开放平台已成为品牌商家的核心战场。作为拥有4.7亿活跃用户的超级平台,京东不仅提供流量支持,更构建了完整的商家服务体系。本文将深入解析京东商家开放平台入驻流程,并详解pop模式、spu/sku等专业术语,帮助商家快速掌握平台运营规则。 一、京东商家入驻全流程解析 (一)…

    2026年9月24日 • 用户投稿
    200
  • sublime怎么配置LSP(Language Server Protocol)_sublime语言服务器协议配置方法

    sublime怎么配置LSP(Language Server Protocol)_sublime语言服务器协议配置方法sublime怎么配置LSP(Language Server Protocol)_sublime语言服务器协议配置方法sublime怎么配置LSP(Language Server Protocol)_sublime语言服务器协议配置方法sublime怎么配置LSP(Language Server Protocol)_sublime语言服务器协议配置方法

    首先安装LSP插件,再配置语言服务器;以Python为例,通过pip安装pylsp并在LSP设置中添加客户端配置,保存后打开.py文件即可启用服务。 在 Sublime Text 中配置 LSP(Language Server Protocol)可以大幅提升代码补全、跳转定义、悬停提示等开发体验。下…

    2026年9月24日 • 用户投稿
    000
  • 谷歌 Pixel 11 或搭载联发科 M90 基带,带来通信提升

    谷歌 Pixel 11 或搭载联发科 M90 基带,带来通信提升谷歌 Pixel 11 或搭载联发科 M90 基带,带来通信提升谷歌 Pixel 11 或搭载联发科 M90 基带,带来通信提升谷歌 Pixel 11 或搭载联发科 M90 基带,带来通信提升

    今年 8 月,谷歌正式推出了 Pixel 10 系列手机,其核心配置了 Tensor G5 处理器。 在该系列发布前,曾有消息称 Pixel 10 的原型机测试过联发科基带。不过最终量产机型仍采用了三星的 Exynos 5400 调制解调器,因此通信性能未实现显著提升。但根据最新消息,谷歌并未终止与…

    2026年9月24日 • 用户投稿
    000
  • windows怎么安装visual c++运行库_visual c++运行库安装教程

    windows怎么安装visual c++运行库_visual c++运行库安装教程windows怎么安装visual c++运行库_visual c++运行库安装教程windows怎么安装visual c++运行库_visual c++运行库安装教程windows怎么安装visual c++运行库_visual c++运行库安装教程

    首先安装Visual C++运行库可解决“找不到vcruntime140.dll”问题,具体步骤包括:一、从微软官网下载对应系统版本的Visual C++ Redistributable安装包,推荐安装2015-2022版;二、可选使用可信的第三方VC++合集工具快速部署多版本运行库;三、通过Win…

    2026年9月24日 • 用户投稿
    000
  • 哪个淘宝比价软件更靠谱?价格低就有优势吗?价格低真的能捡漏吗?

    哪个淘宝比价软件更靠谱?价格低就有优势吗?价格低真的能捡漏吗?哪个淘宝比价软件更靠谱?价格低就有优势吗?价格低真的能捡漏吗?哪个淘宝比价软件更靠谱?价格低就有优势吗?价格低真的能捡漏吗?哪个淘宝比价软件更靠谱?价格低就有优势吗?价格低真的能捡漏吗?

    在淘宝购物时,比价工具已成为理性消费者的得力助手。然而面对琳琅满目的比价应用,哪一款真正值得信赖?当商品价格不断下调,究竟是实打实的优惠,还是精心设计的营销陷阱?本文将从专业视角深入剖析主流比价软件的选择技巧,并揭示低价背后的四大套路。 一、四款热门淘宝比价工具全面测评 1. 历史价格追踪:识破“先…

    2026年9月24日 • 用户投稿
    300
  • Perplexity AI能否保存搜索模板 Perplexity AI常用搜索预设

    Perplexity AI能否保存搜索模板 Perplexity AI常用搜索预设Perplexity AI能否保存搜索模板 Perplexity AI常用搜索预设Perplexity AI能否保存搜索模板 Perplexity AI常用搜索预设Perplexity AI能否保存搜索模板 Perplexity AI常用搜索预设

    perplexity ai目前不支持直接保存搜索模板,但可通过以下方法模拟实现:1. 复制粘贴常用查询结构,将基础模板保存在本地文本编辑器中,替换变量后使用;2. 浏览器书签+关键词占位法,通过书签标题和内容快速调用模板;3. 使用浏览器扩展如textexpander自动展开高频模板。常见预设场景包…

    2026年9月24日 • 用户投稿
    100
  • Java中自定义日志器的简化与自动化:避免重复声明

    Java中自定义日志器的简化与自动化:避免重复声明Java中自定义日志器的简化与自动化:避免重复声明Java中自定义日志器的简化与自动化:避免重复声明Java中自定义日志器的简化与自动化:避免重复声明

    本文探讨了在Java应用中,尤其是在不能使用Lombok或Spring等流行框架时,如何简化自定义日志器(如MXLogger)的声明和初始化。我们将介绍通过自定义工厂、基类继承和静态工具方法来减少重复代码,并深入分析在“简单Java”环境下实现纯注解驱动自动注入的复杂性,提供实用的解决方案。 挑战:…

    2026年9月24日 • 用户投稿
    000
  • CAS单点登录证书生成

    CAS单点登录证书生成CAS单点登录证书生成CAS单点登录证书生成CAS单点登录证书生成

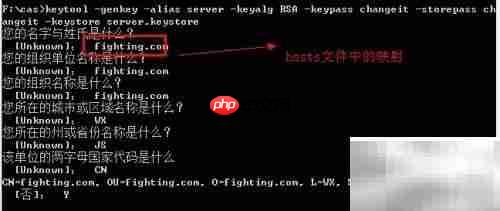
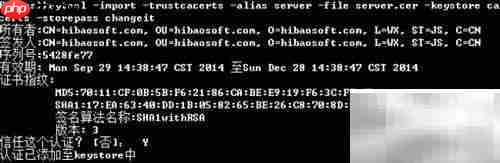
    在完成前期准备工作后,接下来将深入讲解证书的具体生成步骤。 1、 在F盘新建一个名为cas的目录,用于存储所有相关证书文件。随后打开命令行工具,并进入该目录,操作界面如下图所示。 2、 开始创建服务器端证书 3、 执行该命令可在当前路径下生成一个别称为 server 的密钥库,完成后会在cas文件夹…

    2026年9月24日 • 用户投稿
    000
  • 如何在Debian上配置MongoDB审计日志

    在debian上配置mongodb审计日志可以帮助你监控和记录数据库的活动,从而提高安全性。以下是详细的步骤来配置mongodb审计日志: 1. 安装MongoDB 首先,确保你已经在Debian上安装了MongoDB。如果没有安装,可以使用以下命令进行安装: sudo apt updatesudo…

    2026年9月24日
    100
  • 传苹果人工智能模型高管将跳槽至Meta

    传苹果人工智能模型高管将跳槽至Meta传苹果人工智能模型高管将跳槽至Meta传苹果人工智能模型高管将跳槽至Meta传苹果人工智能模型高管将跳槽至Meta

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 据最新消息,苹果公司主管人工智能模型的高层管理人员即将转投Meta,这为苹果在人工智能领域本就艰难的发展之路再添一道阴影。 有内部人士透露,苹果杰出工程师、基础模型团队负责人Ruoming Pa…

    2026年9月24日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信