Pandas DataFrame高级分组聚合:条件计算与结果映射

Pandas DataFrame高级分组聚合:条件计算与结果映射

本教程将详细介绍如何在Pandas DataFrame中执行高级分组聚合操作。我们将学习如何根据ID和年份对数据进行分组,并仅对满足特定条件(例如,组内数据点数量不小于2)的组计算指定统计量(如均值和中位数),然后将这些结果高效地广播回原始DataFrame的相应行中,确保数据处理的准确性和效率。

在数据分析实践中,我们经常需要对dataframe进行分组操作,并对每个组内的特定列计算聚合统计量。然而,有时这些统计量的计算需要满足额外的条件,例如,只有当组内记录数达到一定阈值时才进行计算,并将计算结果映射回原始dataframe的每一行。本教程将以一个具体的场景为例,演示如何使用pandas的groupby()、transform()、nunique()和where()等功能组合,优雅地解决这类问题。

场景描述

假设我们有一个包含交易日期(CALDT)、实体ID(ID)和收益(Return)的DataFrame。我们的目标是:

根据ID和CALDT的年份对数据进行分组。对于每个分组,如果该组的唯一CALDT月份数量大于或等于2(即该ID在当年至少“存活”了2个月),则计算该组内Return列的年化均值和年化中位数(即均值/中位数乘以12)。将计算出的年化均值和年化中位数作为新列添加回原始DataFrame,对于不满足条件的组,对应行的这些新列值应为NaN。

准备数据

首先,我们创建示例DataFrame并进行初步的数据类型转换和年份提取:

import pandas as pdimport numpy as np# 创建示例DataFramedf = pd.DataFrame(         {"CALDT": ["1980-01-31", "1980-02-28", "1980-03-31",                    "1980-01-31", "1980-02-28", "1980-03-31",                    "1980-01-31"],          "ID": [1, 1, 1,                 2, 2, 2,                 3],          "Return": [0.02, 0.05, 0.10,                     0.05, -0.02, 0.03,                     -0.03]          })# 将CALDT列转换为日期时间类型,并提取年份df['CALDT'] = pd.to_datetime(df['CALDT'])df['Year'] = df['CALDT'].dt.yearprint("原始DataFrame:")print(df)

输出:

原始DataFrame:       CALDT  ID  Return  Year0 1980-01-31   1    0.02  19801 1980-02-28   1    0.05  19802 1980-03-31   1    0.10  19803 1980-01-31   2    0.05  19804 1980-02-28   2   -0.02  19805 1980-03-31   2    0.03  19806 1980-01-31   3   -0.03  1980

解决方案

解决此问题的关键在于正确使用groupby()结合transform(),并利用where()进行条件筛选。

1. 分组与transform的应用

首先,我们根据ID和CALDT的年份进行分组。这里,我们不需要显式创建Year列来分组,可以直接在groupby中使用df.CALDT.dt.year。

接着,我们使用transform()方法计算每个组的Return均值和中位数,并将其乘以12进行年化。transform()的优点在于它会返回一个与原始DataFrame(或分组前的Series)长度相同的Series,将聚合结果“广播”回原始行,而不是像agg()那样返回一个聚合后的较小DataFrame。

# 根据ID和CALDT的年份进行分组g = df.groupby(["ID", df.CALDT.dt.year])# 使用transform计算年化均值和中位数# transform会确保计算结果的索引与原始DataFrame对齐mean_return_transformed = g["Return"].transform("mean").mul(12)median_return_transformed = g["Return"].transform("median").mul(12)# 将计算结果组合成一个新的DataFramereturn_stats = pd.DataFrame({    "Mean_Return": mean_return_transformed,    "Median_Return": median_return_transformed})print("初步计算的统计量(未应用条件):")print(return_stats)

输出:

初步计算的统计量(未应用条件):   Mean_Return  Median_Return0         0.68           0.601         0.68           0.602         0.68           0.603         0.24           0.364         0.24           0.365         0.24           0.366        -0.36          -0.36

可以看到,ID=3的行也计算出了统计量,但根据需求,它应该被排除。

2. 应用条件筛选

现在我们需要应用条件:只有当每个分组的唯一CALDT数量大于或等于2时,才保留计算出的统计量。Pandas的where()方法非常适合这种场景。where(condition, other=NaN)会根据condition布尔Series来选择值:如果条件为True,则保留原值;如果条件为False,则替换为other(默认为NaN)。

我们可以再次利用groupby()和transform()来获取每个组的唯一CALDT数量,并将其与2进行比较。

# 计算每个组的唯一CALDT数量,并判断是否大于等于2# transform("nunique") 会将每个组的唯一值数量广播回原始DataFrame的形状condition = g["CALDT"].transform("nunique").ge(2) # .ge(2) 等同于 >= 2# 使用where方法应用条件return_stats_conditional = return_stats.where(condition)print("n应用条件后的统计量:")print(return_stats_conditional)

输出:

应用条件后的统计量:   Mean_Return  Median_Return0         0.68           0.601         0.68           0.602         0.68           0.603         0.24           0.364         0.24           0.365         0.24           0.366          NaN            NaN

现在,ID=3对应的统计量已经正确地变成了NaN。

3. 合并结果

最后一步是将计算出的条件性统计量合并回原始DataFrame。由于return_stats_conditional的索引与原始df的索引是匹配的,我们可以直接使用join()方法。

# 将条件性统计量合并回原始DataFramedf_final = df.join(return_stats_conditional)print("n最终结果DataFrame:")print(df_final)

输出:

最终结果DataFrame:       CALDT  ID  Return  Year  Mean_Return  Median_Return0 1980-01-31   1    0.02  1980         0.68           0.601 1980-02-28   1    0.05  1980         0.68           0.602 1980-03-31   1    0.10  1980         0.68           0.603 1980-01-31   2    0.05  1980         0.24           0.364 1980-02-28   2   -0.02  1980         0.24           0.365 1980-03-31   2    0.03  1980         0.24           0.366 1980-01-31   3   -0.03  1980          NaN            NaN

这与预期的输出完全一致。

完整代码

为了清晰起见,我们将上述步骤整合到一起:

import pandas as pdimport numpy as np# 1. 准备数据df = pd.DataFrame(         {"CALDT": ["1980-01-31", "1980-02-28", "1980-03-31",                    "1980-01-31", "1980-02-28", "1980-03-31",                    "1980-01-31"],          "ID": [1, 1, 1,                 2, 2, 2,                 3],          "Return": [0.02, 0.05, 0.10,                     0.05, -0.02, 0.03,                     -0.03]          })df['CALDT'] = pd.to_datetime(df['CALDT'])df['Year'] = df['CALDT'].dt.year # 实际上这一步不是必须的,因为可以在groupby中直接使用dt.year# 2. 分组并计算条件统计量# 创建分组对象g = df.groupby(["ID", df.CALDT.dt.year])# 使用transform计算年化均值和中位数# transform会自动将聚合结果广播到原始DataFrame的行数return_stats = pd.DataFrame({                     "Mean_Return": g["Return"].transform("mean").mul(12),                     "Median_Return": g["Return"].transform("median").mul(12)                  })# 创建条件:判断每个组的唯一CALDT数量是否大于等于2# g["CALDT"].transform("nunique") 同样将每个组的唯一值数量广播condition_met = g["CALDT"].transform("nunique").ge(2)# 应用条件:不满足条件的行将统计量设为NaNreturn_stats_conditional = return_stats.where(condition_met)# 3. 合并结果到原始DataFramedf_final = df.join(return_stats_conditional)print(df_final)

注意事项与最佳实践

transform() vs. agg():

transform():当您需要将组级别的聚合结果“广播”回原始DataFrame的每一行,使其保持原始形状时,transform()是理想选择。它返回一个与原始Series或DataFrame具有相同索引和长度的Series/DataFrame。agg()(或apply()):当您需要一个聚合后的、行数减少的DataFrame(例如,每个组只有一行结果)时,使用agg()。在本场景中,由于我们需要将结果添加到原始DataFrame的每一行,transform()是正确的选择。

链式操作与可读性:虽然可以将所有操作链式写在一起,但为了提高代码的可读性和调试便利性,将其分解为几个逻辑步骤(如本教程所示)通常是更好的实践。

性能:Pandas的groupby().transform()操作通常是高度优化的,尤其对于内置的聚合函数(如mean, median, nunique)。它比使用循环或apply自定义函数通常更高效。

条件复杂性:如果条件逻辑变得非常复杂,无法直接通过transform()和内置函数实现,您可以考虑使用apply()配合自定义函数。但在这种情况下,需要手动确保返回的Series长度与组内元素数量匹配,以便正确地广播回原始DataFrame。

总结

本教程展示了如何利用Pandas强大的groupby()结合transform()和where()方法,在DataFrame中实现复杂的条件性分组聚合,并将结果高效地映射回原始数据。这种模式在处理需要基于组内特征进行条件判断的统计分析任务时非常有用,能够帮助我们编写出既高效又简洁的数据处理代码。理解transform()的工作原理及其与agg()的区别,是掌握Pandas高级数据操作的关键。

以上就是Pandas DataFrame高级分组聚合:条件计算与结果映射的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1368700.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Pandas DataFrame高级数据重塑:实现多层列标题与数据对齐
上一篇 2025年12月14日 09:00:50
Pandas数据分组条件计算与结果回填教程
下一篇 2025年12月14日 09:01:08

相关推荐

  • 抖音小号开直播有收益吗?抖音直接开直播能赚钱吗

    抖音小号开直播有收益吗?抖音直接开直播能赚钱吗抖音小号开直播有收益吗?抖音直接开直播能赚钱吗抖音小号开直播有收益吗?抖音直接开直播能赚钱吗抖音小号开直播有收益吗?抖音直接开直播能赚钱吗

    在这个短视频风起云涌的时代,抖音已经成为了许多人生活中不可或缺的一部分。随着抖音平台的不断优化和功能的增加,越来越多的人开始尝试在抖音上开直播。抖音小号开直播有收益吗?今天,我们就来聊聊这个话题。 一、抖音小号开直播的收益来源 1. 直播打赏:这是抖音小号直播最直接的收益来源。观众可以通过赠送虚拟礼…

    2026年9月28日 • 用户投稿
    100
  • PHP中静态数组的优势与应用详解

    静态数组是PHP中一个重要的概念,理解其特性有助于编写更高效、更易于维护的代码。本文将详细介绍静态数组与普通数组的区别,以及静态数组在实际开发中的应用场景。 静态变量的作用域与生命周期 在PHP中,使用static关键字声明的变量具有特殊的性质。与普通变量不同,静态变量在函数或方法调用结束后不会被销…

    2026年9月28日
    200
  • Lucene教程:如何构建不匹配任何文档的空查询

    Lucene教程:如何构建不匹配任何文档的空查询Lucene教程:如何构建不匹配任何文档的空查询Lucene教程:如何构建不匹配任何文档的空查询Lucene教程:如何构建不匹配任何文档的空查询

    在Lucene开发中,当需要一个不匹配任何文档的“空”查询时,直接返回null可能导致问题。本文将介绍如何利用MatchNoDocsQuery来构建一个功能上等同于“空”的查询,确保在特定业务逻辑下(如安全校验失败时)查询行为的规范性和稳定性,避免潜在的空指针异常或不确定行为。 引言:为何需要“空”…

    2026年9月28日 • 用户投稿
    100
  • 如何在Java中理解构造方法与析构方法

    构造方法用于对象初始化,Java无真正析构方法。构造方法与类同名,自动调用以初始化成员变量;而析构功能由垃圾回收器管理,finalize()已过时,推荐通过实现AutoCloseable接口并结合try-with-resources语句确保资源及时释放,提升代码安全性与效率。 在Java中,构造方法…

    2026年9月28日
    100
  • MySQL怎样使用索引合并优化 复合索引与索引合并策略

    MySQL怎样使用索引合并优化 复合索引与索引合并策略MySQL怎样使用索引合并优化 复合索引与索引合并策略MySQL怎样使用索引合并优化 复合索引与索引合并策略MySQL怎样使用索引合并优化 复合索引与索引合并策略

    索引合并是mysql中一种优化策略,允许在单个查询中使用多个索引来定位数据。其主要类型包括:1. union合并,用于or连接的条件;2. intersection合并,用于and连接的条件;3. sort-union合并,用于需排序后再合并的情况。复合索引与索引合并不同,前者是多列组合索引,后者则…

    2026年9月28日 • 用户投稿
    100
  • 深入理解Java泛型:类型参数与方法重载的实践指南

    深入理解Java泛型:类型参数与方法重载的实践指南深入理解Java泛型:类型参数与方法重载的实践指南深入理解Java泛型:类型参数与方法重载的实践指南深入理解Java泛型:类型参数与方法重载的实践指南

    本文深入探讨了Java泛型中关于类型参数与泛型类实例在方法签名中的区别,以及由此引发的类型不匹配问题。通过一个具体的代码示例,详细解析了为何在泛型方法中,直接传入泛型类实例或其内部类型参数会引发编译错误,并提供了利用方法重载这一核心机制来优雅地解决此类问题的专业指导和示例代码,帮助开发者清晰理解“h…

    2026年9月28日 • 用户投稿
    200
  • 视频号私信如何改成个人私信?视频号怎么私信给作者

    视频号私信如何改成个人私信?视频号怎么私信给作者视频号私信如何改成个人私信?视频号怎么私信给作者视频号私信如何改成个人私信?视频号怎么私信给作者视频号私信如何改成个人私信?视频号怎么私信给作者

    在这个信息爆炸的时代,我们每个人都希望能拥有一个属于自己的小天地,与他人分享喜怒哀乐,同时保护自己的隐私。而微信视频号私信功能的出现,无疑为我们提供了一个绝佳的沟通平台。但是,有些朋友可能发现,自己无法将视频号私信改成个人私信。别担心,今天就来教大家如何轻松切换隐私模式,让你的沟通更加私密和安全。 …

    2026年9月28日 • 用户投稿
    100
  • 系统还原点与完整的系统镜像备份在功能和恢复范围上有何本质区别?

    系统还原点仅恢复系统文件与设置,不影响个人数据,适用于解决软件或配置问题;而系统镜像备份完整复制整个系统,包括操作系统、程序、文件和引导区,可用于硬件故障后全盘恢复。两者用途不同,层级不同,不可替代。 系统还原点和系统镜像备份虽然都能用于恢复计算机状态,但它们在功能机制和恢复范围上有根本性差异。 系…

    2026年9月28日
    400
  • 华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」

    华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」

    大家好,又见面了,我是你们的朋友全栈君。 内存是非常重要的系统资源,是硬盘和CPU的中间仓库及桥梁,承载着os和应用程序的实时运行。 JVM内存布局规定了Java在运行过程中内存申请、分配、管理的策略,保证了JVM高效稳定运行。不同JVM对于内存的划分方式和管理机制存在差异。结合JVM虚拟机规范,来…

    2026年9月28日 • 用户投稿
    200
  • 苹果16pro和max区别

    苹果16pro和max区别苹果16pro和max区别苹果16pro和max区别苹果16pro和max区别

    主要区别在于:尺寸和显示屏:16 Pro 为 6.1 英寸,而 16 Pro Max 为 6.7 英寸,均采用 ProMotion 显示屏。电池续航:16 Pro 可播放 23 小时视频,而 16 Pro Max 可播放 29 小时。摄像头:均拥有 48MP 主摄像头,但 16 Pro Max 具有…

    2026年9月27日 • 用户投稿
    200
  • DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议

    DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议

    deepseek和chatgpt的主要区别在于训练数据、模型架构、擅长领域及应用场景。1. deepseek侧重代码生成与数学推理,适合编程及逻辑任务;2. chatgpt擅长自然语言处理与文本生成,适用于对话、写作等场景;3. 选型应根据项目核心需求决定,若重代码理解选deepseek,若重语言表…

    2026年9月27日 • 用户投稿
    100
  • 【Linux/C++】Linux下C++命令行编译示例

    本文是关于c++++编程语言基础和linux系统操作基础的系列文章的第二部分。我们将详细介绍在linux环境下如何编译c++代码,并展示相关的编译示例和技巧。 文章目录 准备源代码编译实战引入目录进行编译使用-Wall、-std 参数进行编译生成库文件链接静态库生成可执行文件链接动态库生成可执行文件…

    2026年9月27日
    200
  • Java语法基础中++i和i++的区别

    答案:++i是先加后用,i++是先用后加。前者先将i加1再参与运算,后者先使用原值再加1,两者在赋值和表达式中结果不同。 在Java语法中,++i 和 i++ 都是自增操作符,作用是将变量 i 的值加1,但它们在使用时的执行时机和返回值有重要区别。 1. ++i(前置自增) 前置自增表示先将变量 i…

    2026年9月27日
    100
  • 《新VR战士》确定不采用客串角色 将强化剧情叙事

    《新VR战士》确定不采用客串角色 将强化剧情叙事《新VR战士》确定不采用客串角色 将强化剧情叙事《新VR战士》确定不采用客串角色 将强化剧情叙事《新VR战士》确定不采用客串角色 将强化剧情叙事

    近日,世嘉公开了《VR战士》系列新作的最新动态,明确表示这款正在开发中的格斗游戏将不会加入来自其他IP的跨界角色。在与Giant Bomb的访谈中,制作人山田精一强调,团队的核心目标是打造一个独立且完整的《VR战士》世界观,同时融入新颖设计以吸引新玩家并回馈长期支持的老粉丝。 谈及为何在系列沉寂多年…

    2026年9月27日 • 用户投稿
    100
  • CPU硅脂与钎焊散热工艺的性能差距有多大?

    钎焊导热远优于硅脂,因金属键合大幅降低界面热阻,使CPU温度更低、性能释放更强、超频潜力更大,尤其在高负载下优势明显。 CPU硅脂与钎焊散热工艺之间的性能差距,在我看来,通常能达到数度到十余度甚至更高的温差,这在高性能计算场景下,足以显著影响CPU的性能释放和稳定性。简单来说,钎焊在导热效率上有着硅…

    2026年9月27日
    100
  • JScrollPane滚动条自动更新行为的控制策略与实践

    JScrollPane滚动条自动更新行为的控制策略与实践JScrollPane滚动条自动更新行为的控制策略与实践JScrollPane滚动条自动更新行为的控制策略与实践JScrollPane滚动条自动更新行为的控制策略与实践

    本教程详细探讨如何有效控制JScrollPane的滚动条自动更新行为,特别是在内容重绘后避免意外滚动。文章重点介绍通过设置滚动条策略(如ScrollPaneConstants.HORIZONTAL_SCROLLBAR_NEVER)来禁用滚动条或其自动更新,并简要提及Viewport尺寸调整的替代方法…

    2026年9月27日 • 用户投稿
    100
  • 算法科普——运动学LMPC和动力学LMPC之间的区别与联系

    算法科普——运动学LMPC和动力学LMPC之间的区别与联系算法科普——运动学LMPC和动力学LMPC之间的区别与联系算法科普——运动学LMPC和动力学LMPC之间的区别与联系算法科普——运动学LMPC和动力学LMPC之间的区别与联系

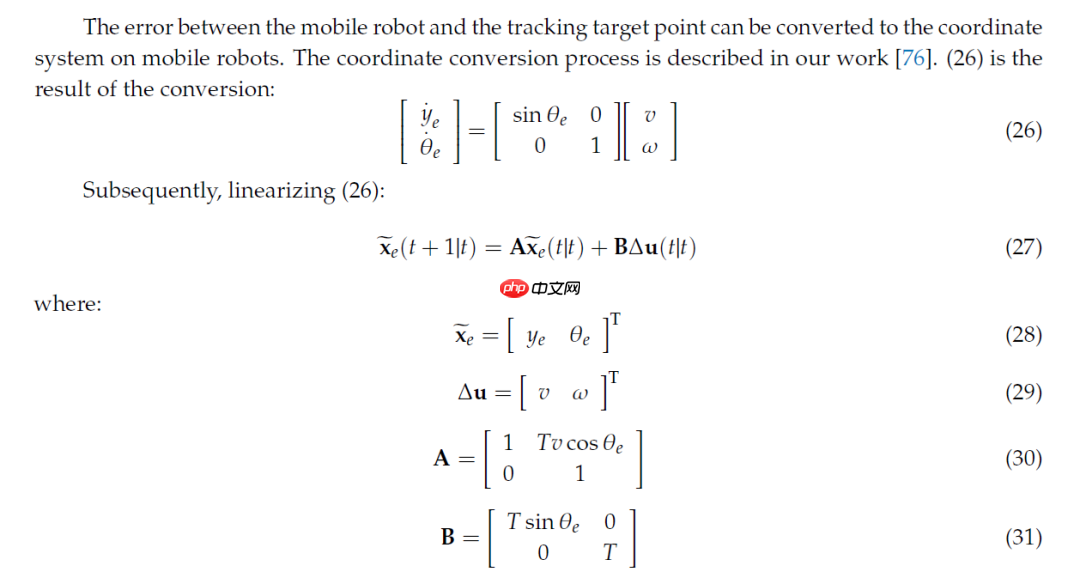
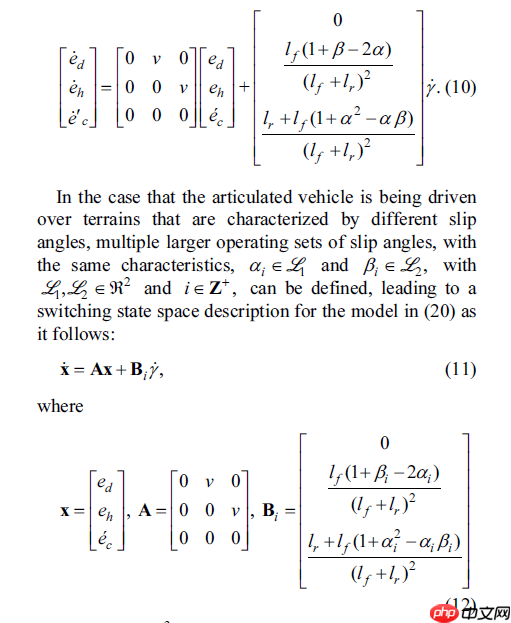
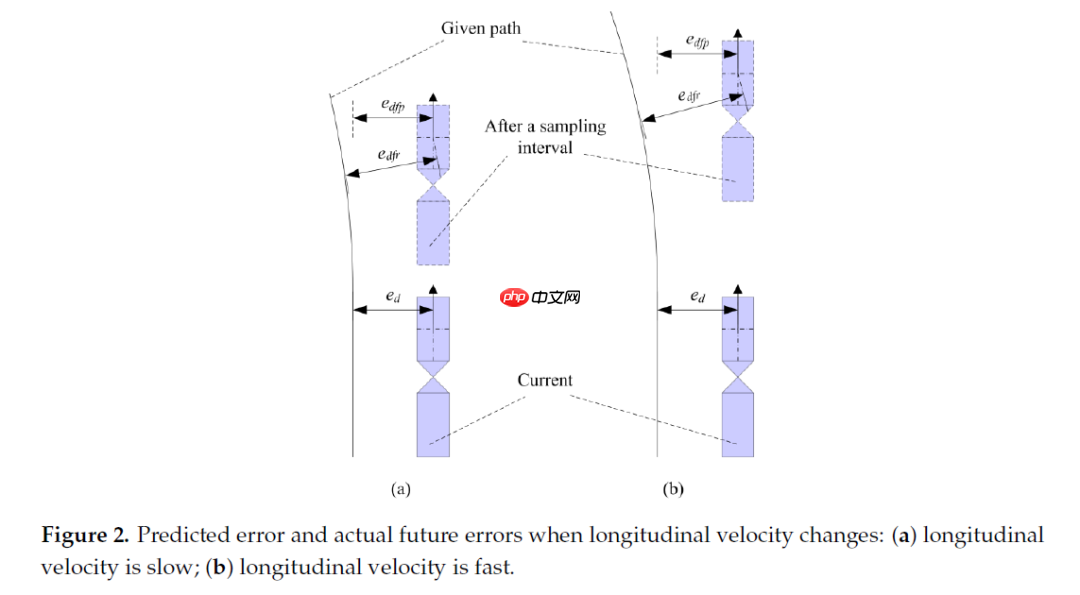
    在上一期的算法科普中,我已经探讨了lmpc的发展历程。然而,上一期并未深入探讨lmpc的各种分支,因此本期将重点介绍两种运动学层面的lmpc控制器和一种动力学层面的lmpc控制器。 一种常见的运动学层面的LMPC控制器的预测模型是直接对运动学模型进行雅克比线性化处理,如[1]中所述: 另一种运动学层…

    2026年9月27日 • 用户投稿
    100
  • 告别繁琐构造函数:使用建造者模式优化Java对象创建

    告别繁琐构造函数:使用建造者模式优化Java对象创建告别繁琐构造函数:使用建造者模式优化Java对象创建告别繁琐构造函数:使用建造者模式优化Java对象创建告别繁琐构造函数:使用建造者模式优化Java对象创建

    本文针对Java中处理多个可选参数时,传统构造函数组合繁琐的问题,详细介绍了建造者模式(Builder Pattern)。该模式通过分阶段构建对象,避免了大量参数构造函数和重复组合,提升了代码的可读性和可维护性。文章将通过代码示例深入解析建造者模式的实现原理与优势,并提供实际应用指导。 传统构造函数…

    2026年9月27日 • 用户投稿
    200
  • Android非Activity类中Toast消息的正确管理与调用

    Android非Activity类中Toast消息的正确管理与调用Android非Activity类中Toast消息的正确管理与调用Android非Activity类中Toast消息的正确管理与调用Android非Activity类中Toast消息的正确管理与调用

    本文旨在解决在Android非Activity类中调用Toast消息时遇到的类型不匹配问题。通过详细阐述Toast.makeText()方法对Context参数的要求,并提供将Activity的Context正确传递给静态工具方法的解决方案,实现Toast消息的集中管理和复用,从而提升代码的健壮性和…

    2026年9月27日 • 用户投稿
    300
  • 文本动画的类选择器应用与优化

    文本动画的类选择器应用与优化文本动画的类选择器应用与优化文本动画的类选择器应用与优化文本动画的类选择器应用与优化

    本文详细介绍了如何将基于ID的文本动画转换为基于类的实现,以支持在多个HTML元素上复用同一动画效果。通过JavaScript动态生成带有自定义CSS变量的标签,并结合CSS @keyframes动画,实现了可灵活应用于页面中任意指定元素的波浪式文本动画,并提供了两种优化方案。 1. 问题背景与目标…

    2026年9月27日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信