Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python如何遍历字典_Python字典遍历的常用方法汇总_创想鸟

Python如何遍历字典_Python字典遍历的常用方法汇总

遍历字典的核心是通过keys()、values()和items()方法分别访问键、值或键值对。直接for循环默认遍历键,等价于使用keys();若需访问值,应使用values();而同时获取键和值时,items()结合元组解包是最常用且高效的方式。选择哪种方式取决于具体需求:仅处理键时用keys(),仅处理值时用values(),需键值对时用items(),其在可读性和性能上更优。遍历时修改字典会引发RuntimeError,安全做法是遍历副本或分离决策与执行。对于嵌套字典,可通过递归实现深度遍历;条件筛选则推荐使用字典推导式,简洁高效。
python如何遍历字典_python字典遍历的常用方法汇总

Python遍历字典,核心就是围绕它的键(key)、值(value)或者键值对(key-value pair)进行操作。最常用的方法通常是利用字典自带的

keys()

、

values()

和

items()

这三个视图对象,它们能让我们高效且清晰地访问字典的各个组成部分。当然,直接在字典对象上进行迭代,默认情况下也是遍历它的键。

解决方案

在Python中,遍历字典有几种非常直接且常用的方式,理解它们的区别和适用场景,能帮助我们写出更清晰、更高效的代码。

1. 遍历字典的键(Keys)这是最基本、也是当你直接对字典对象进行

for

循环时默认的行为。如果你只需要访问字典的键,这是最简洁的方式。

my_dict = {'name': 'Alice', 'age': 30, 'city': 'New York'}print("遍历键(默认行为):")for key in my_dict:    print(key)print("n遍历键(使用.keys()):")for key in my_dict.keys():    print(key)

这两种方式在效果上是等价的,

my_dict.keys()

返回一个字典键的视图对象,它提供了字典键的动态视图。

2. 遍历字典的值(Values)如果你只关心字典中存储的数据,而不需要知道它们对应的键,那么

values()

方法是你的首选。

my_dict = {'name': 'Alice', 'age': 30, 'city': 'New York'}print("遍历值:")for value in my_dict.values():    print(value)
my_dict.values()

返回一个字典值的视图对象。

立即学习“Python免费学习笔记(深入)”;

3. 遍历字典的键值对(Items)这是最常用、也最强大的遍历方式,因为它允许你同时访问键和对应的值。Python的元组解包(tuple unpacking)特性让这种方式异常优雅。

my_dict = {'name': 'Alice', 'age': 30, 'city': 'New York'}print("遍历键值对:")for key, value in my_dict.items():    print(f"{key}: {value}")
my_dict.items()

返回一个字典键值对的视图对象,每个元素都是一个

(key, value)

元组。

何时选择

keys()

、

values()

还是

items()

?性能与可读性的考量

选择哪种遍历方式,往往取决于你具体的需求。这不仅仅是语法上的偏好,更关乎代码的可读性和潜在的性能考量。

从我个人的经验来看,

items()

方法是日常开发中最常用的。因为它一次性提供了键和值,省去了通过键再去查找值的步骤,这在逻辑上更直接,代码也更清晰。如果你需要同时处理键和值,比如打印一个格式化的报告,或者根据键值对进行某种转换,

for key, value in my_dict.items():

几乎是标准答案。它避免了在循环内部使用

my_dict[key]

进行二次查找,虽然对于小字典来说性能差异微乎其微,但在处理大规模数据时,这种直接访问的效率优势就会显现出来。

keys()

方法,无论是显式调用

my_dict.keys()

还是隐式地直接

for key in my_dict:

,主要用于你只需要对字典的键进行操作的场景。比如,你想检查某个键是否存在,或者收集所有键到一个列表中。它的优势在于简洁,如果你不需要值,就没有必要把值也取出来。

而

values()

方法则是在你只关心字典中存储的数据本身,而键对你来说是次要信息时派上用场。例如,你可能想计算所有数值型值的总和,或者将所有值进行某种聚合操作。

关于性能,现代Python解释器对这些操作都进行了高度优化。通常,如果你需要键和值,

items()

会是最高效的。如果你只需要键或值,那么对应的

keys()

或

values()

方法也是高效的。过分纠结于它们之间的微小性能差异,通常是不必要的,除非你是在处理亿级数据且性能瓶颈确实出现在这里。更多时候,选择最能表达你意图、最易于阅读的方式才是王道。

遍历字典时修改字典会怎样?Python的应对策略

这是一个非常常见的陷阱,尤其是在初学者阶段。当你在遍历一个字典的同时尝试修改它(比如添加、删除或改变键的值),Python通常会抛出一个

RuntimeError: dictionary changed size during iteration

。这并不是Python的“脾气不好”,而是为了防止迭代过程中出现不确定性和难以追踪的bug。想象一下,如果你在一个正在被迭代的集合中增删元素,迭代器就可能“迷失”方向,导致跳过元素或访问到不应访问的内存。

比如,尝试这样做:

my_dict = {'a': 1, 'b': 2, 'c': 3}# 这会报错# for key in my_dict:#     if key == 'b':#         del my_dict[key]#     else:#         my_dict[key] = my_dict[key] * 2

要安全地在遍历过程中“修改”字典,你需要采取一些策略:

1. 遍历字典的副本最简单直接的方法是遍历字典的键或项的副本。这样,你修改的是原始字典,但迭代器看到的仍然是修改前的状态。

my_dict = {'a': 1, 'b': 2, 'c': 3, 'd': 4}print(f"原始字典: {my_dict}")# 遍历键的副本进行删除keys_to_delete = [key for key in my_dict if key == 'b' or key == 'd']for key in keys_to_delete:    del my_dict[key]print(f"删除键后的字典: {my_dict}") # {'a': 1, 'c': 3}# 遍历项的副本进行修改my_dict_copy = list(my_dict.items()) # 也可以用 my_dict.copy()for key, value in my_dict_copy:    my_dict[key] = value * 2print(f"修改值后的字典: {my_dict}") # {'a': 2, 'c': 6}

注意,

my_dict.copy()

会创建一个浅拷贝,对于键值都是不可变类型的情况,这通常足够了。如果值是可变对象(如列表或另一个字典),修改这些可变对象会影响原始字典。

2. 构建一个待处理的列表/字典如果你需要根据遍历结果来决定添加或删除哪些项,更好的方式是先收集这些操作,然后在遍历结束后一次性执行。

original_dict = {'apple': 1, 'banana': 2, 'cherry': 3}items_to_add = {}keys_to_remove = []for key, value in original_dict.items():    if value % 2 == 0: # 如果值是偶数,就删除这个键        keys_to_remove.append(key)    else: # 否则,添加一个新的键值对        items_to_add[key + '_new'] = value * 10# 执行删除操作for key in keys_to_remove:    del original_dict[key]# 执行添加操作original_dict.update(items_to_add)print(f"最终字典: {original_dict}") # {'apple': 1, 'apple_new': 10, 'cherry': 3, 'cherry_new': 30}

这种方法将“决策”与“执行”分离,逻辑更清晰,也避免了运行时错误。

深度遍历与特定条件筛选:更复杂的字典迭代场景

字典的遍历不仅仅是简单的循环,在实际项目中,我们经常会遇到更复杂的场景,比如处理嵌套字典、或者根据特定条件筛选数据。

1. 深度遍历嵌套字典当字典的值本身又是字典时,我们就需要进行深度遍历。这通常会用到递归或者栈(stack)来实现。

nested_dict = {    'level1_key1': 'value1',    'level1_key2': {        'level2_key1': 'value2',        'level2_key2': {            'level3_key1': 'value3',            'level3_key2': 'value4'        }    },    'level1_key3': 'value5'}def deep_traverse_dict(d):    for key, value in d.items():        print(f"Key: {key}, Value: {value}")        if isinstance(value, dict):            deep_traverse_dict(value)print("深度遍历嵌套字典:")deep_traverse_dict(nested_dict)

这个递归函数会一层层地深入字典结构,直到所有非字典值都被访问到。对于非常深的嵌套,递归可能会遇到栈溢出,这时可以考虑使用基于栈的迭代方式。

2. 特定条件筛选与字典推导式我们经常需要根据某些条件来筛选字典中的键值对,或者基于现有字典生成一个新的字典。字典推导式(Dictionary Comprehension)是Python提供的一种非常简洁高效的语法。

假设我们有一个员工字典,想筛选出年龄大于30的员工:

employees = {    'Alice': {'age': 25, 'dept': 'HR'},    'Bob': {'age': 35, 'dept': 'IT'},    'Charlie': {'age': 30, 'dept': 'HR'},    'David': {'age': 40, 'dept': 'IT'}}# 使用字典推导式筛选年龄大于30的员工older_employees = {    name: details for name, details in employees.items() if details['age'] > 30}print("n年龄大于30的员工:")print(older_employees)# 输出: {'Bob': {'age': 35, 'dept': 'IT'}, 'David': {'age': 40, 'dept': 'IT'}}# 也可以在遍历时进行筛选,但不生成新字典print("n遍历并打印IT部门的员工:")for name, details in employees.items():    if details['dept'] == 'IT':        print(f"{name}: {details['age']}岁")

字典推导式不仅代码量少,而且通常比传统的

for

循环加

if

条件更具可读性,特别适合创建新的字典。它将遍历、筛选和创建新字典的逻辑紧密结合在一起,体现了Python的简洁和表达力。

以上就是Python如何遍历字典_Python字典遍历的常用方法汇总的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1368782.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Discord.py应用:JSON文件参数批量添加与优化
上一篇 2025年12月14日 09:05:04
Python如何打包项目_Python项目打包发布步骤解析
下一篇 2025年12月14日 09:05:13

相关推荐

  • 夸克Ai搜索如何设置默认_夸克Ai搜索默认引擎更改

    首先在夸克APP中将默认搜索引擎设为AI引擎,再开启相关AI功能开关以启用AI搜索服务。具体步骤:1、打开夸克APP,点击右下角菜单进入设置;2、选择“通用”选项,点击“搜索引擎”;3、选择“AI引擎”或“夸克AI搜索”作为默认服务;4、返回主界面测试搜索关键词,确认AI结果是否展示;5、进入“AI…

    2026年9月21日
    400
  • mysql如何实现后台管理系统

    答案:基于MySQL的%ignore_a_1%需设计用户、权限、日志等表结构,通过后端语言实现安全的CRUD接口与JWT认证,前端展示数据并控制权限,确保系统安全稳定。 实现一个基于 MySQL 的后台管理系统,核心是构建一个安全、稳定、可扩展的系统架构,将数据库作为数据存储层,配合后端语言和前端界…

    2026年9月21日
    000
  • Workerman服务启动失败的排查步骤

    workerman服务启动失败的排查步骤如下:1. 检查配置文件,确保无语法错误;2. 查看系统日志,寻找错误线索;3. 检查端口占用情况,确保端口未被占用;4. 调整文件权限,确保workerman有足够权限;5. 检查php环境,确保版本兼容且扩展已安装。 关于Workerman服务启动失败的排…

    2026年9月21日
    200
  • 百度浏览器自动跳转怎么办 百度浏览器页面跳转广告拦截方法

    百度浏览器自动跳转通常由恶意软件或设置被篡改引起,需检查浏览器设置、清除异常插件、修复快捷方式与注册表,并使用安全软件扫描清理,同时启用广告拦截与隐私保护功能以彻底解决问题。 百度浏览器出现自动跳转,通常不是浏览器本身的问题,而是由恶意软件、插件或设置被篡改导致的。解决这个问题需要从多个方面入手,检…

    2026年9月21日
    100
  • 压力测试(Benchmark)Swoole服务的工具与方法

    进行swoole服务的压力测试是为了确保服务在高负载下稳定运行。1. 选择工具:apache jmeter、wrk、locust。2. 使用方法:jmeter通过脚本配置,wrk通过命令行,locust通过python脚本。3. 注意事项:环境隔离、数据监控、脚本设计。4. 优化点:内存泄漏、连接池…

    2026年9月21日
    000
  • Windows11内存占用率过高怎么解决_Windows11内存占用过高修复方法

    1、通过任务管理器结束高内存占用进程;2、禁用Superfetch(SysMain)服务以降低内存负担;3、优化启动项减少后台负载;4、升级物理内存条提升系统性能。 如果您发现Windows 11系统运行缓慢,并且任务管理器显示内存占用率持续处于高位,这可能是由于后台进程过多、系统服务占用资源或硬件…

    2026年9月21日
    100
  • mysql常用存储引擎有哪些

    InnoDB是现代MySQL应用的首选存储引擎,因其支持事务(ACID)、行级锁、外键约束、崩溃恢复和MVCC,适用于高并发、数据完整性要求高的OLTP场景;MyISAM虽读取快但仅支持表级锁且无事务和外键,适用于读多写少的简单场景,已逐渐被淘汰;Memory引擎将数据存于内存,速度快但易失,适合临…

    2026年9月21日
    000
  • 怎么弄微信公众号_微信公众号注册与功能配置教程

    怎么弄微信公众号_微信公众号注册与功能配置教程怎么弄微信公众号_微信公众号注册与功能配置教程怎么弄微信公众号_微信公众号注册与功能配置教程怎么弄微信公众号_微信公众号注册与功能配置教程

    答案:注册微信公众号需先确定账号类型,订阅号适合内容发布,服务号侧重功能服务,个人注册仅能选订阅号,企业可选服务号并需认证;注册后需配置自定义菜单、自动回复和欢迎语以提升用户体验。 微信公众号的注册与功能配置,说到底,就是把你的内容或服务,通过微信这个巨大的平台,有效地触达目标用户。这过程不复杂,但…

    2026年9月21日 • 用户投稿
    100
  • 利用蝴蝶号搭建多账号无人直播系统的完整方案

    利用蝴蝶号搭建多账号无人直播系统的完整方案利用蝴蝶号搭建多账号无人直播系统的完整方案利用蝴蝶号搭建多账号无人直播系统的完整方案利用蝴蝶号搭建多账号无人直播系统的完整方案

    搭建多账号无人直播系统并非一键操作,而是通过“蝴蝶号”实现自动化流程。首先,“蝴蝶号”负责多账号的生命周期管理,包括登录、状态维护、ip代理分配和设备指纹模拟;其次,内容调度系统决定直播内容及播放时间,可为预录视频或动态生成流;再次,推流引擎将内容实时推送至平台,推荐使用ffmpeg结合python…

    2026年9月21日 • 用户投稿
    100
  • 锚定AI终端存储市场,康盈半导体连发三款新品

    锚定AI终端存储市场,康盈半导体连发三款新品锚定AI终端存储市场,康盈半导体连发三款新品锚定AI终端存储市场,康盈半导体连发三款新品锚定AI终端存储市场,康盈半导体连发三款新品

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 三款新品聚焦AI存储需求 在最新举行的产品发布会上,康盈半导体正式推出三款专为AI应用场景打造的全新存储解决方案,覆盖嵌入式存储与高性能固态硬盘等多个品类,旨在满足多样化AI终端对高效、紧凑、低…

    2026年9月21日 • 用户投稿
    100
  • 数据库运维开发环境的调试模式演进

    数据库运维开发环境的调试模式演进数据库运维开发环境的调试模式演进数据库运维开发环境的调试模式演进数据库运维开发环境的调试模式演进

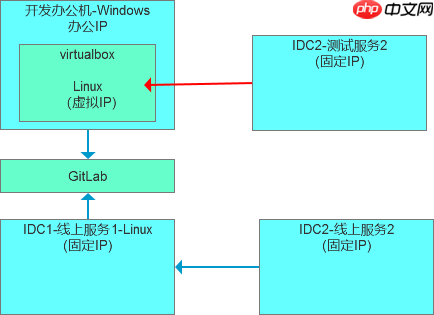
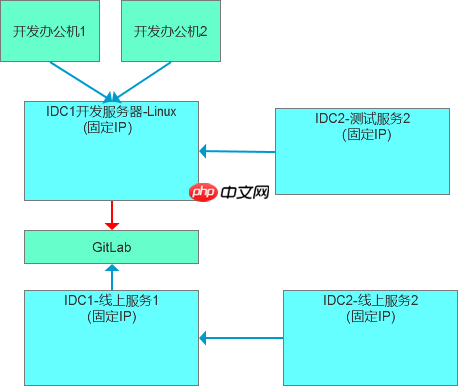
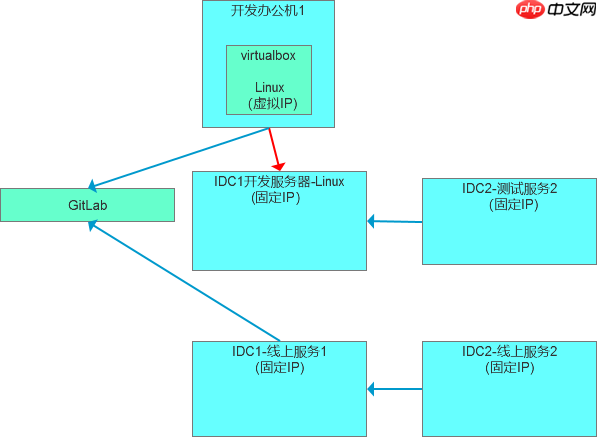
    这是学习笔记的第2393篇文章。 昨日,同事反馈了一个问题,原本的办公机环境中的虚拟机可以将办公机的IP暴露出来,提供数据库运维的API服务。例如,办公机的IP为192.168.10.100,而使用VirtualBox的虚拟机采用主机模式,其IP可能为192.168.56.100,那么192.168…

    2026年9月21日 • 用户投稿
    100
  • linux内核定时器实验

    linux内核定时器实验linux内核定时器实验linux内核定时器实验linux内核定时器实验

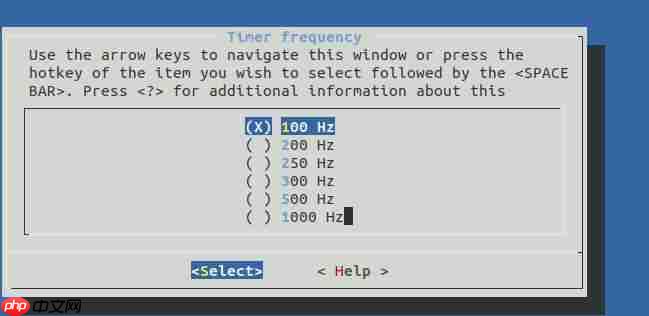
    大家好,又见面了,我是你们的朋友全栈君。 文章目录一、linux时间管理和内核定时器简介1.内核时间管理简介2.内核定时器简介1.init_timer 函数2.add_timer 函数3.del_timer 函数4.del_timer_sync 函数5.mod_timer 函数3.linux内核短延…

    2026年9月21日 • 用户投稿
    000
  • WordPress插件定制:使用Filter Hook修改邮件通知接收者

    本教程将指导您如何在WordPress中利用Filter Hook定制插件行为,特别是修改第三方插件的邮件通知接收者。我们将详细讲解如何识别目标Filter、理解其参数,并正确编写回调函数来拦截或修改数据,以实现自定义的邮件发送逻辑,避免因参数不匹配导致的错误。 WordPress Hook机制概览…

    2026年9月21日
    100
  • VSCode编写Java代码方法_VSCode搭建Java开发环境实战教程

    答案:在VSCode中配置Java开发环境需安装JDK并设置环境变量,再安装VSCode及Java扩展包,即可实现Java项目的创建、编写、运行与调试。它轻量、启动快,支持多语言和丰富扩展,集成Maven/Gradle,适合日常开发。 在VSCode里编写Java代码,说白了,就是把这个轻量级的代码…

    2026年9月21日
    100
  • Swoole如何实现一个UDP服务器

    答案:使用Swoole可轻松创建高性能UDP服务器。通过new SwooleServer()设置UDP套接字,监听Packet事件接收数据,利用sendto()回复客户端;结合set()配置worker_num等参数优化性能,配合PHP UDP客户端测试通信,适用于高并发、低延迟场景。 使用Swoo…

    2026年9月21日
    100
  • MySQL执行计划中的Extra字段代表什么_怎么看优化空间?

    MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?

    在 mysql 查询优化中,执行计划的 extra 字段用于说明查询执行时的额外操作,常见的值包括:1. using filesort 表示需要额外排序,应尽量通过建立索引避免;2. using temporary 表示使用了临时表,常见于 group by 或复杂 join,需优化减少其使用;3.…

    2026年9月21日 • 用户投稿
    100
  • 如何通过tracert命令追踪数据包从本地到目标服务器的完整路径?

    打开命令提示符,输入cmd并回车;2. 执行tracert 目标地址命令追踪路径;3. 查看每跳响应时间与IP,分析延迟变化定位网络瓶颈;4. 注意部分节点可能因防火墙不响应导致超时。 使用 tracert(Windows 系统)命令可以追踪数据包从你的计算机到目标服务器所经过的每一跳网络节点,帮助…

    2026年9月21日
    1000
  • 如何在Java中理解Java I/O与NIO机制

    传统I/O是阻塞式流模型,适用于低并发场景;NIO基于缓冲区与通道,支持非阻塞和多路复用,适合高并发网络应用,核心区别在于线程模型与资源利用率。 Java中的I/O(输入/输出)与NIO(New I/O)是处理数据读写的核心机制,理解它们的区别和使用场景对开发高性能应用至关重要。传统I/O基于流模型…

    2026年9月21日
    100
  • JavaScript中的尾调用优化(TCO)在ES6中如何工作?

    尾调用是指函数的最后一个动作调用另一个函数,ES6引入尾调用优化以重用栈帧、避免内存溢出,支持真正的尾递归,如阶乘函数通过累积参数实现。 尾调用优化(Tail Call Optimization, TCO)是ES6引入的一项语言特性,目的是在特定条件下重用函数调用栈帧,避免不必要的内存增长,从而支持…

    2026年9月21日
    200
  • 抖音蝴蝶号无人直播带货操作流程及注意事项

    抖音蝴蝶号无人直播带货操作流程及注意事项抖音蝴蝶号无人直播带货操作流程及注意事项抖音蝴蝶号无人直播带货操作流程及注意事项抖音蝴蝶号无人直播带货操作流程及注意事项

    “抖音蝴蝶号无人直播带货”是一种通过自动化或半自动化技术实现的直播销售模式。①其核心在于摆脱真人主播限制,实现24小时不间断直播,提升效率与流量利用率;②关键步骤包括明确账号定位与商品选择、准备高质量且丰富的内容素材、利用虚拟人或预录内容实现直播推流、结合智能客服模拟评论区互动;③优势在于降低人力成…

    2026年9月21日 • 用户投稿
    600

发表回复

登录后才能评论
关注微信