Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Pandas中基于多条件和时间窗口匹配关联数据的策略_创想鸟

Pandas中基于多条件和时间窗口匹配关联数据的策略

Pandas中基于多条件和时间窗口匹配关联数据的策略

本教程探讨如何在Pandas中高效地将一个DataFrame中的事件与另一个DataFrame中特定时间窗口(例如7天内)内的相关事件进行匹配和聚合。针对merge_asof的局限性,我们将介绍两种主要方法:利用pyjanitor库的conditional_join功能实现多条件高效连接,以及纯Pandas的merge结合筛选和聚合方案。文章将通过具体示例代码,详细阐述两种方法的实现步骤、适用场景及其性能考量。

问题场景与挑战

在数据分析中,我们经常需要关联两个数据集,其中一个数据集的记录(例如交易记录)需要匹配另一个数据集(例如浏览历史)中发生在特定时间窗口内的所有相关记录。考虑以下两个pandas dataframe:

trade DataFrame:包含交易日期、人员ID、商品代码和交易价值。

import pandas as pdimport janitor # 用于方案一trade = pd.DataFrame({'date': ['2019-08-31', '2019-09-01', '2019-09-04'],                      'person': [1, 1, 2],                      'code': [123, 123, 456],                      'value1': [1, 2, 3]})

view DataFrame:包含浏览日期、人员ID、商品代码和浏览价值。

view = pd.DataFrame({'date': ['2019-08-29', '2019-08-29', '2019-08-30', '2019-08-31', '2019-09-01', '2019-09-01', '2019-09-01', '2019-09-02', '2019-09-03'],                      'person': [1, 1, 1, 2, 1, 2, 2, 1, 2],                      'code': [123, 456, 123, 456, 123, 123, 456, 123, 456],                      'value': [1, 2, 3, 4, 5, 6, 7, 8, 9]})

我们的目标是为每一笔交易,找出其发生前7天内(含交易当天)所有匹配person和code的浏览记录,并将这些浏览记录的日期和价值聚合为列表。

直接使用Pandas的merge_asof函数在这种场景下存在局限性。merge_asof设计用于“最近匹配”,它会为左DataFrame的每一行找到右DataFrame中最近的匹配行,且通常只匹配一次。这不符合我们“获取所有在时间窗口内的匹配项”的需求。例如,merge_asof可能会将view中的[1, 3]分配给第一笔交易,但对于第二笔交易,它可能只会分配[5],而忽略了同样在时间窗口内的[1, 3]。

方案一:使用pyjanitor.conditional_join进行高效多条件连接

pyjanitor库提供了一个强大的conditional_join函数,它允许基于多个自定义条件进行连接,包括非等值条件(如时间范围)。这使得它成为解决此类问题的理想选择,尤其是在处理大型数据集时,其效率通常高于纯Pandas的通用合并再筛选方案。

实现步骤

日期列转换:确保所有涉及日期比较的列都是Pandas的datetime类型。创建辅助时间列:在trade DataFrame中,为每笔交易计算一个“开始日期”,即交易日期减去7天。这将作为时间窗口的下限。执行条件连接:使用conditional_join连接trade和view DataFrame。连接条件包括:view的日期在trade的start_date之后或等于。view的日期在trade的date之前或等于。person列相等。code列相等。数据聚合:连接完成后,结果DataFrame中每行将是trade记录与一个匹配的view记录的组合。我们需要根据原始trade的列进行分组,然后将匹配到的view_dates和view_values聚合成列表。格式化输出:将聚合后的日期列表转换回字符串格式。

代码示例

# 确保日期列为datetime类型trade['date'] = pd.to_datetime(trade['date'])view['date'] = pd.to_datetime(view['date'])# 方案一:使用janitor.conditional_joinout_janitor = (trade  .assign(start_date=lambda d: d['date'].sub(pd.DateOffset(days=7))) # 计算时间窗口的开始日期  .conditional_join(view.rename(columns={'date': 'view_dates', 'value': 'view_values'}), # 重命名view的列以避免冲突                    # 定义连接条件:(左列, 右列, 操作符)                    ('start_date', 'view_dates', '= start_date                    ('date', 'view_dates', '>='),       # view_dates <= trade_date                    ('person', 'person', '=='),         # person相等                    ('code', 'code', '=='),             # code相等                    right_columns=['view_dates', 'view_values'] # 只保留view中需要的列                   )  .drop(columns='start_date') # 移除辅助列  .assign(view_dates=lambda d: d['view_dates'].dt.strftime('%Y-%m-%d')) # 格式化日期为字符串  .groupby(list(trade.columns), as_index=False).agg(list) # 按原始trade列分组并聚合为列表)print("--- 使用 janitor.conditional_join 的结果 ---")print(out_janitor)

优势分析

conditional_join在内部实现了优化的算法来处理非等值连接,特别是涉及到范围查询时,其性能通常优于先进行笛卡尔积式合并再筛选的纯Pandas方法,尤其适用于大数据集。

方案二:纯Pandas的通用合并与筛选

虽然conditional_join更高效,但也可以纯粹使用Pandas的merge和loc进行筛选来实现相同的功能。这种方法在概念上更直接,但可能在性能上有所牺牲,因为它首先会生成一个更大的中间DataFrame。

实现步骤

日期列转换:同方案一,确保日期列为datetime类型。通用合并:使用merge函数基于person和code列进行内连接。这将生成trade和view中所有person和code匹配的组合。时间窗口筛选:使用loc根据时间条件(view_dates在trade_date前7天内)对合并后的结果进行筛选。数据聚合:同方案一,根据原始trade的列进行分组,然后将匹配到的view_dates和view_values聚合成列表。格式化输出:将聚合后的日期列表转换回字符串格式。

代码示例

# 确保日期列为datetime类型trade['date'] = pd.to_datetime(trade['date'])view['date'] = pd.to_datetime(view['date'])# 方案二:纯Pandas解决方案out_pandas = (trade .merge(view.rename(columns={'date': 'view_dates', 'value': 'view_values'}), # 重命名view的列        on=['person', 'code']) # 基于person和code进行合并 .loc[lambda d: d['date'].gt(d['view_dates']) & # 交易日期必须晚于浏览日期      d['date'].sub(pd.DateOffset(days=7)).le(d['view_dates']) # 浏览日期必须在交易日期前7天内     ] .assign(view_dates=lambda d: d['view_dates'].dt.strftime('%Y-%m-%d')) # 格式化日期为字符串 .groupby(list(trade.columns), as_index=False).agg(list) # 按原始trade列分组并聚合为列表)print("n--- 纯Pandas解决方案的结果 ---")print(out_pandas)

局限性分析

纯Pandas方案首先会生成一个包含所有person和code匹配组合的中间DataFrame。如果trade和view中存在大量相同person和code的记录,这个中间DataFrame可能会非常大,导致内存消耗增加和计算时间延长。随后进行的时间条件筛选会减少数据量,但前期合并的开销是不可避免的。

总结与最佳实践

两种方法都能达到预期的结果:

        date  person  code  value1                            view_dates view_values0 2019-08-31       1   123       1              [2019-08-29, 2019-08-30]      [1, 3]1 2019-09-01       1   123       2  [2019-08-29, 2019-08-30, 2019-09-01]   [1, 3, 5]2 2019-09-04       2   456       3  [2019-08-31, 2019-09-01, 2019-09-03]   [4, 7, 9]

对于小型数据集或对性能要求不高的场景:纯Pandas解决方案简单直观,易于理解和实现。对于大型数据集或对性能有严格要求的场景:强烈推荐使用pyjanitor.conditional_join。它通过更优化的算法处理非等值连接,能够显著提高效率并减少内存消耗。

注意事项:

日期类型一致性:在进行任何日期比较或计算之前,务必确保所有日期列都已正确转换为Pandas datetime类型。时间窗口定义:根据具体业务需求精确定义时间窗口(例如,pd.DateOffset(days=7)表示7天,可以根据需要调整为hours、minutes等)。列名冲突:在合并前,如果两个DataFrame中有相同名称但含义不同的列,请务必重命名以避免混淆。在示例中,我们重命名了view中的date和value列。安装pyjanitor:如果选择使用pyjanitor,请确保已通过pip install pyjanitor安装该库。

通过上述两种方法,我们可以灵活地在Pandas中处理复杂的基于多条件和时间窗口的数据关联任务,选择最适合当前项目需求和数据规模的方案。

以上就是Pandas中基于多条件和时间窗口匹配关联数据的策略的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1369641.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python统计CSV文件中数字数量的教程
上一篇 2025年12月14日 09:50:12
Pandas中基于时间窗口关联和聚合数据的技巧:以交易与浏览记录为例
下一篇 2025年12月14日 09:50:27

相关推荐

  • Java Stream 高效分组计数并获取Top N元素

    本文深入探讨了如何利用java stream api对数据进行高效的分组计数,并从中提取出现频率最高的top n元素。文章首先介绍了一种简洁的基于全排序的实现方式,该方法适用于数据集较小或top n值接近总数的情况。随后,针对大数据量和小型top n场景下的性能瓶颈,文章详细阐述了如何通过自定义`c…

    2026年9月21日
    000
  • 如何在Java中实现简单的输入输出

    使用Scanner类读取键盘输入,需导入java.util.Scanner并创建实例;2. 调用nextInt、nextLine等方法获取不同类型数据,注意nextInt不读取换行符可能导致nextLine读取空字符串;3. 推荐使用后关闭Scanner;4. 输出通过System.out.prin…

    2026年9月21日
    000
  • 打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

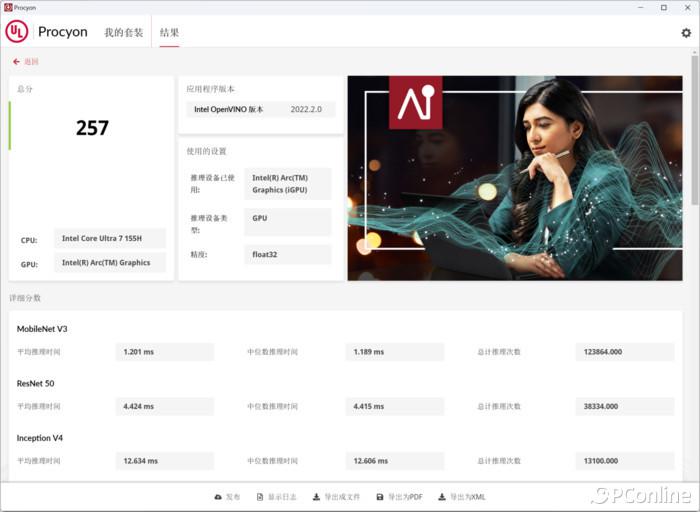
    进入2024年,无论是硬件厂商还是软件供应商,都开始加大力度,向公众宣扬ai对工作生活乃至游戏的影响。在这样的背景下,选择购买一台全新的笔记本,很难不考量它的ai能力对自身使用的影响。因此,我们可以看到办公轻薄本的 ” 常青树 ” ——戴尔灵越系列,也凭借搭载的英特尔酷睿 u…

    2026年9月21日 • 用户投稿
    400
  • Java并发编程中CopyOnWriteArrayList使用场景

    CopyOnWriteArrayList适用于读多写少场景,通过写时复制实现线程安全,读操作无锁并发,迭代基于快照不抛异常,适合配置列表、监听器等数据变动少且需高性能读取的并发环境。 在Java并发编程中,CopyOnWriteArrayList 是一种线程安全的List实现,适用于读多写少的并发场…

    2026年9月21日
    100
  • 抖音商城是哪个公司在运营

    抖音商城的运营主体揭晓 抖音商城由北京微播视界科技有限公司负责运营。 作为抖音背后的母公司,字节跳动通过其全资子公司——微播视界,全面掌舵抖音平台及其电商板块的日常运作。依托雄厚的技术积累与多元化的业务布局,为用户打造流畅、智能且高效的购物环境。 抖音商城究竟是什么? 抖音商城是抖音App内嵌的一站…

    2026年9月21日
    200
  • time函数处理时间在mysql中如何操作

    MySQL中的时间函数用于处理时间数据,如获取当前时间用NOW()或CURTIME(),提取时间部分用TIME(),格式化输出用TIME_FORMAT(),时间计算可用TIMEADD()、TIMEDIFF()等函数,支持加减和差值运算,需注意字段类型与格式匹配。 在 MySQL 中,time 函数和…

    2026年9月20日
    100
  • JAXB中动态获取Java对象QName并创建JAXBElement的反射策略

    本文探讨了在jaxb中,当`jaxbintrospector.getelementname`无法获取java对象对应的`qname`时,如何通过反射机制调用`objectfactory`中生成的`create`方法来动态创建`jaxbelement`。该方法避免了大量类型判断,提高了代码的灵活性和可…

    2026年9月20日
    100
  • Python中print函数使用详解

    Python中print函数使用详解Python中print函数使用详解Python中print函数使用详解Python中print函数使用详解

    1、 输出常见数据类型如字符串与整数 2、 对输出结果进行格式化处理 立即学习“Python免费学习笔记(深入)”; 3、 实现浮点数的格式化输出 4、 关闭自动换行功能 以上就是Python中print函数使用详解的详细内容,更多请关注创想鸟其它相关文章!

    2026年9月20日 • 用户投稿
    200
  • mysql如何优化日期查询

    正确使用索引和避免函数干扰是MySQL日期查询优化的核心。1. 为日期字段添加索引,确保范围查询高效执行;2. 避免在WHERE条件中对日期字段使用DATE()、YEAR()等函数,改用范围比较;3. 用order_date >= ‘2024-01-01’ AND or…

    2026年9月20日
    100
  • Linux输出文本echo命令应用

    echo命令不仅能输出文本,还可结合变量、转义序列和重定向实现动态内容生成、文件创建与追加、配置修改、管道处理及脚本调试,其行为在Bash、Zsh和Dash等shell中因内置实现不同而存在差异,尤其在转义序列处理上需注意使用-e选项或改用printf以保证一致性。 echo 命令在 Linux 中…

    2026年9月20日
    000
  • mysql如何设计审计表

    设计MySQL审计表需明确审计范围,优先针对核心业务表实施行级、操作行为及DDL变更审计。采用通用结构audit_log表,以JSON字段存储新旧值,记录操作类型、时间、操作者等关键信息,并建立索引提升查询效率。通过触发器自动捕获数据变更,结合应用层传递真实用户身份与客户端信息,实现完整审计链路。1…

    2026年9月20日
    000
  • 跨境电商时差大?夜班客服成本高?智能客服多语言24小时值守,人力节省70%!告别熬夜值班!智能客服全天候守护全球生意,让跨境服务更轻松

    跨境电商的时差挑战终于迎来高效解决方案!当海外客户在深夜发起咨询,您无需再依赖高成本的夜间人工团队。晓多智能客服凭借先进的多语言ai应答系统,实现全天候无缝对接全球消费者。无论是英语市场的促销询问,还是法语用户的退换货请求,我们的智能客服都能精准理解并实时回复。某知名美妆品牌接入后,彻底摆脱了夜班排…

    2026年9月20日
    200
  • mysql如何实现用户行为分析

    答案:通过设计用户行为日志表并利用SQL实现活跃度、转化率、页面跳转和留存分析,结合索引优化与外部工具,MySQL可有效支持中小规模用户行为分析。 在MySQL中实现用户行为分析,核心是利用现有数据表结构(如用户操作日志、访问记录等)进行查询和统计,提取出有价值的用户行为模式。虽然MySQL不是专门…

    2026年9月13日
    100
  • mysql如何编写插入数据的insert语句

    编写INSERT语句的核心是安全准确地向表中插入数据,基本语法为INSERT INTO 表名 (列) VALUES (值);可省略列名或使用SET子句,也可通过INSERT … SELECT批量导入;为提升效率,应采用多行VALUES批量插入或LOAD DATA INFILE加载文件;面…

    2026年9月12日
    200
  • 如何在mysql中使用日期函数处理时间数据

    MySQL常用日期函数包括:NOW()、CURDATE()、CURTIME()获取当前时间;YEAR()、MONTH()、DAY()等提取日期部分;DATE_FORMAT()自定义格式化输出;DATE_ADD()、DATE_SUB()进行日期加减;DATEDIFF()和TIMESTAMPDIFF()…

    2026年9月12日
    100
  • 如何在mysql中高效使用SELECT语句

    避免SELECT *,只查询必要列以减少I/O和网络开销;2. 在WHERE条件中使用索引字段并避免函数操作以防止索引失效;3. 用主键或唯一键进行分页优化,避免大偏移量导致性能下降。 在MySQL中高效使用SELECT语句,关键在于优化查询逻辑、合理利用索引以及减少不必要的数据处理。以下是一些实用…

    2026年9月12日
    000
  • 如何在mysql中优化批量写入效率

    使用批量INSERT、显式事务、调整InnoDB参数、优先LOAD DATA INFILE及优化索引策略可显著提升MySQL写入效率,核心是减少I/O与事务开销。 在 MySQL 中进行批量写入时,如果处理不当,很容易导致性能低下。优化批量写入效率可以从多个方面入手,核心目标是减少磁盘 I/O、降低…

    2026年9月12日
    000
  • Java中Collections.sort排序的原理与示例

    Collections.sort()基于TimSort算法,结合插入排序与归并排序,适用于List类型,要求元素可比较或提供Comparator,确保排序稳定高效。 Collections.sort() 是 Java 中用于对集合元素进行排序的工具方法,主要针对 List 类型的集合。它背后依赖于数…

    2026年9月12日
    200
  • 京东小时购示爱送礼和好礼救急专场活动规则是什么?如何进行实操?

    在快节奏的都市生活中,京东小时购精准洞察了两大核心消费场景:情人节等特殊时刻急需传递心意的「示爱送礼」,以及突发状况下对物资的紧急需求「好礼救急」。即日起至2月14日,平台推出鲜花、蛋糕、美妆等14大品类专场,叠加最高立减15元的跑腿补贴、520京豆返利等多项福利,真正实现“即时所需,一小时达”的便…

    2026年9月11日
    100
  • mysql如何进行分页查询

    MySQL分页通过LIMIT和OFFSET实现,语法为SELECT FROM table_name LIMIT limit_count OFFSET offset_count;2. 实际应用中每页显示固定条数,如查询users表第1页LIMIT 10 OFFSET 0,第2页LIMIT 10 OFF…

    2026年9月11日
    100

发表回复

登录后才能评论
关注微信