Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
PySpark数据框:高效实现序列化缺失值前向填充_创想鸟

PySpark数据框:高效实现序列化缺失值前向填充

PySpark数据框:高效实现序列化缺失值前向填充

本文详细介绍了如何在PySpark DataFrame中高效地实现基于序列的前向填充缺失值。针对group_id等列中出现的空值,通过利用PySpark的窗口函数(Window.orderBy和F.last),能够根据row_id的顺序,将前一个非空值填充到后续的空值位置,确保数据的完整性和逻辑连贯性,尤其适用于大规模数据集的处理。

引言

在数据处理过程中,我们经常会遇到数据框中存在缺失值的情况。特别是在某些场景下,缺失值的填充需要遵循特定的逻辑,例如根据序列顺序,将前一个非空值填充到后续的空值位置。本文将聚焦于pyspark dataframe,提供一种高效且专业的方法来解决这类序列化缺失值前向填充问题。例如,当group_id列中存在空值,而我们希望根据row_id的递增顺序,用最近的非空group_id来填充后续的空值,直到遇到下一个非空group_id为止。

核心概念:PySpark窗口函数

PySpark的窗口函数(Window Functions)是处理此类序列化操作的强大工具。它们允许我们在数据框的特定“窗口”内执行计算,而这个窗口可以根据一行或多行的顺序和分区来定义。

对于序列化前向填充,我们需要定义一个窗口,该窗口包含当前行以及其之前的所有行。然后,在这个窗口内找到group_id的最后一个非空值。

关键的窗口函数组件包括:

Window.orderBy(“row_id”): 定义窗口的排序规则,确保我们按照row_id的顺序进行处理。rowsBetween(Window.unboundedPreceding, 0): 定义窗口的范围。Window.unboundedPreceding: 表示窗口从分区的第一行开始。0: 表示窗口的结束点是当前行(偏移量为0)。结合起来,这个窗口定义了从数据开始到当前行(包括当前行)的所有记录。F.last(“column_name”, ignorenulls=True): 在定义的窗口内,获取指定列的最后一个非空值。ignorenulls=True参数至关重要,它确保我们只考虑非空值。

实现步骤与示例代码

下面是使用PySpark窗口函数实现序列化缺失值前向填充的具体步骤和示例代码。

初始化Spark会话: 首先,需要创建一个SparkSession。创建示例DataFrame: 根据问题描述,创建一个包含row_id和group_id的DataFrame,其中group_id包含空值。定义窗口规范: 使用Window.orderBy和rowsBetween定义窗口。应用last函数填充缺失值: 使用F.last函数结合ignorenulls=True,在定义的窗口上应用填充逻辑。

from pyspark.sql import SparkSessionfrom pyspark.sql import functions as Ffrom pyspark.sql.window import Window# 1. 创建Spark会话spark = SparkSession.builder.appName("SequentialFillNulls").getOrCreate()# 2. 创建示例DataFramedata = [    (1, 1), (2, None), (3, None), (4, None),    (5, 5), (6, None), (7, None),    (8, 8), (9, None), (10, None), (11, None), (12, None)]columns = ["row_id", "group_id"]df = spark.createDataFrame(data, columns)print("原始DataFrame:")df.show()# 3. 定义窗口规范# 窗口按row_id排序,范围从分区开始到当前行windowSpec = Window.orderBy("row_id").rowsBetween(Window.unboundedPreceding, 0)# 4. 应用last函数填充缺失值# 使用last函数获取窗口内最后一个非空group_idfilled_df = df.withColumn(    "group_id",    F.last("group_id", ignorenulls=True).over(windowSpec))print("填充缺失值后的DataFrame:")filled_df.show()# 关闭Spark会话spark.stop()

运行上述代码,将得到以下输出:

原始DataFrame:+------+--------+|row_id|group_id|+------+--------+|     1|       1||     2|    null||     3|    null||     4|    null||     5|       5||     6|    null||     7|    null||     8|       8||     9|    null||    10|    null||    11|    null||    12|    null|+------+--------+填充缺失值后的DataFrame:+------+--------+|row_id|group_id|+------+--------+|     1|       1||     2|       1||     3|       1||     4|       1||     5|       5||     6|       5||     7|       5||     8|       8||     9|       8||    10|       8||    11|       8||    12|       8|+------+--------+

关键点与注意事项

row_id的唯一性和顺序性: 本方案的核心在于row_id能够提供一个明确的排序基准。确保row_id是唯一且递增的,对于正确实现前向填充至关重要。如果原始数据没有这样的列,可能需要先通过zipWithIndex或monotonically_increasing_id等方法创建一个。ignorenulls=True的重要性: 在F.last函数中,ignorenulls=True参数确保了只有非空值才会被考虑为“最后一个值”。如果没有这个参数,last函数可能会返回窗口中的最后一个值,即使它是null,从而导致填充不正确。性能考量: 窗口函数在PySpark中是高度优化的,可以高效处理大规模数据集。然而,Window.orderBy操作涉及到数据的全局排序,可能会在集群中引起数据混洗(shuffle),对于超大规模数据集,这可能是性能瓶颈之一。在实际应用中,应评估其对性能的影响。分区(Partitioning): 如果数据本身可以逻辑地划分为多个独立的组(例如,除了row_id还有一个category_id),并且需要在每个category_id内部进行独立的前向填充,那么可以在窗口规范中添加partitionBy(“category_id”)。例如:Window.partitionBy(“category_id”).orderBy(“row_id”).rowsBetween(Window.unboundedPreceding, 0)。替代方法对比: 对于简单的非序列化缺失值填充,PySpark提供了df.fillna()方法。但fillna()无法实现基于前一个值的序列化填充逻辑,因此窗口函数是此类问题的首选方案。

总结

通过PySpark的窗口函数,我们可以优雅且高效地解决DataFrame中基于序列的前向填充缺失值问题。Window.orderBy结合rowsBetween定义了灵活的窗口范围,而F.last(…, ignorenulls=True)则精确地提取了所需的非空值进行填充。这种方法不仅适用于小规模数据,更能在处理百万级甚至亿级行的大规模数据集时展现其强大的性能和可靠性。掌握这一技术,将极大地提升PySpark数据处理的效率和准确性。

以上就是PySpark数据框:高效实现序列化缺失值前向填充的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1370358.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

优化 Tabula-py 表格提取:解决不完整数据与冗余列的实践指南
上一篇 2025年12月14日 10:28:46
PostgreSQL处理超万列CSV数据:JSONB与GIN索引的实践指南
下一篇 2025年12月14日 10:28:57

相关推荐

  • VSCode运行多文件C项目 完整VSCode配置C++开发教程

    要解决#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8运行多文件c项目的问题,核心是正确配置tasks.json、launch.json和settings.json文件以定义编译、调试和项目路径。首先安装c/c++扩展插件和可选的编译…

    2026年9月22日
    000
  • Java集合框架在实际项目中的最佳实践

    合理选择集合类型并预设容量,使用不可变集合保护数据,避免遍历中修改结构,可提升Java程序性能与安全性。 Java集合框架是开发中使用最频繁的工具之一,合理使用能显著提升代码的可读性、性能和稳定性。在实际项目中,遵循一些最佳实践可以避免常见陷阱,提高程序健壮性。 选择合适的集合类型 不同场景应选用最…

    2026年9月22日
    000
  • qq浏览器如何清理dns缓存_QQ浏览器强制刷新与清除DNS缓存指南

    首先清除QQ浏览器DNS缓存:打开应用→点击「我的」→进入「设置」→选择「清理浏览数据」→勾选「DNS缓存」→点击「立即清理」;随后可通过在地址栏添加「#refresh」实现强制刷新;也可使用无痕模式验证问题是否由缓存引起。 如果您尝试访问某个网站,但页面加载缓慢或显示错误,可能是由于本地DNS缓存…

    2026年9月22日
    100
  • 抖音企业号怎么绑定员工号?绑定员工号有哪些好处?

    抖音企业号绑定员工账号是优化团队协作与提升运营效率的重要方式。通过官方流程,企业可将员工的个人抖音号与企业主体进行关联,实现权限分配与协同管理。 一、如何绑定抖音企业号员工号? 准备前提条件:确保企业号已完成企业认证,且员工所使用的抖音账号处于正常使用状态。管理员需准备好营业执照、员工身份资料等信息…

    2026年9月22日
    000
  • Canva的AI混合工具如何操作?快速设计专业图形与文本的步骤

    Canva的AI混合功能通过Magic Studio将文本、图像生成与智能设计整合,提升创作效率。首先,使用Magic Write生成文案初稿,克服空白页难题;其次,通过Magic Media输入详细描述生成定制化图像,越具体效果越好;再利用Magic Design上传图片或输入文字自动生成多种设计…

    2026年9月22日
    000
  • vivoY系列微信收款语音播报如何设置?快速设置语音的实用方法

    先在微信内开启收款语音提醒,再确保vivo手机系统中微信的通知权限、后台运行和电池优化设置正确,避免静音或勿扰模式干扰,即可解决语音不响问题。 vivo Y系列手机上设置微信收款语音播报,核心在于微信应用内部的设置,同时需要确保手机系统层面的通知权限和后台运行策略没有限制它。简单来说,就是先在微信里…

    2026年9月22日
    000
  • win10系统图标(如此电脑)太大怎么办_win10系统图标大小调整方法

    首先通过快捷键Ctrl加鼠标滚轮可快速调整桌面图标大小,其次在显示设置中修改缩放比例能全局调整界面元素,最后若因间距异常导致图标过大,可通过注册表将IconSpacing和IconVerticalSpacing值改为-1125后重启生效。 如果您发现Windows 10系统中的图标(如“此电脑”)显…

    2026年9月22日
    000
  • CentOS7搭建个人站点

    CentOS7搭建个人站点CentOS7搭建个人站点CentOS7搭建个人站点CentOS7搭建个人站点

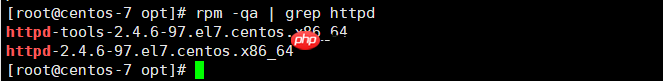
    在本文中,我们将指导您在centos7系统上使用httpd搭建个人网站。httpd是apache http服务器的主程序,设计为一个独立运行的后台进程,负责建立处理请求的子进程或线程池。 首先,我们需要通过rpm命令检查系统中是否已安装httpd: rpm -qa | grep httpd 如果执行…

    2026年9月22日 用户投稿
    200
  • 降压超频(Undervolting)在笔记本与显卡上的能效提升

    降压超频是通过降低芯片核心电压来减少功耗与发热并维持性能的技术。现代处理器和显卡因制造差异,厂商通常设置较高默认电压以确保稳定性,而降压则在保证系统稳定的前提下,去除冗余电压,实现更低功耗与温度。其核心原理为:降低电压→减少功耗与发热→降低风扇转速与电池消耗→提升续航、静音性及持续性能表现。在笔记本…

    2026年9月22日
    200
  • VSCode 怎样配置项目的依赖包自动安装 VSCode 项目依赖包自动安装的配置指南​

    VSCode 怎样配置项目的依赖包自动安装 VSCode 项目依赖包自动安装的配置指南​VSCode 怎样配置项目的依赖包自动安装 VSCode 项目依赖包自动安装的配置指南​VSCode 怎样配置项目的依赖包自动安装 VSCode 项目依赖包自动安装的配置指南​VSCode 怎样配置项目的依赖包自动安装 VSCode 项目依赖包自动安装的配置指南​

    vscode没有内置“一键安装所有依赖”功能,因为它作为通用编辑器需保持轻量与灵活性,无法预设所有项目的依赖管理逻辑;要实现类似效果,最有效的方法是通过配置tasks.json和launch.json实现半自动安装:1. 在项目根目录的.vscode文件夹中创建tasks.json文件,定义“che…

    2026年9月22日 用户投稿
    100
  • MAC的“自动操作”(Automator)怎么用_macOS自动操作创建快速工作流程

    使用Automator可创建自动化工作流程,通过选择“工作流程”并添加操作实现任务串联,保存为“快速操作”或“应用程序”便于调用,结合日历设置定时执行,并可嵌入Shell脚本扩展功能,提升Mac操作效率。 如果您希望在日常操作中提升效率,可以通过自动化重复性任务来节省时间。MAC的“自动操作”(Au…

    2026年9月22日
    000
  • MySQL服务无法启动怎么办?常见解决方法

    MySQL服务无法启动怎么办?常见解决方法MySQL服务无法启动怎么办?常见解决方法MySQL服务无法启动怎么办?常见解决方法MySQL服务无法启动怎么办?常见解决方法

    mysql服务无法启动常见原因包括配置错误、端口占用、数据文件损坏或权限问题。解决方法如下:1. 查看错误日志,定位问题根源;2. 检查配置文件是否存在语法错误或路径问题;3. 确认端口(如3306)未被占用;4. 核查数据目录的权限与完整性;5. 必要时修复或重置数据目录,甚至重新安装mysql。…

    2026年9月22日 用户投稿
    000
  • Java TreeMap如何自定义排序规则

    TreeMap默认按键的自然顺序排序,可通过构造函数传入Comparator自定义排序规则。例如字符串可按长度排序:TreeMap map = new TreeMap((s1, s2) -> s1.length() – s2.length()); 对自定义对象如Person可按年龄…

    2026年9月22日
    000
  • 如何使用MLflow训练AI大模型?模型管理与跟踪的实用教程

    如何使用MLflow训练AI大模型?模型管理与跟踪的实用教程如何使用MLflow训练AI大模型?模型管理与跟踪的实用教程如何使用MLflow训练AI大模型?模型管理与跟踪的实用教程如何使用MLflow训练AI大模型?模型管理与跟踪的实用教程

    MLflow通过实验跟踪、可复现的项目封装、标准化模型格式和集中式模型注册表,实现大模型训练的全流程管理。它记录超参数、指标和模型文件,支持分布式环境下的集中日志管理,利用远程跟踪服务器和云存储统一收集数据,并通过模型版本控制与阶段管理提升团队协作与部署效率。 ☞☞☞AI 智能聊天, 问答助手, A…

    2026年9月22日 用户投稿
    000
  • windows怎么开启或关闭休眠模式_休眠模式启用与禁用设置

    首先通过控制面板或命令提示符启用或禁用休眠功能,其次可设置自动休眠时间以节能;操作路径包括图形界面调整与管理员命令执行,适用于Windows 11系统环境。 如果您发现Windows系统的休眠功能未启用或希望禁用该功能以释放磁盘空间,可以通过系统电源设置或命令行工具进行配置。休眠模式会将当前系统状态…

    2026年9月22日
    000
  • 如何在MiniToolMovieMaker中编辑AI视频?免费AI视频剪辑的教程

    如何在MiniToolMovieMaker中编辑AI视频?免费AI视频剪辑的教程如何在MiniToolMovieMaker中编辑AI视频?免费AI视频剪辑的教程如何在MiniToolMovieMaker中编辑AI视频?免费AI视频剪辑的教程如何在MiniToolMovieMaker中编辑AI视频?免费AI视频剪辑的教程

    MiniTool MovieMaker虽无AI生成功能,但可高效编辑AI生成的MP4、MOV等格式视频或图片序列。通过导入素材后,利用其剪辑、过渡、滤镜、文字、音频处理等功能,实现AI片段的精剪、色彩统一、无缝衔接与风格化输出。支持主流视频、图片及音频格式,兼容性好,适合个人创作者进行AI内容后期整…

    2026年9月22日 用户投稿
    500
  • VSCode如何调试JavaScript代码 VSCode调试功能的实战技巧

    要在vscode中调试javascript,首先需设置断点、配置launch.json文件、选择合适的调试环境并启动调试会话;2. launch.json至关重要,常见陷阱包括program路径错误、type类型不匹配、cwd设置不当、混淆launch与attach模式以及source map配置缺…

    2026年9月22日
    000
  • Linux内核13-进程切换

    进程切换,也称为任务切换、上下文切换或任务调度,本文将探讨linux内核中进程切换的实现。我们首先理解几个关键概念。 1.1 硬件上下文 每个进程都有自己的地址空间,但所有进程共享CPU寄存器。因此,在恢复进程执行前,内核必须确保挂起时的寄存器值被重新加载到CPU寄存器中。 这些需要加载到CPU寄存…

    2026年9月22日
    200
  • 如何修改MySQL的默认端口号?

    如何修改MySQL的默认端口号?如何修改MySQL的默认端口号?如何修改MySQL的默认端口号?如何修改MySQL的默认端口号?

    修改mysql默认端口号需编辑配置文件,核心步骤为:1.定位my.cnf或my.ini文件;2.在[mysqld]段落中修改或添加port参数;3.保存后重启mysql服务。更改端口主要出于避免冲突、提升安全性和适应网络策略考虑。连接时需在客户端工具或代码中指定新端口,如命令行加-p参数、编程语言连…

    2026年9月22日 用户投稿
    1200
  • windows怎么查看系统稳定性历史记录_windows可靠性监视器使用方法

    可通过控制面板、运行命令、搜索功能或事件查看器打开可靠性监视器,查看系统稳定性评分及崩溃记录。 如果您想了解Windows系统的运行状况和历史稳定性,可以通过内置的可靠性监视器来查看详细的系统事件和稳定性评分。该工具会记录应用程序崩溃、Windows故障、硬件驱动问题等信息,并以图表形式展示。 本文…

    2026年9月22日
    000

发表回复

登录后才能评论
关注微信