本文介绍了如何使用 Python 的 BeautifulSoup 库从 HTML 文档的特定元素中移除指定的标签。通过 select 方法定位目标标签,并利用 replace_with 或 extract 方法实现标签的移除,并使用 smooth() 方法清理文档,最终得到期望的 HTML 结构。本文提供清晰的代码示例,帮助开发者快速掌握该技巧。
BeautifulSoup 是一个强大的 Python 库,用于从 HTML 和 XML 文件中提取数据。在处理网页内容时,经常需要移除某些特定的 HTML 标签,例如 标签。本文将详细介绍如何使用 BeautifulSoup 从指定元素的子元素中移除特定的标签。
方法详解
以下步骤展示了如何从
标签中移除 标签:
立即学习“前端免费学习笔记(深入)”;
导入 BeautifulSoup 库:
首先,需要导入 BeautifulSoup 库。
from bs4 import BeautifulSoup
解析 HTML:
使用 BeautifulSoup 解析 HTML 文本。
html_text = """text 1 to keeptext 1 to removeand keep this too.
text 2 to keeptext 2 to removeand keep this too.
"""soup = BeautifulSoup(html_text, "html.parser")定位目标标签:
使用 soup.select(“p span”) 方法定位所有
标签下的 标签。 select() 方法使用 CSS 选择器,可以方便地定位到文档中的特定元素。
for span in soup.select("p span"): # 对每个 span 标签进行处理移除标签:
有两种方法可以移除标签:
replace_with(): 将标签替换为指定的内容。 例如,可以使用空格替换 标签,从而保留标签内的文本内容。
span.replace_with(" ")extract(): 直接从文档树中移除标签。 使用 extract() 会彻底删除标签及其内容。
span.extract()清理文档:
使用 soup.smooth() 方法清理文档,确保 HTML 结构正确。这个方法可以合并相邻的文本节点,使文档更加规范。
soup.smooth()输出结果:
使用 soup.prettify() 方法格式化输出 HTML。
print(soup.prettify())完整代码示例
from bs4 import BeautifulSouphtml_text = """text 1 to keeptext 1 to removeand keep this too.
text 2 to keeptext 2 to removeand keep this too.
"""soup = BeautifulSoup(html_text, "html.parser")for span in soup.select("p span"): span.replace_with(" ") # 或者 span.extract()soup.smooth()print(soup.prettify())注意事项
replace_with() 和 extract() 方法都会修改原始的 BeautifulSoup 对象。select() 方法返回的是一个列表,需要遍历列表才能处理每个标签。smooth() 方法可以优化 HTML 结构,但并非总是必需的。
总结
本文介绍了使用 BeautifulSoup 从 HTML 元素中移除特定标签的方法。通过 select 方法定位目标标签,并利用 replace_with 或 extract 方法实现标签的移除。根据实际需求选择合适的方法,可以灵活地处理 HTML 文档,提取所需的信息。
以上就是使用 BeautifulSoup 从 HTML 元素中移除特定标签的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1370674.html赞 (0)打赏微信扫一扫
支付宝扫一扫
关于作者

相关推荐
参加PHP+MySQL就业培训后能获得的岗位有哪些
参加php+mysql就业培训后,你可以获得以下岗位:1. web开发工程师,利用php和mysql开发动态网站和web应用程序;2. 后端开发工程师,使用php构建后端服务和api;3. 全栈开发工程师,结合前端技术进行全站开发;4. 数据库管理员,负责mysql数据库的设计、优化和维护;5. 软…
Debian OpenSSL的依赖关系是什么

在Debian系统中,OpenSSL的依赖关系涵盖系统库、开发工具以及一些可选组件。 本文将详细阐述这些依赖项,并提供安装建议。 核心依赖: C标准库 (libc6): OpenSSL依赖C标准库才能正常运行。 OpenSSL开发库 (libssl-dev): 包含OpenSSL的头文件和静态库,用…
[python]windows上通过whl文件安装triton模块
在windows系统中,使用.whl文件安装triton是一个简单且高效的方法。以下是完整的操作流程说明: 一、检查系统配置 Python版本:首先确认已安装Python,并确保其版本与你要安装的Triton .whl 文件兼容。例如,若下载的是triton-2.0.0-cp310-cp310-wi…
FineReport与.NET集成要点
1、FineReport(FR)与.NET项目的集成主要涵盖三个核心部分,如上图所示。 2、报表发布是集成过程中的关键步骤之一。 3、需要注意的是,FR报表工程本质上是基于Java的Servlet应用,无法由IIS直接解析处理,因此必须将其部署在支持Servlet规范的Web应用服务器(如Tomca…
利用AWS Pinpoint高效发送注册验证码(OTP)教程
本文旨在指导开发者如何高效利用AWS Pinpoint服务发送用户注册验证码(OTP),解决传统AWS SNS在处理动态、未预注册手机号时的局限性。我们将深入探讨Pinpoint作为首选方案的优势,提供具体实现步骤和代码示例,并分享最佳实践,确保OTP消息的可靠、快速送达。 理解注册验证码(OTP)…
consul怎么在windows下安装
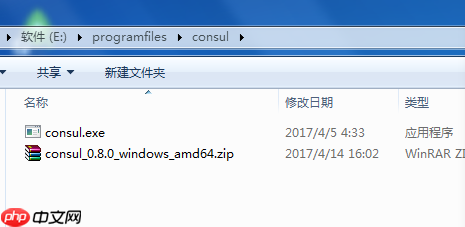
1.去官网下载:https://www.consul.io/downloads.html 2.解压: 3.设置环境变量:path添加 E:programfilesconsul; 4.cmd启动: consul agent -dev 帮衣帮-AI服装设计 AI服装设计神器,AI生成印花、虚拟试衣、面料…
sublime怎么让不同类型文件使用不同的缩进设置 _sublime不同文件缩进设置方法
Sublime Text 可根据不同文件类型自动应用缩进设置,通过语法专属配置实现。1. 打开文件后点击右下角语法名称,选择 Open Syntax Specific Settings;2. 在配置文件中设置 tab_size 和 translate_tabs_to_spaces,如 Python …
sublime的goto symbol in project功能怎么用_sublime Goto Symbol in Project使用方法
使用快捷键Ctrl+Shift+R(Win/Linux)或Cmd+Shift+R(Mac)可快速调用Goto Symbol in Project功能,通过搜索符号名称跳转到函数、类等定义位置,支持模糊匹配与实时过滤,需确保项目已添加至侧边栏且语法包正确安装以保证索引识别效果。 Sublime Tex…
Debian Context支持哪些编程语言
Debian Linux系统并非直接“支持”特定编程语言,而是提供了一个运行各种编程语言的理想环境。以下列举几种在Debian上广泛使用的编程语言及其应用场景: 主流编程语言及应用 Python: 以其简洁的语法和强大的功能著称,广泛应用于数据科学、Web开发、自动化运维等领域。丰富的第三方库使其成…
【新手入门】使用ERNIE-4.5-0.3B-Paddle从原始文本构建知识图谱
1. 概述 本文将探讨如何使用ernie-4.5-0.3b-paddle模型从原始文本构建知识图谱。通过结合大语言模型(llm)和检索增强生成(rag)技术实现文本生成,帮助我们从非结构化数据中高效提取实体和关系信息。 2. 什么是知识图谱? 2.1 基本概念 知识图谱是一种语义网络,它表示和连接现…
mysql增删改查语句在哪写
MySQL 增刪改查語句通常寫在以下位置:SQL 客户端(例如 MySQL Workbench)程式碼中外部檔案儲存程序 MySQL 增刪改查語句在哪裡寫? MySQL 增刪改查語句通常寫在以下位置: 1. SQL 客户端 例如,MySQL Workbench、phpMyAdmin 或命令行界面 (…
sublime怎么安装和使用DocBlockr插件_sublime使用DocBlockr生成注释的教程
安装DocBlockr插件:通过Package Control搜索并安装DocBlockr;2. 使用方法:在函数上方输入/**后回车,自动生成含参数、返回值的注释块;3. 配置优化:可设置快捷键、自定义模板及扩展语言支持,提升注释效率。 在Sublime Text中安装和使用DocBlockr插件…
ChatGPT是否支持自动补全代码 开发模式下的智能提示与生成能力

本文将探讨广泛关注的焦点:ChatGPT作为一款强大的语言模型,在代码开发场景下是否具备类似传统集成开发环境(IDE)的自动补全功能,以及其在开发模式下的智能提示与代码生成能力。我们将通过解析ChatGPT的工作原理,说明其如何辅助开发者,并提供一些利用其智能能力提升开发效率的操作建议。了解这些,将…
WhisperLiveKit— 开源AI语音识别工具,支持说话人识别
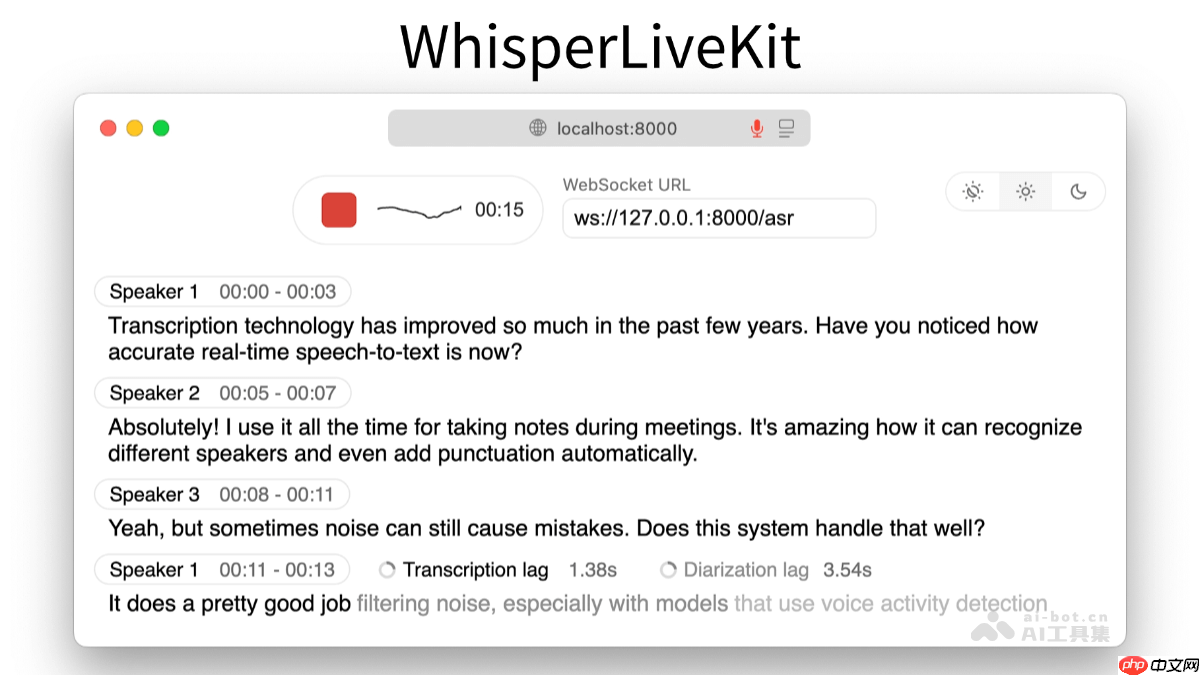
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 海螺语音 海螺AI推出的AI语音生成工具,支持多种语种、情绪和效果。 94 查看详情 WhisperLiveKit是什么 whisperlivekit 是一款开源的实时语音识别解决方案,能够将语…
sublime怎么在侧边栏中直接新建文件和文件夹_sublime侧边栏添加文件夹的操作方法
在Sublime Text中侧边栏可通过右键菜单新建文件或文件夹:1. 右键目标目录选New File并输入名称即可创建文件;2. 同样操作选New Folder可创建文件夹;3. 确保侧边栏可见且已添加项目,使用Ctrl+K, Ctrl+B切换显示,通过File→Add Folder to Pro…
sublime如何给代码添加注释 _sublime代码注释技巧
Sublime Text中注释操作统一高效:1. 使用Ctrl+/(Cmd+/)添加单行或多行注释,Ctrl+Shift+/(Cmd+Shift+/)添加块注释;2. 自动识别语言语法生成对应注释符号(如//、#、等);3. 可通过Package Control安装DocBlockr、Comment…
360极速浏览器和Chrome哪个更好用_360极速浏览器与Chrome浏览器对比评测
360极速浏览器在兼容旧版网站、内存优化和本地化功能上占优,适合需要访问网银等特殊场景的国内用户;Chrome则凭借V8引擎性能、成熟的扩展生态和跨平台同步能力,在现代网页体验与隐私安全方面表现更佳。两者均基于Chromium内核,但在IE兼容模式、广告拦截集成度、资源占用控制及账户体系设计上存在差…
mysql如何读取数据库数据
MySQL 读取数据库数据有两种常用方法:SELECT 语句,用于从表中提取数据,语法为:SELECT [列名] FROM [表名] [条件] [分组] [条件] [排序] [限制]。fetchall() 方法,用于将所有结果行存储在一个元组列表中。 MySQL 读取数据库数据 MySQL 提供了多…
悟空浏览器如何屏蔽图片加载_悟空浏览器无图模式开启方法
1、可通过设置菜单开启无图模式,进入浏览器设置后启用“节省流量”功能;2、可临时切换当前页面为无图浏览,点击底部操作栏的“省流模式”按钮实现快速切换;3、高级用户能通过自定义脚本,在用户脚本管理中添加CSS代码隐藏所有图片。 如果您在使用悟空浏览器时希望减少数据流量消耗或提升网页加载速度,可以选择关…
sublime如何高亮vue文件语法 _sublime Vue语法高亮方法
安装Vue Syntax Highlight插件可让Sublime Text正确高亮.vue文件,支持template、script和style区块的语法着色,提升编辑体验。 要让 Sublime Text 正确高亮 Vue 文件语法,关键是将 .vue 文件识别为支持的语法格式。Vue 单文件组件…