Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
PyTorch多进程共享内存溢出:深度解析与管理策略_创想鸟

PyTorch多进程共享内存溢出:深度解析与管理策略

PyTorch多进程共享内存溢出:深度解析与管理策略

PyTorch在多进程并行处理数据时,可能导致/dev/shm目录下的torch_shm_文件大量堆积,最终引发共享内存溢出和程序崩溃。本文将深入探讨PyTorch共享内存机制,分析问题成因,并提供系统重启、安全手动清理的注意事项,以及更深层次的优化数据传输和进程生命周期管理等策略,旨在帮助开发者有效解决和预防此类问题。

理解PyTorch共享内存机制

pytorch为了高效地在不同进程间共享张量数据,利用了操作系统提供的共享内存机制。当一个张量被创建并设置为可共享时,其底层数据会被存储在共享内存区域。在linux系统中,这通常表现为在/dev/shm(共享内存文件系统)下创建以torch_shm_为前缀的临时文件或目录。

当使用torch.multiprocessing模块(特别是Pool)进行并行计算时,如果子进程返回的张量或包含张量的对象需要被主进程接收,PyTorch会尝试通过共享内存来避免昂贵的数据拷贝。torch.multiprocessing.set_sharing_strategy(“file_system”)策略指示PyTorch使用文件系统作为共享内存的后端,这对于处理大量张量或避免文件描述符限制非常有用,但同时也增加了对/dev/shm空间的需求。

问题情景分析与代码示例

在并行处理大量数据时,开发者可能会遇到PyTorch多进程导致共享内存溢出的问题。具体表现为,当处理的数据点达到一定数量后,程序因无法分配更多共享内存而崩溃。通过检查/dev/shm目录,会发现大量未被清理的torch_shm_文件持续堆积。即使尝试了分块处理、为每个分块创建新的Pool对象以及显式删除返回结果,问题可能依然存在。

以下是一个典型的代码示例,展示了可能导致共享内存溢出的场景:

import torchimport torch.multiprocessing as mpfrom glob import globimport osimport time# 由于操作系统文件描述符限制,通常需要使用 "file_system" 策略mp.set_sharing_strategy("file_system")def processData(fname):    """    模拟数据处理函数,从文件中读取数据并生成一个张量列表。    这里的张量会被共享给主进程。    """    # 实际场景中,这里会进行复杂的张量操作    # 示例:创建一个包含5个随机张量的列表    return [torch.randn(100, 100, dtype=torch.float32) for _ in range(5)]if __name__ == "__main__":    # 设置启动方法为 'spawn',确保跨平台兼容性和安全性    # force=True 可以在脚本多次运行时避免重复设置的错误    mp.set_start_method("spawn", force=True)    # 替换为实际的数据目录,例如创建一个虚拟目录和文件    # for i in range(20000):    #     with open(f"/tmp/data/file_{i}.txt", "w") as f:    #         f.write(f"data for file {i}")    datadir = "/path/to/your/data/directory" # 请替换为实际路径    processedData = []    print(f"程序启动时 /dev/shm 中的 torch_shm_ 文件数量: {len([f for f in os.listdir('/dev/shm') if f.startswith('torch_shm_')])}")    # 创建一个进程池    with mp.Pool(processes=8) as pool: # 使用 with 语句确保进程池被正确关闭        file_paths = glob(datadir + "/*.txt")        print(f"发现 {len(file_paths)} 个文件待处理。")        # 使用 imap_unordered 异步获取结果        for i, result_list in enumerate(pool.imap_unordered(processData, file_paths)):            processedData.extend(result_list)            # 定期检查 /dev/shm 状态            if (i + 1) % 100 == 0:                shm_files_count = len([f for f in os.listdir('/dev/shm') if f.startswith('torch_shm_')])                print(f"已处理 {i+1} 个文件,当前 /dev/shm 中的 torch_shm_ 文件数量: {shm_files_count}")                # 可以在这里添加检查,如果文件数量异常,则提前退出或记录警告    # 进程池在 with 语句结束后会自动 close 和 join    shm_files_count_final = len([f for f in os.listdir('/dev/shm') if f.startswith('torch_shm_')])    print(f"所有文件处理完毕后 /dev/shm 中的 torch_shm_ 文件数量: {shm_files_count_final}")    # 此时 processedData 列表中包含了所有子进程返回的张量    # 如果这些张量不被及时清理,其对应的共享内存区域将持续占用    # 显式解除引用,有助于垃圾回收    del processedData    # 强制进行Python垃圾回收,但这不直接作用于共享内存文件    import gc    gc.collect()    # 再次检查,看是否有变化 (通常不会立即清理共享内存文件)    shm_files_count_after_del = len([f for f in os.listdir('/dev/shm') if f.startswith('torch_shm_')])    print(f"显式删除引用后 /dev/shm 中的 torch_shm_ 文件数量: {shm_files_count_after_del}")

尽管代码中使用了mp.Pool的with语句(或显式的pool.close()和pool.join())来确保进程池被正确关闭,但共享内存文件可能并未及时清理。这通常是因为PyTorch的共享内存管理器在某些情况下未能及时回收资源,或者主进程仍然持有对这些共享内存区域的隐式引用。

共享内存溢出排查与诊断

要诊断共享内存溢出问题,最直接且有效的方法是监控/dev/shm目录。在Linux终端中,可以使用以下命令:

ls -l /dev/shm | grep torch_shm_ | wc -l

该命令会统计当前/dev/shm目录下以torch_shm_开头的文件的数量。在程序运行期间定期执行此命令,可以观察文件数量是否持续增长。如果文件数量快速增加且不下降,则强烈表明存在共享内存泄漏。

此外,还可以使用df -h /dev/shm命令来查看/dev/shm文件系统的实际使用情况,判断是否接近满载。

现有解决方案与注意事项

当遇到PyTorch多进程共享内存溢出时,可以考虑以下解决方案,并注意其局限性和潜在风险。

1. 系统重启

最直接有效的临时解决方案是重启操作系统或计算环境。系统重启会清空/dev/shm目录,从而释放所有被占用的共享内存资源。

优点: 简单、彻底,能够快速解决当前的内存溢出问题。局限性: 这种方法在开发和测试阶段可行,但在生产环境或需要长时间运行、高可用性的任务中显然不切实际。它治标不治本,不能解决根本的内存管理问题。

2. 手动清理的风险

理论上,可以通过手动删除/dev/shm目录下的torch_shm_文件来释放空间。例如,使用以下命令:

sudo rm -rf /dev/shm/torch_shm_*

严重警告: 直接在/dev或/dev/shm目录下使用rm -rf命令是极其危险的操作。如果命令中不慎出现空格(例如rm -rf torch *),可能导致删除/dev目录下所有文件,甚至整个文件系统,造成不可逆的数据丢失和系统损坏。此外,如果程序正在运行并依赖这些共享内存文件,强行删除可能导致程序崩溃或数据损坏。因此,强烈不建议在生产环境或不熟悉系统操作的情况下执行此类命令。即使要手动清理,也应精确指定路径和前缀,并仔细检查命令,且仅在确认没有PyTorch进程正在使用这些文件时进行。

PyTorch共享内存管理策略探讨

为了从根本上解决或缓解PyTorch多进程共享内存溢出问题,需要深入理解并优化共享内存的使用方式。

1. 优化数据传输

减少共享张量数量: 仔细检查processData函数返回的数据。如果返回的是大量小型张量列表,每个张量都可能在共享内存中创建独立的区域。考虑是否可以:

合并张量: 将多个小张量合并成一个大张量返回,减少共享内存对象的数量。内部处理,只返回结果: 在子进程内部完成大部分处理,只返回最终的、聚合的结果(例如,标量、小列表、或经过降维的张量),而非原始张量或中间计算结果。序列化传输: 如果数据量巨大且不适合共享内存,可以考虑将子进程处理后的数据序列化(例如,使用pickle、numpy.save、torch.save),然后通过队列或文件传输序列化数据的路径,在主进程中反序列化加载。这会增加CPU开销,但能避免共享内存问题。

显式管理张量生命周期: 尽管PyTorch的共享内存管理器会尝试清理,但如果主进程对子进程返回的张量(或包含它们的列表)保持引用,这些共享内存区域就不会被释放。确保在不再需要时,显式地解除对这些张量的引用,让Python的垃圾回收机制有机会清理它们。例如,可以定期将processedData列表中的数据持久化到磁盘,然后清空列表,或者在处理完一批数据后,使用del关键字显式删除不再需要的张量引用。

# 示例:定期清理 processedData 列表batch_size = 1000for i, result_list in enumerate(pool.imap_unordered(processData, file_paths)):    processedData.extend(result_list)    if (i + 1) % batch_size == 0:        # 在这里可以将 processedData 写入磁盘或进行其他聚合操作        # 然后清空列表,解除对张量的引用        del processedData[:] # 清空列表内容        print(f"已处理 {i+1} 个文件,并清空 processedData 列表。")

2. 进程生命周期管理

确保进程池正确关闭: 使用with mp.Pool(…) as pool:语句是管理进程池生命周期的最佳实践。它确保了在代码块结束时,无论是否发生异常,进程池都会被正确关闭(close())并等待所有子进程完成(join()),从而允许PyTorch有机会清理它们持有的共享内存资源。**分

以上就是PyTorch多进程共享内存溢出:深度解析与管理策略的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1370782.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
使用 Pandas 进行 DataFrame 重塑:从长表到宽表
上一篇 2025年12月14日 10:50:40
使用SciPy解决列表子集和问题:基于Knapsack算法的优化裁剪策略
下一篇 2025年12月14日 10:50:55

相关推荐

  • MySQL数据备份自动化实施_MySQL定时任务与脚本管理

    MySQL数据备份自动化实施_MySQL定时任务与脚本管理MySQL数据备份自动化实施_MySQL定时任务与脚本管理MySQL数据备份自动化实施_MySQL定时任务与脚本管理MySQL数据备份自动化实施_MySQL定时任务与脚本管理

    mysql数据备份的自动化实施核心在于结合mysqldump等工具与操作系统的定时任务(如linux的cron或windows的task scheduler),通过编写和管理脚本实现定期执行备份。1. 使用mysqldump作为基础工具,编写包含数据库连接信息、时间戳文件名、日志记录、压缩清理等功能…

    2026年9月21日 • 用户投稿
    100
  • 如何设置Linux软件包更新排除 yum exclude和apt-mark hold

    如何设置Linux软件包更新排除 yum exclude和apt-mark hold如何设置Linux软件包更新排除 yum exclude和apt-mark hold如何设置Linux软件包更新排除 yum exclude和apt-mark hold如何设置Linux软件包更新排除 yum exclude和apt-mark hold

    要阻止linux系统中特定软件包更新,可针对不同发行版使用相应方法。对于rhel/centos系系统,可通过在/etc/yum.conf或.repo文件中添加exclude=包名来排除升级;对于debian/ubuntu系系统,则使用sudo apt-mark hold 包名命令锁定版本。这两种方式…

    2026年9月21日 • 用户投稿
    400
  • MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能

    MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能

    mysql热点数据缓存的核心在于将频繁访问的数据保留在内存中以减少磁盘i/o,提升查询速度并缓解数据库压力。1. innodb缓冲池是关键机制,需合理配置其大小(通常为服务器内存的70-80%)及实例数以优化性能;2. 应用层缓存如redis/memcached通过前置缓存逻辑减少对mysql的直接…

    2026年9月21日 • 用户投稿
    000
  • 如何在Krita导出AI生成的8K艺术图片?保存超高清图像方法

    答案是优先选择PNG格式导出8K AI艺术作品,确保画布为8K分辨率,嵌入sRGB色彩配置文件,并优化系统内存与硬盘性能以提升Krita处理效率。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在Krita中导出AI生成的8K艺术图片,核心…

    2026年9月21日
    100
  • Laravel 8 登录后重定向到仪表盘的完整教程

    本教程详细介绍了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种方法。我们将探讨如何利用 Laravel 内置的 $redirectTo 属性,以及如何通过重写 LoginController 中的 login 方法来实现自定义重定向逻辑。此外,教程还将重点讲解正确的路由配置和中间件使用…

    2026年9月21日
    000
  • 《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表

    《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表

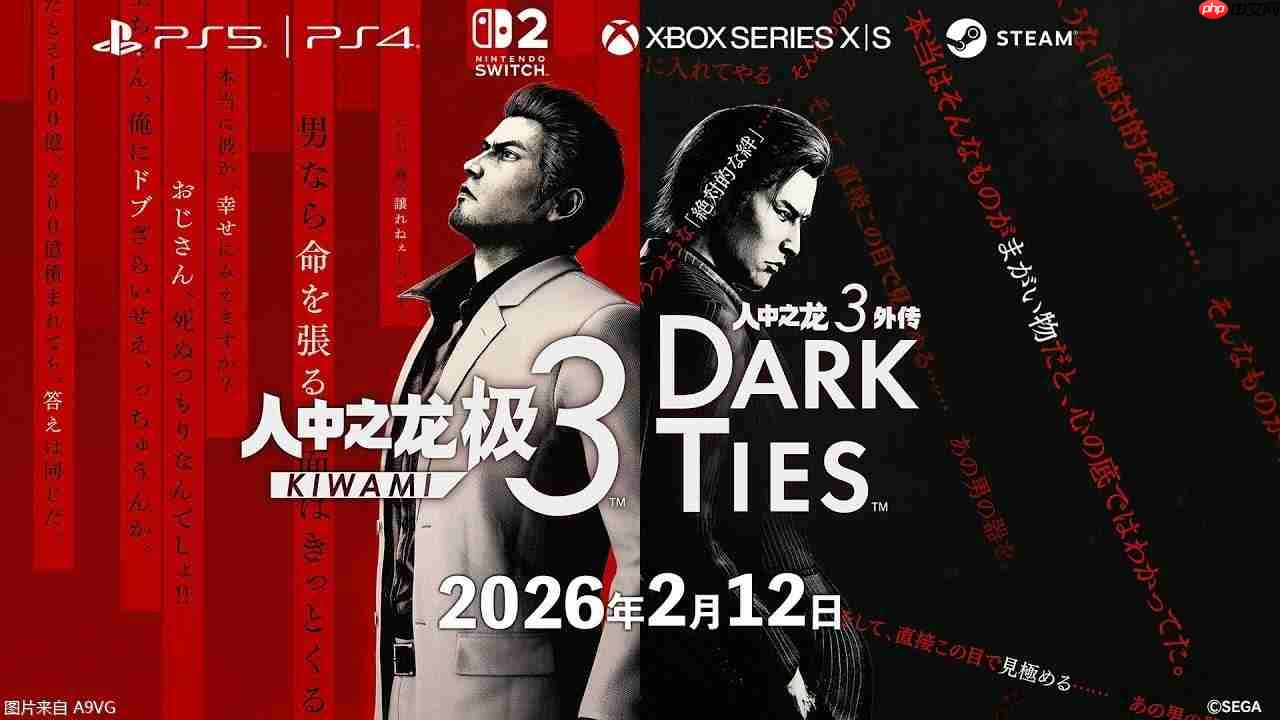
    世嘉公开《如龙极3/如龙3外传  dark ties》官方中文版预告宣传片,将于2026年2月12日发售 ​​​​,登陆ps5/ps4/switch2/xbox/pc平台,全球同步推出。 ​​​ 在2009年于PS3平台发售的《如龙3》焕然重生,为您打造“极致体验”。鲜活真实的冲绳街景、震撼力升级的…

    2026年9月21日 • 用户投稿
    000
  • safari浏览器怎么把标签页固定在最左边_safari浏览器标签页固定最左设置

    Safari可通过“固定标签”功能将常用网页保持在标签栏最左并随启动恢复;2. 手动拖动标签至最左可临时调整顺序但不永久保存;3. 结合书签栏添加常用网站并固定标签,可提升访问效率。 如果您希望在使用 Safari 浏览器时将常用网页始终保持在标签栏的最左侧位置,以便快速访问,可以通过以下方法实现标…

    2026年9月21日
    000
  • 如何用Animoto制作AI营销视频?快速生成商业AI视频的教程

    如何用Animoto制作AI营销视频?快速生成商业AI视频的教程如何用Animoto制作AI营销视频?快速生成商业AI视频的教程如何用Animoto制作AI营销视频?快速生成商业AI视频的教程如何用Animoto制作AI营销视频?快速生成商业AI视频的教程

    Animoto通过模板与拖放功能,结合AI生成的文案和配音,帮助用户快速制作品牌统一、节奏合理、带明确CTA的高效营销视频,适用于多平台推广。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Animoto是一个非常适合快速制作AI营销视频的…

    2026年9月21日 • 用户投稿
    000
  • 使用本地HTML文件运行JavaScript脚本失败的原因及解决方案

    本文旨在帮助开发者理解在没有Web服务器的情况下,直接通过浏览器打开本地HTML文件时,JavaScript脚本可能无法正常运行的原因,并提供相应的解决方案。文章将深入探讨浏览器安全策略、相对路径问题以及如何正确引入和执行JavaScript脚本,确保你的HTML、CSS和JavaScript代码能…

    2026年9月21日
    000
  • mac怎么使用磁盘工具_mac磁盘工具使用教程

    使用磁盘工具可解决Mac外接存储问题。1. 打开磁盘工具,选择设备后点击“急救”扫描修复错误;2. 通过“抹掉”功能将设备格式化为APFS或Mac OS扩展以提升兼容性;3. 利用“分区”功能划分硬盘为多个宗卷,便于数据管理;4. 创建空白磁盘映像用于备份,或恢复.dmg文件至U盘制作启动盘。 如果…

    2026年9月21日
    100
  • VSCode怎么看效果_VSCode实时预览和调试代码运行效果教程

    VSCode通过实时预览扩展和内置调试器实现代码效果查看。使用Live Server可实时预览前端页面,保存即刷新;Markdown文件支持侧边预览。调试功能需配置launch.json,支持Node.js、Python、浏览器端JavaScript等,通过断点、变量监视、调用堆栈等深入分析代码执行…

    2026年9月21日
    000
  • 使用正则表达式检测字符串中的除零操作

    本文详细介绍了如何使用正则表达式精确检测字符串中潜在的除零操作。针对表达式中可能存在的变量引用(如<>)、数字、多余空格以及禁止包含引号等复杂情况,文章提供了一个高效的正则表达式模式,并深入解析其构成原理。通过具体的Java代码示例,读者将学习如何将此模式应用于实际编程场景,从而有效识别…

    2026年9月21日
    000
  • AI钉钉1.0联动雅里数科 共探“酒旅+AI”的工作新范式

    在数字化浪潮席卷全球的当下,人工智能正以前所未有的速度重塑各行各业,酒旅产业也正在迎来由ai驱动的深刻变革。10月11日,阿里巴巴钉钉再度走进雅里数科集团,开启一场关于“酒旅行业ai原生工作方式”的深度对话。此次交流标志着双方合作迈入全新阶段,致力于共同探索ai原生工作范式,引领酒旅行业迈向智能化发…

    2026年9月21日
    100
  • 如何检测Linux网络接口DMA状态 硬件加速功能验证

    如何检测Linux网络接口DMA状态 硬件加速功能验证如何检测Linux网络接口DMA状态 硬件加速功能验证如何检测Linux网络接口DMA状态 硬件加速功能验证如何检测Linux网络接口DMA状态 硬件加速功能验证

    可通过以下方法检测linux系统中网络接口dma状态和硬件加速是否启用:1.使用 ethtool -i eth0 和 ethtool -k eth0 查看驱动信息及sg、tso、ufo、gso功能是否启用;2.通过 cat /proc/interrupts 和 cat /proc/slabinfo …

    2026年9月21日 • 用户投稿
    800
  • 构建Spring自定义Kafka配置的注解式解决方案

    本文探讨了在Spring Boot应用中通过自定义注解实现Kafka配置自动化时遇到的挑战,特别是由于Bean注册时机不当导致的依赖注入失败。我们将深入分析问题根源,并提供两种核心解决方案:利用META-INF/spring.factories实现标准化的自动配置发现,以及通过ImportBeanD…

    2026年9月21日
    1100
  • 悟空浏览器开发者工具的控制台怎么用_悟空浏览器Console控制台使用入门教程

    首先启用悟空浏览器开发者工具并进入Console标签,可查看错误、警告等日志信息,通过过滤功能定位问题;支持执行JavaScript代码实时调试,监控网络请求失败及全局异常,还可清空或保存日志以便分析。 如果您在使用悟空浏览器进行网页开发或调试时,发现页面元素未按预期工作或脚本报错,则可以借助开发者…

    2026年9月21日
    700
  • 蝴蝶号无人直播中的AI角色控制技巧与注意事项

    蝴蝶号无人直播中的AI角色控制技巧与注意事项蝴蝶号无人直播中的AI角色控制技巧与注意事项蝴蝶号无人直播中的AI角色控制技巧与注意事项蝴蝶号无人直播中的AI角色控制技巧与注意事项

    要让蝴蝶号ai角色在直播中更具真实感和互动性,关键在于注入“人味儿”,打破“机器感”。首先,声音要有温度,选择有情感起伏的音色,并根据不同语境调整语调、语速,适当加入语气词增强亲切感;其次,确保视觉形象与行为模式统一,动作、表情、眼神与语音内容自然同步,强化人设一致性;第三,建立多层次互动逻辑,ai…

    2026年9月21日 • 用户投稿
    400
  • VSCode整个项目怎么导出_VSCode项目打包与导出为压缩文件的完整教程

    答案:导出VSCode项目可通过手动压缩、终端命令、插件或Git克隆实现,推荐使用终端命令排除node_modules并选择zip格式以兼顾兼容性与效率。 将VSCode整个项目导出,实际上就是将项目文件夹打包成一个压缩文件,方便备份、分享或迁移。下面介绍几种常见的打包导出方法。 解决方案: 手动压…

    2026年9月21日
    000
  • SpringBoot的定时任务

    SpringBoot的定时任务SpringBoot的定时任务SpringBoot的定时任务SpringBoot的定时任务

    大家好,我是你们的老朋友全栈君。我们又见面了。 一、基于注解(@Scheduled)的定时任务 使用SpringBoot的@Scheduled注解来创建定时任务非常简单,只需几行代码就能实现。然而,@Scheduled默认是单线程运行,这意味着当启动多个任务时,一个任务的执行时间可能会影响到下一个任…

    2026年9月21日 • 用户投稿
    400
  • 百度网盘官方网页登录 百度网盘网页版入口快捷

    百度网盘官方网页登录入口是https://pan.baidu.com,用户可直接访问该网址登录账号,主界面布局清晰,支持文件上传下载、智能检索、跨设备同步及在线预览等功能。 百度网盘官方网页登录入口在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来百度网盘网页版入口快捷方式,感兴趣的网友一起…

    2026年9月21日
    100

发表回复

登录后才能评论
关注微信