答案:Beautiful Soup通过解析HTML为结构化对象,结合find、find_all和select等方法高效定位元素,可与Selenium配合处理动态内容,并需注意编码、容错、性能及反爬策略。
Python使用Beautiful Soup解析HTML的核心在于,它能将复杂的HTML或XML文档转换成一个Python对象,这个对象结构化地表示了原始文档的各个部分,使得我们能够以非常直观和灵活的方式来搜索、导航和修改这些内容。在我看来,它就像一个专业的解剖师,把网页的骨架和肌肉都清晰地展现在你面前,让你能精准地找到任何你想抓取的信息。
解决方案
要用Beautiful Soup解析HTML,我们通常会遵循一套基本流程。这包括获取HTML内容、创建Beautiful Soup对象,然后利用其强大的方法来定位和提取数据。
import requestsfrom bs4 import BeautifulSoup# 假设我们要解析的HTML内容,实际项目中通常是从网络请求获取html_doc = """我的示例页面 """# 或者从一个URL获取HTML内容# try:# response = requests.get('http://example.com') # 替换成你要抓取的URL# response.raise_for_status() # 检查请求是否成功# html_doc = response.text# except requests.exceptions.RequestException as e:# print(f"请求失败: {e}")# exit()# 使用BeautifulSoup解析HTML# 'html.parser' 是Python内置的解析器,通常够用,但也可以选择 'lxml' 或 'html5lib'soup = BeautifulSoup(html_doc, 'html.parser')# 1. 查找第一个h1标签h1_tag = soup.find('h1')if h1_tag: print(f"第一个H1标签内容: {h1_tag.text}") # .text 获取标签内的文本# 2. 查找所有p标签p_tags = soup.find_all('p')print("n所有P标签内容:")for p in p_tags: print(p.text)# 3. 通过id查找元素container_div = soup.find(id='container')if container_div: print(f"nID为'container'的div内容: {container_div.h1.text} (只取h1)") # 可以链式查找# 4. 通过class查找元素intro_p = soup.find(class_='intro')if intro_p: print(f"nclass为'intro'的p标签内容: {intro_p.text}") # 提取strong标签内容 strong_tag = intro_p.find('strong') if strong_tag: print(f" 其中的strong标签内容: {strong_tag.text}")# 5. 查找所有链接及其href属性all_links = soup.find_all('a')print("n所有链接:")for link in all_links: print(f" 文本: {link.text}, URL: {link.get('href')}") # .get() 获取属性值# 6. 使用CSS选择器 (select方法)# 查找所有class为nav下的li标签nav_items = soup.select('ul.nav li')print("n导航列表项 (CSS选择器):")for item in nav_items: print(f" {item.text}")# 查找所有class为content下的p标签content_paragraphs = soup.select('div.content p')print("n内容段落 (CSS选择器):")for p in content_paragraphs: print(f" {p.text}")# 查找带有href属性的a标签href_links = soup.select('a[href]')print("n所有带href属性的链接:")for link in href_links: print(f" {link.get('href')}")
Beautiful Soup选择器有哪些?如何高效定位元素?
Beautiful Soup提供了多种灵活的选择器来定位HTML或XML文档中的元素,我个人觉得这是它最强大的地方之一。理解并善用这些选择器,能极大提升你抓取数据的效率和准确性。
最基础的,也是我们最常用的是
find()
和
find_all()
方法。
find()
用来查找第一个匹配的标签,而
find_all()
则返回所有匹配的标签列表。这两个方法可以接受多种参数:
- 标签名:
soup.find('div')会找到文档中第一个
标签。
soup.find_all('a')会找到所有
标签。
- 属性: 可以通过字典形式传递属性,比如
soup.find(id='container')
找到
id="container"
的元素,或者
soup.find_all('p', class_='intro')找到所有
class="intro"
的
标签。这里需要注意,
class
是Python的关键字,所以Beautiful Soup用
class_
来表示HTML的
class
属性。
- 文本内容:
soup.find_all(string='欢迎来到我的网站')
可以查找文本内容完全匹配的元素。
- 正则表达式: 如果你需要更复杂的匹配模式,可以传入正则表达式。例如,
soup.find_all(re.compile("^h"))会找到所有以 ‘h’ 开头的标签(如
,
).
更高级,也更现代的选择方式是
select()
方法,它允许你使用CSS选择器语法。如果你熟悉CSS,这简直就是福音。
select()
方法返回一个标签列表,就像
find_all()
一样。
- 标签选择器:
soup.select('h1')查找所有
标签。
- 类选择器:
soup.select('.intro')查找所有
class="intro"
的元素。
- ID选择器:
soup.select('#container')查找
id="container"
的元素。
- 属性选择器:
soup.select('a[href]')查找所有带有
href
属性的
标签。
soup.select('a[target="_blank"]')查找
target="_blank"
的
标签。
- 组合选择器: 这是CSS选择器的强大之处。
- 后代选择器:
soup.select('div.content p')查找所有在
class="content"
的
 内部的

 标签。
- 子元素选择器:
soup.select('ul.nav > li')查找
class="nav"
的
标签的直接子元素
。
- 兄弟选择器:
soup.select('h1 + p')查找紧跟在
后面的
标签。
在我看来,对于简单的、直接的查找,
find()
和
find_all()
配合标签名和属性字典已经足够高效。但当你的选择逻辑变得复杂,需要组合多种条件,或者想要模仿浏览器中CSS选择器的行为时,
select()
方法的优势就显现出来了。它能让你用一行代码完成原本可能需要多次
find()
或
find_all()
才能实现的复杂定位。熟练掌握CSS选择器,对于提升Beautiful Soup的使用效率至关重要。
解析动态加载的HTML内容,Beautiful Soup还能胜任吗?
这是一个非常实际且经常遇到的问题。坦白讲,Beautiful Soup本身是无法直接处理动态加载的HTML内容的。它的工作机制是接收一段静态的HTML字符串,然后对其进行解析。而所谓的“动态加载”,通常指的是网页通过JavaScript在浏览器加载完成后,才异步请求数据并渲染到页面上的内容。当你使用
requests
库去抓取这类页面时,你拿到的HTML通常是初始的、未执行JavaScript的骨架页面,那些JavaScript生成的内容根本就不在里面。
那么,是不是就束手无策了呢?当然不是。在这种情况下,Beautiful Soup通常会与一些能够模拟浏览器行为的工具结合使用。最常见的解决方案就是引入 Selenium。
Selenium是一个自动化测试工具,但它也能被用来进行网络爬虫。它的核心思想是启动一个真实的浏览器(比如Chrome或Firefox),然后通过代码控制这个浏览器去访问网页、等待页面加载、执行JavaScript,甚至模拟用户的点击、滚动等操作。一旦页面在浏览器中完全加载并渲染完毕,你就可以从Selenium控制的浏览器中获取到完整的、包含JavaScript渲染内容的HTML源码。
这个流程大致是这样的:
- 使用Selenium启动浏览器,并访问目标URL。
- 等待页面加载完成,或者等待特定的动态内容出现(可以使用Selenium的等待机制)。
- 从Selenium获取当前页面的HTML源码。这个源码就是经过JavaScript渲染后的最终HTML。
- 将获取到的HTML源码传递给Beautiful Soup,然后像处理静态HTML一样进行解析和数据提取。
下面是一个简化的代码示例,展示了如何将Selenium与Beautiful Soup结合:
from selenium import webdriverfrom selenium.webdriver.chrome.service import Servicefrom selenium.webdriver.common.by import Byfrom selenium.webdriver.support.ui import WebDriverWaitfrom selenium.webdriver.support import expected_conditions as ECfrom bs4 import BeautifulSoupimport time # 用于简单的等待# 配置Chrome WebDriver的路径# 请确保你已经下载了对应Chrome版本的ChromeDriver,并放在可执行路径或指定路径# 例如:service = Service('/path/to/chromedriver')# 如果你的ChromeDriver在系统PATH中,可以省略Servicedriver_path = 'path/to/chromedriver' # 替换为你的chromedriver路径service = Service(driver_path)# 启动Chrome浏览器 (无头模式,即不显示浏览器窗口)options = webdriver.ChromeOptions()options.add_argument('--headless') # 无头模式options.add_argument('--disable-gpu') # 禁用GPU加速,在无头模式下通常需要options.add_argument('--no-sandbox') # 解决一些Linux环境下的权限问题options.add_argument('--disable-dev-shm-usage') # 解决Docker等环境下的内存问题driver = webdriver.Chrome(service=service, options=options)url = 'http://example.com/dynamic_page' # 替换为实际的动态加载页面URLtry: driver.get(url) # 显式等待,直到某个元素(比如ID为'dynamic-content'的div)出现 # 这比简单的time.sleep()更健壮 WebDriverWait(driver, 10).until( EC.presence_of_element_located((By.ID, 'dynamic-content')) ) # 获取页面渲染后的HTML rendered_html = driver.page_source # 将HTML传递给Beautiful Soup进行解析 soup = BeautifulSoup(rendered_html, 'html.parser') # 现在你可以像解析静态HTML一样处理soup对象了 dynamic_div = soup.find(id='dynamic-content') if dynamic_div: print(f"动态加载内容: {dynamic_div.text.strip()}") else: print("未找到动态内容元素。")except Exception as e: print(f"在Selenium操作中发生错误: {e}")finally: # 无论如何都要关闭浏览器 driver.quit()虽然Selenium引入了额外的复杂性和资源消耗(因为它要启动一个完整的浏览器),但对于那些重度依赖JavaScript渲染内容的网站,这几乎是不可避免的解决方案。Beautiful Soup在这里扮演的角色,就是对Selenium获取到的“最终形态”的HTML进行高效的结构化解析,它俩是很好的搭档。
实际项目中,Beautiful Soup解析常见陷阱与优化策略
在实际的Web抓取项目中,即使Beautiful Soup再好用,也总会遇到一些意料之外的“坑”,以及一些可以提升效率和健壮性的优化点。在我看来,这些经验比单纯的代码示例更具价值。
编码问题 (Encoding Issues):
- 陷阱: 最常见的问题之一就是编码错误,尤其是
UnicodeEncodeError
或
UnicodeDecodeError
。当你从
requests.get().text
获取内容时,requests会尝试根据HTTP响应头猜测编码。但如果猜测错误,或者响应头未明确指定编码,你就会得到乱码。
- 策略:
- 明确指定编码: 最好的方法是在
requests
获取内容后,手动设置
response.encoding
。例如,
response.encoding = 'utf-8'
或
response.encoding = response.apparent_encoding
(requests会根据内容猜测)。
- Beautiful Soup解析时指定:
BeautifulSoup(html_doc, 'html.parser', from_encoding='utf-8')
也可以尝试,但通常在
requests
层面处理更好。
-
response.content
:
requests.get().content
返回的是字节流,你可以先获取字节流,然后手动解码:
html_doc = response.content.decode('utf-8', errors='ignore')。
errors='ignore'
可以跳过无法解码的字符,防止程序崩溃,但可能会丢失部分信息。
-
HTML结构不规范或残缺:
- 陷阱: 真实世界的HTML往往不如教程中的示例那么完美,可能存在标签未闭合、属性缺失引号等问题。
- 策略: Beautiful Soup在这方面其实做得很好,它能处理大部分不规范的HTML。但你可以通过选择不同的解析器来优化:
-
html.parser
(默认):
Python内置,速度适中,容错性尚可。 -
lxml
:
需要额外安装pip install lxml
。速度最快,容错性好,但对不规范HTML的处理有时会比较严格。
-
html5lib
:
需要额外安装pip install html5lib
。最严格地遵循HTML5规范,即使是最糟糕的HTML也能解析成正确的树形结构,但速度最慢。
- 选择建议: 通常我推荐优先使用
lxml
,因为它速度快且功能强大。如果遇到
lxml
无法处理的极端情况,再尝试
html5lib
。
-
元素不存在时的错误处理:
-
陷阱: 当你尝试
soup.find('div').text而
find('div')返回
None
时,会抛出
AttributeError: 'NoneType' object has no attribute 'text'
。
-
策略: 始终检查
find()
或
select()
的结果是否为
None
或空列表。
element = soup.find('nonexistent_tag')if element: print(element.text)else: print("元素未找到。")# 对于select,返回的是列表elements = soup.select('nonexistent_selector')if elements: for el in elements: print(el.text)else: print("元素列表为空。")这种防御性编程能让你的爬虫更加健壮,不会因为某个页面结构略有不同就崩溃。
-
性能优化:
- 陷阱: 在处理大量HTML文档或非常大的HTML文件时,解析速度可能会成为瓶颈。
- 策略:
- 使用
lxml
解析器:
这是最直接有效的性能提升手段,lxml
比
html.parser
快很多。
- 避免不必要的
find_all
:
如果你只需要一个元素,使用find()
而不是
find_all()
然后取第一个。
- 缩小搜索范围: 如果你知道某个元素在文档的某个特定部分,先找到那个部分,再在其内部进行搜索。例如,
container_div = soup.find(id='container'); if container_div: inner_p = container_div.find('p')这样比直接
soup.find('p')效率更高,因为搜索范围缩小了。
- 缓存请求: 对于重复访问的URL,考虑使用
requests-cache
等库来缓存HTTP请求,减少网络延迟和服务器负载。
-
伦理与反爬虫:
- 陷阱: 虽然这不是Beautiful Soup本身的问题,但在实际项目中,频繁或过快的请求可能触发网站的反爬虫机制,导致IP被封禁或数据抓取失败。
- 策略:
- 遵守
robots.txt
:
在抓取前检查网站的robots.txt
文件,了解哪些路径允许抓取,哪些不允许。
- 设置请求间隔: 使用
time.sleep()
在每次请求之间加入随机延迟,模拟人类浏览行为。
- 设置User-Agent: 伪装成常见的浏览器User-Agent,避免被识别为爬虫。
- 使用代理IP: 当IP被封禁时,通过代理IP轮换来继续抓取。
这些陷阱和策略,说实话,很多都是在实际操作中踩坑后总结出来的。它们能帮助你写出更稳定、更高效、更“友好”的爬虫程序。

以上就是Python怎么用Beautiful Soup解析HTML_Beautiful Soup HTML解析实战教程的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1371310.html
- 遵守
- 使用
-
-
- 明确指定编码: 最好的方法是在
赞 (0)打赏 微信扫一扫
 支付宝扫一扫
- 子元素选择器:
- 后代选择器:
关于作者

相关推荐
-
sublime怎么配置eslint进行js校验_sublime集成ESLint代码检查配置


首先安装SublimeLinter和SublimeLinter-eslint插件,确保系统或项目中已安装ESLint;通过npx eslint –init生成配置文件;插件会自动调用项目内的eslint,若未识别可手动设置executable路径;保存JavaScript文件时即可实时显…
-
PHP文件引入时参数传递机制详解与最佳实践
在php中,直接通过url查询字符串方式向`require`或`include`引入的文件传递参数是无效的,这会导致“未定义变量”错误。本文将深入探讨php文件引入的原理,并提供三种正确的参数传递方法:利用作用域共享、手动填充`$_get`数组,以及推荐的通过函数或类进行封装,旨在帮助开发者构建更健…
-
Safari浏览器怎么查看网页源代码_Safari浏览器网页HTML源代码查看方式
首先启用Safari开发菜单,然后通过菜单命令或快捷键Option+Command+U查看完整HTML源代码;也可右键选择检查元素,使用Web检查器查看特定区域的DOM结构与样式信息。 如果您在浏览网页时需要检查页面的结构或调试内容,查看网页源代码是一个常用的方法。Safari浏览器提供了多种方式来…
-
Java 8 使用 Stream API 扁平化嵌套 Map 并提取首个元素

本文将详细介绍如何使用 Java 8 的 Stream API 将一个嵌套的 Map 结构进行扁平化处理,并从中提取所需的数据。 具体来说,我们将把 Map<Integer, Map<String, List>> 转换为 Map,其中新 Map 的键是原内部 Map 的键,值…
-
Chrome浏览器怎么禁止图片和视频自动加载_网页媒体内容自动加载禁用教程

可通过设置阻止Chrome自动加载媒体。①针对特定网站:点击地址栏锁形图标→网站设置→将“自动播放”设为不允许;②全局禁用:进入chrome://settings/content→自动播放→设为默认不允许;③使用扩展如uBlock Origin拦截媒体加载;④启用Lite模式以节省数据并延迟媒体加载…
-
修改 Android KeyStore 中 KeyPair 的用途
本文档介绍了如何在 Android KeyStore 中修改现有 KeyPair 的用途,使其支持密钥协商 (Key Agreement) 操作。通过示例代码展示了如何利用 KeyStore.setEntry 方法在 Android 13 (API 33) 及以上版本中导入 KeyPair 并设置所…
-
sublime怎么跳转到指定行_sublime快速定位行号的方法
跳转到指定行可通过快捷键实现:Windows/Linux按Ctrl + G,Mac按Cmd + G,弹出对话框后输入行号(如50)或行:列(如50:10)即可定位,状态栏双击亦可打开该对话框,还可通过命令面板输入“goto line”进行跳转,其中快捷键方式最快捷。 在 Sublime Text 中…
-
sublime怎么查看和安装主题_Sublime主题安装与切换美化教程

在Sublime Text中更换和安装主题能显著提升编码体验,让界面更美观、更符合个人习惯。下面详细介绍如何查看、安装以及切换主题。 查看当前使用的主题 要确认当前Sublime Text正在使用哪个主题,可以打开命令面板: 按下 Ctrl+Shift+P(Windows/Linux)或 Cmd+S…
-
并发处理共享列表并收集结果的方案

本文旨在介绍如何利用 Java 并行流高效地处理大型列表,尤其是在每个元素的处理过程耗时较长的情况下。并行流能够将列表分割成多个子任务,并在多个线程上并发执行,从而显著提升处理速度。但同时,并发编程也带来了共享资源同步的问题,需要谨慎处理。 使用并行流并发处理列表 假设我们有一个 Foo 类,其 p…
-
Debian中PostgreSQL扩展插件

在Debian系统中高效管理PostgreSQL扩展插件,您可以选择多种方法。本文重点介绍一种便捷的工具和常用的管理命令。 推荐工具:Pig Pig是一个基于Go语言开发的PostgreSQL包管理器,兼容Debian、Ubuntu等主流Linux发行版。它预置了340多个扩展,并通过国内镜像优化了…
-
参加PHP+MySQL就业培训后能获得的岗位有哪些
参加php+mysql就业培训后,你可以获得以下岗位:1. web开发工程师,利用php和mysql开发动态网站和web应用程序;2. 后端开发工程师,使用php构建后端服务和api;3. 全栈开发工程师,结合前端技术进行全站开发;4. 数据库管理员,负责mysql数据库的设计、优化和维护;5. 软…
-
高效并发处理共享列表与结果收集的Java教程

本文介绍了如何利用Java并发特性,特别是并行流(Parallel Streams),来高效处理共享列表,并将处理结果进行收集。针对耗时操作,通过将列表分割成子列表,并利用并行流并发执行,可以显著提高处理效率。同时,强调了在并发环境下对共享资源进行同步的重要性,并提供了收集处理结果的示例代码。 在处…
-
Debian OpenSSL的依赖关系是什么
在Debian系统中,OpenSSL的依赖关系涵盖系统库、开发工具以及一些可选组件。 本文将详细阐述这些依赖项,并提供安装建议。 核心依赖: C标准库 (libc6): OpenSSL依赖C标准库才能正常运行。 OpenSSL开发库 (libssl-dev): 包含OpenSSL的头文件和静态库,用…
-
使用并行流并发处理共享列表并收集结果

本文将探讨如何高效地并发处理共享列表,并收集处理结果。在处理大量数据时,将任务分解为多个子任务并行执行可以显著提高效率。Java 8引入的并行流(Parallel Streams)为我们提供了一种简洁而强大的方式来实现这一目标。 并行流简介 并行流是Java 8 Stream API的一个特性,它允…
-
sublime怎么设置启动时自动打开上次的项目 _sublime启动自动打开上次项目
Sublime Text 能自动恢复上次项目和文件,需确保设置中启用 “remember_open_files”: true 且 “hot_exit”: false,并通过正常退出方式(如 Ctrl+Q 或 Cmd+Q)关闭程序以保存会话状态。 Sub…
-
Debian与Zookeeper集成开发指南

在Debian系统上部署ZooKeeper:一份简明指南 本文档简要介绍如何在debian系统上安装和配置zookeeper分布式协调服务。由于缺乏针对“debian与zookeeper集成开发指南”的特定信息,本文将提供一个基础的安装和配置过程。 Debian系统概述 Debian GNU/Lin…
-
如何在微服务之间共享静态数据
微服务架构的本质决定了微服务之间无法直接共享静态变量。正如上面摘要所说,每个微服务都是一个独立的进程,拥有自己的内存空间,静态变量只在其所属的进程内有效。试图在一个微服务中访问另一个微服务的静态变量,就像试图在一个独立的Java程序中访问另一个程序的变量一样,是不可能的。 微服务架构的独立性 微服务…
-
[python]windows上通过whl文件安装triton模块


在windows系统中,使用.whl文件安装triton是一个简单且高效的方法。以下是完整的操作流程说明: 一、检查系统配置 Python版本:首先确认已安装Python,并确保其版本与你要安装的Triton .whl 文件兼容。例如,若下载的是triton-2.0.0-cp310-cp310-wi…
-
FineReport与.NET集成要点
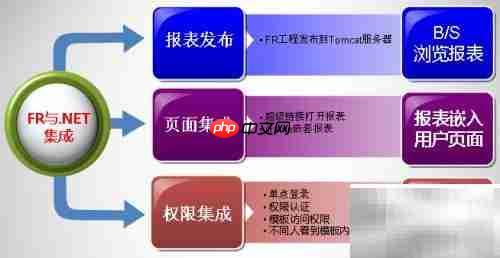

1、FineReport(FR)与.NET项目的集成主要涵盖三个核心部分,如上图所示。 2、报表发布是集成过程中的关键步骤之一。 3、需要注意的是,FR报表工程本质上是基于Java的Servlet应用,无法由IIS直接解析处理,因此必须将其部署在支持Servlet规范的Web应用服务器(如Tomca…
-
如何在微服务之间共享静态数据?
在微服务架构中,各个服务都是独立的部署单元,拥有各自的内存空间。如同上述摘要所述,直接通过静态变量在不同的微服务之间共享数据是不可能的。 试图在一个微服务中设置静态变量的值,然后在另一个微服务中访问它,将会得到 null 或初始值,而不是之前设置的值。 这不是 Spring Boot 特有的问题,而…
- 属性: 可以通过字典形式传递属性,比如