Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
处理Google Generative AI API限流与数据持久化实践_创想鸟

处理Google Generative AI API限流与数据持久化实践

处理Google Generative AI API限流与数据持久化实践

本文旨在指导开发者在使用Google Generative AI API(原PaLM API)时,如何有效应对429限流错误、实现数据持久化与错误恢复。我们将探讨官方API的优势,提供实用的限流策略如时间延迟和指数退避,并演示如何在数据处理过程中实时保存结果。通过详细的代码示例和最佳实践,帮助您构建更稳定、高效的AI应用。

理解与应对API限流(429错误)

在使用任何api进行大规模数据处理时,遭遇“429 too many requests”错误是常见挑战。这表明您在短时间内发送了过多的请求,超出了api提供商设定的速率限制。最初尝试通过随机延迟来规避限流是正确的方向,但如果延迟不足或策略不当,仍会触发限制。

为何会发生429错误?

API提供商设置速率限制是为了保护其服务免受滥用、确保公平使用并维持服务稳定性。当请求频率过高时,服务器会返回429状态码,拒绝进一步的请求。对于Google Bard这类基于大型语言模型的服务,计算资源消耗较大,因此限流尤为重要。

官方API的优势:Google Generative AI API (原PaLM API)

原问题中提到的是与“Google Bard”的非官方交互,这往往缺乏明确的API文档和限流指导。为了获得更稳定、可控的开发体验,强烈建议使用Google官方提供的Generative AI API(前身为PaLM API)。该API通过MakerSuite进行原型设计,并提供标准的SDK进行编程访问。

使用官方API的好处包括:

明确的文档和支持: 官方API通常有详细的文档,包含速率限制、错误码等信息。稳定性与可靠性: 官方API经过优化,更适合生产环境使用。模型一致性: 官方API(如models/text-bison-001)与Bard当前使用的模型保持一致,确保结果可预测。

限流策略:延迟与退避

当面对429错误时,仅仅移除延迟是不明智的。相反,我们需要更智能的延迟策略:

固定时间延迟: 在每次API请求之间插入一个固定的短时间延迟。根据经验,对于Google Generative AI API,1到5秒的延迟通常是一个良好的起点,可以显著减少被限流的几率。

import time# ... (API 调用代码) ...time.sleep(3) # 每次请求后暂停3秒

指数退避(Exponential Backoff): 这是更健壮的策略。当收到429错误时,不要立即重试,而是等待一段时间,然后重试。如果再次失败,则等待更长的时间,依此类推,呈指数级增长。这可以避免在API服务器过载时进一步加剧其负担。

import timeimport randomdef call_api_with_retry(api_call_function, max_retries=5, initial_delay=1):    delay = initial_delay    for i in range(max_retries):        try:            response = api_call_function()            return response        except Exception as e:            if "429" in str(e): # 检查是否是429错误                print(f"收到429错误,第 {i+1} 次重试,等待 {delay} 秒...")                time.sleep(delay + random.uniform(0, 1)) # 添加随机抖动,避免“惊群效应”                delay *= 2 # 延迟翻倍            else:                raise e # 其他错误直接抛出    raise Exception("API调用失败,超出最大重试次数")

数据持久化与错误恢复

在长时间运行的循环中调用API时,如果发生错误(如429限流或网络中断),已处理的数据可能会丢失。因此,实时保存进度至关重要。

实时保存已处理数据

最简单有效的方法是在每次成功获取API响应后,立即将结果写入文件。这样,即使程序中断,您也可以从上次保存的点恢复。

逐行写入: 对于文本数据,可以将每条响应作为一行写入文本文件。追加模式: 使用文件追加模式(’a’)确保不会覆盖之前的数据。结构化数据保存: 对于更复杂的响应,可以将其序列化为JSON格式,然后写入文件。

import jsondef save_response(data, filename="bard_responses.jsonl"):    """将单条响应以JSON Lines格式追加到文件"""    with open(filename, 'a', encoding='utf-8') as f:        f.write(json.dumps(data, ensure_ascii=False) + 'n')# 示例:在循环中保存# for i, sentence in enumerate(sentences_to_process):#     try:#         response = genai.generate_text(...) # 假设这是API调用#         if response.result:#             save_response({"id": i, "input": sentence, "output": response.result})#         time.sleep(random.uniform(1, 5)) # 加入随机延迟#     except Exception as e:#         print(f"处理第 {i} 条数据时发生错误: {e}")#         # 错误处理逻辑,可以记录错误并跳过,或触发重试#         break # 或者根据需要决定是否中断循环

健壮的错误处理

结合try-except块来捕获API调用过程中可能出现的异常,并采取相应的恢复措施。

# 结合错误处理和数据保存的伪代码# responses = [] # 如果想先收集到内存再统一保存,但不如实时保存健壮# for i, item in enumerate(data_items):#     try:#         api_response = call_api_with_retry(lambda: genai.generate_text(prompt=item))#         if api_response and api_response.result:#             processed_data = {"input": item, "output": api_response.result}#             save_response(processed_data, "processed_results.jsonl")#             # responses.append(processed_data) # 如果需要内存中的副本#         time.sleep(random.uniform(1, 5)) # 每次请求后延迟#     except Exception as e:#         print(f"处理第 {i} 条数据时发生致命错误: {e}")#         print("程序中断,已处理数据已保存到 processed_results.jsonl")#         break # 遇到无法恢复的错误时中断循环

使用Google Generative AI API进行开发

Google Generative AI API提供了一个统一的接口来访问其各种生成式AI模型。

环境搭建

首先,安装Python SDK:

pip install google-generativeai

然后,您需要一个API密钥。可以通过Google Cloud Console或MakerSuite获取。

核心代码示例

以下是一个使用google-generativeai库调用text-bison-001模型生成文本的完整示例,并融入了限流和数据持久化的概念:

import google.generativeai as genaiimport timeimport randomimport jsonimport os# 配置您的API密钥# 建议从环境变量或安全配置中加载,避免硬编码# genai.configure(api_key=os.environ.get("GOOGLE_API_KEY"))genai.configure(api_key="YOUR_API_KEY") # 请替换为您的实际API密钥# 定义默认模型参数defaults = {  'model': 'models/text-bison-001',  'temperature': 0.7, # 创造性程度,0-1  'candidate_count': 1, # 生成的候选响应数量  'top_k': 40,  'top_p': 0.95,  'max_output_tokens': 1024, # 最大输出长度  'stop_sequences': [], # 停止生成的序列  # 安全设置:根据您的应用场景调整  'safety_settings': [      {"category":"HARM_CATEGORY_DEROGATORY","threshold":"BLOCK_LOW_AND_ABOVE"},      {"category":"HARM_CATEGORY_TOXICITY","threshold":"BLOCK_LOW_AND_ABOVE"},      {"category":"HARM_CATEGORY_VIOLENCE","threshold":"BLOCK_MEDIUM_AND_ABOVE"},      {"category":"HARM_CATEGORY_SEXUAL","threshold":"BLOCK_MEDIUM_AND_ABOVE"},      {"category":"HARM_CATEGORY_MEDICAL","threshold":"BLOCK_MEDIUM_AND_ABOVE"},      {"category":"HARM_CATEGORY_DANGEROUS","threshold":"BLOCK_MEDIUM_AND_ABOVE"}  ],}# 待处理的句子列表(模拟数据)sentences_to_process = [    "写一首关于海底城堡的诗歌",    "描述一个在月球上发现的神秘生物",    "创作一个关于时间旅行者的短故事",    "解释量子纠缠的基本原理",    "写一个关于未来城市的科幻场景",    "给我一个关于友谊的励志名言",    "总结一下人工智能的最新发展",    "编写一个关于古代文明的谜语",    "创作一首关于星空的俳句",    "描述一场发生在遥远星球上的战争",    "写一首关于海底城堡的诗歌",    "描述一个在月球上发现的神秘生物",    "创作一个关于时间旅行者的短故事",    "解释量子纠缠的基本原理",    "写一个关于未来城市的科幻场景",    "给我一个关于友谊的励志名言",    "总结一下人工智能的最新发展",    "编写一个关于古代文明的谜语",    "创作一首关于星空的俳句",    "描述一场发生在遥远星球上的战争",    # ... 更多句子,模拟120次请求]output_filename = "generative_ai_responses.jsonl"def generate_text_with_retry(prompt_text, retry_count=5, base_delay=1):    """    带指数退避和随机抖动的API调用函数。    """    current_delay = base_delay    for attempt in range(retry_count):        try:            response = genai.generate_text(                **defaults,                prompt=prompt_text            )            if response.result:                return response.result            else:                # API可能成功返回但结果为空,也视为失败                raise Exception("API返回空结果")        except Exception as e:            error_message = str(e)            if "429" in error_message or "Quota exceeded" in error_message:                print(f"尝试 {attempt + 1}/{retry_count}: 收到限流错误 ({error_message}),等待 {current_delay:.2f} 秒后重试...")                time.sleep(current_delay + random.uniform(0, 0.5)) # 添加随机抖动                current_delay *= 2 # 指数退避            else:                print(f"尝试 {attempt + 1}/{retry_count}: 发生其他错误 ({error_message}),等待 {current_delay:.2f} 秒后重试...")                time.sleep(current_delay + random.uniform(0, 0.5))                current_delay *= 2    raise Exception(f"多次重试后仍无法成功调用API: {prompt_text}")# 检查是否有之前保存的进度,从上次中断处恢复start_index = 0if os.path.exists(output_filename):    with open(output_filename, 'r', encoding='utf-8') as f:        for line in f:            start_index += 1    print(f"从文件 {output_filename} 中恢复,已处理 {start_index} 条数据。")print(f"开始处理,总共 {len(sentences_to_process)} 条数据,从第 {start_index} 条开始。")for i in range(start_index, len(sentences_to_process)):    subject = sentences_to_process[i]    prompt = f"""{subject}""" # 简化prompt,直接使用句子作为主题    print(f"正在处理第 {i+1}/{len(sentences_to_process)} 条数据: '{subject[:30]}...'")    try:        generated_text = generate_text_with_retry(prompt)        # 实时保存结果        with open(output_filename, 'a', encoding='utf-8') as f:            json.dump({"id": i, "input_prompt": subject, "generated_output": generated_text}, f, ensure_ascii=False)            f.write('n')        print(f"成功生成并保存第 {i+1} 条数据。")        # 每次成功请求后,添加一个随机延迟,以避免连续触发限流        time.sleep(random.uniform(1, 3)) # 1到3秒的随机延迟    except Exception as e:        print(f"处理第 {i+1} 条数据 '{subject[:30]}...' 时发生致命错误: {e}")        print(f"程序中断。已处理的数据已保存到 '{output_filename}'。")        break # 遇到致命错误,中断整个处理循环print("所有数据处理完成或程序中断。")

参数配置详解

model: 指定要使用的模型,如models/text-bison-001。temperature: 控制生成文本的随机性或创造性。值越高,输出越随机;值越低,输出越集中和确定。candidate_count: 请求生成的候选响应数量。通常设置为1。top_k / top_p: 采样策略参数,用于控制模型在生成文本时考虑的词汇范围。top_k: 模型在生成下一个词时,会从概率最高的k个词中进行采样。top_p: 模型会选择概率累积和达到p的最小词汇集进行采样。max_output_tokens: 生成文本的最大长度。stop_sequences: 一个字符串列表,当模型生成其中任何一个字符串时,就会停止生成。safety_settings: 用于过滤不安全内容的设置。您可以根据应用程序的需求调整阈值。

最佳实践与注意事项

API密钥安全: 绝不将API密钥硬编码到公开的代码库中。使用环境变量、配置文件或秘密管理服务来存储和访问密钥。监控API使用情况: Google Cloud Console通常提供API使用情况仪表板,您可以监控请求量、错误率等,以便更好地理解和管理限流。保持更新: Google的AI服务发展迅速,API和模型可能会更新。定期查看官方文档以获取最新信息。理解模型限制: 即使是强大的模型也有其局限性,例如事实性错误、偏见或无法理解复杂指令。设计您的应用程序时要考虑到这些。分批处理与异步: 对于需要处理海量数据的场景,除了简单的time.sleep,还可以考虑更高级的分批处理(如果API支持)或异步编程(如asyncio)来提高效率,同时仍需注意限流。对于更复杂的任务调度和容错,Celery等工具也是可选方案。

总结

通过采用Google官方的Generative AI API,并结合智能的限流策略(如固定延迟和指数退避)以及健壮的数据持久化与错误处理机制,开发者可以构建出更加稳定、高效且具备恢复能力的AI应用。始终记住API密钥安全、关注官方文档,并根据实际需求调整您的处理策略,以确保您的AI集成项目顺利进行。

以上就是处理Google Generative AI API限流与数据持久化实践的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1371618.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Abjad 教程:如何在乐谱中标记 X 形符头音符(死音)
上一篇 2025年12月14日 11:36:21
机器学习模型对数变换后预测值还原指南
下一篇 2025年12月14日 11:36:36

相关推荐

  • Azure Blob 存储上传文件失败:权限错误排查与解决方案

    Azure Blob 存储上传文件失败:权限错误排查与解决方案Azure Blob 存储上传文件失败:权限错误排查与解决方案Azure Blob 存储上传文件失败:权限错误排查与解决方案Azure Blob 存储上传文件失败:权限错误排查与解决方案

    本文档旨在帮助开发者解决在使用 Azure Blob 存储上传文件时遇到的 “AuthorizationFailure” 错误,即权限不足的问题。文章将详细介绍该错误的常见原因,并提供通过配置 Azure 存储账户的网络防火墙规则,添加客户端 IP 地址来解决问题的具体步骤,…

    2026年9月29日 • 用户投稿
    000
  • 抖音账号的权重是什么意思?抖音账号权重1到10

    抖音账号的权重是什么意思?抖音账号权重1到10抖音账号的权重是什么意思?抖音账号权重1到10抖音账号的权重是什么意思?抖音账号权重1到10抖音账号的权重是什么意思?抖音账号权重1到10

    随着短视频平台的迅速发展,抖音已经成为用户展示自我、传播内容的重要渠道。在众多创作者中,想要让自己的作品脱颖而出,关键之一就是理解并提升抖音账号的权重。本文将带您深入了解抖音账号权重的含义,帮助您打造更具影响力的内容。 一、什么是抖音账号权重? 抖音账号权重是平台对账号整体表现的综合评价,涵盖账号活…

    2026年9月29日 • 用户投稿
    000
  • PHP多维数组:高效提取嵌套结构中最后一个元素的特定值

    本文详细介绍了如何在PHP多维数组中,通过迭代和end()函数,准确获取特定嵌套层级下最后一个子数组中指定元素的值。教程提供了两种实现方式:直接输出和将值存储到新数组中,并强调了数据验证的重要性,以确保处理复杂或动态数据结构的健壮性。 1. 理解问题背景与数组结构 在处理复杂数据,尤其是通过解析xm…

    2026年9月29日
    000
  • win10提示“无法加载用户配置文件”_用户配置文件加载失败错误修复指南

    win10提示“无法加载用户配置文件”_用户配置文件加载失败错误修复指南win10提示“无法加载用户配置文件”_用户配置文件加载失败错误修复指南win10提示“无法加载用户配置文件”_用户配置文件加载失败错误修复指南win10提示“无法加载用户配置文件”_用户配置文件加载失败错误修复指南

    首先重启电脑并进入安全模式,启用内置管理员账户后检查用户配置文件服务状态,运行SFC扫描修复系统文件,并通过注册表编辑器修正ProfileList中损坏的配置文件项,最后重启尝试正常登录。 如果您在登录Windows 10时遇到“无法加载用户配置文件”的错误提示,这通常意味着系统无法正确读取或访问您…

    2026年9月29日 • 用户投稿
    000
  • VSCode如何实现智能代码审查 VSCodeAI辅助质量检测的配置方法

    vscode实现智能代码审查的核心是配置lint工具和ai辅助插件;2. 首先根据编程语言选择合适的lint工具(如eslint、pylint等),并在项目中安装工具及其vscode扩展;3. 然后通过配置文件(如.eslintrc.js)定义代码规则,并在vscode的settings.json中…

    2026年9月29日
    000
  • mysql数据库中数据备份与恢复概念

    数据备份与恢复是MySQL数据库安全的核心,通过物理或逻辑方式复制数据以防范丢失;全量、增量和差异备份各有优劣,需结合RPO与RTO制定策略;恢复时依类型选择对应方法,定期验证并保障存储安全,可有效提升系统容灾能力。 在MySQL数据库管理中,数据备份与恢复是保障数据安全的核心操作。当系统遭遇硬件故…

    2026年9月29日
    100
  • 谷歌发布最新 DORA 报告,揭示开发者如何使用 AI

    谷歌发布最新 DORA 报告,揭示开发者如何使用 AI谷歌发布最新 DORA 报告,揭示开发者如何使用 AI谷歌发布最新 DORA 报告,揭示开发者如何使用 AI谷歌发布最新 DORA 报告,揭示开发者如何使用 AI

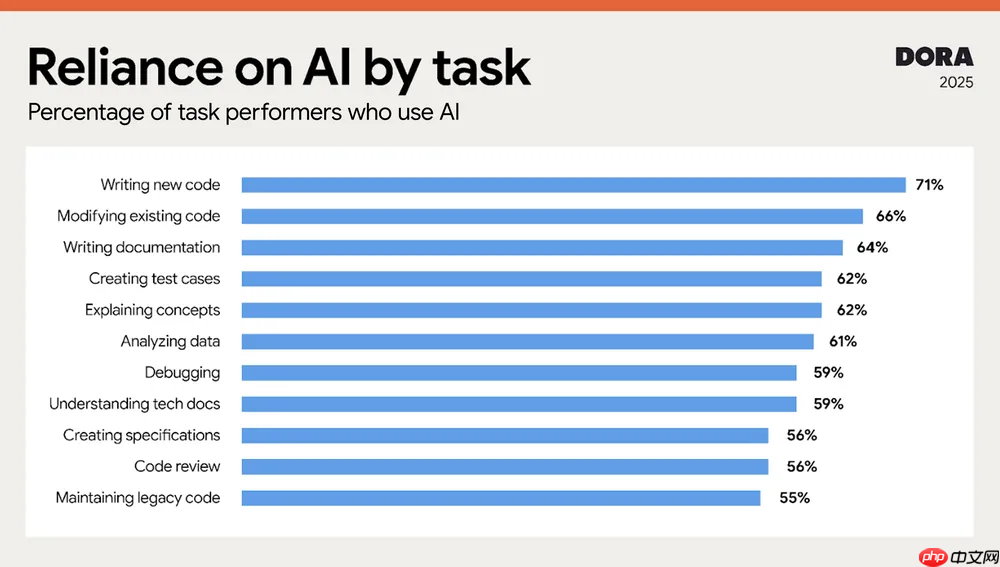
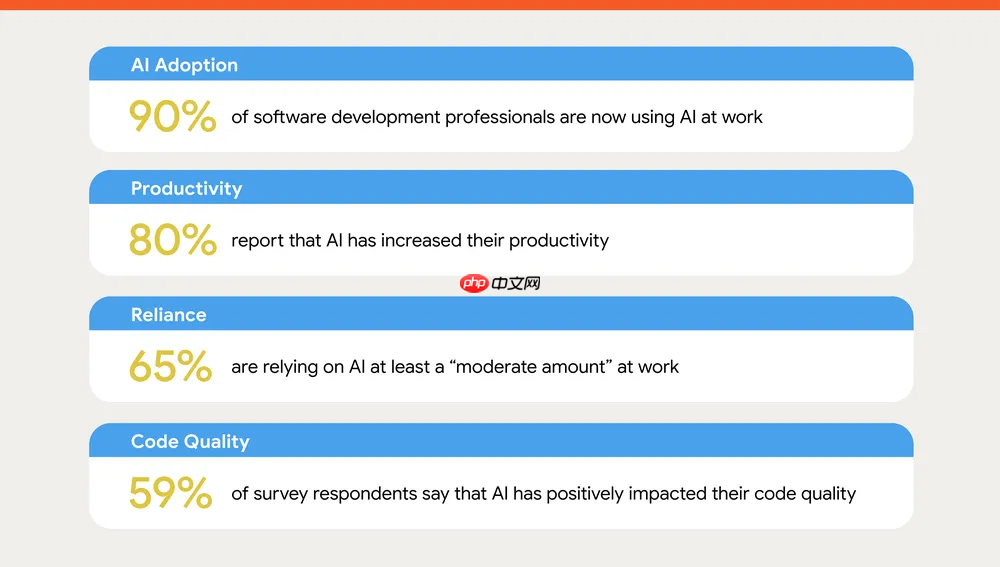
    谷歌发布了最新的 2025 年 dora 报告,重点聚焦 ai 在软件开发中的广泛应用及其带来的深远影响。 DORA(DevOps Research and Assessment) 是由谷歌长期主导的开发效能研究项目,每年通过全球范围的大规模调研,为软件工程团队提供基于数据的洞察与实践指导。今年报告…

    2026年9月29日 • 用户投稿
    000
  • QQ空间访问报错如何解决

    QQ空间访问报错如何解决QQ空间访问报错如何解决QQ空间访问报错如何解决QQ空间访问报错如何解决

    网络问题、浏览器兼容性、账号异常或系统维护是QQ空间访问报错的常见原因。2. 可依次检查网络连接、切换网络模式、更换浏览器或清理缓存、确认账号状态及查看系统维护公告。3. 若问题持续,建议联系腾讯客服反馈错误信息以获取支持。 QQ空间访问报错通常由网络问题、浏览器兼容性、账号异常或系统维护等原因引起…

    2026年9月29日 • 用户投稿
    000
  • DeepSeek本地部署如何验证安装完整性 DeepSeek文件校验与数字证书检查指南

    DeepSeek本地部署如何验证安装完整性 DeepSeek文件校验与数字证书检查指南DeepSeek本地部署如何验证安装完整性 DeepSeek文件校验与数字证书检查指南DeepSeek本地部署如何验证安装完整性 DeepSeek文件校验与数字证书检查指南DeepSeek本地部署如何验证安装完整性 DeepSeek文件校验与数字证书检查指南

    对于本地部署的DeepSeek,确保安装过程的完整性和文件的未被篡改是至关重要的。本文将指导用户如何通过文件校验和数字证书检查这两种方法,验证DeepSeek本地部署文件的安装完整性。我们将详细讲解操作步骤,帮助用户掌握必要的验证技能,确保部署环境的安全与可靠。 ☞☞☞AI 智能聊天, 问答助手, …

    2026年9月29日 • 用户投稿
    000
  • 抖音运营每天工作安排是啥?运营每天需要做的事情

    抖音运营每天工作安排是啥?运营每天需要做的事情抖音运营每天工作安排是啥?运营每天需要做的事情抖音运营每天工作安排是啥?运营每天需要做的事情抖音运营每天工作安排是啥?运营每天需要做的事情

    随着短视频平台的迅速发展,抖音已经成为众多内容创作者展示自我、传播信息的重要渠道。为了在激烈的竞争中占据一席之地,制定科学的抖音运营计划显得尤为重要。本文将从内容策划、粉丝互动、数据追踪等角度出发,详细介绍抖音运营人员每日的工作流程。 一、内容策划与制作 早晨选题规划每天早上是确定当天视频主题的关键…

    2026年9月29日 • 用户投稿
    000
  • 使用Java在Vulkan中加载GLSL着色器

    使用Java在Vulkan中加载GLSL着色器使用Java在Vulkan中加载GLSL着色器使用Java在Vulkan中加载GLSL着色器使用Java在Vulkan中加载GLSL着色器

    本文介绍了如何在Java中使用Vulkan API加载和使用GLSL着色器。核心步骤是将GLSL着色器编译为SPIR-V二进制格式,然后加载到Vulkan管线中。通过使用ShaderSPIRVUtils等工具,可以简化编译过程,并确保着色器代码在Vulkan环境中正确执行。本文将提供详细的步骤和示例…

    2026年9月29日 • 用户投稿
    000
  • DeepSeek跨平台安装遇到中文路径问题 DeepSeek中文目录兼容性处理方案

    DeepSeek跨平台安装遇到中文路径问题 DeepSeek中文目录兼容性处理方案DeepSeek跨平台安装遇到中文路径问题 DeepSeek中文目录兼容性处理方案DeepSeek跨平台安装遇到中文路径问题 DeepSeek中文目录兼容性处理方案DeepSeek跨平台安装遇到中文路径问题 DeepSeek中文目录兼容性处理方案

    在使用 DeepSeek 进行跨平台安装或部署时,用户有时会遇到与中文路径相关的兼容性问题,这可能导致安装失败或程序运行时出现异常。本文旨在阐述这一问题的常见原因,并提供一套实用的中文目录兼容性处理方案,指导用户通过清晰的步骤解决此问题,确保 DeepSeek 能够顺利安装和运行。 ☞☞☞AI 智能…

    2026年9月29日 • 用户投稿
    000
  • 如何在SublimeText中设置代码自动补全?提升编码效率的配置技巧

    如何在SublimeText中设置代码自动补全?提升编码效率的配置技巧如何在SublimeText中设置代码自动补全?提升编码效率的配置技巧如何在SublimeText中设置代码自动补全?提升编码效率的配置技巧如何在SublimeText中设置代码自动补全?提升编码效率的配置技巧

    Sublime Text的内置自动补全功能有限,需结合第三方插件如Anaconda或LSP实现智能补全。首先启用auto_complete并配置触发条件,再通过Package Control安装语言专属插件,如Python用Anaconda或LSP-pyright,JavaScript用TypeSc…

    2026年9月29日 • 用户投稿
    000
  • 夸克搜索怎么屏蔽不想要的内容_夸克搜索屏蔽不良内容设置教程

    夸克搜索怎么屏蔽不想要的内容_夸克搜索屏蔽不良内容设置教程夸克搜索怎么屏蔽不想要的内容_夸克搜索屏蔽不良内容设置教程夸克搜索怎么屏蔽不想要的内容_夸克搜索屏蔽不良内容设置教程夸克搜索怎么屏蔽不想要的内容_夸克搜索屏蔽不良内容设置教程

    关闭网页智能保护、启用成人模式、管理搜索历史、标记广告及开启内容拦截器可优化夸克搜索结果。具体:1. 在设置中调整【搜索与浏览】下的【网页智能保护】开关以控制跳转与广告过滤;2. 进入【隐私设置】完成年龄验证后选择是否开启【成人模式】来屏蔽敏感内容;3. 关闭【搜索历史记录提示】和【搜索发现】以减少…

    2026年9月29日 • 用户投稿
    200
  • 高通 CEO:AI 成为新的 UI,智能体构成新的操作系统

    高通 CEO:AI 成为新的 UI,智能体构成新的操作系统高通 CEO:AI 成为新的 UI,智能体构成新的操作系统高通 CEO:AI 成为新的 UI,智能体构成新的操作系统高通 CEO:AI 成为新的 UI,智能体构成新的操作系统

    在今日举行的骁龙峰会 2025 主题演讲中,高通公司总裁兼首席执行官克里斯蒂亚诺・阿蒙(cristiano amon)登台发表演讲,深入阐述了“ai everywhere”的未来愿景。 演讲中,阿蒙指出,我们正经历个人计算领域的一次深刻变革:人工智能正在演变为全新的用户界面(UI)。这一转变的核心在…

    2026年9月29日 • 用户投稿
    100
  • CentOS系统怎么查找软件包_yum-search命令使用技巧

    CentOS系统怎么查找软件包_yum-search命令使用技巧CentOS系统怎么查找软件包_yum-search命令使用技巧CentOS系统怎么查找软件包_yum-search命令使用技巧CentOS系统怎么查找软件包_yum-search命令使用技巧

    最常用方法是使用 yum search 命令,通过关键词搜索软件包,如 yum search java 可查找所有含“java”的包;2. 使用 yum provides 可定位命令所属包,如 yum provides ifconfig 能查出 net-tools;3. 结合 grep 过滤和 &#…

    2026年9月29日 • 用户投稿
    100
  • 使用蝴蝶号+AI工具,轻松实现智能直播带货

    使用蝴蝶号+AI工具,轻松实现智能直播带货使用蝴蝶号+AI工具,轻松实现智能直播带货使用蝴蝶号+AI工具,轻松实现智能直播带货使用蝴蝶号+AI工具,轻松实现智能直播带货

    直播带货效率可通过“蝴蝶号+ai工具”组合提升。1.蝴蝶号作为虚拟账号系统,可模拟真人操作,自动发言、点赞、刷礼物、发弹幕,营造直播间人气氛围,提高用户停留时间和转化率;2.ai工具则能写脚本、生成商品介绍、实时分析评论区情绪、语音播报促销信息,并实现自动回复评论、智能推荐话术、语音合成播报等功能,…

    2026年9月29日 • 用户投稿
    100
  • 安装系统时,遇到 “BIOS 设置与系统安装不兼容”,怎么调整?

    安装系统时,遇到 “BIOS 设置与系统安装不兼容”,怎么调整?安装系统时,遇到 “BIOS 设置与系统安装不兼容”,怎么调整?安装系统时,遇到 “BIOS 设置与系统安装不兼容”,怎么调整?安装系统时,遇到 “BIOS 设置与系统安装不兼容”,怎么调整?

    答案:BIOS设置与系统安装不兼容通常由启动模式、安全启动、硬盘模式等配置引起,需进入BIOS调整。首先检查Boot Mode,根据操作系统选择UEFI或Legacy BIOS;若安装Linux等非微软系统,可禁用Secure Boot;将SATA Mode设为AHCI以获得最佳性能,若驱动不支持可…

    2026年9月29日 • 用户投稿
    200
  • 115网盘资源网站地址 115网盘大量资源搜索网站链接

    115网盘资源网站地址 115网盘大量资源搜索网站链接115网盘资源网站地址 115网盘大量资源搜索网站链接115网盘资源网站地址 115网盘大量资源搜索网站链接115网盘资源网站地址 115网盘大量资源搜索网站链接

    115网盘作为一款备受用户青睐的云存储服务,以其卓越的离线下载功能和超大存储空间而闻名。许多用户习惯于将高清影视、学习资料、大型软件等珍贵资源保存在其中,久而久之,形成了一个庞大而丰富的资源生态。 立即进入“☞☞☞☞☞点击国内网盘资源网站直达入口 ☜☜☜☜☜”; 立即进入“☞☞☞☞☞点击网盘资源永久…

    2026年9月29日 • 用户投稿
    200
  • 快手店铺怎么开运费险?快手开通运费险在哪里

    随着网络购物的普及,越来越多的人选择在线购物。然而,物流问题始终是消费者关注的重点。为了应对这一挑战,各大电商平台纷纷推出了运费险服务。本文将详细介绍如何在快手店铺开通运费险,帮助商家降低经营风险,增强市场竞争力。 一、运费险的概念 运费险,又称“物流运输保险”,是一种由电商平台提供的免费保险服务,…

    2026年9月29日
    100

发表回复

登录后才能评论
关注微信