Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
使用 Pandas 高效识别用户新零售商:条件列创建教程_创想鸟

使用 Pandas 高效识别用户新零售商:条件列创建教程

使用 Pandas 高效识别用户新零售商:条件列创建教程

本文旨在指导读者如何使用 Pandas 在用户行为数据中识别特定时期内出现的新零售商。我们将探讨两种高效的方法:利用 pd.merge 的 indicator 参数进行合并分析,以及通过创建 MultiIndex 并结合 isin 方法进行多列条件判断,最终为每个零售商记录生成一个“是否为新零售商”的条件列。

引言

在数据分析场景中,我们经常需要比较两个数据集,以识别在第二个数据集中出现但在第一个数据集中不存在的实体。例如,在用户行为分析中,我们可能需要找出用户在“后观察期”访问的哪些零售商是“前观察期”从未访问过的。这要求我们针对每个用户,比较其在两个时期内的零售商集合,并标记出新增的零售商。传统的 isin() 或 loc[] 方法在处理多列(如 user_id 和 retailer 组合)的条件判断时可能不够直观或高效。本教程将介绍两种使用 pandas 解决此类问题的专业方法。

数据准备

首先,我们创建两个示例 DataFrame,分别代表用户在“前观察期”和“后观察期”的零售商访问记录。

import pandas as pd# 前观察期数据sample1 = pd.DataFrame(    {        'user_id': [45, 556, 556, 556, 556, 556, 556, 1344, 1588, 2063, 2063, 2063, 2673, 2982, 2982],        'retailer': ['retailer_1', 'retailer_1', 'retailer_2', 'retailer_3', 'retailer_4', 'retailer_5', 'retailer_6',                      'retailer_3', 'retailer_2', 'retailer_2', 'retailer_3', 'retailer_7', 'retailer_1', 'retailer_1', 'retailer_2']    })# 后观察期数据sample2 = pd.DataFrame(    {        'user_id': [45, 45, 556, 556, 556, 556, 556, 556, 1344, 1588, 2063, 2063, 2063, 2673, 2673, 2982, 2982],        'retailer': ['retailer_1', 'retailer_6', 'retailer_1', 'retailer_2', 'retailer_3', 'retailer_4', 'retailer_5', 'retailer_6',                      'retailer_3', 'retailer_2', 'retailer_2', 'retailer_3', 'retailer_7', 'retailer_1', 'retailer_2', 'retailer_1', 'retailer_2']    })print("Sample 1 (前观察期):")print(sample1)print("nSample 2 (后观察期):")print(sample2)

我们的目标是在 sample2 中添加一个名为 is_new_retailer 的列,如果 sample2 中的某个 (user_id, retailer) 组合在 sample1 中不存在,则该列值为 1,否则为 0。

方法一:使用 pd.merge 的 indicator 参数

Pandas 的 merge 函数提供了一个 indicator 参数,当设置为 True 或一个字符串时,它会生成一个额外的列,指示每行记录的来源。这对于识别仅存在于左 DataFrame、仅存在于右 DataFrame 或同时存在于两者的数据非常有用。

执行左合并: 我们将 sample2 作为左 DataFrame,sample1 作为右 DataFrame,基于 user_id 和 retailer 列进行左合并。indicator=’is_new_retailer’ 会创建一个新列来标记合并结果。解释 indicator 结果: indicator 列将包含 ‘left_only’ (仅存在于 sample2)、’right_only’ (仅存在于 sample1,但在左合并中不会出现) 或 ‘both’ (同时存在于两者)。转换为二进制标志: 我们关注的是 ‘left_only’ 的情况,这意味着该 (user_id, retailer) 组合在 sample2 中有,但在 sample1 中没有,即它是一个新零售商。我们将 ‘left_only’ 转换为 1,其他情况转换为 0。

# 使用 left merge 和 indicator 参数# 将 sample2 作为左表,sample1 作为右表# indicator='is_new_retailer' 会生成一个名为 'is_new_retailer' 的列,# 标记每行记录的来源 ('left_only', 'right_only', 'both')merged_df = sample2.merge(sample1, on=['user_id', 'retailer'], how='left', indicator='is_new_retailer')# 将 'is_new_retailer' 列的 'left_only' 值转换为 1 (表示新零售商),其他转换为 0# 'left_only' 意味着该组合只存在于 sample2 中,而不存在于 sample1 中merged_df['is_new_retailer'] = merged_df['is_new_retailer'].eq('left_only').astype(int)print("n方法一:使用 pd.merge 的 indicator 参数")print(merged_df)

注意事项:这种方法在 (user_id, retailer) 组合在两个 DataFrame 中都是唯一的情况下表现完美。如果存在重复,merge 操作可能会产生额外的行,但这通常不是问题,因为我们通常关心的是组合的唯一性,而不是行的计数。

方法二:利用 MultiIndex.isin 进行多列条件判断

当需要基于多列的组合来检查成员关系时,创建 MultiIndex 是一个非常灵活且强大的方法。这种方法的核心思想是将多个列组合成一个复合索引,然后使用 Index.isin() 方法来检查一个复合索引中的元素是否存在于另一个复合索引中。

创建 MultiIndex: 分别从 sample1 和 sample2 中选择 user_id 和 retailer 列,创建两个 MultiIndex 对象。使用 isin() 检查成员关系: 使用 sample2 的 MultiIndex 调用 isin() 方法,并传入 sample1 的 MultiIndex。这将返回一个布尔 Series,指示 sample2 中每个 (user_id, retailer) 组合是否在 sample1 中存在。转换为二进制标志: 将布尔 Series 取反 (~),然后转换为整数类型 (astype(int)),其中 True (不在 sample1 中) 变为 1,False (在 sample1 中) 变为 0。

# 创建 sample2 的 MultiIndex,包含 user_id 和 retailermux1 = pd.MultiIndex.from_frame(sample2[['user_id', 'retailer']])# 创建 sample1 的 MultiIndex,包含 user_id 和 retailermux2 = pd.MultiIndex.from_frame(sample1[['user_id', 'retailer']])# 检查 mux1 中的每个组合是否在 mux2 中存在# (~mux1.isin(mux2)) 表示:如果 mux1 中的组合不在 mux2 中,则为 True (即为新零售商)sample2['is_new_retailer'] = (~mux1.isin(mux2)).astype(int)print("n方法二:利用 MultiIndex.isin 进行多列条件判断")print(sample2)

优点:这种方法在概念上更直接地表达了“检查一个多列组合是否存在于另一个多列组合集合中”的需求。它避免了 merge 操作可能带来的行数变化,直接在原始 DataFrame 上添加新列,尤其适用于需要精确控制行匹配的场景。

总结与注意事项

我们探讨了两种在 Pandas 中创建条件列以识别“新”实体的高效方法:

pd.merge 结合 indicator 参数: 适用于通过合并操作来识别左右 DataFrame独有或共有的记录。其优点是直观且代码简洁,尤其适合在合并过程中直接生成标志。MultiIndex.isin 方法: 适用于需要基于多列组合进行成员关系检查的场景。它提供了更精细的控制,直接在原始 DataFrame 上进行判断,避免了合并可能带来的额外行。

在选择方法时,请考虑以下几点:

数据量: 对于非常大的数据集,两种方法的性能可能有所不同。merge 通常在 C 语言层面实现,可能在某些情况下更快,但 MultiIndex 的查找效率也很高。建议在实际应用中对大规模数据进行性能测试重复值处理: 两种方法都能正确处理 (user_id, retailer) 组合的唯一性。merge 方法在 on 列存在重复时会产生笛卡尔积,但 indicator 列的标记依然准确;MultiIndex.isin 则直接基于组合的唯一性进行判断。可读性与意图: MultiIndex.isin 更直接地表达了“检查多列组合的成员关系”这一意图,对于理解代码逻辑可能更为清晰。

通过这两种方法,您可以灵活高效地在 Pandas 中处理复杂的条件判断,为您的数据分析任务提供强大的支持。

以上就是使用 Pandas 高效识别用户新零售商:条件列创建教程的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1373436.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

Kivy教程:深入理解按钮事件处理与if条件判断的陷阱
上一篇 2025年12月14日 13:15:03
Hypothesis与Pandas:高效生成测试数据帧的实践指南
下一篇 2025年12月14日 13:15:16

相关推荐

  • 如何使用Ribbet的AI功能裁剪图片?快速实现精准图像裁剪

    答案:Ribbet的AI裁剪功能可快速智能识别主体并推荐裁剪方案,支持手动微调与多种比例选择,结合亮度、色彩等编辑工具优化效果,适用于制作符合社交媒体尺寸要求的封面图,操作简便且大部分功能免费,适合追求效率的普通用户。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepS…

    2026年9月21日
    400
  • 卢伟冰:功能手机、智能手机之后 手机行业正进入新周期

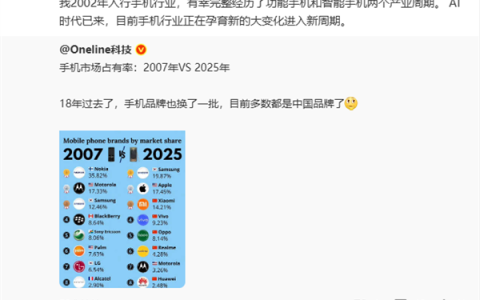
    9月4日,小米集团总裁卢伟冰表示,继功能机时代与智能机时代之后,全球手机产业正迈入一个全新时代。 卢伟冰今日在社交平台发文提到:“我从2002年进入手机行业,有幸完整见证了功能手机和智能手机两大发展阶段。如今,AI时代已经到来,整个行业正在酝酿深刻变革,步入全新的发展周期。” 回望过去,功能手机时期…

    2026年9月21日
    200
  • Java 正则表达式:查找双引号内所有指定字符串的出现次数

    本文旨在解决在 Java 中使用正则表达式查找双引号内特定字符串(例如 “variant”)的所有出现次数的问题。我们将提供一个完整的解决方案,包括正则表达式的构建、代码示例以及详细的解释,帮助开发者准确高效地完成此类任务。 在 Java 中,使用正则表达式查找字符串中特定模…

    2026年9月21日
    000
  • MySQL 大型历史数据表结构设计与优化指南

    本文旨在为处理大量客户历史交易数据的MySQL数据库设计提供专业指导。我们将探讨如何构建高效、可扩展的表结构,重点关注主键设计、数据分区、实时数据摄入以及性能优化策略,以确保系统能够稳定支持百万级乃至亿级数据量的查询需求。 MySQL大型历史数据表结构设计与优化 在处理大量历史数据,特别是涉及到多用…

    2026年9月21日
    000
  • MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录

    MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录MySQL重复数据检测与清理逻辑_Sublime脚本批量处理历史冗余记录

    处理mysql重复数据的核心步骤是识别并清理,可使用group by或窗口函数定位重复项,再通过分批删除或倒腾法安全清理;sublime text可用于高效生成和编辑sql语句。1. 识别重复数据常用group by+having或row_number()窗口函数;2. 清理策略包括分批删除、使用临…

    2026年9月21日 用户投稿
    100
  • 如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    PyTorch大模型训练需综合运用分布式训练、内存优化与高效计算策略。首先采用DistributedDataParallel实现多GPU并行,配合DistributedSampler确保数据均衡;通过混合精度训练、梯度累积和激活检查点缓解显存压力;使用torch.compile优化模型计算效率;选择…

    2026年9月21日 用户投稿
    100
  • MySQL自动化性能测试方案_MySQL持续监控调优数据库效率

    MySQL自动化性能测试方案_MySQL持续监控调优数据库效率MySQL自动化性能测试方案_MySQL持续监控调优数据库效率MySQL自动化性能测试方案_MySQL持续监控调优数据库效率MySQL自动化性能测试方案_MySQL持续监控调优数据库效率

    mysql自动化性能测试和持续监控的核心在于构建闭环反馈系统,包含模拟真实负载、全面数据采集、自动化执行与分析、数据驱动的持续调优四大环节。①测试环境需与生产一致并隔离,使用docker、虚拟机或云沙盒,解决数据同步与脱敏问题;②负载生成工具如sysbench、jmeter、locust或自定义脚本…

    2026年9月21日 用户投稿
    200
  • CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法

    CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法CyberLinkMediaSuite如何制作AI视频?多功能工具快速剪辑的方法

    答案:CyberLink MediaSuite(核心为PowerDirector)通过AI艺术风格转换、智能对象选取、AI天空替换、音频降噪与运动追踪等功能,显著提升视频制作效率与创意表现。结合模板应用、快捷键操作、媒体库管理及代理编辑等实战技巧,可实现快速剪辑与专业输出,适用于Vlog创作、教育视…

    2026年9月21日 用户投稿
    300
  • Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]

    Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]Win10与Ubuntu 18.04双系统安装。(Win10引导Linux)[通俗易懂]

    大家好,很高兴再次与大家见面,我是你们的老朋友全栈君。 作为一个初学者,为了满足自己的求知欲,我按照几位大神写的教程尝试了一遍安装过程,现在来和大家分享一下。 1、Win10安装(如果已经安装,请跳过) 1)制作系统U盘(参考微信公众号“软件安装管家”): https://www.php.cn/li…

    2026年9月21日 用户投稿
    400
  • 百家号视频怎么隐藏?百家号怎么设置仅自己可见

    随着短视频平台的快速发展,其已成为人们获取资讯和休闲娱乐的重要方式。作为国内知名的自媒体平台之一,百家号吸引了大量用户。然而,在享受便捷的同时,隐私安全问题也日益突出。本文将介绍百家号视频隐藏的方法,帮助用户更好地保护个人内容,维护隐私安全。 一、百家号视频隐藏方法 设置隐私权限 在百家号后台,用户…

    2026年9月21日
    200
  • MySQL数据库如何设计适合大数据量的表结构_案例分析?

    MySQL数据库如何设计适合大数据量的表结构_案例分析?MySQL数据库如何设计适合大数据量的表结构_案例分析?MySQL数据库如何设计适合大数据量的表结构_案例分析?MySQL数据库如何设计适合大数据量的表结构_案例分析?

    设计适合大数据量的mysql表结构,核心在于数据类型选对、索引用好、适当拆分。1. 合理选择字段类型,如根据数据范围选用tinyint/smallint代替bigint,固定值字段用enum类型,大文本字段单独拆表;2. 精准建立索引,高频查询字段建联合索引并遵循最左前缀原则,避免低区分度字段建索引…

    2026年9月21日 用户投稿
    100
  • windows10如何查看S.M.A.R.T.硬盘状态_windows10硬盘S.M.A.R.T.状态查看方法

    电脑运行慢、蓝屏或文件损坏可能是硬盘故障前兆,可通过S.M.A.R.T.技术检测健康状况。1、使用WMIC命令行工具输入“wmic diskdrive get model,status”查看状态,显示Pred Fail需立即备份数据;2、CrystalDiskInfo可深度分析S.M.A.R.T.参…

    2026年9月21日
    200
  • Photopea的AI功能怎么裁剪图片?快速实现高效图片裁剪技巧

    Photopea的AI功能怎么裁剪图片?快速实现高效图片裁剪技巧Photopea的AI功能怎么裁剪图片?快速实现高效图片裁剪技巧Photopea的AI功能怎么裁剪图片?快速实现高效图片裁剪技巧Photopea的AI功能怎么裁剪图片?快速实现高效图片裁剪技巧

    Photopea的AI功能通过智能选择工具与内容感知技术结合,实现高效图片裁剪。首先使用对象选择、快速选择或魔棒工具智能识别主体或背景,再通过“选择并遮住”精细调整边缘,尤其适用于复杂轮廓如发丝。随后可应用图层蒙版透明化背景,并用裁剪工具调整画布范围。结合内容感知填充可移除干扰元素并自动补全画面,内…

    2026年9月21日 用户投稿
    300
  • PHP框架中间件有什么用处_PHP框架中间件设计与实现

    PHP框架中间件是处理请求和响应的过滤器,用于实现身份验证、日志记录、CORS等通用逻辑,核心价值在于解耦和提升可维护性。通过定义中间件接口、具体中间件类及管道调度器可实现自定义中间件,如身份验证或CORS处理。在Laravel中可通过Kernel.php配置全局、分组或路由级中间件,执行顺序按注册…

    2026年9月21日
    100
  • Java中字符到数字转换:解决for循环提前返回的常见陷阱

    本文探讨java中`for`循环在字符到数字转换时,因`return`语句放置不当导致程序提前终止、无法完整处理字符串的问题。我们将分析这种常见陷阱,并提供修正方案,演示如何正确利用循环填充数组,并在循环结束后统一返回最终结果,确保每个字符都能被准确映射和组合。 引言:字符到数字的映射需求 在编程实…

    2026年9月21日
    100
  • 梦幻号虚拟主播电商运营宝典(附新手教程+配套工具清单)

    虚拟主播电商的核心在于“内容驱动销售,人设凝聚用户”,要让“梦幻号”真正动起来并实现带货,必须先赋予其鲜明的人设,包括清晰的定位标签(如美食家、科技宅)、独特的人格魅力(性格、口头禅、小缺点)和与产品的强关联性,使其具备辨识度和故事感,从而建立用户信任;接着通过obs studio、vtube st…

    2026年9月21日
    100
  • deepseek下载速度优化_从deepseek下载速度优化官网获取

    deepseek下载速度优化入口在官网https://www.deepseek.com,进入后可通过设置调整响应模式、使用智能路由和数据压缩技术提升速度。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ deepseek下载速度优化入口地址在…

    2026年9月21日
    100
  • Java多线程API调用中Future.get()返回null的解决方案

    本文旨在解决%ignore_a_1%api调用中`future.get()`方法返回`null`的常见问题。当使用`callable`和`executorservice`并发执行api请求并尝试获取结果时,如果流读取逻辑不当,可能导致获取到的数据为空。文章将详细解释问题根源,并提供使用`string…

    2026年9月21日
    100
  • mysql如何排查排序异常

    排查MySQL排序异常需先确认ORDER BY是否生效,检查子查询、UNION及应用层逻辑是否覆盖排序;通过EXPLAIN分析是否使用索引排序,避免Using filesort;确保字段类型、字符集和排序规则(collation)符合预期,处理NULL值和大小写敏感性;关注sort_buffer_s…

    2026年9月21日
    000
  • 即梦AI运镜控制怎么控制_即梦AI视频镜头移动技巧详解

    掌握即梦AI运镜需四步:一、用“镜头缓慢推进”等预设提示词生成标准运动;二、通过动效画板框选主体并绘制运动路径;三、设置首尾帧引导转场,实现穿越或循环效果;四、结合“希区柯克式变焦”“时间冻结环绕”等高级技巧增强视觉表现。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Dee…

    2026年9月21日
    000

发表回复

登录后才能评论
关注微信