Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
生成二值特征矩阵:使用Pandas crosstab与reindex的高效方法_创想鸟

生成二值特征矩阵:使用Pandas crosstab与reindex的高效方法

生成二值特征矩阵:使用Pandas crosstab与reindex的高效方法

本教程旨在详细阐述如何将具有事务性记录(如用户-特征对)的原始数据转换为一个二值化的特征矩阵。我们将重点介绍如何利用Pandas库中的crosstab函数进行数据透视,并结合reindex方法确保所有指定用户都包含在输出中,同时为未使用的特征填充零值,从而高效、清晰地构建用户-特征关联矩阵。

1. 问题背景与目标

在数据分析和机器学习领域,我们经常需要将用户的行为日志或事务数据转换为结构化的特征矩阵。例如,给定一个包含用户 (personnumber) 及其使用的特征 (featuresk) 的数据集,目标是创建一个新的dataframe,其中:

行代表特定的用户列表。列代表所有唯一的特征。单元格的值为1,如果该用户使用了该特征;为0,如果该用户未曾使用该特征。

原始数据可能如下所示:

featureSk PersonNumber

A1001B1001C1003C1004A1002B1005

我们希望为指定的 PersonNumber 列表(例如 [1001, 1002, 1003])生成如下的二值特征矩阵:

PersonNumber A B C

100111010021001003001

直接通过循环或条件判断来构建这样的矩阵效率低下且代码复杂,尤其是在处理大规模数据时。

2. 使用 pd.crosstab 构建基础频率矩阵

Pandas库提供了一个强大的函数 pd.crosstab,它能够根据两个或多个因子计算交叉表(频率表)。这正是我们解决问题的第一步:统计每个用户使用每个特征的次数。

pd.crosstab 的基本用法是 pd.crosstab(index, columns),其中 index 参数指定作为行索引的列,columns 参数指定作为列标题的列。

import pandas as pd# 示例数据data = {    'featureSk': ['A', 'B', 'C', 'C', 'A', 'B'],    'PersonNumber': [1001, 1001, 1003, 1004, 1002, 1005]}productusage_df = pd.DataFrame(data)# 使用crosstab生成频率表# index指定行,columns指定列feature_matrix = pd.crosstab(productusage_df["PersonNumber"], productusage_df["featureSk"])print("原始crosstab结果:")print(feature_matrix)

输出结果:

原始crosstab结果:featureSk     A  B  CPersonNumber         1001          1  1  01002          1  0  01003          0  0  11004          0  0  11005          0  1  0

pd.crosstab 默认会计算频率(即出现次数)。对于我们的二值化需求,任何大于0的计数都意味着该用户使用了该特征,可以视为1。幸运的是,crosstab 的输出已经满足了“0”表示未使用的需求。

3. 整合目标用户列表并处理缺失值

pd.crosstab 生成的矩阵只包含 productusage_df 中实际存在的 PersonNumber。如果我们的目标用户列表 vals 包含一些未在 productusage_df 中出现的用户,或者我们需要按照特定顺序排列用户,crosstab 的输出将不完整。

为了解决这个问题,我们可以使用DataFrame的 reindex 方法。reindex 允许我们根据一个新的索引来对DataFrame进行重排。如果新索引中的某个值在原DataFrame中不存在,reindex 会默认添加该行/列并用 NaN 填充。通过设置 fill_value=0,我们可以将这些 NaN 值替换为0,这正是我们二值化需求所期望的。

# 目标用户列表target_person_numbers = [1001, 1002, 1003]# 使用reindex来包含所有目标用户,并用0填充缺失值final_feature_matrix = feature_matrix.reindex(target_person_numbers, fill_value=0)print("n最终二值特征矩阵:")print(final_feature_matrix)

输出结果:

最终二值特征矩阵:featureSk     A  B  CPersonNumber         1001          1  1  01002          1  0  01003          0  0  1

通过这两步,我们成功地将原始的事务性数据转换成了所需的二值特征矩阵,并且确保了所有目标用户都被包含在内,未使用的特征被正确地标记为0。

4. 完整示例代码

以下是整合上述步骤的完整Python函数示例:

import pandas as pddef generate_binary_feature_matrix(productusage_df: pd.DataFrame, target_person_numbers: list) -> pd.DataFrame:    """    根据产品使用日志生成一个二值化的用户-特征矩阵。    Args:        productusage_df (pd.DataFrame): 包含 'featureSk' 和 'PersonNumber' 列的DataFrame。        target_person_numbers (list): 期望在输出矩阵中包含的PersonNumber列表。    Returns:        pd.DataFrame: 二值化的特征矩阵,其中行是PersonNumber,列是featureSk,                      单元格值为1表示用户使用了该特征,0表示未使用的特征。    """    if not isinstance(productusage_df, pd.DataFrame):        raise TypeError("productusage_df 必须是一个 Pandas DataFrame。")    if 'featureSk' not in productusage_df.columns or 'PersonNumber' not in productusage_df.columns:        raise ValueError("productusage_df 必须包含 'featureSk' 和 'PersonNumber' 列。")    # 步骤1: 使用crosstab生成基础频率矩阵    # 任何非零计数在这里都被视为特征存在,对于二值化是合适的    base_matrix = pd.crosstab(productusage_df["PersonNumber"], productusage_df["featureSk"])    # 步骤2: 使用reindex来包含所有目标用户,并用0填充缺失值    # 这会确保target_person_numbers中的所有用户都在结果中,    # 并且对于未在base_matrix中出现的PersonNumber,其所有特征值都为0。    final_matrix = base_matrix.reindex(target_person_numbers, fill_value=0)    # 确保所有特征列都是整数类型 (0或1)    # 虽然crosstab通常输出整数,但reindex可能导致类型变化,这里显式转换以保证结果一致性    for col in final_matrix.columns:        final_matrix[col] = final_matrix[col].astype(int)    return final_matrix# 示例数据data = {    'featureSk': ['A', 'B', 'C', 'C', 'A', 'B'],    'PersonNumber': [1001, 1001, 1003, 1004, 1002, 1005]}productusage_df = pd.DataFrame(data)# 测试目标用户列表test_person_list = [1001, 1002, 1003, 9999] # 包含一个不存在的用户# 调用函数生成特征矩阵result_df = generate_binary_feature_matrix(productusage_df, test_person_list)print("--- 最终生成的二值特征矩阵 ---")print(result_df)# 验证数据类型print("n--- 结果DataFrame信息 ---")result_df.info()

输出:

--- 最终生成的二值特征矩阵 ---featureSk     A  B  CPersonNumber         1001          1  1  01002          1  0  01003          0  0  19999          0  0  0--- 结果DataFrame信息 ---Int64Index: 4 entries, 1001 to 9999Data columns (total 3 columns): #   Column  Non-Null Count  Dtype---  ------  --------------  ----- 0   A       4 non-null      int64 1   B       4 non-null      int64 2   C       4 non-null      int64dtypes: int64(3)memory usage: 160.0 bytes

5. 注意事项与总结

性能考量: pd.crosstab 和 reindex 是高度优化的Pandas操作,对于中等规模的数据集(数百万行),它们的性能远优于手动循环。PySpark集成: 虽然本教程的解决方案是基于Pandas的,但如果您的原始数据是PySpark DataFrame,您可以先使用 .toPandas() 方法将其转换为Pandas DataFrame,然后再应用此逻辑。对于非常大的数据集,直接在PySpark中使用 groupBy 和 pivot 操作可能更高效,但这超出了本教程的范围。列的顺序: pd.crosstab 生成的列顺序是按特征名称的字母顺序排列的。如果需要特定的列顺序,可以在 reindex 之后使用 df[desired_column_order] 进行调整。数据类型: crosstab 默认输出整数类型。reindex 操作通常会保留类型,但为了确保结果的一致性,尤其是当 fill_value 可能导致类型推断为浮点数时,显式将列转换为 int 类型是一个好习惯。

通过利用Pandas的 pd.crosstab 和 reindex 函数,我们可以高效且优雅地将扁平化的事务数据转换为结构化的二值特征矩阵,这在数据预处理和特征工程中是非常实用的技巧。

以上就是生成二值特征矩阵:使用Pandas crosstab与reindex的高效方法的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1374476.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
生成音频正弦波形:从频率与时长到可视化教程
上一篇 2025年12月14日 14:11:19
音频正弦波形生成教程:利用频率与录音时长重构时间域信号
下一篇 2025年12月14日 14:11:23

相关推荐

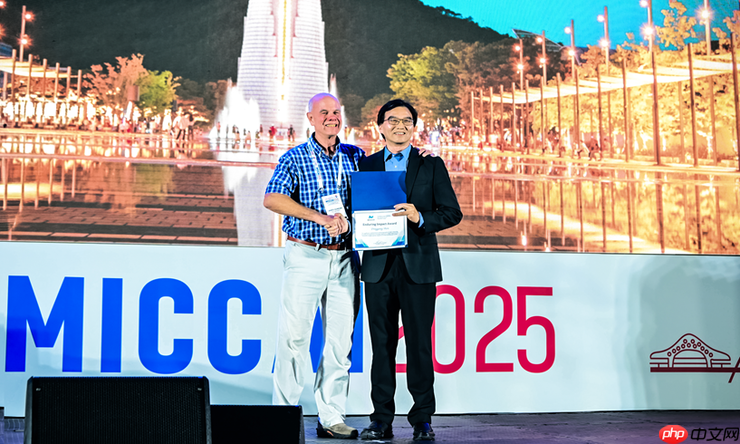
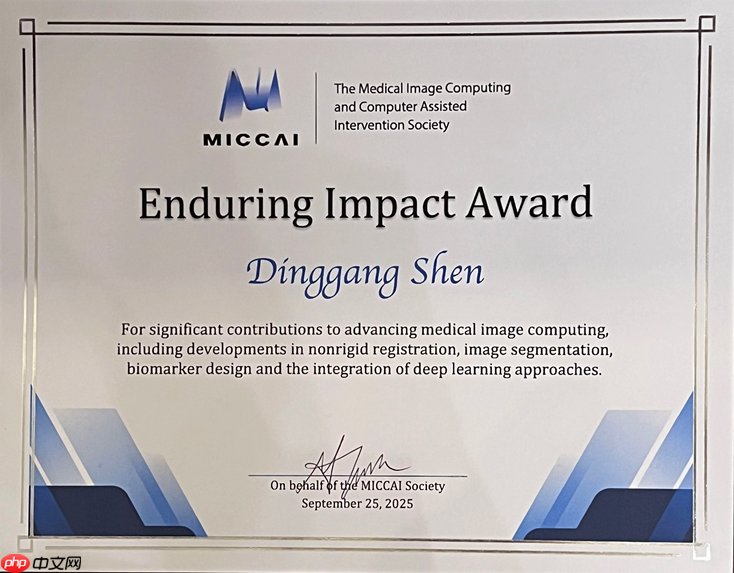
  • 顶级学术会议MICCAI最高奖项披露,华人科学家首次获奖!

    顶级学术会议MICCAI最高奖项披露,华人科学家首次获奖!顶级学术会议MICCAI最高奖项披露,华人科学家首次获奖!顶级学术会议MICCAI最高奖项披露,华人科学家首次获奖!顶级学术会议MICCAI最高奖项披露,华人科学家首次获奖!

    9 月 23 日至 27 日,2025 年国际医学影像计算与计算机辅助介入协会(miccai)年会在韩国隆重举行。在此期间,上海科技大学生物医学工程学院创始院长、联影智能联席 ceo 沈定刚荣获大会颁发的 miccai enduring impact award (eia) 持久影响力奖,成为该奖项…

    2026年9月26日 • 用户投稿
    000
  • 2025高分辨率图片生成AI工具Top10榜单

    2025年高分辨率AI图像生成工具将实现技术突破,榜单预测包括DeepImage AI Pro 2025、NVIDIA AI Imaginer 5.0等十款产品,涵盖生成质量、速度、细节控制、Prompt理解与软件兼容性五大维度;当前技术瓶颈集中在计算资源需求大、算法优化难、数据标注成本高,而未来趋…

    2026年9月26日
    200
  • synchronized 关键字的实现原理是什么?它是如何保证线程安全的?

    synchronized 关键字的实现原理是什么?它是如何保证线程安全的?synchronized 关键字的实现原理是什么?它是如何保证线程安全的?synchronized 关键字的实现原理是什么?它是如何保证线程安全的?synchronized 关键字的实现原理是什么?它是如何保证线程安全的?

    synchronized 是 Java 中保证线程安全的核心机制,其本质是通过 JVM 内置的 Monitor(监视器)实现互斥访问。当多个线程竞争同步资源时,synchronized 依靠对象头中的 Mark Word 和锁升级机制(偏向锁 → 轻量级锁 → 重量级锁)动态调整锁的实现方式,以平衡…

    2026年9月26日 • 用户投稿
    100
  • sublime怎么修改默认的python build system_sublime Python默认编译系统修改

    sublime怎么修改默认的python build system_sublime Python默认编译系统修改sublime怎么修改默认的python build system_sublime Python默认编译系统修改sublime怎么修改默认的python build system_sublime Python默认编译系统修改sublime怎么修改默认的python build system_sublime Python默认编译系统修改

    答案:通过创建自定义Build System可指定Python解释器路径和运行参数。1. 在Tools→Build System→New Build System中创建新配置;2. 编辑JSON内容,设置cmd为python路径及-u $file参数,确保shell为true;3. 保存为Pytho…

    2026年9月26日 • 用户投稿
    100
  • readdir在Debian中的安全性问题

    readdir 是 linux 系统中用于列出目录内容的函数,通常在 头文件中声明。在 debian(以及大多数 linux 发行版)中,readdir 函数本身并不直接引入额外的安全风险。然而,当它与系统其他部分结合使用时,可能会受到一些潜在的安全威胁。以下是一些相关的考虑点: 动态链接器劫持和 …

    2026年9月26日
    100
  • sublime怎么调试python代码_sublime配置Python调试环境教程

    sublime怎么调试python代码_sublime配置Python调试环境教程sublime怎么调试python代码_sublime配置Python调试环境教程sublime怎么调试python代码_sublime配置Python调试环境教程sublime怎么调试python代码_sublime配置Python调试环境教程

    配置Sublime Text的Python调试环境需安装SublimeREPL插件以运行交互式脚本,设置自定义Build System实现快捷运行输出,通过插入import pdb; pdb.set_trace()使用pdb进行简单断点调试,并可搭配Anaconda或LSP插件提升编码效率,适用于轻…

    2026年9月26日 • 用户投稿
    000
  • Java 8中的Stream API有哪些常用操作?它是惰性求值的吗?

    Java 8中的Stream API有哪些常用操作?它是惰性求值的吗?Java 8中的Stream API有哪些常用操作?它是惰性求值的吗?Java 8中的Stream API有哪些常用操作?它是惰性求值的吗?Java 8中的Stream API有哪些常用操作?它是惰性求值的吗?

    答案:Java 8的Stream API通过中间操作和终端操作实现惰性求值,提升性能与代码可读性。中间操作如filter、map返回新流且惰性执行,终端操作如forEach、collect触发计算并产生结果。惰性求值避免不必要的计算,支持短路操作,优化管道处理,适用于无限流。使用时需避免副作用、重复…

    2026年9月26日 • 用户投稿
    100
  • 新机遇、新体验、新服务,HarmonyOS 游戏领启未来

    新机遇、新体验、新服务,HarmonyOS 游戏领启未来新机遇、新体验、新服务,HarmonyOS 游戏领启未来新机遇、新体验、新服务,HarmonyOS 游戏领启未来新机遇、新体验、新服务,HarmonyOS 游戏领启未来

    【中国,上海,2025年7月31日】2025年中国国际数字娱乐产业大会(cdec)高峰论坛顺利举行。华为终端云服务互动媒体bu总裁张思建在题为《技术赋能体验创新 harmonyos 游戏领启未来》的演讲中指出,随着harmonyos 5设备数量突破千万大关,鸿蒙系统5已成功通过大规模市场验证,整体用…

    2026年9月26日 • 用户投稿
    400
  • 率先完成 30TB 硬盘测试,希捷携手百度开启 AI 存储新纪元

    率先完成 30TB 硬盘测试,希捷携手百度开启 AI 存储新纪元率先完成 30TB 硬盘测试,希捷携手百度开启 AI 存储新纪元率先完成 30TB 硬盘测试,希捷携手百度开启 AI 存储新纪元率先完成 30TB 硬盘测试,希捷携手百度开启 AI 存储新纪元

    在人工智能技术迅猛发展的背景下,从大规模模型训练到广泛的边缘计算应用,数据以前所未有的速度不断产生。根据 idc 的预测,至 2028 年全球将生成高达 394zb 的数据,其中生成式 ai 贡献超过 100zb。面对如此庞大的数据体量,如何实现安全存储与高效管理,成为亟需解决的关键问题。对于承载数…

    2026年9月26日 • 用户投稿
    100
  • 豆包AI是否能生成代码 豆包代码生成功能及其适用范围分析

    本文将围绕豆包AI是否能生成代码这一问题展开探讨。我们将首先确认其代码生成能力,随后详细讲解如何有效利用此功能,并通过步骤拆解,帮助用户掌握操作过程。最后,会分析该功能的适用场景与潜在局限,以便用户能更全面地理解和运用。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Deep…

    2026年9月26日
    100
  • 优化VSCode远程SSH开发体验与高性能扩展加载方案

    通过优化SSH连接复用、按需加载扩展、预启动远程服务及本地协同调优,可显著提升VSCode远程开发体验。具体包括:配置ControlMaster实现连接共享,减少重复认证;使用高效加密算法加快传输;通过extensionKind分离本地与远程扩展,降低远程负载;设置VSCODE_AGENT_FOLD…

    2026年9月26日
    000
  • 如何利用Nginx日志进行安全监控

    如何利用Nginx日志进行安全监控如何利用Nginx日志进行安全监控如何利用Nginx日志进行安全监控如何利用Nginx日志进行安全监控

    保障网站和应用安全,Nginx日志安全监控至关重要。本文将详细介绍关键步骤和最佳实践。 一、Nginx日志配置与启用 默认配置: Nginx通常已启用访问日志和错误日志记录。请确保日志文件配置正确并妥善存储。日志格式: 建议使用标准日志格式,方便后续分析。例如: log_format main ‘$…

    2026年9月26日 • 用户投稿
    000
  • 构建健壮的Java用户输入:Scanner整数解析与异常捕获

    构建健壮的Java用户输入:Scanner整数解析与异常捕获构建健壮的Java用户输入:Scanner整数解析与异常捕获构建健壮的Java用户输入:Scanner整数解析与异常捕获构建健壮的Java用户输入:Scanner整数解析与异常捕获

    本文深入探讨了Java Scanner在获取整数输入时,当用户输入非整数数据可能引发的InputMismatchException。我们将解释此异常的产生机制,并提供一种健壮的解决方案:通过结合try-catch语句有效捕获并处理该异常,从而避免程序崩溃,提升用户交互的稳定性与友好性。 1. Jav…

    2026年9月26日 • 用户投稿
    000
  • 利好!TikTokShop欧洲市场入驻标准更新

    利好!TikTokShop欧洲市场入驻标准更新利好!TikTokShop欧洲市场入驻标准更新利好!TikTokShop欧洲市场入驻标准更新利好!TikTokShop欧洲市场入驻标准更新

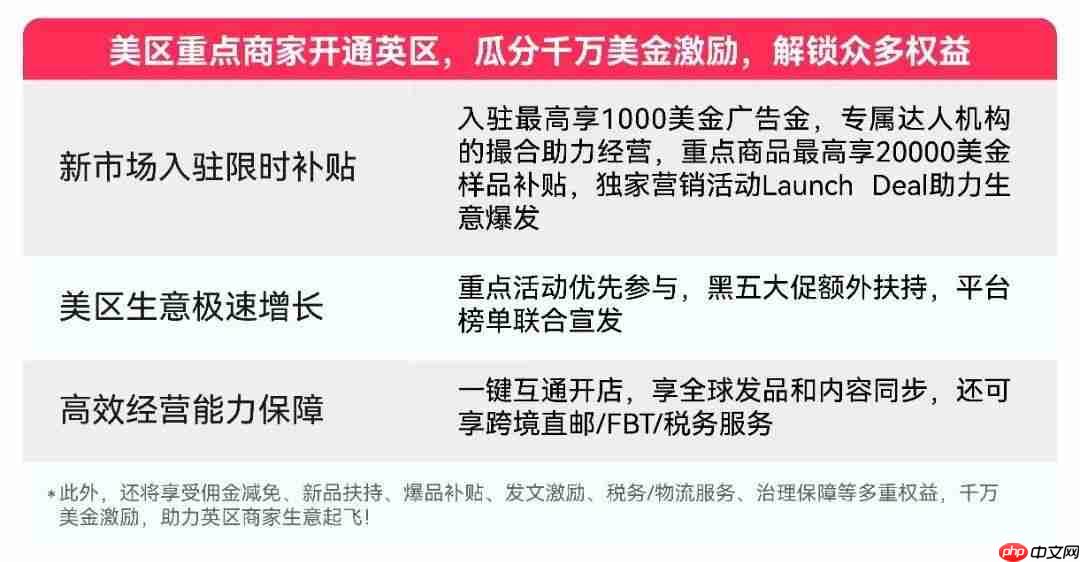
    近日,tiktokshop跨境电商针对欧洲市场释放利好信号!英国、西班牙、德国、意大利、法国欧洲五国跨境自运营(pop)模式,入驻标准更新及商家扶持新政策迎来官宣。 最新招商政策中,新商的调整核心在于,商家的第三方电商平台运营经验由【必填】调整为【选填】。同时,TikTokShop美区重点商家、有亚…

    2026年9月26日 • 用户投稿
    000
  • 怎么让豆包AI生成Python数据可视化代码

    怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码怎么让豆包AI生成Python数据可视化代码

    明确需求、指定图表类型和库、提供数据结构或示例,能高效让豆包ai生成python可视化代码。1. 先说明要画什么图,如“柱状图”;2. 指定用哪个库,如matplotlib或seaborn;3. 提供数据结构或部分数据;4. 检查生成代码是否完整,必要时补充导入语句或显示命令。 ☞☞☞AI 智能聊天…

    2026年9月26日 • 用户投稿
    000
  • 京东新卡支付安全吗?信用卡支付安全吗?全面解析支付安全机制

    京东新卡支付安全吗?信用卡支付安全吗?全面解析支付安全机制京东新卡支付安全吗?信用卡支付安全吗?全面解析支付安全机制京东新卡支付安全吗?信用卡支付安全吗?全面解析支付安全机制京东新卡支付安全吗?信用卡支付安全吗?全面解析支付安全机制

    “网购时绑定新银行卡会不会被盗刷?””信用卡在平台消费是否存在风险?”随着京东等电商平台支付场景的不断拓展,用户对支付安全的关注度持续攀升。本文深入剖析京东新卡支付与信用卡支付的安全机制,用技术逻辑和平台规则消除你的顾虑。 一、京东新卡支付安全机制解析 1. 什么是京东新卡支付? 当用户首次在京东使…

    2026年9月26日 • 用户投稿
    000
  • Tomcat日志中常见的性能瓶颈是什么

    在tomcat日志中,常见的性能瓶颈主要包括以下几个方面: 线程数配置不当: 问题描述:Tomcat的线程数配置不合理可能导致请求堆积或线程资源浪费。如果线程数过少,可能无法处理高并发请求,导致请求延迟增加。相反,线程数过多可能导致频繁的上下文切换和资源竞争,影响性能。解决方法:根据服务器的硬件资源…

    2026年9月26日
    000
  • 《少林vs武当:传奇》上架Steam 暂不支持中文

    《少林vs武当:传奇》上架Steam 暂不支持中文《少林vs武当:传奇》上架Steam 暂不支持中文《少林vs武当:传奇》上架Steam 暂不支持中文《少林vs武当:传奇》上架Steam 暂不支持中文

    近日,格斗游戏新作《少林vs武当:传奇》(shaolin vs wutang legends)正式登陆steam平台,目前尚未公布具体发售时间,且暂未提供中文支持。 Steam商店页面:[点击前往](https://www.php.cn/link/b1a5a84a3388b3f37634445bd1…

    2026年9月26日 • 用户投稿
    000
  • 雷神 911 主机如何测试 M.2 接口?带宽性能评估​

    雷神 911 主机如何测试 M.2 接口?带宽性能评估​雷神 911 主机如何测试 M.2 接口?带宽性能评估​雷神 911 主机如何测试 M.2 接口?带宽性能评估​雷神 911 主机如何测试 M.2 接口?带宽性能评估​

    要测试雷神 911 主机 m.2 接口的带宽性能,首先确认其支持的协议(pcie 或 sata)及规格,可查阅主板说明书或使用硬件检测工具;准备 m.2 ssd、最新驱动、windows 10/11 系统及测试软件如 crystaldiskmark 和 as ssd benchmark;运行测试并记…

    2026年9月26日 • 用户投稿
    000
  • 如何在Java方法中正确传递和使用数组参数

    如何在Java方法中正确传递和使用数组参数如何在Java方法中正确传递和使用数组参数如何在Java方法中正确传递和使用数组参数如何在Java方法中正确传递和使用数组参数

    本文旨在帮助Java初学者理解如何在方法中正确传递和使用数组作为参数。通过一个实际的代码示例,详细讲解了如何创建、传递和访问数组,以及如何在方法内部对数组进行操作,最终返回期望的结果。掌握这些技巧对于编写高效且功能完善的Java程序至关重要。 在Java编程中,方法经常需要接收数组作为参数,以便对一…

    2026年9月26日 • 用户投稿
    500

发表回复

登录后才能评论
关注微信