解决PyTorch GAN训练中的梯度计算错误:inplace操作与计算图分离

解决PyTorch GAN训练中的梯度计算错误:inplace操作与计算图分离

本文旨在解决PyTorch GAN训练中常见的RuntimeError: one of the variables needed for gradient computation has been modified by an inplace operation错误。该错误通常源于生成器和判别器在共享计算图时,梯度计算顺序不当或未正确隔离梯度流。核心解决方案是利用tensor.detach()方法,在计算判别器损失时,切断生成器输出与计算图的连接,从而确保梯度计算的独立性与正确性。

理解PyTorch中的梯度计算与inplace操作错误

在pytorch中,runtimeerror: one of the variables needed for gradient computation has been modified by an inplace operation是一个常见的错误,尤其在使用autograd进行复杂模型训练时。这个错误表明在进行反向传播(梯度计算)时,某个变量在计算图中被“原地”(inplace)修改了,导致pytorch无法正确地计算其梯度,因为它需要该变量的原始状态。

对于生成对抗网络(GANs)这类包含多个相互作用网络的模型,这种错误尤为常见。GANs的训练涉及到生成器(Generator, G)和判别器(Discriminator, D)的交替优化。判别器试图区分真实样本和生成器生成的假样本,而生成器则试图生成足以欺骗判别器的假样本。这意味着判别器在训练时需要依赖生成器的输出,但其梯度不应回传到生成器。

原始代码中,loss_nonsaturating函数同时计算了判别器损失d_loss和生成器损失g_loss。

def loss_nonsaturating(d, g, x_real, *, device):    z = torch.randn(x_real.shape[0], g.z_dim, device=device)    gz = g(z) # 生成器输出的假样本    dgz = F.sigmoid(d(gz)) # 判别器对假样本的判断    dx = d(x_real) # 判别器对真实样本的判断    real_label = torch.ones(x_real.shape[0], device=device)    fake_label = torch.zeros(x_real.shape[0], device=device)    bce_loss = F.binary_cross_entropy_with_logits    g_loss = bce_loss(dgz, real_label).mean() # 生成器损失依赖dgz    d_loss = bce_loss(dx, real_label).mean() + bce_loss(dgz, fake_label).mean() # 判别器损失也依赖dgz    return d_loss, g_loss

然后在训练循环中,先对d_loss进行反向传播,再对g_loss进行反向传播:

d_optimizer.zero_grad()d_loss.backward(retain_graph=True) # 判别器反向传播,保留计算图d_optimizer.step()g_optimizer.zero_grad()g_loss.backward() # 生成器反向传播g_optimizer.step()

问题出在d_loss和g_loss都依赖于d(gz),而d(gz)又依赖于g(z)。当d_loss.backward(retain_graph=True)执行时,它会计算判别器参数的梯度,并可能对计算图中的某些中间变量进行操作(例如,释放内存或修改状态)。尽管retain_graph=True参数试图保留计算图以供后续使用,但如果后续的g_loss.backward()尝试访问已被修改或释放的中间变量,就会触发inplace操作错误。在这种情况下,错误提示[torch.FloatTensor [512, 1]], which is output 0 of AsStridedBackward0, is at version 2; expected version 1 instead明确指出某个张量在期望版本1时,已被修改为版本2,导致梯度计算失败。

解决方案:分离计算图

解决此问题的核心在于明确区分生成器和判别器的梯度流。判别器在训练时需要看到生成器生成的假样本,但其优化过程不应影响生成器的参数。这意味着在计算判别器关于假样本的损失时,需要切断生成器输出的梯度流。PyTorch提供了tensor.detach()方法来完成这一任务。

tensor.detach()会创建一个新的张量,它与原张量共享底层数据,但不再是计算图的一部分。这意味着对这个新张量的任何操作都不会记录在计算图中,也不会触发梯度回传到原张量。

在GAN训练中,当判别器处理生成器输出的假样本时,我们希望判别器能够学习区分这些假样本,但我们不希望判别器的梯度回传到生成器。因此,应该在将生成器输出的假样本传递给判别器之前,对其调用.detach()。

修正后的训练逻辑

以下是修正后的训练循环,展示了如何正确使用detach()来分离生成器和判别器的梯度流:

import torchimport torch.nn as nnimport torch.nn.functional as Ffrom tqdm import tqdm# 假设 Reshape, Generator, Discriminator 类已定义如原问题所示# 这里仅为示例,省略具体实现细节class Reshape(torch.nn.Module):    def __init__(self, *shape):        super().__init__()        self.shape = shape    def forward(self, x):        return x.reshape(x.size(0), *self.shape)class Generator(torch.nn.Module):    def __init__(self, z_dim=64, num_channels=1):        super().__init__()        self.z_dim = z_dim        self.net = nn.Sequential(            nn.Linear(z_dim, 512),            nn.BatchNorm1d(512),            nn.ReLU(),            nn.Linear(512, 64 * 7 * 7),            nn.BatchNorm1d(64 * 7 * 7),            nn.ReLU(),            Reshape(64, 7, 7),            nn.PixelShuffle(2),            nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1),            nn.BatchNorm2d(32),            nn.ReLU(),            nn.PixelShuffle(2),            nn.Conv2d(in_channels=8, out_channels=1, kernel_size=3, padding=1)        )    def forward(self, z):        return self.net(z)class Discriminator(torch.nn.Module):    def __init__(self, num_channels=1):        super().__init__()        self.net = nn.Sequential(            nn.Conv2d(in_channels=1, out_channels=32, kernel_size=4, padding=1, stride=2),            nn.ReLU(),            nn.Conv2d(in_channels=32, out_channels=64, kernel_size=4, padding=1, stride=2),            nn.ReLU(),            Reshape(64*7*7),            nn.Linear(64*7*7, 512),            nn.ReLU(),            nn.Linear(512, 1),            Reshape() # Output a scalar        )    def forward(self, x):        return self.net(x)# 辅助函数,模拟数据加载def build_input(x, y, device):    x_real = x.to(device)    y_real = y.to(device)    return x_real, y_real# 模拟训练数据加载器class DummyDataLoader:    def __init__(self, num_batches, batch_size, image_size, num_channels):        self.num_batches = num_batches        self.batch_size = batch_size        self.image_size = image_size        self.num_channels = num_channels    def __iter__(self):        for _ in range(self.num_batches):            x = torch.randn(self.batch_size, self.num_channels, self.image_size, self.image_size)            y = torch.randint(0, 10, (self.batch_size,)) # Dummy labels            yield x, y    def __len__(self):        return self.num_batches# 模拟训练设置num_latents = 64device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')g = Generator(z_dim=num_latents).to(device)d = Discriminator().to(device)g_optimizer = torch.optim.Adam(g.parameters(), lr=1e-3)d_optimizer = torch.optim.Adam(d.parameters(), lr=1e-3)iter_max = 1000batch_size = 64image_size = 28num_channels = 1train_loader = DummyDataLoader(iter_max, batch_size, image_size, num_channels)# 修正后的训练循环with tqdm(total=int(iter_max)) as pbar:    for idx, (x, y) in enumerate(train_loader):        x_real, y_real = build_input(x, y, device)        # --------------------- 训练判别器 ---------------------        d_optimizer.zero_grad()        # 判别器处理真实样本        real_output = d(x_real)        real_label = torch.ones(x_real.shape[0], 1, device=device) # 确保标签维度匹配判别器输出        d_loss_real = F.binary_cross_entropy_with_logits(real_output, real_label).mean()        # 生成假样本并分离计算图        z = torch.randn(x_real.shape[0], g.z_dim, device=device)        with torch.no_grad(): # 在生成假样本时,可以暂时禁用梯度计算,但detach更常用且灵活            fake_samples = g(z).detach() # 关键步骤:分离生成器输出的计算图        # 判别器处理假样本        fake_output = d(fake_samples)        fake_label = torch.zeros(x_real.shape[0], 1, device=device) # 确保标签维度匹配判别器输出        d_loss_fake = F.binary_cross_entropy_with_logits(fake_output, fake_label).mean()        # 总判别器损失        d_loss = d_loss_real + d_loss_fake        d_loss.backward()        d_optimizer.step()        # --------------------- 训练生成器 ---------------------        g_optimizer.zero_grad()        # 重新生成假样本(这次不分离,因为需要梯度回传到生成器)        z = torch.randn(x_real.shape[0], g.z_dim, device=device)        gen_samples = g(z)        # 判别器对新生成的假样本的判断        gen_output = d(gen_samples)        # 生成器希望判别器将假样本判为真        g_loss = F.binary_cross_entropy_with_logits(gen_output, real_label).mean()        g_loss.backward()        g_optimizer.step()        pbar.set_description(f"D_loss: {d_loss.item():.4f}, G_loss: {g_loss.item():.4f}")        pbar.update(1)print("训练完成!")

在上述修正代码中:

判别器训练阶段:生成器产生假样本g(z)。关键一步:fake_samples = g(z).detach()。这将生成器输出的假样本从计算图中分离出来。当这些fake_samples被传递给判别器d并计算d_loss_fake时,梯度将不会回传到生成器g。d_loss.backward()执行时,只计算判别器参数的梯度,不会影响生成器。生成器训练阶段:生成器重新产生假样本gen_samples = g(z)。这次没有使用.detach(),因为生成器需要通过判别器的输出回传梯度来更新自身参数。g_loss.backward()执行时,梯度会从g_loss通过判别器d回传到生成器g的参数。

通过这种方式,生成器和判别器的梯度计算过程被清晰地隔离,避免了因共享计算图而导致的inplace操作错误。同时,也不再需要retain_graph=True,因为每个网络的梯度计算都在独立的计算路径上完成。

注意事项与总结

detach() vs with torch.no_grad(): detach()通常用于在计算图中间切断梯度流,返回一个新的张量。with torch.no_grad():是一个上下文管理器,在该块内的所有操作都不会记录梯度,常用于推理或评估阶段,或在训练中明确不希望某些部分计算梯度时。在GANs中,当判别器处理生成器输出的假样本时,使用detach()更精确地表达了“只使用数据,不追踪其来源梯度”的意图。标签维度匹配: 确保损失函数中的标签张量维度与模型输出张量的维度匹配,例如,如果判别器输出是(batch_size, 1),则标签也应是(batch_size, 1)。优化器清零: 在每次迭代开始时,务必调用optimizer.zero_grad()来清除之前迭代的梯度,防止梯度累积。交替训练: GANs通常采用交替训练策略,即在一个训练步骤中先更新判别器,再更新生成器。这种分离的训练流程是成功的关键。

通过正确理解并应用tensor.detach()来管理GANs训练中的梯度流,可以有效避免inplace操作错误,确保模型能够稳定且高效地学习。这种技术不仅适用于GANs,也适用于任何需要隔离子网络梯度计算的多网络训练场景。

以上就是解决PyTorch GAN训练中的梯度计算错误:inplace操作与计算图分离的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1375069.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
解决Web抓取时HTML输出在终端被截断的问题
上一篇 2025年12月14日 14:41:34
Pyheif安装教程:解决缺失libheif依赖的问题
下一篇 2025年12月14日 14:41:42

相关推荐

  • 洗碗机普及迎来攻坚战,行业探寻市场爆发“黄金拐点”

    洗碗机普及迎来攻坚战,行业探寻市场爆发“黄金拐点”洗碗机普及迎来攻坚战,行业探寻市场爆发“黄金拐点”洗碗机普及迎来攻坚战,行业探寻市场爆发“黄金拐点”洗碗机普及迎来攻坚战,行业探寻市场爆发“黄金拐点”

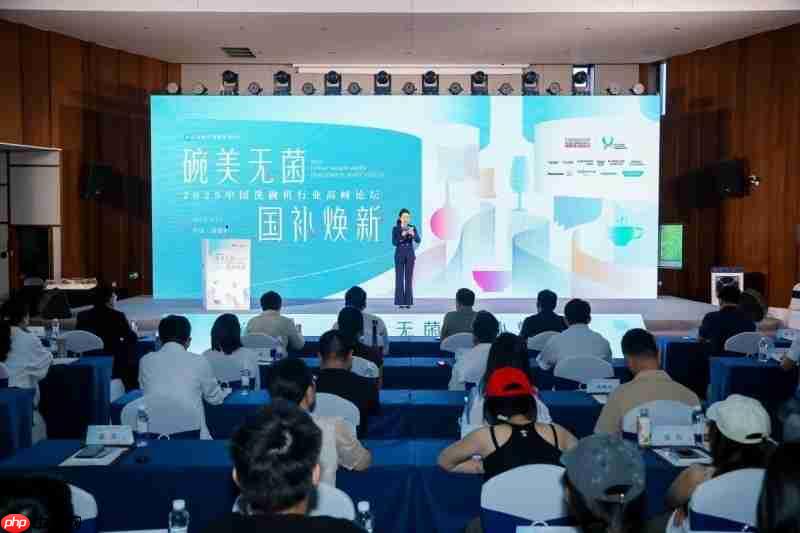
    家电行业中,谁是最被看好的“潜力股”之一?洗碗机当之不让。但是现实困境却是,洗碗机渗透率徘徊在4%左右迟迟难以突破,原因何在,又该如何破局? 2025年9月17日,由中国家电网主办的“碗美无菌国补焕新2025中国洗碗机行业高峰论坛”在千年瓷都景德镇拉开帷幕,来自A.O.史密斯、卡萨帝、finish亮…

    2026年9月28日 • 用户投稿
    000
  • 如何用豆包AI生成Python环境配置代码

    如何用豆包AI生成Python环境配置代码如何用豆包AI生成Python环境配置代码如何用豆包AI生成Python环境配置代码如何用豆包AI生成Python环境配置代码

    豆包ai可辅助生成python环境配置代码。1. 首先明确项目需求,如python版本、依赖库和虚拟环境类型;2. 向豆包ai输入具体提示词,获取创建venv和requirements.txt的命令;3. 如需复杂配置,可要求生成开发与生产环境分离的依赖文件;4. 注意版本控制、输出验证及通过多轮交…

    2026年9月28日 • 用户投稿
    100
  • 豆包AI生成项目预算表的技巧 快速规划资源投入的指南

    豆包AI生成项目预算表的技巧 快速规划资源投入的指南豆包AI生成项目预算表的技巧 快速规划资源投入的指南豆包AI生成项目预算表的技巧 快速规划资源投入的指南豆包AI生成项目预算表的技巧 快速规划资源投入的指南

    做项目预算的关键是明确目标与合理分类。首先需明确项目目标和范围,向豆包ai输入一句话生成初步预算框架;其次将预算分为人力、技术、外包等清晰类别,并用工具生成参考表格;三要为每项预算预留弹性空间,尤其ai项目的不确定性环节;四要定期更新对比预算,利用豆包ai的协作功能跟踪变化并分析调整。 ☞☞☞AI …

    2026年9月28日 • 用户投稿
    100
  • 十一小长假肆意畅玩!华硕RTX5060甜品卡全力助能

    十一小长假肆意畅玩!华硕RTX5060甜品卡全力助能十一小长假肆意畅玩!华硕RTX5060甜品卡全力助能十一小长假肆意畅玩!华硕RTX5060甜品卡全力助能十一小长假肆意畅玩!华硕RTX5060甜品卡全力助能

    十一假期的脚步渐近,想想即将到来的悠闲小长假,小伙伴们准备怎样度过呢?宅家开启电竞狂欢才是明智之选!在这个假期,有诸多佳作等你来战,准备好投身一场热血沸腾的电竞之旅了吗~ 想要顺利畅享游戏大作带来的极致体验,DLSS技术的支持至关重要。DLSS是一套创新性的神经网络渲染技术,借助AI提升帧率、降低延…

    2026年9月28日 • 用户投稿
    400
  • 使用 Java 泛型实现 CSV 到对象的转换器

    使用 Java 泛型实现 CSV 到对象的转换器使用 Java 泛型实现 CSV 到对象的转换器使用 Java 泛型实现 CSV 到对象的转换器使用 Java 泛型实现 CSV 到对象的转换器

    本文将介绍如何使用 Java 泛型创建一个通用的 CSV 到对象的转换器。通过泛型,我们可以避免为每种需要转换的 Java 类编写重复的代码,从而提高代码的可重用性和可维护性。文章将提供代码示例,并讨论一些关于代码设计和现有 CSV 解析库的建议。 泛型 CSV 工具类 使用 Java 泛型可以创建…

    2026年9月28日 • 用户投稿
    100
  • 怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解

    怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解

    xml数据解析借助豆包ai可简化为四个步骤:1. 发送xml内容让ai分析结构,明确标签层级与关键节点;2. 要求ai生成对应语言的解析代码,如python使用elementtree提取数据;3. 利用ai检查并修复格式错误,如未闭合标签或缺失引号;4. 指定需提取字段及输出格式,如json或csv…

    2026年9月28日 • 用户投稿
    100
  • 图片生成3d效果图的ai工具2025前十榜单

    2025年图片生成3D效果图的AI工具将由多模态理解、高效三维重建与用户友好性领先的平台主导,核心在于简化建模流程、提升真实感与可编辑性,融合NeRF、高斯泼溅与扩散模型等技术,实现从2D图像到高质量3D资产的智能转换,赋能设计、游戏、电商等领域。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索…

    2026年9月28日
    400
  • sublime怎么配置ctags实现函数跳转_Sublime配置CTags实现代码定义与函数跳转

    sublime怎么配置ctags实现函数跳转_Sublime配置CTags实现代码定义与函数跳转sublime怎么配置ctags实现函数跳转_Sublime配置CTags实现代码定义与函数跳转sublime怎么配置ctags实现函数跳转_Sublime配置CTags实现代码定义与函数跳转sublime怎么配置ctags实现函数跳转_Sublime配置CTags实现代码定义与函数跳转

    答案:配置Sublime Text函数跳转需安装CTags工具并设置SublimeCTags插件。先通过包管理器或手动安装Universal/Exuberant Ctags,确保命令行可执行;再在Sublime中用Package Control安装SublimeCTags插件;接着在用户设置中指定c…

    2026年9月28日 • 用户投稿
    100
  • 如何利用Elser AI Comics批量生成漫画并提高创作效率?

    如何利用Elser AI Comics批量生成漫画并提高创作效率?如何利用Elser AI Comics批量生成漫画并提高创作效率?如何利用Elser AI Comics批量生成漫画并提高创作效率?如何利用Elser AI Comics批量生成漫画并提高创作效率?

    用elser ai comics批量生成漫画的关键在于掌握模板机制、角色统一设定和自动分镜功能。一、提前规划内容结构,明确每话大纲、角色、剧情节点和关键台词,写剧本草稿并标注重点画面,统一角色设定以节省调整时间;二、使用自定义模板保存常用构图、配色和字体,实现风格统一与快速复用,例如封面、回顾格与对…

    2026年9月28日 • 用户投稿
    300
  • 马斯克的 Grok 聊天机器人以超低价赢得美国政府合约

    马斯克的 Grok 聊天机器人以超低价赢得美国政府合约马斯克的 Grok 聊天机器人以超低价赢得美国政府合约马斯克的 Grok 聊天机器人以超低价赢得美国政府合约马斯克的 Grok 聊天机器人以超低价赢得美国政府合约

    埃隆・马斯克旗下的 xAI 公司近日宣布,已与美国联邦政府达成一项重要协议:其开发的人工智能聊天机器人 Grok 将以极低的价格向联邦机构提供服务。 根据与美国总务管理局签订的合同,各联邦部门在未来一年半内使用 Grok,每单位服务费用仅为42美分,远低于1美元的市场主流定价。这一价格显著低于目前在…

    2026年9月28日 • 用户投稿
    100
  • 告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧

    告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧

    告别加班的核心在于利用豆包ai集成deepseek的能力实现办公自动化。1. excel数据清洗与分析可由自然语言描述规则,自动完成数据清洗、分析及图表生成;2. word文档批量处理支持文本替换、格式调整等操作,提升文档编辑效率;3. 复杂文档生成通过模板和数据自动填充,实现合同、简历等个性化文档…

    2026年9月28日 • 用户投稿
    100
  • Gemini支持材料特性预测吗 Gemini新材料研发辅助功能

    Gemini支持材料特性预测吗 Gemini新材料研发辅助功能Gemini支持材料特性预测吗 Gemini新材料研发辅助功能Gemini支持材料特性预测吗 Gemini新材料研发辅助功能Gemini支持材料特性预测吗 Gemini新材料研发辅助功能

    gemini 正在进军材料特性预测和新材料研发辅助领域,其潜力体现在三个方面:1)加速材料发现周期,通过预测材料性质缩小实验范围,显著提升效率;2)设计具有特定性质的材料,基于需求反向生成结构和组成方案;3)发现隐藏关联,从复杂数据中挖掘影响材料性能的关键因素。gemini 可预测力学、热学、电学、…

    2026年9月28日 • 用户投稿
    100
  • 用豆包AI实现GUI编程?智能设计桌面应用界面

    用豆包AI实现GUI编程?智能设计桌面应用界面用豆包AI实现GUI编程?智能设计桌面应用界面用豆包AI实现GUI编程?智能设计桌面应用界面用豆包AI实现GUI编程?智能设计桌面应用界面

    豆包ai虽非专业gui平台,但能有效辅助界面设计。它可根据自然语言描述生成控件布局、推荐技术方案(如tkinter、pyqt),并输出基础代码片段;具体步骤为:1. 明确需求,2. 用语言引导ai生成结构,3. 选择框架,4. 整合调试代码,5. 手动优化细节;该方式适合新手、原型验证者、跨框架开发…

    2026年9月28日 • 用户投稿
    100
  • sublime怎么配置react开发环境_Sublime搭建React.js开发环境全攻略

    sublime怎么配置react开发环境_Sublime搭建React.js开发环境全攻略sublime怎么配置react开发环境_Sublime搭建React.js开发环境全攻略sublime怎么配置react开发环境_Sublime搭建React.js开发环境全攻略sublime怎么配置react开发环境_Sublime搭建React.js开发环境全攻略

    答案是配置Babel语法高亮、ESLint代码检查和Prettier自动格式化。首先安装Package Control以管理插件,接着安装Babel插件并设置JavaScript (Babel)为默认语法;然后通过Node.js安装ESLint并配置SublimeLinter-eslint进行实时错…

    2026年9月28日 • 用户投稿
    200
  • Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%

    Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%

    9月26日消息,据最新报道,intel拟上调其第13代和第14代酷睿(raptor lake)桌面处理器的售价,涨幅或将超过10%。 据悉,此次调价可能与供应链紧张及AI PC市场需求疲软有关。自2022年10月发布以来,Raptor Lake系列一直担当Intel产品线的主力角色。 尽管该系列已属…

    2026年9月28日 • 用户投稿
    200
  • 怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧

    怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧

    明确提问和引导是用豆包ai写好redis操作代码的关键。1. 先说明使用的编程语言和redis客户端库,如python的redis-py、node.js的ioredis或go的go-redis;2. 指定具体操作类型,如字符串、哈希、列表等,并说明是读还是写操作;3. 结合业务场景提问,例如缓存、限…

    2026年9月28日 • 用户投稿
    600
  • sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化

    sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化

    启用ClearType提升Windows下字体清晰度;2. 在Sublime中设置合适字体与subpixel_antialias;3. 避免非整数缩放防模糊;4. 可选Fira Code连字字体优化可读性。 Sublime Text 的字体渲染效果直接影响编码体验,清晰锐利的字体能减轻视觉疲劳。默认…

    2026年9月28日 • 用户投稿
    100
  • 华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」

    华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」

    大家好,又见面了,我是你们的朋友全栈君。 内存是非常重要的系统资源,是硬盘和CPU的中间仓库及桥梁,承载着os和应用程序的实时运行。 JVM内存布局规定了Java在运行过程中内存申请、分配、管理的策略,保证了JVM高效稳定运行。不同JVM对于内存的划分方式和管理机制存在差异。结合JVM虚拟机规范,来…

    2026年9月28日 • 用户投稿
    200
  • 360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹

    360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹

    首先通过设置菜单清除浏览数据,进入“更多工具”选择“清除上网痕迹”,勾选历史记录、缓存、Cookie等项后立即清除;其次手动删除用户数据文件夹,关闭浏览器后在%localappdata%360ChromeChromeUser Data路径下重命名或删除Default文件夹;再使用CCleaner等系…

    2026年9月28日 • 用户投稿
    100
  • Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力

    Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力

    ollama 正式发布“web search”api,使大语言模型具备实时获取互联网信息的能力,显著提升回答准确率并有效降低幻觉现象。 该功能以 REST API 形式开放,并已深度集成至 Ollama 的 Python 和 JavaScript SDK 中,便于开发者在各类应用中快速接入与调用。同…

    2026年9月28日 • 用户投稿
    200

发表回复

登录后才能评论
关注微信