Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python中基于文本匹配JSON数据并提取关联URL信息_创想鸟

Python中基于文本匹配JSON数据并提取关联URL信息

Python中基于文本匹配JSON数据并提取关联URL信息

本教程详细介绍了如何使用Python处理JSON和文本文件,通过正则表达式从文本中提取特定模式的设备名称,并以此名称作为键,在JSON结构化数据中查找匹配项,最终提取并展示关联的URL信息。文章涵盖了文件读写、JSON解析、正则表达式应用及数据遍历等核心技术,旨在提供一个高效、实用的数据整合解决方案。

1. 概述

在日常数据处理中,我们经常会遇到需要从非结构化文本中提取关键信息,并将其与结构化数据(如json)进行关联匹配的场景。本教程将以一个具体示例,演示如何利用python的json模块进行json数据解析,re模块进行正则表达式匹配,从而实现从纯文本文件中识别设备名称,并在一个包含设备详细信息的json文件中找到对应的记录,最终提取出所需的url字段。

2. 准备工作

在开始编写代码之前,我们需要准备两个示例文件:一个JSON文件(test.json)和一个纯文本文件(test.txt)。

2.1 JSON文件 (test.json)

这个文件包含了多个设备的信息,每个设备都有一个唯一的名称和多个关联的URL。

{  "results": [    {      "url": "https://api.server.com/cables/100/",      "termination_a": {        "url": "https://api.server.com/interfaces/250/",        "device": {          "url": "https://api.server.com/devices/10/",          "display": "device-number1-2023-08 myname (1718)",          "name": "device-number1-2023-08 myname1"        }      }    },    {      "url": "https://api.server.com/cables/200/",      "termination_a": {        "url": "https://api.server.com/interfaces/160/",        "device": {          "url": "https://api.server.com/devices/22/",          "display": "device-number3-2023-08 myname (2245)",          "name": "device-number3-2023-08 myname3"        }      }    },    {      "url": "https://api.server.com/cables/300/",      "termination_a": {        "url": "https://api.server.com/interfaces/260/",        "device": {          "url": "https://api.server.com/devices/73/",          "display": "device-number8-2023-08 myname (3678)",          "name": "device-number8-2023-08 myname8"        }      }    }  ]}

2.2 文本文件 (test.txt)

这个文件包含了一些描述性文本,其中嵌入了我们想要匹配的设备名称。

this is device-number1-2023-08 myname1 and it is good.this is device-number8-2023-08 myname8 and it is.this is device-number3-2023-08 myname3 and it is not good.this is an unmatched-device-name and it is irrelevant.

3. 实现步骤与代码

我们将通过以下步骤实现目标:

立即学习“Python免费学习笔记(深入)”;

读取并解析JSON文件。读取文本文件内容。使用正则表达式从文本内容中提取所有设备名称。遍历JSON数据,将JSON中的设备名称与从文本中提取的名称进行比对。如果名称匹配,则打印出JSON中对应的URL信息。

3.1 示例代码

import jsonimport redef find_and_extract_urls(json_filepath, text_filepath):    """    从文本文件中提取设备名称,并在JSON文件中查找匹配的设备,    然后打印出关联的URL信息。    Args:        json_filepath (str): JSON文件的路径。        text_filepath (str): 文本文件的路径。    """    # 1. 读取并解析JSON文件    try:        with open(json_filepath, 'r', encoding='utf-8') as json_file:            json_data = json.load(json_file)    except FileNotFoundError:        print(f"错误: 未找到JSON文件 '{json_filepath}'")        return    except json.JSONDecodeError:        print(f"错误: JSON文件 '{json_filepath}' 格式不正确")        return    # 2. 读取文本文件内容    try:        with open(text_filepath, 'r', encoding='utf-8') as text_file:            text_content = text_file.read()    except FileNotFoundError:        print(f"错误: 未找到文本文件 '{text_filepath}'")        return    # 3. 使用正则表达式从文本内容中提取所有设备名称    # 正则表达式解释:    # (device-w+-d+-d+ w+): 捕获组,匹配 'device-' 开头,    # 接着是任意单词字符 (w+),然后是两个数字组 (d+),    # 最后是一个空格和任意单词字符 (w+)。    # 示例匹配: "device-number1-2023-08 myname1"    txt_device_names = re.findall(r"(device-w+-d+-d+ w+)", text_content)    # 将提取到的名称转换为集合,以便O(1)时间复杂度进行查找,提高效率    txt_device_names_set = set(txt_device_names)    print(f"从文本文件 '{text_filepath}' 中提取到的设备名称: {txt_device_names_set}n")    # 4. 遍历JSON数据,查找匹配项并提取URL    found_matches = False    for item in json_data.get("results", []): # 使用.get()处理'results'键可能不存在的情况        device_info = item.get("termination_a", {}).get("device", {})        json_device_name = device_info.get("name")        if json_device_name and json_device_name in txt_device_names_set:            found_matches = True            print(f"匹配成功!设备名称 --> {json_device_name}")            print(f"  根URL: {item.get('url', 'N/A')}")            print(f"  termination_a URL: {item.get('termination_a', {}).get('url', 'N/A')}")            # 如果需要,还可以打印其他URL,例如 termination_a device URL            # print(f"  termination_a device URL: {device_info.get('url', 'N/A')}")            print("-" * 30)    if not found_matches:        print("未找到任何匹配的设备名称。")# 调用函数执行匹配和提取if __name__ == "__main__":    json_file_path = 'test.json'    text_file_path = 'test.txt'    find_and_extract_urls(json_file_path, text_file_path)

3.2 代码解释

导入模块: json 用于处理JSON数据,re 用于正则表达式操作。文件读取:使用 with open(…) 语句确保文件在操作完成后被正确关闭,即使发生错误。json.load(json_file) 将JSON文件内容解析为Python字典。text_file.read() 读取整个文本文件的内容到一个字符串。增加了 try-except 块来处理 FileNotFoundError 和 json.JSONDecodeError,增强程序的健壮性。正则表达式匹配:re.findall(r”(device-w+-d+-d+ w+)”, text_content) 是核心。r”…” 表示这是一个原始字符串,避免反斜杠的转义问题。(device-w+-d+-d+ w+) 是正则表达式模式,用于捕获符合特定格式的设备名称。device-: 字面匹配 “device-“。w+: 匹配一个或多个字母、数字或下划线。d+: 匹配一个或多个数字。` `: 匹配一个空格。(): 捕获组,表示我们想要提取括号内的内容。txt_device_names 将是一个包含所有匹配到的设备名称的列表。将 txt_device_names 转换为 set (txt_device_names_set) 是一个重要的优化,它使得后续在循环中检查 json_device_name in txt_device_names_set 的操作具有平均 O(1) 的时间复杂度,而如果使用列表则为 O(n),在大数据量时性能差异显著。数据遍历与匹配:代码遍历 json_data[“results”] 列表中的每一个字典(代表一个设备)。通过 item.get(“termination_a”, {}).get(“device”, {}).get(“name”) 安全地访问嵌套字典中的设备名称。使用 .get() 方法可以在键不存在时返回默认值(这里是空字典或 None),避免 KeyError。if json_device_name and json_device_name in txt_device_names_set: 判断从JSON中获取的设备名称是否存在于从文本中提取的名称集合中。如果匹配成功,则打印出根URL (item[‘url’]) 和 termination_a 下的URL (item[‘termination_a’][‘url’])。同样,使用 .get() 方法安全地访问这些URL。

4. 运行结果

执行上述Python脚本,你将看到如下输出:

从文本文件 'test.txt' 中提取到的设备名称: {'device-number8-2023-08 myname8', 'device-number1-2023-08 myname1', 'device-number3-2023-08 myname3'}匹配成功!设备名称 --> device-number1-2023-08 myname1  根URL: https://api.server.com/cables/100/  termination_a URL: https://api.server.com/interfaces/250/------------------------------匹配成功!设备名称 --> device-number3-2023-08 myname3  根URL: https://api.server.com/cables/200/  termination_a URL: https://api.server.com/interfaces/160/------------------------------匹配成功!设备名称 --> device-number8-2023-08 myname8  根URL: https://api.server.com/cables/300/  termination_a URL: https://api.server.com/interfaces/260/------------------------------

5. 注意事项与扩展

正则表达式的准确性: 正则表达式是此解决方案的关键。确保你的模式能够准确捕获目标字符串,同时避免误匹配。如果设备名称的格式发生变化,你需要相应地调整正则表达式。性能优化: 对于非常大的文本文件,逐行读取并处理可能比一次性读取整个文件更节省内存。对于非常大的JSON文件,考虑使用流式解析(如 ijson 库)而不是一次性加载到内存。错误处理: 在实际应用中,应增加更完善的错误处理机制,例如处理文件不存在、JSON格式错误、数据结构不符合预期等情况。本教程已包含基本的 try-except 块。数据结构灵活性: 如果JSON数据的结构可能变化,访问嵌套字段时应更多地使用 dict.get() 方法,并提供默认值,以防止 KeyError。输出格式: 根据实际需求调整输出的格式和内容。你可以将提取到的信息存储到新的数据结构中,或者写入到新的文件里。

6. 总结

本教程展示了如何结合Python的文件I/O、JSON解析和正则表达式,高效地从非结构化文本中提取信息,并与结构化数据进行匹配和关联。这种方法在数据清洗、数据集成和自动化报告等多种场景下都非常实用。通过理解并灵活运用这些技术,你可以构建出强大的数据处理脚本,以

以上就是Python中基于文本匹配JSON数据并提取关联URL信息的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1376672.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
解决Python asyncio中异步任务执行顺序与依赖性问题
上一篇 2025年12月14日 16:06:14
Python pathlib 模块:从完整路径中提取当前目录名称
下一篇 2025年12月14日 16:06:31

相关推荐

  • mysql如何进入编辑模式 mysql输入sql语句创建数据库

    mysql如何进入编辑模式 mysql输入sql语句创建数据库mysql如何进入编辑模式 mysql输入sql语句创建数据库mysql如何进入编辑模式 mysql输入sql语句创建数据库mysql如何进入编辑模式 mysql输入sql语句创建数据库

    创建mysql数据库需登录后执行sql语句;避免sql注入用参数化查询、输入验证、最小权限原则、waf;解决乱码需统一客户端、数据库、表编码为utf8mb4;优化查询性能可通过索引、explain分析、避免select *、使用join、分页优化、定期维护、硬件升级、缓存。 想要用MySQL创建数据…

    2026年9月23日 • 用户投稿
    1500
  • Asianux 7.3安装Oracle 11.2.0.4单实例体验

    在asianux 7.3环境中安装#%#$#%@%@%$#%$#%#%#$%@_a189c++633d9995e11bf8607170ec9a4b8 11.2.0.4单实例的具体步骤和注意事项如下: 环境:Asianux 7.3 需求:安装Oracle 11.2.0.4 单实例 背景:系统使用默认的…

    2026年9月23日
    200
  • VSCode管理FPGA约束文件(高效编辑方法,时序约束指南)

    使用vscode高效编辑fpga约束文件的方法包括:1. 安装“better comments”和“bracket pair colorizer”等插件以提升可读性和编辑效率;2. 利用代码片段功能创建常用约束模板,如时钟和i/o约束,通过关键词快速插入以减少重复输入和错误;3. 使用支持正则表达式…

    2026年9月23日
    000
  • 如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧

    如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧如何在Krita中使用AI裁剪图片?快速掌握高效图像裁剪技巧

    Krita虽无内置AI裁剪功能,但可通过其构图辅助线、选区与变换工具实现“智能”裁剪,并结合外部AI工具完成内容扩展与智能构图,形成高效工作流。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ Krita本身,作为一款强大的开源数字绘画与图像…

    2026年9月23日 • 用户投稿
    200
  • 在Loom中利用虚拟线程实现递归任务:告别ForkJoinPool的限制

    本文探讨了Java Loom中RecursiveAction和RecursiveTask与虚拟线程的兼容性。由于它们设计上依赖于ForkJoinPool及其特定的工作线程,无法直接与虚拟线程配合使用。文章提供了两种替代方案:一是利用CompletableFuture结合虚拟线程工厂实现自定义递归任务…

    2026年9月23日
    500
  • 《蝎之尾》攻略——游戏配置要求介绍

    《蝎之尾》(tail of scorpios)是由jabberworks打造的一款设定在架空历史背景下的悬疑推理类视觉小说游戏。该游戏不仅剧情引人入胜,画面表现也相当出色,同时对设备的硬件要求较为亲民,最低仅需1.6ghz单核的intel或amd处理器即可运行。 《蝎之尾》最低配置要求如下: 操作系…

    2026年9月23日
    200
  • CodeIgniter 动态多数据库连接与数据导入实践指南

    本文详细介绍了在 CodeIgniter 框架中,如何根据用户输入的动态数据库凭证建立并管理第二个数据库连接。通过构建自定义连接配置数组,并利用 CodeIgniter 的数据库加载机制,开发者可以灵活地切换数据库实例,从而实现从外部数据库导入数据到主数据库的功能,提升应用的灵活性和数据处理能力。 …

    2026年9月23日
    000
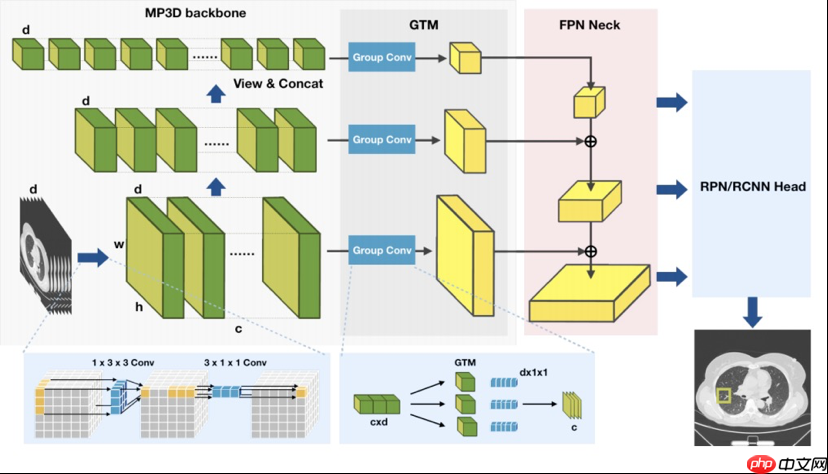
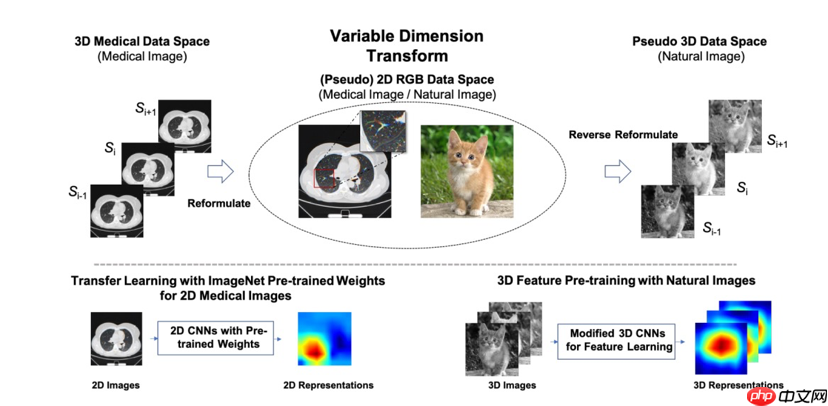
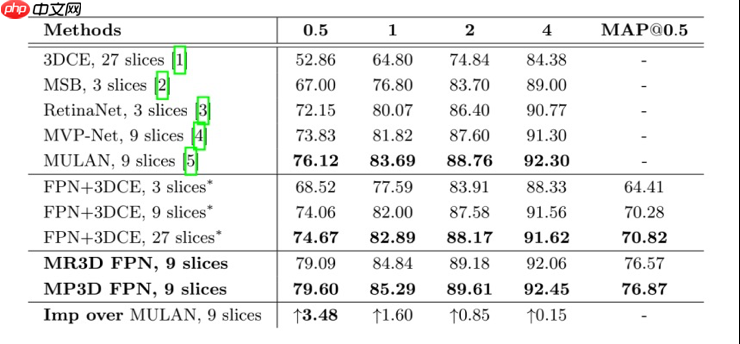
  • MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)

    MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)MICCAI 2020 | 基于3D监督预训练的全身病灶检测SOTA(预训练代码和模型已公开)

    ▊ 研究背景介绍 由于深度学习任务通常依赖大量标注数据,医疗图像的标注需要专业知识,标注人员需精确判断病灶的大小、形状、边缘等信息,甚至需要经验丰富的专家进行多次评估,这增加了深度学习在医疗领域应用的难度。 目前,尽管有一些公开数据集(如LIDC-IDRI、LUNA等)可供使用,但这些数据集的图像数…

    2026年9月23日 • 用户投稿
    200
  • 2025内存条最新榜单 内存条品牌排行榜前十名盘点

    为您的电脑挑选合适的内存条是提升整体性能的关键一步。面对市场上琳琅满目的品牌,选择可能变得困难。本文为您整理了2025年最值得关注的内存条品牌排行榜,帮助您清晰地了解各大品牌的特点,为您的设备升级或新机配置提供有力参考。 一、2025内存条品牌排行榜前十名 1、海盗船 (Corsair):作为高端硬…

    2026年9月23日
    100
  • 如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程

    如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程如何使用TensorFlowLite训练AI大模型?移动端模型优化的教程

    TensorFlow Lite通过模型转换、量化、剪枝等优化手段,将训练好的大模型压缩并加速,使其能在移动端高效推理。首先在服务器端训练模型,随后用TFLiteConverter转为.tflite格式,结合量化(如Float16或全整数量化)、量化感知训练、剪枝和聚类等技术减小模型体积、提升运行速度…

    2026年9月23日 • 用户投稿
    000
  • 抖音ai分身怎么关闭?抖音AI怎么关闭

    作为广受欢迎的短视频社交平台,抖音通过其AI分身功能为用户带来了更具个性化的推荐体验。但如何停用这一功能也逐渐成为用户关心的问题。本文将为您详细介绍如何关闭抖音的AI分身,并探讨在享受个性化推荐的同时如何保障个人隐私。 一、抖音AI分身功能概述 抖音的AI分身是基于人工智能技术,通过对用户的兴趣偏好…

    2026年9月23日
    000
  • mysql怎么修改索引 mysql索引创建与更新操作教程

    mysql怎么修改索引 mysql索引创建与更新操作教程mysql怎么修改索引 mysql索引创建与更新操作教程mysql怎么修改索引 mysql索引创建与更新操作教程mysql怎么修改索引 mysql索引创建与更新操作教程

    mysql中修改索引的正确方法是删除旧索引并创建新索引,因为mysql不支持直接修改索引结构;1. 创建索引可通过create index或alter table add index实现,用于加速数据检索;2. 删除索引使用drop index或alter table drop index,操作前需…

    2026年9月23日 • 用户投稿
    200
  • Hibernate 3.6 Criteria API 根别名设置行为解析

    在Hibernate 3.6版本中,使用getSession().createCriteria(Entity.class, “myAlias”)尝试为根实体设置自定义表别名时,生成的SQL语句中的根别名仍可能默认为this_,而非用户指定的别名。这源于Hibernate内部C…

    2026年9月23日
    100
  • VSCode如何管理技术债务 VSCode代码质量跟踪的实用方法

    eslint、pylint等linter类扩展可实时识别代码问题,从源头减少技术债务;2. sonarlint能集成sonarqube规则,深度检测代码异味并提供修复建议;3. code metrics可量化函数圈复杂度等指标,帮助定位高风险代码;4. todo tree将todo、fixme等注释…

    2026年9月23日
    000
  • 谷歌浏览器如何更改界面语言_谷歌浏览器界面语言修改方法

    1、打开谷歌浏览器设置,添加简体中文并设为显示语言,重启生效;2、在macOS语言与地区中将中文拖至首选语言顶部以同步系统设置;3、若未生效,可清除Chrome的Preferences缓存文件重置配置。 如果您在使用谷歌浏览器时希望将其界面语言更改为其他语言,可能是因为系统默认语言不符合您的使用习惯…

    2026年9月23日
    000
  • win11无法将网络位置从公用更改为专用怎么办_win11网络位置从公用改专用修复方法

    首先通过设置应用尝试更改网络配置文件类型,若失败则依次采用本地安全策略编辑器、重置网络配置文件或PowerShell命令行方式解决,确保网络从公用更改为专用。 如果您尝试在Windows 11中更改网络位置类型,但发现无法将网络从公用更改为专用,则可能是由于系统策略、网络配置文件异常或用户权限问题导…

    2026年9月23日
    100
  • ClipStudioPaint的AI混合工具怎么操作?优化漫画创作的步骤

    AI混合工具是高效上色助手而非替代者,通过高质量线稿与色彩提示,快速生成基础颜色,显著提升漫画上色效率;其局限在于缺乏艺术理解与复杂光影处理能力,需人工精修光影、材质与色彩情绪,结合分层调整与选区工具优化,实现从自动化底稿到艺术化成品的转化。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免…

    2026年9月23日
    000
  • WooCommerce教程:有选择地从订单邮件通知中移除产品购买备注

    本文将指导您如何通过自定义代码,在WooCommerce的特定订单邮件通知中移除产品购买备注。默认情况下,购买备注会出现在订单确认邮件和订单完成邮件中。但有时,您可能希望仅在订单确认邮件中显示这些备注,而在订单完成邮件中将其隐藏。以下步骤将帮助您实现这一目标。 步骤 1: 理解问题 直接使用wooc…

    2026年9月23日
    200
  • PC玩家有福了!《剑星》Steam首次打折 更新今日上线

    PC玩家有福了!《剑星》Steam首次打折 更新今日上线PC玩家有福了!《剑星》Steam首次打折 更新今日上线PC玩家有福了!《剑星》Steam首次打折 更新今日上线PC玩家有福了!《剑星》Steam首次打折 更新今日上线

    《剑星》今日上线了1.4.0版本补丁,并同步在steam平台开启首发折扣活动。作为游戏自发售以来的首次降价,此次促销也创下了价格新低。标准版与完整版均享受8折优惠,折后价分别为214.4元和286元。 根据星空平台数据,本作整体好评率高达94%,近期玩家评价保持在92%的好评率,而简体中文区玩家的好…

    2026年9月23日 • 用户投稿
    100
  • 夸克浏览器在线连接入口 夸克官网快速直达链接

    夸克浏览器在线使用入口为https://quark.sm.cn/,用户可通过浏览器直接访问、手机应用内跳转、扫描二维码或搜索官网链接进入;其具备AI智能搜索、无广告干扰、多端数据同步及高效安全浏览等优势。 夸克浏览器在线连接入口 夸克官网快速直达链接在哪里?这是不少网友都关注的,接下来由PHP小编为…

    2026年9月23日
    100

发表回复

登录后才能评论
关注微信