Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
优化Celery任务日志:实现stdout/stderr的精细化文件管理_创想鸟

优化Celery任务日志:实现stdout/stderr的精细化文件管理

优化Celery任务日志:实现stdout/stderr的精细化文件管理

本文旨在提供celery任务中stdout/stderr输出的有效管理策略。首先介绍如何将所有celery worker日志统一输出到单个文件,随后重点阐述如何利用python的`logging`模块实现任务级别的日志分离,确保并发任务的输出互不干扰,并提供详细代码示例和最佳实践,帮助开发者构建更健壮、可维护的celery应用。

在开发和部署Celery分布式任务系统时,任务执行过程中的输出信息(如通过print()语句或标准日志记录)对于调试、监控和问题排查至关重要。然而,这些输出默认会混杂在Celery worker的控制台日志中,当多个任务并发执行时,很难区分不同任务的特定输出。本文将探讨两种主要方法来管理和分离Celery任务的日志输出:一是将所有worker日志统一重定向到文件,二是实现任务级别的日志精细化管理。

方法一:将所有Celery Worker日志统一输出到文件

最直接的方法是将整个Celery worker进程的所有日志输出重定向到一个指定的文件。这可以通过在启动worker时使用-f或–logfile命令行选项来实现。

操作步骤:

准备Celery任务代码:创建一个main.py文件,包含一个简单的Celery应用和任务,其中任务内部使用print()输出信息。

# main.pyimport timefrom celery import Celerydef long_run_func():    print('>>> Start running long_run_func()')    time.sleep(5)    print('>>> End running long_run_func()')celery_app = Celery('celery_task', broker='redis://localhost:6379/0')@celery_app.task(name="long_run_celery_task")def long_run_celery_task():    long_run_func()if __name__ == '__main__':    long_run_celery_task.delay()

启动Celery Worker并指定日志文件:使用celery -A命令启动worker,并通过-f参数指定日志文件的路径。

celery -A main:celery_app worker --loglevel=INFO -f celery_worker.log

当运行main.py触发任务后,所有worker的日志输出,包括任务内部的print()语句,都将被写入celery_worker.log文件。

celery_worker.log示例:

[2024-01-13 09:56:04,119: INFO/MainProcess] Task long_run_celery_task[bae57432-18de-4f00-8227-cdf34856cd15] received[2024-01-13 09:56:04,121: WARNING/ForkPoolWorker-7] >>> Start running long_run_func()[2024-01-13 09:56:09,123: WARNING/ForkPoolWorker-7] >>> End running long_run_func()[2024-01-13 09:56:09,127: INFO/ForkPoolWorker-7] Task long_run_celery_task[bae57432-18de-4f00-8227-cdf34856cd15] succeeded in 5.006108791014412s: None

局限性:

此方法虽然简单,但会将所有由该worker处理的任务日志以及worker自身的运行日志混合在一个文件中。对于需要精细化区分不同任务输出的场景,特别是当多个任务并发执行时,这种方式难以满足需求。

方法二:实现任务级别日志分离

为了实现更精细的任务日志管理,尤其是当多个任务并发执行时,避免日志混淆,最佳实践是利用Python标准库中的logging模块。通过为每个任务或任务中的特定逻辑创建独立的日志记录器(Logger)并配置对应的文件处理器(FileHandler),可以轻松地将不同任务的输出写入各自独立的文件。

核心策略:

不再使用print()语句,而是改用logging模块。为每个需要独立日志的任务或功能模块定义一个具有唯一名称的Logger,并为其配置一个FileHandler,指向特定的日志文件。

实现步骤与示例代码:

定义自定义日志器函数:创建一个辅助函数custom_logger,用于根据名称获取或创建日志器,并为其配置一个文件处理器。

# main.py (续)import timeimport loggingimport osfrom celery import Celery# Celery 应用初始化celery_app = Celery(__name__, broker='redis://localhost:6379/0')def custom_logger(name):    """    创建一个具有指定名称和文件处理器的日志器。    """    logger = logging.getLogger(name)    if not logger.handlers: # 避免重复添加处理器        logger.setLevel(logging.INFO)        # 定义日志格式        formatter = logging.Formatter('%(asctime)s - %(name)s - %(levelname)s - %(message)s')        # 创建文件处理器,每个任务/模块一个日志文件        handler = logging.FileHandler(os.path.join(f'{name}.log'), 'a') # 'a' for append mode        handler.setFormatter(formatter)        logger.addHandler(handler)    return loggerdef long_run_func():    l = custom_logger("long_task") # 获取名为 "long_task" 的日志器    l.info('>>> Start running long_run_func()')    time.sleep(5)    l.info('>>> End running long_run_func()')def short_run_func():    l = custom_logger("short_task") # 获取名为 "short_task" 的日志器    l.info('>>> Start running short_run_func()')    time.sleep(3)    l.info('>>> End running short_run_func()')@celery_app.task(name="long_run_celery_task")def long_run_celery_task():    long_run_func()@celery_app.task(name="short_run_celery_task")def short_run_celery_task():    short_run_func()if __name__ == '__main__':    # 触发两个任务    long_run_celery_task.delay()    short_run_celery_task.delay()

启动Celery Worker:这次启动worker时,不再需要-f参数来指定统一的日志文件,因为任务内部会自行处理日志输出。

celery -A main:celery_app worker --loglevel=INFO

观察日志输出:运行main.py后,long_run_celery_task和short_run_celery_task将分别将其日志输出到long_task.log和short_task.log文件中。

long_task.log示例:

2024-01-13 10:00:00,123 - long_task - INFO - >>> Start running long_run_func()2024-01-13 10:00:05,125 - long_task - INFO - >>> End running long_run_func()

short_task.log示例:

2024-01-13 10:00:00,130 - short_task - INFO - >>> Start running short_run_func()2024-01-13 10:00:03,132 - short_task - INFO - >>> End running short_run_func()

代码解析:

logging.getLogger(name): 获取或创建一个名为name的日志器。如果已存在同名日志器,则返回现有实例,这避免了重复创建。logger.setLevel(logging.INFO): 设置日志器的最低日志级别。只有达到或高于此级别的消息才会被处理。logging.Formatter(…): 定义日志消息的输出格式。%(asctime)s表示时间戳,%(name)s表示日志器名称,%(levelname)s表示日志级别,%(message)s表示日志内容。logging.FileHandler(filename, mode): 创建一个文件处理器,将日志消息写入指定文件。’a’模式表示追加写入。handler.setFormatter(formatter): 将格式化器应用于文件处理器。logger.addHandler(handler): 将文件处理器添加到日志器。一个日志器可以有多个处理器,将日志发送到不同的目的地(如文件、控制台、网络等)。

注意事项与最佳实践

避免重复添加处理器: 在custom_logger函数中,if not logger.handlers:这行代码非常重要,它确保了同一个日志器不会被重复添加文件处理器,否则每次调用custom_logger都会向日志器添加一个新的FileHandler,导致日志重复写入。日志级别管理: 根据需要设置合适的日志级别(DEBUG, INFO, WARNING, ERROR, CRITICAL)。在生产环境中,通常将默认级别设置为INFO或WARNING,以便捕获重要信息而不过载日志系统。日志轮转(Log Rotation): 对于长期运行的任务和生产环境,日志文件会持续增长,占用大量磁盘空间。应考虑使用logging.handlers.RotatingFileHandler或logging.handlers.TimedRotatingFileHandler来实现日志文件的自动轮转和清理,以防止单个日志文件过大。异步日志处理: 在高性能要求的场景下,同步的日志写入操作可能会阻塞任务执行。可以考虑使用logging.handlers.QueueHandler结合QueueListener实现异步日志处理,将日志事件放入队列,由单独的线程进行写入,从而减少对任务主线程的影响。统一日志配置: 对于复杂的应用,建议将日志配置集中管理,例如通过logging.config.dictConfig或fileConfig从配置文件(如YAML、JSON)加载日志配置,而不是硬编码在代码中。Celery内置日志: Celery本身也提供了其自己的日志配置机制。在任务中使用celery_app.log.info()等方法,其输出会遵循Celery worker的整体日志配置。上述方法主要用于任务内部的特定逻辑需要独立日志文件的情况。避免在任务中直接使用print(): 一旦决定采用logging模块进行日志管理,就应该在所有任务和相关函数中统一使用logger.info()、logger.debug()等方法,彻底替代print(),以确保所有输出都能被日志系统捕获和处理。

总结

通过本文介绍的方法,开发者可以有效地管理Celery任务的日志输出。对于简单的场景,使用celery worker -f将所有日志统一输出到文件是可行的。然而,为了实现任务级别的精细化日志管理,特别是在并发任务环境中,强烈推荐利用Python的logging模块为每个任务创建独立的日志器和文件处理器。这种方式不仅提供了清晰的日志分离,还为后续的日志级别控制、格式化、轮转以及更复杂的日志集成(如发送到中央日志系统)奠定了坚实的基础,是构建健壮和可维护Celery应用的关键实践。

以上就是优化Celery任务日志:实现stdout/stderr的精细化文件管理的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1379454.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
解决Python包安装中Rust/Cargo依赖引发的Subprocess错误
上一篇 2025年12月14日 20:40:50
Django在Docker中URL 404排查:容器更新与URL识别问题
下一篇 2025年12月14日 20:41:03

相关推荐

  • 想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​

    想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​想让豆包和 AI 穿搭建议工具结合打造时尚造型?操作方法​

    豆包可辅助打造ai穿搭建议工具,但需结合其他模型与技术。1.明确目标场景:基础搭配推荐、个性化定制或虚拟试穿,决定所需ai类型;2.利用现有ai模型如style dna做搭配引擎,kolors实现虚拟试衣;3.选择api对接或搭建中台实现系统整合;4.收集用户画像与衣柜信息提升推荐精准度;5.通过豆…

    2026年9月26日 • 用户投稿
    000
  • 免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南

    免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南免费PPT生成支持多人协作吗_免费工具实现PPT协作的指南

    选择支持多人协作的免费PPT工具可高效完成演示文稿制作。一、WPS Office在线版:登录官网后新建演示文稿,通过共享链接设置“可编辑”权限,团队成员即可实时协同编辑,光标与修改痕迹同步显示。二、Microsoft PowerPoint Online:使用Microsoft账户登录Office官网…

    2026年9月25日 • 用户投稿
    200
  • sublime怎么解决高分屏下UI过小的问题_sublime界面缩放与高清屏适配方法

    sublime怎么解决高分屏下UI过小的问题_sublime界面缩放与高清屏适配方法sublime怎么解决高分屏下UI过小的问题_sublime界面缩放与高清屏适配方法sublime怎么解决高分屏下UI过小的问题_sublime界面缩放与高清屏适配方法sublime怎么解决高分屏下UI过小的问题_sublime界面缩放与高清屏适配方法

    首先修改配置文件实现高分屏适配,通过Preferences→Settings添加”ui_scale”:1.25可调整整体界面缩放,其次单独设置”font_size”:14提升代码可读性,最后利用Package Control安装Ayu等现代主题优化显示…

    2026年9月25日 • 用户投稿
    500
  • 使用正则表达式判断字符串中字符是否全部唯一

    使用正则表达式判断字符串中字符是否全部唯一使用正则表达式判断字符串中字符是否全部唯一使用正则表达式判断字符串中字符是否全部唯一使用正则表达式判断字符串中字符是否全部唯一

    本文介绍如何使用Java正则表达式来判断一个字符串中的所有字符是否都是唯一的。我们将探讨一种使用正则表达式检测字符串中是否存在重复字符的方法,并提供相应的Java代码示例。通过本文,你将学习如何利用正则表达式的强大功能来解决字符串处理中的常见问题。 在字符串处理中,经常需要判断一个字符串中的字符是否…

    2026年9月25日 • 用户投稿
    000
  • 用豆包AI生成Python数据挖掘代码

    用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码用豆包AI生成Python数据挖掘代码

    想用豆包ai生成python数据挖掘代码的关键在于明确任务目标和数据结构。1. 首先明确数据挖掘任务类型,如分类、聚类或回归,并具体描述需求,例如“根据用户年龄、消费金额和购买频率做客户分群”。2. 接着提供清晰的数据格式与来源,比如说明csv文件中的字段信息,以便ai进行数据预处理和建模。3. 要…

    2026年9月25日 • 用户投稿
    900
  • sublime怎么解决许可证密钥(license key)无效问题 _sublime许可证密钥无效修复方法

    sublime怎么解决许可证密钥(license key)无效问题 _sublime许可证密钥无效修复方法sublime怎么解决许可证密钥(license key)无效问题 _sublime许可证密钥无效修复方法sublime怎么解决许可证密钥(license key)无效问题 _sublime许可证密钥无效修复方法sublime怎么解决许可证密钥(license key)无效问题 _sublime许可证密钥无效修复方法

    使用官方购买的正版密钥并清除非法残留可解决Sublime Text许可证无效问题,确保正确输入用户名和多行密钥,删除Local目录下的License.sublime_license文件,检查hosts文件是否屏蔽验证域名,重启软件后即可恢复正常。 Sublime Text 出现许可证密钥无效的问题,…

    2026年9月25日 • 用户投稿
    200
  • 淘宝支付方式无法切换怎么办 支付设置修改与修复方法

    淘宝支付方式无法切换怎么办 支付设置修改与修复方法淘宝支付方式无法切换怎么办 支付设置修改与修复方法淘宝支付方式无法切换怎么办 支付设置修改与修复方法淘宝支付方式无法切换怎么办 支付设置修改与修复方法

    首先检查默认支付设置并更换支付渠道,确认各支付方式状态正常,清除淘宝缓存或重启应用,更新淘宝与支付宝至最新版本,切换网络环境或尝试网页端操作,若仍无法解决则联系客服处理。 淘宝支付方式无法切换,可能是由于账户设置、网络问题或系统缓存导致。别着急,大多数情况下通过简单的设置调整就能解决。以下是几种常见…

    2026年9月25日 • 用户投稿
    100
  • Debian系统OpenSSL漏洞修复

    Debian系统OpenSSL漏洞修复Debian系统OpenSSL漏洞修复Debian系统OpenSSL漏洞修复Debian系统OpenSSL漏洞修复

    确保Debian系统的OpenSSL安全,请遵循以下步骤: 一、系统更新: 首先,更新您的Debian系统至最新版本。使用以下命令更新软件包列表并升级所有已安装软件: sudo apt updatesudo apt upgrade 二、版本确认: 检查当前OpenSSL版本: openssl ver…

    2026年9月25日 • 用户投稿
    100
  • RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

    RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启RTX 5080整机塞进保时捷911轮毂!通过钥匙开机重启

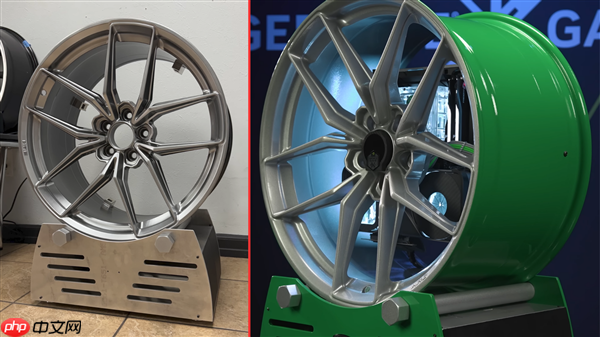
    10月13日,当汽车与高性能计算相遇,会激发出怎样的创意奇迹?nvidia在最新一期geforce garage节目中揭晓了答案。 这一次,他们携手改装界传奇人物JCustom(Justin Chu),将一台完整的RTX 5080游戏主机巧妙植入保时捷911的轮毂之中,实现了汽车工艺与电脑科技的惊艳…

    2026年9月25日 • 用户投稿
    100
  • 亚马逊拟再次向AI创企Anthropic投资数十亿美元

    亚马逊拟再次向AI创企Anthropic投资数十亿美元亚马逊拟再次向AI创企Anthropic投资数十亿美元亚马逊拟再次向AI创企Anthropic投资数十亿美元亚马逊拟再次向AI创企Anthropic投资数十亿美元

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 有消息透露,亚马逊正计划再度向人工智能企业Anthropic注资数十亿美元,旨在深化两家公司的战略合作关系。据悉,此次潜在的投资可能在去年11月承诺的80亿美元基础上进一步加码。 早在2024年…

    2026年9月25日 • 用户投稿
    100
  • 获取物品名称并转换为字符串时出现乱码的解决方案

    获取物品名称并转换为字符串时出现乱码的解决方案获取物品名称并转换为字符串时出现乱码的解决方案获取物品名称并转换为字符串时出现乱码的解决方案获取物品名称并转换为字符串时出现乱码的解决方案

    本文旨在解决在 Minecraft Spigot 插件开发中,获取玩家放置的物品名称并尝试将其转换为字符串时出现乱码的问题。通过分析问题原因,并提供正确的代码示例,帮助开发者避免类似错误,从而更有效地获取玩家名称。 在 Spigot 插件开发中,当玩家放置方块时,我们可能需要获取该方块对应的玩家名称…

    2026年9月25日 • 用户投稿
    100
  • Tomcat日志如何帮助排查内存泄漏

    Tomcat日志如何帮助排查内存泄漏Tomcat日志如何帮助排查内存泄漏Tomcat日志如何帮助排查内存泄漏Tomcat日志如何帮助排查内存泄漏

    Tomcat日志是诊断内存泄漏问题的关键。通过分析Tomcat日志,您可以深入了解内存使用情况和垃圾回收(GC)行为,从而有效定位和解决内存泄漏。以下是如何利用Tomcat日志排查内存泄漏: 1. GC日志分析 首先,启用详细的GC日志记录。在Tomcat启动参数中添加以下JVM选项: -XX:+P…

    2026年9月25日 • 用户投稿
    000
  • 尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署

    尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署

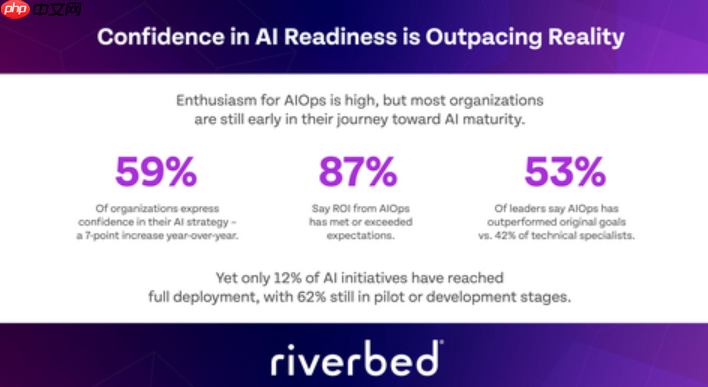
    根据 Riverbed 最新发布的全球调查报告,企业在人工智能(AI)采用方面展现出强烈承诺,并正在对 IT 运营进行战略性重塑以支撑 AI 发展。尽管整体 AI 投资额几乎翻倍,且高达 87% 的组织表示其 AIOps 项目的投资回报已达到或超出预期,但仅有 12% 的 AI 项目实现了全企业范围…

    2026年9月25日 • 用户投稿
    000
  • Bukkit插件开发:正确处理物品显示名称与玩家识别

    Bukkit插件开发:正确处理物品显示名称与玩家识别Bukkit插件开发:正确处理物品显示名称与玩家识别Bukkit插件开发:正确处理物品显示名称与玩家识别Bukkit插件开发:正确处理物品显示名称与玩家识别

    本文旨在解决Bukkit插件开发中,从BlockPlaceEvent获取物品显示名称并将其用于玩家识别时常见的“乱码”问题。我们将深入探讨Component对象与纯文本字符串的区别,并提供两种核心解决方案:直接获取放置方块的玩家名称,以及如何正确地将Component转换为纯文本字符串,以避免不必要…

    2026年9月25日 • 用户投稿
    300
  • 云上书阁app如何绑定手机号_云上书阁app提升账户安全性操作

    云上书阁app如何绑定手机号_云上书阁app提升账户安全性操作云上书阁app如何绑定手机号_云上书阁app提升账户安全性操作云上书阁app如何绑定手机号_云上书阁app提升账户安全性操作云上书阁app如何绑定手机号_云上书阁app提升账户安全性操作

    绑定手机号可提升云上书阁App账户安全性,支持通过“我的”页面或设置菜单操作:进入账号与安全选项,输入手机号并验证短信验证码即可完成绑定。 如果您希望为云上书阁App的账户增加一层保护,绑定手机号是一项关键的安全措施。完成绑定后,您将能更方便地找回密码、接收安全提醒,并提升账户的整体安全性。 本文运…

    2026年9月25日 • 用户投稿
    000
  • sublime怎么折叠所有代码_sublime代码折叠快捷方法

    sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法sublime怎么折叠所有代码_sublime代码折叠快捷方法

    Sublime Text 支持多种代码折叠快捷键,Windows/Linux 使用 Ctrl + Shift + [/] 折叠/展开代码块,Ctrl + K, Ctrl + 1 展开所有用 Ctrl + K, Ctrl + J,macOS 用户将 Ctrl 替换为 Command。 在 Sublim…

    2026年9月25日 • 用户投稿
    200
  • vivo Z5的GPU是什么

    vivo Z5的GPU是什么vivo Z5的GPU是什么vivo Z5的GPU是什么vivo Z5的GPU是什么

    vivo Z5 搭载了 Adreno 612 GPU,与前代相比,其性能提升 35%,能效更高,支持 HDR10+,兼容 Vulkan 和 OpenGL ES,并集成了 Qualcomm AI Engine,可加速机器学习任务。 vivo Z5 的 GPU vivo Z5 智能手机搭载了 Adren…

    2026年9月25日 • 用户投稿
    000
  • 华硕TUF RTX 4090显卡拆解 19相供电设计分析

    华硕TUF RTX 4090显卡拆解 19相供电设计分析华硕TUF RTX 4090显卡拆解 19相供电设计分析华硕TUF RTX 4090显卡拆解 19相供电设计分析华硕TUF RTX 4090显卡拆解 19相供电设计分析

    华硕tuf rtx 4090显卡的19相供电设计相比其他显卡具有更稳定、更纯净的电流输出优势。1. 降低纹波电压,提高gpu核心稳定性;2. 提高供电效率,降低mosfet温度;3. 增强超频潜力,提供更大性能提升空间;4. 延长显卡寿命,降低工作温度。判断其供电设计是否优秀,可从元件选择、pwm控…

    2026年9月25日 • 用户投稿
    000
  • 政府机构 5000 万台电脑将替换为国产 Linux

    政府机构 5000 万台电脑将替换为国产 Linux政府机构 5000 万台电脑将替换为国产 Linux政府机构 5000 万台电脑将替换为国产 Linux政府机构 5000 万台电脑将替换为国产 Linux

    点击上方“芋道源码”,选择“设为星标” 无论是前浪,还是后浪? 只要能浪,就是好浪! 每日 10:33 更新文章,让你每天都有点点收获… 精选源码专栏 原创 | Java 2021 超神之路,很肝~带中文详细注释的开源项目Dubbo RPC 框架源码解析Netty 网络应用框架源码解析R…

    2026年9月25日 • 用户投稿
    400
  • 想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​想将 AI 模型组装工具与豆包联用完成模型组装?方法详解​

    ai模型组装工具与豆包联用是可行且高效的,关键在于接口兼容性、数据流转和部署方式。具体步骤如下:1. 理解豆包的模型接入规范,包括支持的模型格式、api调用方式及资源需求;2. 在组装工具中完成模型构建、训练与导出,确保符合平台要求;3. 如需转换模型格式(如pytorch转onnx),使用相应工具…

    2026年9月25日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信