Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
PLY Lexer规则定义最佳实践:Token返回与优先级管理_创想鸟

PLY Lexer规则定义最佳实践:Token返回与优先级管理

PLY Lexer规则定义最佳实践:Token返回与优先级管理

本文深入探讨python ply库在构建词法分析器时常见的两个关键问题:token规则函数未正确返回token对象,以及token规则之间的优先级冲突。通过详细分析`pass`语句的误用和通用规则对特定规则的遮蔽效应,文章提供了两种有效的解决方案,包括在通用规则中内联处理特定关键字和调整规则定义顺序,旨在帮助开发者构建健壮、高效的ply词法分析器。

PLY Lexer工作原理概述

PLY(Python Lex-Yacc)是一个用于在Python中实现词法分析器(Lexer)和语法分析器(Parser)的库。Lexer负责将输入文本分解成一系列有意义的符号,即Token。每个Token都有一个类型(type)和一个值(value)。在PLY中,我们通过定义一系列以t_开头的函数或字符串变量来指定Token的正则表达式规则。

一个常见的陷阱是,即使正则表达式匹配成功,如果Token规则函数没有明确返回一个Token对象,Lexer也无法生成有效的Token。此外,当多个正则表达式可能匹配同一段文本时,PLY会根据其内部机制(最长匹配优先,然后是定义顺序)来解决冲突,这可能导致意料之外的Token识别错误。

核心问题一:Token规则函数未返回Token对象

在PLY中,使用函数定义Token规则时,该函数必须返回一个t(Token)对象。如果函数体中只包含pass语句,它将隐式返回None,导致Lexer无法生成任何Token,进而使Parser无数据可解析。

考虑以下错误的Token规则定义:

import ply.lex as leximport ply.yacc as yacctokens = ['WORDS','VERBS']def t_WORDS(t):    r'[A-Za-z]+'    pass # 错误:这里应返回tdef t_VERBS(t):    r'(is|are|am)'    pass # 错误:这里也应返回t# ... 省略其他Lexer和Parser代码

在这种情况下,无论输入什么字符串,Lexer都不会产生Token,因为t_WORDS和t_VERBS函数都返回了None。

解决方案:确保Token函数返回t对象

正确的做法是在每个Token规则函数匹配成功后,明确返回传入的t对象。PLY会自动将匹配到的文本存储在t.value中,并根据函数名或t.type属性设置Token类型。

def t_WORDS(t):    r'[A-Za-z]+'    return t # 正确:返回Token对象def t_VERBS(t):    r'(is|are|am)'    return t # 正确:返回Token对象

这是PLY Lexer能够正常工作的基础。

核心问题二:Token规则的优先级与冲突

PLY在处理Token规则时,存在一个优先级机制。当多个正则表达式可能匹配同一段输入时,PLY会遵循以下规则:

最长匹配优先:优先选择匹配文本最长的规则。定义顺序优先:如果多个规则匹配长度相同,则优先选择在代码中定义靠前的规则(对于函数定义的规则而言)。

示例分析:通用规则遮蔽特定规则

在提供的示例中,t_WORDS规则r'[A-Za-z]+’可以匹配任何由字母组成的单词,包括”is”、”are”、”am”。如果t_WORDS在t_VERBS之前定义,或者即使在之后定义,由于t_WORDS的正则表达式更通用,当它匹配到”is”、”are”等词时,可能会将其识别为WORDS类型的Token,而不是更具体的VERBS类型。

例如,当输入”This are”时,如果t_WORDS和t_VERBS都返回t,且t_WORDS先被定义或其规则更“贪婪”,”are”可能会被识别为WORDS而不是VERBS,导致语法分析失败。

# 假设以下定义顺序def t_WORDS(t):    r'[A-Za-z]+'    return tdef t_VERBS(t):    r'(is|are|am)'    return t 

在这种情况下,”are”会被t_WORDS匹配,并生成一个WORDS Token。t_VERBS规则将永远不会被触发,因为t_WORDS的通用性将其“遮蔽”了。

解决方案一:合并规则并在函数内部判断

一种常见的做法是将具有特定含义的关键字(如动词)与通用单词规则合并处理。在匹配到通用单词后,可以在函数内部检查其值是否属于特定关键字集合,并相应地修改Token的类型。

import ply.lex as leximport ply.yacc as yacctokens = ['WORDS','VERBS']def t_WORDS(t):    r'[A-Za-z]+'    # 检查匹配到的单词是否是动词    if t.value.lower() in ['am', 'is', 'are']:        t.type = 'VERBS' # 如果是动词,则改变Token类型    return t # 必须返回t# t_VERBS规则在这种方案下可以移除或不定义,因为动词在t_WORDS中处理了t_ignore = ' tn'def t_error(t):    print(f'Lexical error: Unexpected character "{t.value[0]}"')    t.lexer.skip(1)def p_sentence(p):    'sentence : WORDS VERBS'    p[0] = p[1] + " " + p[2] # 组合结果,中间加空格def p_error(p):    if p:        print(f"Syntax error at '{p.value}'")    else:        print("Syntax error at EOF")lexer = lex.lex()parser = yacc.yacc()while True:    try:        sentence = input("Sentence : ")        if not sentence:            break        result = parser.parse(sentence)        print(f"Parsed result: {result}")    except EOFError:        break    except Exception as e:        print(f"An error occurred: {e}")

这种方法确保了特定关键字优先被识别为它们应有的类型,同时避免了规则之间的直接冲突。

解决方案二:调整规则定义顺序

PLY对于函数定义的Token规则,会按照它们在代码中出现的顺序进行注册。因此,将更具体、更精确的规则定义在更通用、更宽泛的规则之前,可以确保特定Token优先被匹配。

import ply.lex as leximport ply.yacc as yacctokens = ['WORDS','VERBS']# 更具体的VERBS规则必须在更通用的WORDS规则之前定义def t_VERBS(t):    r'(is|are|am)'    return t # 必须返回tdef t_WORDS(t):    r'[A-Za-z]+'    return t # 必须返回tt_ignore = ' tn'def t_error(t):    print(f'Lexical error: Unexpected character "{t.value[0]}"')    t.lexer.skip(1)def p_sentence(p):    'sentence : WORDS VERBS'    p[0] = p[1] + " " + p[2]def p_error(p):    if p:        print(f"Syntax error at '{p.value}'")    else:        print("Syntax error at EOF")lexer = lex.lex()parser = yacc.yacc()while True:    try:        sentence = input("Sentence : ")        if not sentence:            break        result = parser.parse(sentence)        print(f"Parsed result: {result}")    except EOFError:        break    except Exception as e:        print(f"An error occurred: {e}")

通过将t_VERBS定义在t_WORDS之前,当Lexer遇到”is”、”are”或”am”时,会优先尝试匹配t_VERBS规则。由于t_VERBS是一个精确匹配,它会成功识别这些词为VERBS类型的Token,从而避免了被t_WORDS规则遮蔽。

总结与注意事项

在PLY中构建词法分析器时,请务必注意以下几点:

Token规则函数必须返回t对象:这是最基础也是最容易犯的错误。pass语句会导致函数返回None,使Lexer无法生成Token。理解规则优先级:PLY会优先匹配最长的文本,如果长度相同,则根据规则的定义顺序(函数定义)或正则表达式的排列顺序(字符串定义)来决定。处理规则冲突:方法一:内联处理:将特定关键字的识别逻辑整合到更通用的Token规则函数中,通过修改t.type来区分。这在处理保留字和标识符时非常有效。方法二:调整定义顺序:确保更具体、更精确的Token规则在代码中定义于更通用、更宽泛的规则之前。

通过遵循这些最佳实践,可以有效避免PLY Lexer中常见的正则表达式错误和规则冲突问题,从而构建出更加健壮和准确的词法分析器。

以上就是PLY Lexer规则定义最佳实践:Token返回与优先级管理的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1381605.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
IntelliJ IDEA文件类型识别与管理:从.txt到.py的转换与配置
上一篇 2025年12月14日 23:06:02
Python编程中解决IndexError:优化最长公共前缀算法
下一篇 2025年12月14日 23:06:12

相关推荐

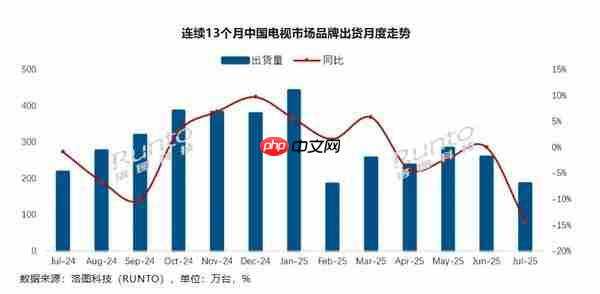
  • 7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二

    7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二7 月中国电视市场出货量为 186.0 万台 海信、TCL 居前二

    8 月 13 日,洛图科技(runto)发布《中国电视市场品牌出货月度快报》。2025 年 7 月,中国电视市场品牌整机出货量为 186.0 万台,较去年同期下降 14.3%,创下近 13 个月来最大的单月同比跌幅;同时,环比 6 月大幅下降 28.2%。 电视 CNMO 注意到,2025 年 7 …

    2026年9月25日 • 用户投稿
    000
  • VSCode如何通过SSH连接远程开发 VSCode远程SSH开发的配置与调试技巧

    安装“remote – ssh”扩展是实现vscode远程开发的基础;2. 配置ssh连接需在~/.ssh/config中设置host、hostname、user、port和identityfile等参数以实现快速连接;3. 连接成功后vscode会自动在远程安装vs code serv…

    2026年9月25日
    400
  • Groovy编程:在HTTP请求头中传递授权令牌的实践指南

    Groovy编程:在HTTP请求头中传递授权令牌的实践指南Groovy编程:在HTTP请求头中传递授权令牌的实践指南Groovy编程:在HTTP请求头中传递授权令牌的实践指南Groovy编程:在HTTP请求头中传递授权令牌的实践指南

    本教程详细介绍了如何在Groovy中通过HTTP请求头发送授权令牌,以实现对RESTful API的安全访问。针对用户在Groovy中模拟curl -H ‘Authorization: token …’命令时遇到的常见问题,本文提供了基于java.net.URL和…

    2026年9月25日 • 用户投稿
    900
  • 如何使用Keras快速构建模型 Keras神经网络搭建入门教程

    如何使用Keras快速构建模型 Keras神经网络搭建入门教程如何使用Keras快速构建模型 Keras神经网络搭建入门教程如何使用Keras快速构建模型 Keras神经网络搭建入门教程如何使用Keras快速构建模型 Keras神经网络搭建入门教程

    使用 keras 快速搭建神经网络模型需掌握以下步骤:1. 安装 keras 并确认后端环境,推荐通过 tensorflow.keras 导入模块;2. 使用 sequential 模型堆叠层,定义输入形状、神经元数量和激活函数;3. 编译模型时选择合适的损失函数、优化器和评估指标;4. 准备数据并…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法

    sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法sublime怎么配置Docker环境进行代码编译 _sublime Docker开发环境配置方法

    Sublime Text可通过插件与Docker集成实现编译运行。1. 安装Terminus和Build Systems插件;2. 项目根目录创建Dockerfile定义环境;3. 配置自定义构建系统调用docker build和run命令;4. 可选使用Terminus面板查看输出,注意路径映射与…

    2026年9月25日 • 用户投稿
    800
  • Word文档插入尾注怎么做_Word文档插入尾注如何做详细方法

    Word文档插入尾注怎么做_Word文档插入尾注如何做详细方法Word文档插入尾注怎么做_Word文档插入尾注如何做详细方法Word文档插入尾注怎么做_Word文档插入尾注如何做详细方法Word文档插入尾注怎么做_Word文档插入尾注如何做详细方法

    插入尾注可提升文档专业性,操作步骤为:1. 定位光标;2. 点击“引用”选项卡;3. 点击“插入尾注”按钮;4. 在文档末尾输入注释内容。可通过“脚注和尾注”对话框自定义位置、编号格式及起始数,删除时建议通过正文编号移除以确保同步,系统会自动重新排序。 在Word文档中插入尾注,可以帮助你在文档末尾…

    2026年9月25日 • 用户投稿
    000
  • laravel怎么清除应用的所有缓存_laravel应用缓存清理方法

    Laravel应用响应异常或配置未生效时,需清除缓存。依次执行php artisan route:clear、config:clear、view:clear和cache:clear命令,可分别清除路由、配置、视图及应用缓存,确保修改生效。 如果您发现 Laravel 应用响应异常或配置更改未生效,可…

    2026年9月25日
    200
  • DeepSeek如何接入本地数据库 数据对接的配置方式与使用注意事项

    DeepSeek如何接入本地数据库 数据对接的配置方式与使用注意事项DeepSeek如何接入本地数据库 数据对接的配置方式与使用注意事项DeepSeek如何接入本地数据库 数据对接的配置方式与使用注意事项DeepSeek如何接入本地数据库 数据对接的配置方式与使用注意事项

    本文旨在介绍如何实现将数据对接至本地数据库,供使用DeepSeek或其他类似模型处理的应用程序进行访问。我们将概述整个过程,包括前期准备工作、详细的配置步骤以及在使用过程中需要注意的重要事项。通过阅读本文,您将了解从环境搭建到数据访问的核心环节,从而能够顺利地将您的本地数据与基于DeepSeek的应…

    2026年9月25日 • 用户投稿
    800
  • DeepSeek部署在云服务器时要注意什么 部署环境配置及安全策略建议

    DeepSeek部署在云服务器时要注意什么 部署环境配置及安全策略建议DeepSeek部署在云服务器时要注意什么 部署环境配置及安全策略建议DeepSeek部署在云服务器时要注意什么 部署环境配置及安全策略建议DeepSeek部署在云服务器时要注意什么 部署环境配置及安全策略建议

    当计划将DeepSeek部署到云服务器上时,细致周到的准备工作对于确保系统的稳定运行和数据安全至关重要。本文将详细介绍在云端部署DeepSeek时需要特别注意的环境配置和安全策略。我们将探讨如何选择合适的服务器资源、安装必要的软件依赖,并实施一系列关键的安全措施,旨在为您提供清晰的操作指导,帮助您顺…

    2026年9月25日 • 用户投稿
    1000
  • 疑似魅族 22 真机曝光 后置方形镜头模组 这颜值打几分?

    疑似魅族 22 真机曝光 后置方形镜头模组 这颜值打几分?疑似魅族 22 真机曝光 后置方形镜头模组 这颜值打几分?疑似魅族 22 真机曝光 后置方形镜头模组 这颜值打几分?疑似魅族 22 真机曝光 后置方形镜头模组 这颜值打几分?

    8 月 18 日,知名数码博主曝光了魅族即将推出的 22 系列真机实拍图。从流出的照片来看,新机在外观设计上迎来重大革新,后置摄像模组由传统的竖向排列调整为方形布局,集成三到四个镜头,模组凸起较为突出,整体呈现出简洁且硬朗的视觉风格。机身侧面疑似采用直角边框设计,进一步增强了整机的立体感与辨识度。 …

    2026年9月25日 • 用户投稿
    000
  • sublime怎么设置python linter_sublime Python Linter配置方法

    sublime怎么设置python linter_sublime Python Linter配置方法sublime怎么设置python linter_sublime Python Linter配置方法sublime怎么设置python linter_sublime Python Linter配置方法sublime怎么设置python linter_sublime Python Linter配置方法

    首先安装SublimeLinter插件及SublimeLinter-pylint或SublimeLinter-flake8,然后通过pip安装pylint或flake8,最后在SublimeLinter设置中配置Python可执行文件路径和检查模式,启用实时与保存时检查即可实现Python代码质量监…

    2026年9月25日 • 用户投稿
    100
  • 动态缓存键配置:Spring Boot 缓存管理的灵活应用

    动态缓存键配置:Spring Boot 缓存管理的灵活应用动态缓存键配置:Spring Boot 缓存管理的灵活应用动态缓存键配置:Spring Boot 缓存管理的灵活应用动态缓存键配置:Spring Boot 缓存管理的灵活应用

    在 Spring Boot 应用中,使用 @Cacheable 注解可以方便地实现缓存功能。然而,在某些场景下,我们需要根据请求参数动态地生成缓存键,而不是简单地使用固定的键值。虽然 @Cacheable 注解允许通过 key 属性指定 SpEL 表达式来生成缓存键,但有时我们可能需要更灵活的控制,…

    2026年9月25日 • 用户投稿
    200
  • 动态缓存键在Spring Boot中的实现教程

    动态缓存键在Spring Boot中的实现教程动态缓存键在Spring Boot中的实现教程动态缓存键在Spring Boot中的实现教程动态缓存键在Spring Boot中的实现教程

    本文介绍了如何在Spring Boot应用中实现基于请求参数的动态缓存键。通过直接操作CacheManager获取缓存对象,并使用cache.get(key, () -> …)方法,可以灵活地根据请求参数生成缓存键,从而实现更精细化的缓存控制。这种方法避免了直接修改缓存名称,而是专…

    2026年9月25日 • 用户投稿
    700
  • PHP加密算法有哪些_PHP数据加密解密常用函数

    推荐使用password_hash()存储密码,openssl_encrypt()加密数据,RSA实现安全通信,根据场景选择合适加密方式保障信息安全。 在PHP开发中,数据加密和解密是保障信息安全的重要手段。根据使用场景的不同,可以选择不同的加密方式。常见的需求包括密码存储、敏感数据传输、配置文件加…

    2026年9月25日
    100
  • Word文档全选文本怎么做_Word文档全选文本如何做详细方法

    Word文档全选文本怎么做_Word文档全选文本如何做详细方法Word文档全选文本怎么做_Word文档全选文本如何做详细方法Word文档全选文本怎么做_Word文档全选文本如何做详细方法Word文档全选文本怎么做_Word文档全选文本如何做详细方法

    全选Word文档最常用方法是使用快捷键Ctrl+A(Windows)或Command+A(Mac),可快速选中全部内容;也可通过“开始”选项卡中“编辑”组的“选择”命令进行全选;小文档可用鼠标拖动选中;在分节或多栏文档中需确保页面视图并尝试双击“全选”以避免遗漏,推荐优先使用快捷键操作。 在Word…

    2026年9月25日 • 用户投稿
    600
  • 高效并发处理共享列表与结果收集的Java教程

    高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程高效并发处理共享列表与结果收集的Java教程

    本文介绍了如何利用Java并发特性,特别是并行流(Parallel Streams),来高效处理共享列表,并将处理结果进行收集。针对耗时操作,通过将列表分割成子列表,并利用并行流并发执行,可以显著提高处理效率。同时,强调了在并发环境下对共享资源进行同步的重要性,并提供了收集处理结果的示例代码。 在处…

    2026年9月25日 • 用户投稿
    100
  • Debian OpenSSL的依赖关系是什么

    Debian OpenSSL的依赖关系是什么Debian OpenSSL的依赖关系是什么Debian OpenSSL的依赖关系是什么Debian OpenSSL的依赖关系是什么

    在Debian系统中,OpenSSL的依赖关系涵盖系统库、开发工具以及一些可选组件。 本文将详细阐述这些依赖项,并提供安装建议。 核心依赖: C标准库 (libc6): OpenSSL依赖C标准库才能正常运行。 OpenSSL开发库 (libssl-dev): 包含OpenSSL的头文件和静态库,用…

    2026年9月25日 • 用户投稿
    200
  • 如何在微服务之间共享静态数据

    如何在微服务之间共享静态数据如何在微服务之间共享静态数据如何在微服务之间共享静态数据如何在微服务之间共享静态数据

    微服务架构的本质决定了微服务之间无法直接共享静态变量。正如上面摘要所说,每个微服务都是一个独立的进程,拥有自己的内存空间,静态变量只在其所属的进程内有效。试图在一个微服务中访问另一个微服务的静态变量,就像试图在一个独立的Java程序中访问另一个程序的变量一样,是不可能的。 微服务架构的独立性 微服务…

    2026年9月25日 • 用户投稿
    100
  • [python]windows上通过whl文件安装triton模块

    [python]windows上通过whl文件安装triton模块[python]windows上通过whl文件安装triton模块[python]windows上通过whl文件安装triton模块[python]windows上通过whl文件安装triton模块

    在windows系统中,使用.whl文件安装triton是一个简单且高效的方法。以下是完整的操作流程说明: 一、检查系统配置 Python版本:首先确认已安装Python,并确保其版本与你要安装的Triton .whl 文件兼容。例如,若下载的是triton-2.0.0-cp310-cp310-wi…

    2026年9月25日 • 用户投稿
    300
  • 如何在微服务之间共享静态数据?

    如何在微服务之间共享静态数据?如何在微服务之间共享静态数据?如何在微服务之间共享静态数据?如何在微服务之间共享静态数据?

    在微服务架构中,各个服务都是独立的部署单元,拥有各自的内存空间。如同上述摘要所述,直接通过静态变量在不同的微服务之间共享数据是不可能的。 试图在一个微服务中设置静态变量的值,然后在另一个微服务中访问它,将会得到 null 或初始值,而不是之前设置的值。 这不是 Spring Boot 特有的问题,而…

    2026年9月25日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信