Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
优化XGBoost海量数据加载策略:兼顾内存效率与并发读取_创想鸟

优化XGBoost海量数据加载策略:兼顾内存效率与并发读取

优化XGBoost海量数据加载策略:兼顾内存效率与并发读取

本文旨在解决使用pandas和多进程读取海量csv文件进行xgboost训练时遇到的内存瓶颈。核心策略包括利用xgboost的dmatrix外部内存机制处理超大数据集,以及优化pandas数据加载流程,具体涉及将i/o密集型任务切换至线程池执行器,并采用一次性批量拼接dataframe以提高效率并降低内存开销。这些方法旨在确保在资源有限的环境下,也能高效、稳定地处理大规模机器学习数据集。

在机器学习实践中,特别是面对XGBoost等强大模型时,处理大规模数据集(例如数百万行、数十GB甚至上TB的数据)是常态。然而,将这些海量数据一次性加载到内存中,往往会导致内存溢出(OOM)错误,尤其是在资源受限的训练实例上。为了高效且稳定地处理这类挑战,我们需要采用针对性的数据加载和管理策略。

策略一:利用XGBoost的DMatrix外部内存机制

对于极其庞大的数据集,XGBoost本身提供了强大的外部内存(External Memory)解决方案,这是处理远超可用RAM数据量的根本方法。XGBoost的DMatrix是其内部数据结构,专为高效训练而设计,并支持通过自定义迭代器(custom iterator)分块加载数据。

核心思想:XGBoost的外部内存功能允许用户定义一个迭代器,该迭代器按需(on-demand)地加载数据块,而不是将整个数据集一次性载入内存。这意味着,无论数据集有多大,只要能够以块的形式读取,XGBoost就能进行训练。这种方法对于训练和预测都适用,但主要优势体现在训练阶段,因为它避免了将整个数据集常驻内存的需求。

实现原理:通过实现一个符合特定接口的Python迭代器,XGBoost会在需要数据时调用该迭代器来获取下一个数据块。这使得用户可以控制数据的加载粒度,例如从磁盘读取、网络流或数据库中分批获取数据。

优势:

根本解决内存限制: 允许训练任意大小的数据集,只要存储空间足够。资源效率高: 避免不必要的内存占用,尤其适合在成本敏感或资源受限的环境中进行训练。灵活性: 用户可以自定义数据加载逻辑,适应各种数据源和格式。

参考资料:由于实现自定义迭代器涉及XGBoost的特定API和数据流管理,建议查阅XGBoost官方文档中关于外部内存的详细教程,以获取最准确和最新的实现指导。

策略二:优化Pandas并发数据读取流程

即使XGBoost提供了外部内存机制,但在数据预处理阶段,我们可能仍需使用Pandas进行初步的数据读取和合并。此时,优化Pandas的并发读取策略至关重要。原始方法中存在两个主要的性能和内存瓶颈:

不当的并发执行器选择: 文件I/O操作属于I/O密集型任务,而非CPU密集型任务。低效的DataFrame拼接方式: 在循环中频繁调用pd.concat会导致严重的性能和内存开销。

1. I/O密集型任务的并发选择:线程池 vs 进程池

进程池(ProcessPoolExecutor)的局限性:

ProcessPoolExecutor适用于CPU密集型任务,因为它通过创建独立的进程来规避Python的全局解释器锁(GIL)。然而,进程创建和销毁的开销较大。更重要的是,进程间通信(IPC)需要对数据进行序列化和反序列化,这在传递大型DataFrame时会产生显著的性能瓶失和额外的内存复制,加剧内存压力。对于文件读取这类I/O操作,大部分时间是等待磁盘或网络响应,CPU利用率不高。

线程池(ThreadPoolExecutor)的优势:

ThreadPoolExecutor适用于I/O密集型任务。尽管Python的GIL会限制多线程在CPU密集型任务上的并行性,但在I/O操作(如文件读取)期间,GIL会被释放,允许其他线程执行I/O等待。线程比进程轻量,创建和切换开销小。线程共享同一进程的内存空间,避免了进程间的数据序列化和复制,从而减少内存消耗和通信开销。

因此,对于并发读取文件的场景,应优先选择ThreadPoolExecutor。

2. 高效的DataFrame拼接策略

在循环中通过pd.concat([df, _df])反复拼接DataFrame是Pandas操作中的一大性能陷阱。每次pd.concat都会创建一个新的DataFrame,并将所有旧数据和新数据复制到新的内存区域,这会导致:

内存开销剧增: 随着DataFrame的增大,每次拼接都会复制越来越多的数据,导致内存使用量呈指数级增长。性能下降: 数据复制操作非常耗时,尤其对于大型DataFrame。

推荐策略:将所有待拼接的子DataFrame收集到一个列表中,然后在所有读取任务完成后,执行一次性的大批量pd.concat操作。

优化后的并发读取代码示例

结合上述两点优化,改进后的数据读取函数如下:

import pandas as pdimport multiprocessing as mpfrom concurrent.futures import ThreadPoolExecutor, waitfrom typing import List# 假设 _read_training_data 和 train_mdirnames 已定义# def _read_training_data(training_data_path: str) -> pd.DataFrame:#     """Reads a single CSV file into a DataFrame."""#     df = pd.read_csv(training_data_path)#     return df# def train_mdirnames(paths: List[str]) -> List[str]:#     """Generates a list of file paths to read."""#     # This function needs to be implemented based on your directory structure#     # For demonstration, let's assume it just returns the input paths#     return paths def read_training_data_optimized(    paths: List[str]) -> pd.DataFrame:    """    Optimized function to read multiple CSV files concurrently using ThreadPoolExecutor    and perform a single concatenation.    """    # lazy loading of modules for training (if applicable)    # import multiprocessing as mp # Already imported for cpu_count if needed    # from concurrent.futures import ThreadPoolExecutor, wait # Already imported    # get directories (assuming ipaths is a list of file paths)    ipaths = paths # Placeholder, replace with actual train_mdirnames(paths)    print(f'Start parallel data reading with ThreadPoolExecutor. Using default workers.')    # Use ThreadPoolExecutor for I/O-bound operations    # By default, ThreadPoolExecutor uses a heuristic for max_workers,    # often min(32, os.cpu_count() + 4) for Python 3.8+    # You can also set a custom number, e.g., max_workers=mp.cpu_count() * 5    with ThreadPoolExecutor() as executor:        # Submit all tasks        tasks = [            executor.submit(_read_training_data, ipath)            for ipath in ipaths        ]        # Wait for all tasks to complete        # wait() is preferred here over as_completed() because we need all results        # before the single pd.concat call.        wait(tasks)        # Collect results and perform a single concatenation        # This avoids repeated memory reallocations and copies.        dataframes = [future.result() for future in tasks]        df = pd.concat(dataframes, ignore_index=True) # ignore_index=True for clean index    print(f'Have read {len(df)} data points')    return df# Example usage (assuming _read_training_data is defined elsewhere)# def _read_training_data(path):#     print(f"Reading {path}...")#     return pd.DataFrame({'col1': range(1000), 'col2': range(1000)}) # Mock data# file_paths = [f'data_{i}.csv' for i in range(10)]# final_df = read_training_data_optimized(file_paths)# print(final_df.head())# print(f"Final DataFrame shape: {final_df.shape}")

代码解释:

ThreadPoolExecutor: 替换了ProcessPoolExecutor,更适合文件I/O操作。默认的max_workers通常足够,也可根据实际I/O吞吐量调整。wait(tasks): 等待所有提交的任务完成。这确保了在进行pd.concat之前,所有子DataFrame都已成功读取并可用。dataframes = [future.result() for future in tasks]: 创建一个列表来存储所有子DataFrame。df = pd.concat(dataframes, ignore_index=True): 在所有子DataFrame收集完毕后,执行一次性的大批量拼接。ignore_index=True可以避免索引重复问题,并生成一个连续的新索引。

注意事项与性能考量

内存限制依然存在: 尽管优化了Pandas的读取和拼接,但如果单个CSV文件本身就非常大,或者所有子DataFrame的总和在最终pd.concat时仍然超出可用内存,那么内存溢出问题仍可能发生。在这种情况下,XGBoost的外部内存机制是更根本的解决方案。I/O瓶颈: 并发读取的性能最终会受限于磁盘I/O速度。如果存储介质(如Sagemaker的EBS卷类型)速度较慢,增加再多的线程也无法显著提升速度。监控资源: 在大规模数据处理时,务必监控实例的CPU、内存和磁盘I/O使用情况,以便及时发现瓶颈并调整策略。数据预处理: 如果数据预处理步骤复杂且需要大量内存,考虑在加载到XGBoost的DMatrix之前,对数据进行分块处理和转换,或者利用Spark、Dask等分布式计算框架。

总结

处理海量数据进行XGBoost训练是一个常见的挑战。解决内存溢出问题需要多管齐下:

对于超大规模数据集(远超RAM),优先采用XGBoost内置的DMatrix外部内存机制。 这允许模型分块读取数据,从根本上规避内存限制。对于Pandas数据加载阶段,优化并发策略至关重要。 将I/O密集型任务切换到ThreadPoolExecutor,并采用一次性批量pd.concat来收集所有子DataFrame,可以显著提高效率并减少内存开销。

结合这两种策略,开发者可以更高效、更稳定地在各种计算资源环境下处理和训练大规模机器学习模型。

以上就是优化XGBoost海量数据加载策略:兼顾内存效率与并发读取的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1382594.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Python中安全获取嵌套JSON数据中的图片URL
上一篇 2025年12月15日 00:03:23
Pandas groupby 性能优化:实现高效数据聚合
下一篇 2025年12月15日 00:03:37

相关推荐

  • 夸克网盘怎么扩容_免费获取与购买存储空间

    通过新用户注册、切换登录方式、解绑手机号、参与推广活动及每日签到,可免费获取1TB至20TB不等的夸克网盘扩容空间,其中推广任务最高可得20TB可叠加容量,签到则累积永久空间。 如果您在使用夸克网盘时发现存储空间不足,可以通过平台提供的多种方式免费获取额外容量,或选择购买服务来满足更大需求。以下是具…

    2026年9月24日
    700
  • Java中实现跨类和函数共享变量的指南

    Java中实现跨类和函数共享变量的指南Java中实现跨类和函数共享变量的指南Java中实现跨类和函数共享变量的指南Java中实现跨类和函数共享变量的指南

    本教程将详细介绍在Java中如何创建可在所有类和函数中访问的共享变量。通过利用public static关键字,我们可以定义类级别的变量,实现全局共享状态。文章将提供声明、访问示例,并讨论使用此类变量时的最佳实践和注意事项,确保代码的可维护性和健壮性。 理解共享变量的需求 在java应用程序开发中,…

    2026年9月24日 • 用户投稿
    100
  • Ubuntu挂载网络共享

    在ubuntu中挂载网络共享有多种方法,以下是其中两种常用的方法: 方法一:使用mount命令 安装必要的软件包:如果你还没有安装cifs-utils(用于CIFS/SMB协议),可以使用以下命令安装: sudo apt updatesudo apt install cifs-utils 创建挂载点…

    2026年9月24日
    000
  • Java中实现州府问答系统:2D数组管理、排序与用户输入验证

    Java中实现州府问答系统:2D数组管理、排序与用户输入验证Java中实现州府问答系统:2D数组管理、排序与用户输入验证Java中实现州府问答系统:2D数组管理、排序与用户输入验证Java中实现州府问答系统:2D数组管理、排序与用户输入验证

    本教程详细介绍了如何使用Java构建一个州府问答系统。内容涵盖了使用二维数组存储州名及其首都数据、实现冒泡排序对数据按首都名称进行排序、以及如何通过用户输入验证机制,处理大小写不敏感的答案,并最终统计正确率。文章提供了完整的代码示例和关键注意事项,帮助读者理解并实现类似的数据结构与算法应用。 1. …

    2026年9月24日 • 用户投稿
    100
  • sublime如何配置使其支持EditorConfig _sublime EditorConfig支持配置

    sublime如何配置使其支持EditorConfig _sublime EditorConfig支持配置sublime如何配置使其支持EditorConfig _sublime EditorConfig支持配置sublime如何配置使其支持EditorConfig _sublime EditorConfig支持配置sublime如何配置使其支持EditorConfig _sublime EditorConfig支持配置

    首先安装Package Control,再通过命令面板安装EditorConfig插件,确保项目根目录有.editorconfig文件,重启后即可自动应用格式规则。 Sublime Text 本身不内置支持 EditorConfig,但可以通过安装插件来实现对 .editorconfig 文件的识别…

    2026年9月24日 • 用户投稿
    100
  • 《明末:渊虚之羽》1.5版本更新今日登陆主机!详情待公布!

    《明末:渊虚之羽》1.5版本更新今日登陆主机!详情待公布!《明末:渊虚之羽》1.5版本更新今日登陆主机!详情待公布!《明末:渊虚之羽》1.5版本更新今日登陆主机!详情待公布!《明末:渊虚之羽》1.5版本更新今日登陆主机!详情待公布!

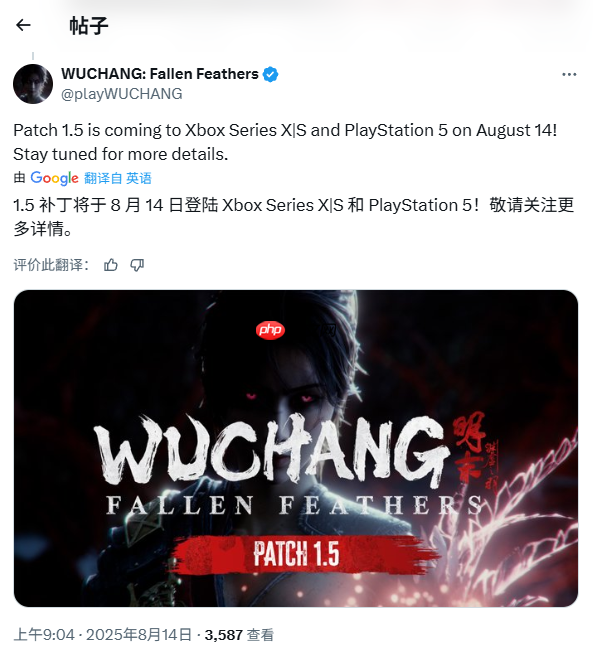
    今日,国产类魂游戏《明末:渊虚之羽》官方通过社交平台x宣布,1.5版本更新即将上线主机平台。 官方在推文中指出:“1.5版本补丁将于8月14日正式登陆Xbox Series X|S与PlayStation 5平台!更多详细信息将陆续公开,请持续关注。” 此前,该版本已率先在PC平台推出,主要内容更新…

    2026年9月24日 • 用户投稿
    000
  • 使用 Rest Assured 创建泛型 JSONPath 值提取函数

    使用 Rest Assured 创建泛型 JSONPath 值提取函数使用 Rest Assured 创建泛型 JSONPath 值提取函数使用 Rest Assured 创建泛型 JSONPath 值提取函数使用 Rest Assured 创建泛型 JSONPath 值提取函数

    本文探讨如何在 Rest Assured 中设计一个泛型工具函数,以实现类型安全的 JSONPath 值提取。针对直接使用 T.class 导致的编译错误,文章提供了通过将 Class 作为参数传入的解决方案,有效规避了 Java 泛型擦除问题,从而实现灵活、可复用的 JSON 数据解析。 泛型 J…

    2026年9月24日 • 用户投稿
    000
  • x浏览器保存的密码在哪里查看_x浏览器已保存账号密码查看方法

    x浏览器保存的密码在哪里查看_x浏览器已保存账号密码查看方法x浏览器保存的密码在哪里查看_x浏览器已保存账号密码查看方法x浏览器保存的密码在哪里查看_x浏览器已保存账号密码查看方法x浏览器保存的密码在哪里查看_x浏览器已保存账号密码查看方法

    首先通过X浏览器设置进入密码管理,再选择具体网站查看账号密码。操作路径为:打开X浏览器→点击菜单→进入设置→选择安全及隐私→点击站点密码管理→找到目标网站→点击编辑→查看明文账号密码,全过程需通过设备验证。 如果您在使用X浏览器时启用了密码保存功能,但需要查看已存储的账号信息,则可以通过浏览器内置的…

    2026年9月24日 • 用户投稿
    000
  • 怎么用豆包AI分析Python内存使用 AI辅助定位内存泄漏的实用方法

    怎么用豆包AI分析Python内存使用 AI辅助定位内存泄漏的实用方法怎么用豆包AI分析Python内存使用 AI辅助定位内存泄漏的实用方法怎么用豆包AI分析Python内存使用 AI辅助定位内存泄漏的实用方法怎么用豆包AI分析Python内存使用 AI辅助定位内存泄漏的实用方法

    python内存泄漏可通过tracemalloc、objgraph及代码分析定位。1. 使用tracemalloc模块记录内存分配堆栈,生成快照并输出统计结果,交由豆包ai分析可疑内存泄漏点;2. 用objgraph查看常见对象类型及增长趋势,若发现异常增长对象可交由豆包判断是否合理;3. 将疑似泄…

    2026年9月24日 • 用户投稿
    000
  • 抖音双11好物节有哪些优惠活动?双11抖音有什么活动

    抖音双11好物节有哪些优惠活动?双11抖音有什么活动抖音双11好物节有哪些优惠活动?双11抖音有什么活动抖音双11好物节有哪些优惠活动?双11抖音有什么活动抖音双11好物节有哪些优惠活动?双11抖音有什么活动

    一年一度的双11购物狂欢节即将来临,抖音平台也紧跟潮流,推出了抖音双11好物节活动。这次活动可谓是优惠满满,好物多多,让广大消费者在购物的同时,也能享受购物的乐趣。下面,就让我为大家详细介绍一下2025年抖音双11好物节的优惠活动吧! 一、抖音双11好物节活动时间 活动周期:2025年9月16日(中…

    2026年9月24日 • 用户投稿
    000
  • 如何验证厂商宣传的散热技术是否切实有效?

    如何验证厂商宣传的散热技术是否切实有效?如何验证厂商宣传的散热技术是否切实有效?如何验证厂商宣传的散热技术是否切实有效?如何验证厂商宣传的散热技术是否切实有效?

    要验证散热技术是否有效,需结合产品规格、第三方评测、用户反馈及自行测试。首先查看热管数量与材质、均热板设计、风扇风量与静压等真实参数,警惕模糊宣传;其次参考专业媒体在标准环境下的烤机测试数据,如AIDA64或FurMark负载下的温度与频率表现;再通过电商平台或论坛收集长期使用反馈,关注共性问题如噪…

    2026年9月24日 • 用户投稿
    000
  • 抖音账号无故被封禁该如何解决?封禁是否因他人举报而起?详解抖音账号封禁原因!

    抖音账号无故被封禁该如何解决?封禁是否因他人举报而起?详解抖音账号封禁原因!抖音账号无故被封禁该如何解决?封禁是否因他人举报而起?详解抖音账号封禁原因!抖音账号无故被封禁该如何解决?封禁是否因他人举报而起?详解抖音账号封禁原因!抖音账号无故被封禁该如何解决?封禁是否因他人举报而起?详解抖音账号封禁原因!

    一、抖音账号被封的常见原因 (一)是否因他人举报导致封号? 1. 一次举报会怎样?当一个抖音账号被用户举报时,平台通常不会立即采取严厉措施。首次举报多数情况下只会触发系统警告。例如,若发布的视频涉及轻微版权问题或存在争议性言论,虽未明显违规,但经他人举报后,可能会收到平台提醒。2. 多次举报的严重后…

    2026年9月24日 • 用户投稿
    200
  • 如何用豆包 AI 大模型与 AI 聚会游戏设计工具结合,活跃聚会氛围?​

    如何用豆包 AI 大模型与 AI 聚会游戏设计工具结合,活跃聚会氛围?​如何用豆包 AI 大模型与 AI 聚会游戏设计工具结合,活跃聚会氛围?​如何用豆包 AI 大模型与 AI 聚会游戏设计工具结合,活跃聚会氛围?​如何用豆包 AI 大模型与 AI 聚会游戏设计工具结合,活跃聚会氛围?​

    豆包 ai 大模型与 ai 聚会游戏设计工具结合,能有效提升聚会互动性和趣味性。1. 可用豆包 ai 生成个性化问题或话题,如搞笑类、回忆类等,帮助破冰交流;2. 结合聚会游戏工具,利用 ai 生成的关键词或背景设定定制专属小游戏,增强即兴互动;3. 借 ai 生成角色设定和剧情线索,营造角色扮演氛…

    2026年9月24日 • 用户投稿
    100
  • 夸克网盘怎么分享文件_文件分享链接创建与管理

    夸克网盘怎么分享文件_文件分享链接创建与管理夸克网盘怎么分享文件_文件分享链接创建与管理夸克网盘怎么分享文件_文件分享链接创建与管理夸克网盘怎么分享文件_文件分享链接创建与管理

    夸克网盘支持通过生成链接或二维码分享文件。首先打开夸克App进入网盘页面,长按选中文件后点击“分享”,可选择公开或私密模式并设置有效期(1天、7天或永久),生成链接后系统自动复制到剪贴板。已生成的链接可在“我的分享”页面管理,支持修改有效期、更改密码或停止分享。此外,还可通过“二维码分享”功能生成二…

    2026年9月24日 • 用户投稿
    100
  • sublime如何格式化sql语句 _sublime SQL格式化方法

    sublime如何格式化sql语句 _sublime SQL格式化方法sublime如何格式化sql语句 _sublime SQL格式化方法sublime如何格式化sql语句 _sublime SQL格式化方法sublime如何格式化sql语句 _sublime SQL格式化方法

    使用插件实现Sublime Text格式化SQL。1. 安装Package Control:通过控制台执行代码安装插件管理工具;2. 安装SQLPrettyPrinter:通过命令面板搜索并安装,选中SQL语句后运行“SQL Pretty Print”命令格式化;3. 高级用户可结合Python的s…

    2026年9月24日 • 用户投稿
    100
  • mysql数据库中的自增列如何使用

    自增列是MySQL中用于自动产生唯一数值的整数列,通常作为主键使用。通过AUTO_INCREMENT属性,插入数据时若未指定值,系统会自动分配比当前最大值大1的数值,确保每条记录拥有唯一标识,简化插入操作。创建表时可定义自增列,如:CREATE TABLE users (id INT AUTO_IN…

    2026年9月24日
    100
  • 如何高效管理Debian文件系统

    高效管理debian文件系统可以通过以下几个步骤来实现: 了解文件系统结构: Debian文件系统遵循标准的Linux文件系统层次结构,例如/bin, /etc, /home, /usr, /var等。熟悉这些目录的作用,有助于更好地组织和管理文件。 磁盘空间管理: 使用df -h命令查看磁盘空间使…

    2026年9月24日
    000
  • 高效集成SOAP服务:Spring Boot中WSDL转Java的实践与策略

    高效集成SOAP服务:Spring Boot中WSDL转Java的实践与策略高效集成SOAP服务:Spring Boot中WSDL转Java的实践与策略高效集成SOAP服务:Spring Boot中WSDL转Java的实践与策略高效集成SOAP服务:Spring Boot中WSDL转Java的实践与策略

    本教程旨在指导开发者如何在Spring Boot项目中将WSDL(Web Services Description Language)文件转换为Java类,并成功消费SOAP(Simple Object Access Protocol)Web服务。文章将探讨常见的转换挑战,如wsimport兼容性问…

    2026年9月24日 • 用户投稿
    100
  • windows10提示“we couldn’t complete the updates undoing changes”_windows10更新失败修复方法

    windows10提示“we couldn’t complete the updates undoing changes”_windows10更新失败修复方法windows10提示“we couldn’t complete the updates undoing changes”_windows10更新失败修复方法windows10提示“we couldn’t complete the updates undoing changes”_windows10更新失败修复方法windows10提示“we couldn’t complete the updates undoing changes”_windows10更新失败修复方法

    遇到Windows 10更新失败时,可依次使用Windows更新疑难解答、重置更新组件、运行SFC和DISM修复系统文件,或使用Media Creation Tool进行原地升级解决。 如果您在尝试更新 Windows 10 系统时遇到“我们无法完成更新,正在撤消更改”的提示,这通常意味着更新过程中…

    2026年9月24日 • 用户投稿
    200
  • 怎样让 AI 家居设计工具与豆包配合打造理想家居?实用教程​

    怎样让 AI 家居设计工具与豆包配合打造理想家居?实用教程​怎样让 AI 家居设计工具与豆包配合打造理想家居?实用教程​怎样让 AI 家居设计工具与豆包配合打造理想家居?实用教程​怎样让 AI 家居设计工具与豆包配合打造理想家居?实用教程​

    使用ai家居设计工具与豆包配合能提升家装效率,具体步骤如下:1. 利用ai工具生成设计方案,上传户型图并设定风格偏好,快速获取多个装修效果图;2. 将ai输出结果整理至豆包,为每个房间建立页面,添加说明、表格及标签以便查阅;3. 结合豆包优化预算和采购计划,记录材料价格并比对市场价,设置提醒避免遗漏…

    2026年9月24日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信