处理大型xml文件时,nokogiri的dom解析会占用大量内存,因此应优先使用nokogiri::xml::reader进行流式解析以降低内存消耗;2. 优化xpath/css选择器,通过使用更具体路径减少遍历范围,提升查询效率;3. 避免频繁调用to_xml或to_s,减少不必要的序列化操作以提升性能;4. 可将大文件分批处理或拆分为小文件,结合流式解析实现高效操作;5. 进行xml修改时,可通过at_css或at_xpath定位节点并修改其属性或内容;6. 添加元素需创建新节点并使用add_child或add_sibling系列方法插入dom树;7. 删除元素使用remove方法即可从文档中移除指定节点;8. xml验证可通过nokogiri::xml::schema加载xsd文件,调用validate方法检查文档合规性,适用于确保外部数据结构正确;9. 处理命名空间时必须注册前缀与uri的映射关系,使用xpath查询需显式传入命名空间哈希;10. 默认命名空间需手动绑定临时前缀才能在xpath中使用,不可直接以无前缀方式查询;11. 可通过node.namespace.href和node.namespace.prefix检查节点的命名空间信息以避免匹配失败;12. css选择器对命名空间支持有限,推荐在复杂命名空间场景下优先使用xpath。综上,nokogiri通过dom操作和流式解析提供了完整的xml处理能力,结合命名空间管理、选择器优化和验证机制,能够高效应对各种xml处理需求。
Ruby的Nokogiri库在解析和生成XML文档方面,确实是Ruby生态里一个非常强大且灵活的工具。它底层基于C语言的libxml2和libxslt库,所以性能上很有保障,用起来也相当直观,无论是从字符串、文件还是URL加载XML,然后进行复杂的查询、修改,或者从头开始构建XML结构,它都能轻松胜任。
解决方案
Nokogiri处理XML文档,核心在于构建一个DOM树(Document Object Model),然后通过CSS选择器或XPath表达式来遍历、查找、修改这个树。生成XML则是一个逆向过程,从Nokogiri的对象开始构建,最终序列化为字符串或写入文件。
解析XML文档:
通常我们从一个XML字符串或文件开始。
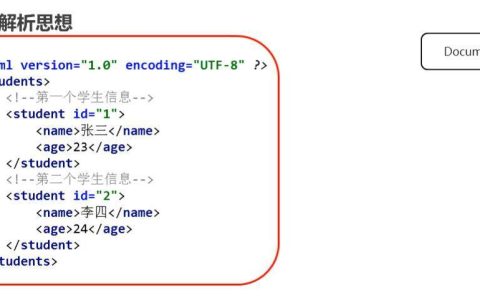
require 'nokogiri'# 从字符串解析xml_string = <<-XMLEveryday Italian Giada De Laurentiis 2005 30.00Harry Potter J.K. Rowling 2005 29.99 XMLdoc = Nokogiri::XML(xml_string)# 查找元素:可以用CSS选择器,也可以用XPath# 查找所有书的标题puts "所有书的标题 (CSS):"doc.css('book title').each do |title| puts "- #{title.text}"endputs "n所有书的作者 (XPath):"doc.xpath('//book/author').each do |author| puts "- #{author.text}"end# 获取特定元素的属性first_book_category = doc.at_css('book')['category']puts "n第一本书的分类: #{first_book_category}"# 获取特定元素的文本内容harry_potter_price = doc.at_xpath("//book[title='Harry Potter']/price").textputs "哈利波特的价格: #{harry_potter_price}"# 遍历并提取信息puts "n详细书籍信息:"doc.css('book').each do |book_node| category = book_node['category'] title = book_node.at_css('title').text author = book_node.at_css('author').text year = book_node.at_css('year').text price = book_node.at_css('price').text puts " 分类: #{category}, 标题: #{title}, 作者: #{author}, 年份: #{year}, 价格: #{price}"end# 从文件解析# File.open("example.xml") do |f|# doc_from_file = Nokogiri::XML(f)# # ... 进行操作# end
生成XML文档:
生成XML同样灵活,你可以从头构建,也可以在现有文档上添加修改。
require 'nokogiri'# 从头开始生成一个XML文档builder = Nokogiri::XML::Builder.new do |xml| xml.root { xml.product(id: 123) { xml.name "Awesome Widget" xml.price "99.99", currency: "USD" xml.features { xml.feature "Durable" xml.feature "Lightweight" } } xml.product(id: 456) { xml.name "Super Gadget" xml.price "199.99", currency: "EUR" } }endputs "n生成的XML文档:n"puts builder.to_xml(indent: 2) # indent参数可以美化输出# 在现有文档上添加元素 (假设我们想给第一本书添加一个“出版商”信息)doc = Nokogiri::XML(xml_string) # 使用前面解析的文档first_book = doc.at_css('book')if first_book # 创建一个新元素并添加到first_book下 publisher_node = Nokogiri::XML::Node.new "publisher", doc publisher_node.content = "Penguin Random House" first_book.add_child(publisher_node)endputs "n修改后的XML文档 (添加出版商):n"puts doc.to_xml(indent: 2)
Nokogiri在处理大型XML文件时有哪些性能考量和优化策略?
处理大型XML文件时,Nokogiri的默认行为是将整个文档加载到内存中构建DOM树。这对于几MB到几十MB的文件通常没问题,但如果文件达到几百MB甚至GB级别,内存消耗就会变得非常显著,甚至可能导致程序崩溃。我个人就遇到过因为处理一个几GB的日志XML文件,直接把服务器内存吃光的情况。
所以,这里有几个关键的性能考量和优化策略:
内存消耗: 这是最直接的问题。DOM解析器会把所有节点、属性、文本内容都加载到内存。解析时间: 构建庞大的DOM树本身也需要时间。
针对这些问题,Nokogiri提供了解决方案:
使用 Nokogiri::XML::Reader 进行流式解析 (SAX-like):这是处理超大型XML文件的首选方法。Nokogiri::XML::Reader 不会一次性加载整个文档,而是像一个事件流一样,逐个节点地读取。你只在需要时处理当前节点,处理完就丢弃,这样内存占用可以保持在一个非常低的水平。缺点是你无法像DOM那样随意跳转到文档的任何位置,只能顺序处理。
# 假设有一个非常大的 large_data.xml 文件# large_data.xml 类似:.........reader = Nokogiri::XML::Reader(File.open("large_data.xml"))item_count = 0reader.each do |node| if node.name == 'item' && node.node_type == Nokogiri::XML::Reader::ELEMENT # 当遇到一个 元素的开始标签时 # 可以通过 node.attribute('id') 获取属性 # 如果需要处理内部内容,可以使用 node.read_inner_xml # 但要注意,read_inner_xml 会把当前节点的内部内容读入字符串,如果内容很大,也要小心 item_count += 1 # puts "Found item with ID: #{node.attribute('id')}" # 示例:打印ID endendputs "Total items found: #{item_count}"
这种方式非常适合提取特定类型的数据,或者对每个记录进行独立处理,而不需要知道整个文档的结构。
优化XPath/CSS选择器:虽然Nokogiri的底层实现很高效,但糟糕的选择器仍然会影响性能。例如,//book 会遍历整个文档来查找所有 book 元素,而如果你知道 book 总是出现在 bookstore 下,那么 bookstore/book 或 doc.css('bookstore > book') 会更高效,因为它限定了搜索范围。尽量使用更具体的路径,减少通配符的使用。
避免不必要的 to_xml 或 to_s 调用:如果你只是想修改文档并保存,而不是每次修改都打印出来,那么就不要频繁调用 doc.to_xml。这个操作会遍历整个DOM树并序列化,非常耗时。
分批处理:如果你的逻辑允许,可以将一个巨大的XML文件拆分成多个小文件,或者每次只处理文件中的一部分数据。但这通常需要更复杂的逻辑来管理文件指针或使用流式解析。
如何利用Nokogiri进行XML的修改、删除和验证?
Nokogiri不仅能解析和生成,它在DOM操作方面也做得相当出色,你可以把它想象成一个前端操作HTML DOM那样去操作XML。
修改元素内容和属性:
require 'nokogiri'xml_string = <<-XML New Feature XMLdoc = Nokogiri::XML(xml_string)# 修改元素文本内容log_level_node = doc.at_xpath("//setting[@name='loglevel']")if log_level_node log_level_node['value'] = 'DEBUG' # 修改属性 # 如果是修改元素文本内容,例如 Hello,则 node.content = "New Message"end# 修改属性feature_node = doc.at_css('feature')if feature_node feature_node['enabled'] = 'false' feature_node.at_css('description').content = 'Old Feature (disabled)' # 修改子元素内容endputs "n修改后的XML文档:n"puts doc.to_xml(indent: 2)
添加和删除元素:
Nokogiri提供了多种方法来添加和删除节点,包括 add_child, add_next_sibling, add_previous_sibling, replace, remove 等。
require 'nokogiri'xml_string = <<-XML First Item Second ItemXMLdoc = Nokogiri::XML(xml_string)items_node = doc.at_css('items')# 添加新元素new_item = Nokogiri::XML::Node.new("item", doc)new_item['id'] = '3'new_item.content = "Third Item"items_node.add_child(new_item) # 添加为子节点another_item = Nokogiri::XML::Node.new("item", doc)another_item['id'] = '4'another_item.content = "Fourth Item (after first)"doc.at_css('item[id="1"]').add_next_sibling(another_item) # 添加为兄弟节点puts "n添加元素后的XML文档:n"puts doc.to_xml(indent: 2)# 删除元素item_to_remove = doc.at_css('item[id="2"]')item_to_remove.remove if item_to_removeputs "n删除元素后的XML文档 (移除了ID为2的项):n"puts doc.to_xml(indent: 2)
XML验证 (Schema/DTD):
XML验证是一个非常重要的环节,特别是当你需要确保接收到的XML数据符合预期的结构时。Nokogiri支持使用XML Schema (XSD) 和 DTD (Document Type Definition) 进行验证。XSD是更现代、功能更强大的验证方式。
首先,你需要有一个Schema文件(例如 my_schema.xsd):
然后是Ruby代码进行验证:
require 'nokogiri'# 假设你的schema文件在当前目录# File.write('my_schema.xsd', <<-XSD# # # # # # # # # # # XSD# )schema = Nokogiri::XML::Schema(File.read('my_schema.xsd'))# 验证通过的XMLvalid_xml = <<-XML Alice 30XMLdoc_valid = Nokogiri::XML(valid_xml)errors = schema.validate(doc_valid)if errors.empty? puts "nValid XML is valid."else puts "nValid XML has validation errors:" errors.each { |error| puts "- #{error.message}" }end# 验证失败的XML (缺少age元素)invalid_xml = <<-XML BobXMLdoc_invalid = Nokogiri::XML(invalid_xml)errors = schema.validate(doc_invalid)if errors.empty? puts "Invalid XML is valid (unexpected)."else puts "nInvalid XML has validation errors:" errors.each { |error| puts "- #{error.message}" }end# DTD 验证类似,使用 Nokogiri::XML::DTD 而不是 Schema# dtd = Nokogiri::XML::DTD(File.read('my_dtd.dtd'))# dtd.validate(doc)
验证功能在处理外部API返回的XML数据时尤其有用,可以提前发现数据结构不匹配的问题,避免后续处理逻辑出错。
Nokogiri处理XML命名空间(Namespaces)时有哪些常见陷阱和最佳实践?
XML命名空间(Namespaces)是一个在XML文档中避免元素和属性名称冲突的机制。它通过URI来唯一标识一个命名空间,并通过前缀在元素或属性名中引用。这东西初看起来可能有点绕,但一旦涉及到复杂的企业级XML或SOAP消息,几乎是避不开的。Nokogiri对命名空间的支持很好,但确实有一些地方容易踩坑。
常见陷阱:
忘记声明命名空间前缀: 这是最常见的错误。当你使用XPath或CSS选择器查询带有命名空间的元素时,你必须在查询中也带上命名空间前缀,并且告诉Nokogiri这个前缀对应哪个URI。如果你的XML是这样的:
GOOG
如果你直接用 doc.xpath('//GetStockPrice'),很可能什么都找不到,因为它不知道 GetStockPrice 是属于 m 命名空间的。
默认命名空间: 如果一个XML文档有默认命名空间(即没有前缀的 xmlns="some_uri"),Nokogiri在XPath查询时会把没有前缀的元素视为不属于任何命名空间。这意味着你仍然需要为默认命名空间定义一个前缀,然后在XPath中使用它。比如 xmlns="http://example.com/data",你可能需要定义 data:element。
XPath 1.0 的局限性: Nokogiri底层使用的是libxml2,它支持XPath 1.0。XPath 1.0 在处理默认命名空间时确实比较麻烦,它没有直接的方法来匹配没有前缀但属于默认命名空间的元素。你需要手动注册一个前缀来映射这个默认命名空间。
最佳实践:
始终注册命名空间前缀:当你的XML文档包含命名空间时,无论你使用XPath还是CSS选择器,都应该明确地注册命名空间前缀和对应的URI。
require 'nokogiri'xml_with_namespace = <<-XML Product A 100 Product B XMLdoc = Nokogiri::XML(xml_with_namespace)# 注册命名空间前缀ns = { 'my' => 'http://example.com/my_namespace' }# 使用XPath查询带命名空间的元素my_item_name = doc.xpath('//my:item/my:name', ns).firstputs "n带命名空间的商品名称: #{my_item_name.text if my_item_name}"# 使用CSS选择器查询带命名空间的元素# 注意:CSS选择器对命名空间的支持不如XPath直接,通常需要指定完整的命名空间URI# 或者对于特定Nokogiri版本,可以通过 `doc.css('my|item')` 来查询,但这依赖于libxml2的版本和Nokogiri的实现# 更稳妥的做法是使用XPath
处理默认命名空间:如果XML文档有默认命名空间,比如 ,你需要在注册命名空间时为它指定一个临时的前缀。
require 'nokogiri'xml_with_default_namespace = <<-XML ValueXMLdoc = Nokogiri::XML(xml_with_default_namespace)# 为默认命名空间指定一个前缀 (例如 'd')ns = { 'd' => 'http://example.com/default_ns' }# 使用这个前缀来查询元素element_node = doc.xpath('//d:element', ns).firstputs "n默认命名空间中的元素值: #{element_node.text if element_node}"
检查命名空间URI:如果你不确定一个元素属于哪个命名空间,可以通过 node.namespace.href 或 node.namespace.prefix 来检查。
require 'nokogiri'xml_with_namespace = <<-XML Product A XMLdoc = Nokogiri::XML(xml_with_namespace)item_node = doc.at_css('my|item') # 这种CSS选择器写法在某些Nokogiri版本/libxml2版本下有效if item_node && item_node.namespace puts "nItem 元素的命名空间URI: #{item_node.namespace.href}" puts "Item 元素的命名空间前缀: #{item_node.namespace.prefix}"end
理解并正确处理命名空间是使用Nokogiri处理复杂XML的关键一步。一旦掌握了注册和使用前缀的方法,大部分问题都能迎刃而解。
以上就是Ruby的Nokogiri库怎么解析和生成XML文档?的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1429989.html
 微信扫一扫
 支付宝扫一扫