Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
如何在Swift中使用XMLParser解析本地XML文件?_创想鸟

如何在Swift中使用XMLParser解析本地XML文件?

要处理swift中xml解析的错误、权衡xmlparser的优劣并实现数据结构化存储,需遵循以下三点:1. 通过实现parser(_:parseerroroccurred:)方法捕获解析错误,并在didendelement中手动校验数据完整性,同时对字符串进行trim和nil合并以增强健壮性;2. xmlparser的优势在于事件驱动、低内存占用,适合大文件和流式解析,但其代理模式需大量样板代码,缺乏xpath查询和dom操作能力,复杂场景可考虑第三方库;3. 通过定义swift结构体(如book)作为数据模型,在解析过程中利用currentbook临时对象收集元素数据,每当一个完整元素结束时将其存入books数组,从而实现xml数据的结构化存储与后续操作。

如何在Swift中使用XMLParser解析本地XML文件?

在Swift中解析本地XML文件,XMLParser是Apple提供的一个相当直接且高效的工具。它采用的是SAX(Simple API for XML)解析方式,也就是事件驱动型,这意味着它不会一次性把整个XML文档加载到内存中,而是边读取边触发事件,非常适合处理大型文件,避免内存压力。

解决方案

要使用XMLParser解析本地XML文件,你需要做几件事:首先,确保你的XML文件在项目Bundle中;然后,你需要一个遵循XMLParserDelegate协议的类来处理解析过程中触发的各种事件,比如遇到元素开始、找到字符数据、元素结束等。

假设我们有一个名为books.xml的文件,内容大致如下:

            Gambardella, Matthew        XML Developer's Guide        Computer        44.95        2000-10-01        An in-depth look at creating applications with XML.                Corets, Eva        Maeve Ascendant        Fantasy        5.95        2000-09-03        A novel about a young woman's journey to save her people.    

接下来是解析代码:

import Foundation// 定义一个结构体来存储解析后的书籍数据struct Book {    var id: String?    var author: String?    var title: String?    var genre: String?    var price: String?    var publishDate: String?    var description: String?}// 解析器类,遵循 XMLParserDelegateclass XMLBookParser: NSObject, XMLParserDelegate {    var books: [Book] = []    private var currentBook: Book?    private var currentElement: String = ""    private var foundCharacters: String = ""    func parse(xmlFileName: String) -> [Book]? {        guard let path = Bundle.main.path(forResource: xmlFileName, ofType: "xml"),              let data = FileManager.default.contents(atPath: path) else {            print("Error: XML file not found or could not be read.")            return nil        }        let parser = XMLParser(data: data)        parser.delegate = self        // 开始解析        let success = parser.parse()        if !success {            print("Parsing failed. Error: (parser.parserError?.localizedDescription ?? "Unknown error")")            return nil        }        return books    }    // MARK: - XMLParserDelegate Methods    func parser(_ parser: XMLParser, didStartElement elementName: String, namespaceURI: String?, qualifiedName qName: String?, attributes attributeDict: [String : String] = [:]) {        currentElement = elementName        foundCharacters = "" // 每次遇到新元素,清空之前收集的字符        if elementName == "book" {            currentBook = Book()            currentBook?.id = attributeDict["id"]        }    }    func parser(_ parser: XMLParser, foundCharacters string: String) {        // 收集当前元素内的字符数据        // 注意:foundCharacters可能会被多次调用,需要拼接        foundCharacters += string.trimmingCharacters(in: .whitespacesAndNewlines)    }    func parser(_ parser: XMLParser, didEndElement elementName: String, namespaceURI: String?, qualifiedName qName: String?) {        // 当元素结束时,将收集到的数据赋值给当前书籍对象        switch elementName {        case "author":            currentBook?.author = foundCharacters        case "title":            currentBook?.title = foundCharacters        case "genre":            currentBook?.genre = foundCharacters        case "price":            currentBook?.price = foundCharacters        case "publish_date":            currentBook?.publishDate = foundCharacters        case "description":            currentBook?.description = foundCharacters        case "book":            if let book = currentBook {                books.append(book)            }            currentBook = nil // 清空当前书籍,准备解析下一本        default:            break        }    }    func parser(_ parser: XMLParser, parseErrorOccurred parseError: Error) {        print("Parsing error: (parseError.localizedDescription)")    }}// 如何使用// let parser = XMLBookParser()// if let parsedBooks = parser.parse(xmlFileName: "books") {//     for book in parsedBooks {//         print("Book ID: (book.id ?? "N/A"), Title: (book.title ?? "N/A"), Author: (book.author ?? "N/A")")//     }// }

如何处理XML解析中的常见错误和异常?

在实际开发中,XML解析远不止“一帆风顺”那么简单。XMLParser的parser(_:parseErrorOccurred:)方法是你的第一道防线。这个代理方法会在解析器遇到任何结构性错误时被调用,比如XML格式不规范、标签未闭合等。你需要在这个方法里捕获并处理这些错误,例如打印错误信息,或者向用户反馈解析失败。

更常见的情况是,XML结构虽然合法,但内容可能不符合你的预期。比如,某个必需的元素缺失了,或者数据类型不对。XMLParser本身不会帮你校验这些“业务逻辑”上的问题,这需要你在didEndElement中手动检查。举个例子,如果price元素本应是数字,但XML里却写成了文本,你需要在赋值时尝试转换,并处理转换失败的情况。

我个人的经验是,对于生产环境的代码,对foundCharacters的trimmingCharacters(in: .whitespacesAndNewlines)操作是必不可少的,因为XML文本内容经常包含多余的空白符和换行符,这些会污染你的数据。同时,对可能为空的字符串进行nil合并操作(?? "N/A")也是一种防御性编程的好习惯,防止程序因为nil而崩溃。处理大型或复杂XML时,逻辑会变得相当复杂,因为你需要手动维护一个“状态机”,知道当前正在解析哪个元素的哪个子元素,这确实是个挑战。

相较于其他解析方式,XMLParser的优势与局限性是什么?

XMLParser最大的优势在于其事件驱动的特性。这意味着它在处理超大型XML文件时,内存占用非常小。它不会像DOM(Document Object Model)解析器那样,一次性把整个XML树加载到内存中。如果你正在处理GB级别的XML日志文件,或者从网络流式接收XML数据,XMLParser的效率和内存管理能力是无与伦比的。此外,它是Apple内置的框架,无需引入第三方库,减少了项目依赖。

然而,它的局限性也同样明显。首先,它的API是基于代理的,这意味着你需要编写大量的样板代码来处理各种事件,尤其当XML结构嵌套很深时,维护当前解析状态(比如当前是哪个book的哪个author)会变得非常繁琐,需要手动管理一个栈或类似的结构。这与JSON解析的Codable协议形成了鲜明对比,Codable能让你以声明式的方式轻松地将JSON映射到Swift对象,极大简化了代码。

其次,XMLParser不提供直接的DOM操作或XPath查询能力。如果你需要频繁地查询XML文档中的特定节点,或者修改XML内容,XMLParser就不合适了。你需要自己实现一套遍历和查询逻辑。对于更复杂的XML操作,通常会考虑引入第三方库,例如KissXML或AEXML,它们提供了更高级的抽象和便利的API,虽然代价是增加了项目依赖和可能更高的内存开销。所以,选择哪种解析方式,真的取决于你的具体需求和XML文件的特性。

如何将解析后的XML数据结构化存储?

将解析后的XML数据结构化存储,核心在于定义清晰的Swift数据模型。在上面的例子中,我使用了Book结构体来承载解析出来的数据。这种方式是Swift中处理数据集合的典型做法。

当XMLParser遍历XML文档时,你需要在didEndElement回调中,根据当前结束的元素名称,将收集到的foundCharacters数据赋值给你的数据模型实例的相应属性。例如,当title元素结束时,将foundCharacters赋值给currentBook.title。当一个完整的逻辑单元(比如一个book元素)解析完毕时,你需要将这个完整的currentBook实例添加到你的数据数组(books: [Book])中,并清空currentBook以准备解析下一个。

这种逐个元素构建对象的方式,虽然需要手动管理状态,但它确保了数据在内存中的结构化,方便后续的业务逻辑处理,比如展示到UI界面、进行数据筛选或存储到本地数据库。

// 这是上面解决方案中已经包含的结构体struct Book {    var id: String?    var author: String?    var title: String?    var genre: String?    var price: String?    var publishDate: String?    var description: String?}// 在 XMLBookParser 类中,我们定义了一个数组来存储解析后的所有书籍class XMLBookParser: NSObject, XMLParserDelegate {    var books: [Book] = [] // 存储所有解析完成的Book对象    private var currentBook: Book? // 临时变量,用于构建当前正在解析的Book对象    // ... 其他属性和方法 ...}

这种模式使得解析过程与数据存储逻辑紧密结合,每当一个完整的book节点被解析完成,它就会被添加到books数组中,最终形成一个包含所有书籍信息的Swift对象数组,非常便于后续操作。这种方式也体现了面向对象编程的思想,将数据和操作数据的逻辑封装在一起。

以上就是如何在Swift中使用XMLParser解析本地XML文件?的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1430084.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
XSL-FO的marker有什么用途?
上一篇 2025年12月17日 03:18:57
Java中DOM和SAX解析XML有什么区别?如何选择?
下一篇 2025年12月17日 03:19:08

相关推荐

  • 如何系统学习蝴蝶号无人直播运营的核心知识

    如何系统学习蝴蝶号无人直播运营的核心知识如何系统学习蝴蝶号无人直播运营的核心知识如何系统学习蝴蝶号无人直播运营的核心知识如何系统学习蝴蝶号无人直播运营的核心知识

    要系统学习蝴蝶号无人直播运营的核心知识,首先要理解平台逻辑、制定精细化内容策略、掌握自动化技术并持续进行数据分析与风险控制。具体包括:一是深入研究平台算法和规则边界,确保操作合规;二是构建高质量、多样化且合规的内容素材库,并进行标签化管理;三是选择安全可靠的自动化工具,避免使用违规软件;四是模拟真人…

    2026年9月21日 • 用户投稿
    200
  • Swoole如何实现一个UDP服务器

    答案:使用Swoole可轻松创建高性能UDP服务器。通过new SwooleServer()设置UDP套接字,监听Packet事件接收数据,利用sendto()回复客户端;结合set()配置worker_num等参数优化性能,配合PHP UDP客户端测试通信,适用于高并发、低延迟场景。 使用Swoo…

    2026年9月21日
    000
  • MySQL执行计划中的Extra字段代表什么_怎么看优化空间?

    MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?

    在 mysql 查询优化中,执行计划的 extra 字段用于说明查询执行时的额外操作,常见的值包括:1. using filesort 表示需要额外排序,应尽量通过建立索引避免;2. using temporary 表示使用了临时表,常见于 group by 或复杂 join,需优化减少其使用;3.…

    2026年9月21日 • 用户投稿
    000
  • OPPO官宣哈苏专业影像套装:为Find X9系列打造“口袋中的完全体哈苏”

    OPPO官宣哈苏专业影像套装:为Find X9系列打造“口袋中的完全体哈苏”OPPO官宣哈苏专业影像套装:为Find X9系列打造“口袋中的完全体哈苏”OPPO官宣哈苏专业影像套装:为Find X9系列打造“口袋中的完全体哈苏”OPPO官宣哈苏专业影像套装:为Find X9系列打造“口袋中的完全体哈苏”

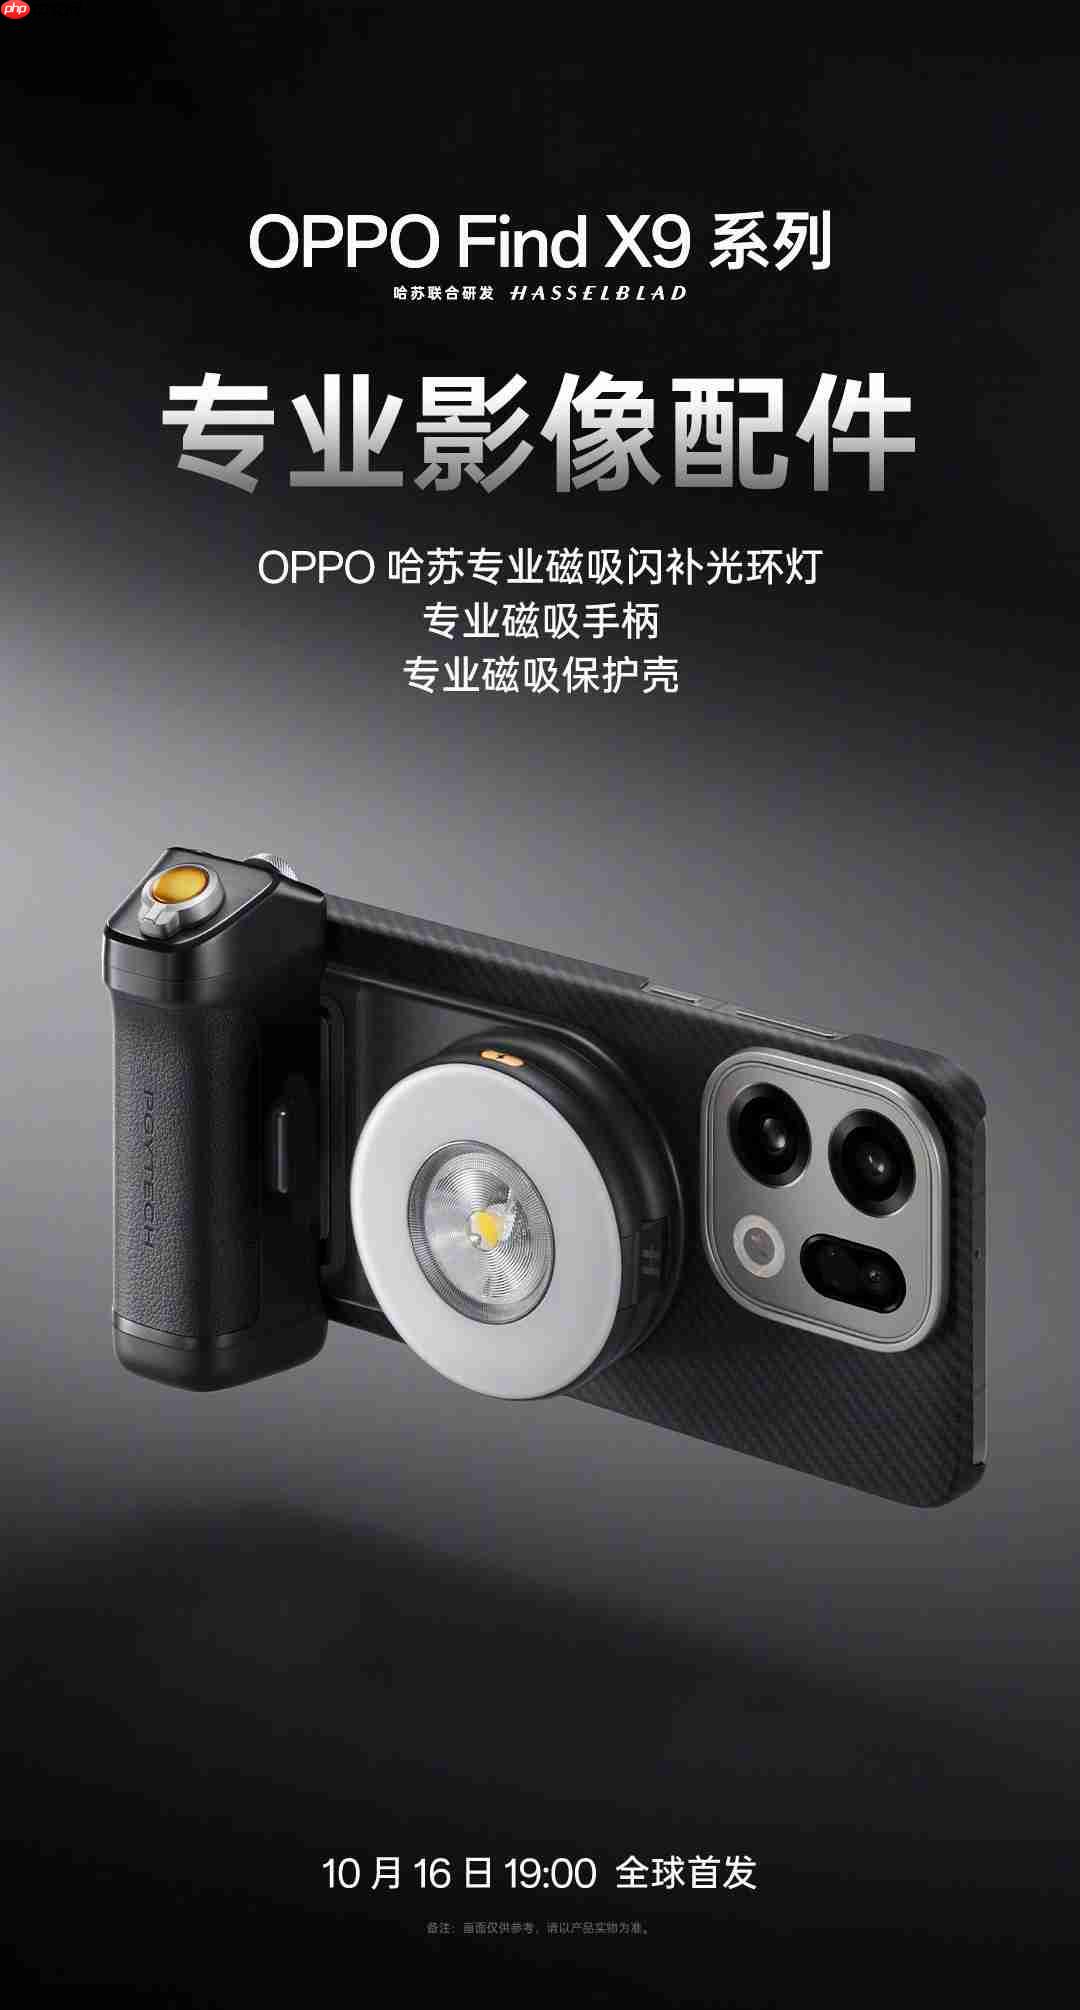
    10月13日,oppo正式宣布将发布哈苏专业影像套装,涵盖哈苏专业增距镜、全新磁吸手柄、磁吸保护壳以及专业手机肩带等配件。该套装被官方誉为“口袋里的完整版哈苏”,主打“追星无需携带相机”的理念,将于10月16日随find x9系列一同亮相,并专为find x9 pro机型优化适配。 图片来源@OPP…

    2026年9月21日 • 用户投稿
    000
  • 如何通过tracert命令追踪数据包从本地到目标服务器的完整路径?

    打开命令提示符,输入cmd并回车;2. 执行tracert 目标地址命令追踪路径;3. 查看每跳响应时间与IP,分析延迟变化定位网络瓶颈;4. 注意部分节点可能因防火墙不响应导致超时。 使用 tracert(Windows 系统)命令可以追踪数据包从你的计算机到目标服务器所经过的每一跳网络节点,帮助…

    2026年9月21日
    900
  • Linux interfaces 虚拟网络类型了解01

    Linux interfaces 虚拟网络类型了解01Linux interfaces 虚拟网络类型了解01Linux interfaces 虚拟网络类型了解01Linux interfaces 虚拟网络类型了解01

    在osi模型的定义中,数据链路层和物理层,以及传输层和网络层执行的任务在概念上相似:它们都提供了数据传输的方式,即沿着特定路径将数据从源点传输到目的地的方法。然而,数据链路层和物理层负责跨物理路径的通信服务,而传输层和网络层则提供由多个数据链路组成的逻辑路径或虚拟路径的通信服务。 Bridge操作指…

    2026年9月21日 • 用户投稿
    000
  • 如何在Java中理解Java I/O与NIO机制

    传统I/O是阻塞式流模型,适用于低并发场景;NIO基于缓冲区与通道,支持非阻塞和多路复用,适合高并发网络应用,核心区别在于线程模型与资源利用率。 Java中的I/O(输入/输出)与NIO(New I/O)是处理数据读写的核心机制,理解它们的区别和使用场景对开发高性能应用至关重要。传统I/O基于流模型…

    2026年9月21日
    000
  • UC浏览器网页上的文字无法选中复制怎么办 UC浏览器解决网页文字禁止复制问题

    答案:可通过开发者工具、阅读模式、打印预览、OCR识别或自定义脚本解除UC浏览器网页复制限制。具体操作依次为:开启开发者工具并执行JavaScript代码解除限制;启用阅读模式净化页面内容;使用打印预览重新渲染页面以选中文字;对截图应用OCR技术提取文本;添加书签脚本自动移除禁用选择的代码,从而实现…

    2026年9月21日
    000
  • JavaScript中的尾调用优化(TCO)在ES6中如何工作?

    尾调用是指函数的最后一个动作调用另一个函数,ES6引入尾调用优化以重用栈帧、避免内存溢出,支持真正的尾递归,如阶乘函数通过累积参数实现。 尾调用优化(Tail Call Optimization, TCO)是ES6引入的一项语言特性,目的是在特定条件下重用函数调用栈帧,避免不必要的内存增长,从而支持…

    2026年9月21日
    100
  • MySQL数据分库分表如何设计_避免性能瓶颈的方法?

    MySQL数据分库分表如何设计_避免性能瓶颈的方法?MySQL数据分库分表如何设计_避免性能瓶颈的方法?MySQL数据分库分表如何设计_避免性能瓶颈的方法?MySQL数据分库分表如何设计_避免性能瓶颈的方法?

    分库分表设计需注意分片键选择、分片数量控制、避免跨库查询及完善运维体系。一,优先选择高频查询字段作为分片键,如用户id,避免使用时间戳以防写热点;二,初期合理分片(如4~8库,每库4~8表),预留扩容空间并根据数据总量反推分片数;三,尽量避免跨库查询,可通过冗余数据、异步汇总或强制路由优化;四,配套…

    2026年9月21日 • 用户投稿
    000
  • 抖音蝴蝶号无人直播带货操作流程及注意事项

    抖音蝴蝶号无人直播带货操作流程及注意事项抖音蝴蝶号无人直播带货操作流程及注意事项抖音蝴蝶号无人直播带货操作流程及注意事项抖音蝴蝶号无人直播带货操作流程及注意事项

    “抖音蝴蝶号无人直播带货”是一种通过自动化或半自动化技术实现的直播销售模式。①其核心在于摆脱真人主播限制,实现24小时不间断直播,提升效率与流量利用率;②关键步骤包括明确账号定位与商品选择、准备高质量且丰富的内容素材、利用虚拟人或预录内容实现直播推流、结合智能客服模拟评论区互动;③优势在于降低人力成…

    2026年9月21日 • 用户投稿
    500
  • VSCode侧边栏怎么去掉_VSCode侧边栏隐藏教程

    隐藏VSCode侧边栏可通过Ctrl + B(Windows/Linux)或Cmd + B(macOS)快捷键快速切换,也可通过菜单栏“视图 > 外观 > 切换侧边栏可见性”或命令面板执行“View: Toggle Sidebar Visibility”实现。推荐使用快捷键操作,效率最高…

    2026年9月21日
    000
  • win10连接打印机错误0x00000709怎么办_win10打印机连接错误修复方法

    错误代码0x00000709通常因权限不足、系统更新冲突或服务异常导致共享打印机连接失败。可使用专业工具一键修复,或通过修改注册表权限、卸载KB5005569等特定更新、重启Print Spooler及相关服务,以及添加Windows凭据(如IP地址和guest账户)解决该问题。 当您在Window…

    2026年9月21日
    100
  • php switch语句怎么用_php中switch条件判断语句的用法示例

    答案:PHP中switch语句用于多条件判断,语法为switch(表达式){case值:代码;break;},通过松散比较匹配case值,执行对应代码块,遇到break跳出避免穿透,default处理无匹配情况。示例根据$day输出星期几,注意事项包括case值不可为表达式、需注意类型松散比较、省略…

    2026年9月21日
    100
  • MobileCLIP2— 苹果开源的端侧多模态模型

    MobileCLIP2— 苹果开源的端侧多模态模型MobileCLIP2— 苹果开源的端侧多模态模型MobileCLIP2— 苹果开源的端侧多模态模型MobileCLIP2— 苹果开源的端侧多模态模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 可图大模型 可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型 32 查看详情 MobileCLIP2是什么 mobileclip2是由苹果研究团队开发的新一代高效多模态模型,…

    2026年9月21日 • 用户投稿
    100
  • 如何利用蝴蝶号自动直播间打造被动收入系统

    如何利用蝴蝶号自动直播间打造被动收入系统如何利用蝴蝶号自动直播间打造被动收入系统如何利用蝴蝶号自动直播间打造被动收入系统如何利用蝴蝶号自动直播间打造被动收入系统

    要打造蝴蝶号自动直播间实现被动收入,核心在于用预设内容和智能系统替代真人出镜,构建低干预、可持续的流量转化模式。1.内容策略上选择“长寿型”内容,如软件教程、助眠音频、产品演示,并设计循环播放逻辑;2.技术搭建时优化互动设置,嵌入商品链接与自动弹幕,提升直播间活性;3.多渠道引流,结合短视频与社交媒…

    2026年9月21日 • 用户投稿
    000
  • MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本

    MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本

    最小权限原则是mysql用户权限配置的核心,确保每个用户仅拥有必要权限以提升安全性与可维护性。1.明确需求:根据用户角色分配如只读、增删改查或结构修改权限;2.创建用户并编写sql脚本进行权限管理,替代手动输入命令,提高效率与一致性;3.使用sublime text等编辑器提升脚本编写效率,利用语法…

    2026年9月21日 • 用户投稿
    000
  • mac怎么在菜单栏显示日期_Mac菜单栏显示日期方法

    首先启用菜单栏时钟显示,进入系统设置→控制中心→日期与时间→开启“在菜单栏中显示”;接着在“桌面与程序坞”→“时钟”中勾选“显示日期”以显示星期和具体日期,可选开启24小时制或秒数;若设置未生效,可通过终端执行killall SystemUIServer命令强制刷新菜单栏。 如果您发现Mac的菜单栏…

    2026年9月21日
    200
  • 音乐文件占用空间太多怎么办_音乐文件占用空间太多如何整理详细指南

    解决音乐文件占空间问题的关键是压缩与整理:先用软件或在线工具降低比特率压缩体积,再按场景分类、利用元数据自动归集,并通过听歌片段和BPM判断保留内容,避免重复与误删。 音乐文件占空间太多,核心解决办法就两条:一是压缩单个文件体积,二是通过有效分类管理提升使用效率。直接删歌不是长久之计,学会整理和优化…

    2026年9月21日
    000
  • Via浏览器在鸿蒙系统上运行会闪退怎么办_Via浏览器鸿蒙系统闪退的解决方法

    Via浏览器闪退可依次尝试清除缓存数据、更新或重装应用、检查系统更新与存储空间、禁用硬件加速功能,必要时通过开发者模式启用USB调试并使用DevEco Studio捕获日志定位问题。 如果您在使用Via浏览器访问网页时,应用突然关闭或无法正常启动,则可能是由于软件兼容性或系统资源问题导致。以下是解决…

    2026年9月21日
    300

发表回复

登录后才能评论
关注微信