..的核心作用是选中当前节点的直接父节点,如//span/..可选中span的父节点li,连续使用可向上多级跳跃,常用于灵活定位。

XPath中那个看似简单的
..
语法,其核心作用就是让你从当前所在的节点,向上一步,准确无误地选中它的直接父节点。这在处理XML或HTML文档时,简直是家常便饭,而且效率奇高,是构建复杂路径时不可或缺的一个小工具。
解决方案
说白了,
..
就是个快捷方式,它代表着“回到上一层”。想象一下你在一个文件系统的某个文件夹里,输入
cd ..
就能回到上一级目录,XPath里的
..
就是这个意思。它允许你从一个特定的子节点出发,反向追踪到它的容器。
我们来看个例子,假设有这么一段HTML结构:
- Item 1
- Item 2 (current)
- Item 3
如果你当前选择的节点是那个
标签,也就是通过路径
//span
找到了它。现在,你想选中包含这个
的
标签,怎么办?很简单,在
//span
后面直接加上
..
就行了。
完整的XPath表达式会是这样:
//span/..
这个表达式会精确地选中那个
的直接父节点,也就是
Item 2 (current)
这个
标签。
再比如,如果你当前选中了
这个节点,想找到它的父节点
,路径就是
//li[text()='Item 1']/..
。结果就是
- ...
。
..
的强大之处在于它的相对性。无论你当前节点是什么,只要它有父节点,
..
就能帮你找到它。这让XPath的路径构建变得异常灵活,尤其是在你不知道完整路径,或者路径可能因为结构变化而改变时,它能提供一种非常稳定的向上导航方式。
XPath中
..
..
与
parent::
轴的区别是什么?
很多人会问,既然有
..
,那
parent::
轴又是什么鬼?两者到底有啥区别?其实,
..
就是
parent::node()
的一个简写。在我看来,它就是为了方便而生。你想啊,每次都写
parent::node()
多麻烦,
..
多简洁。在绝大多数情况下,它们的效果是完全一样的,都指向当前节点的直接父节点。
但它们之间还是有点细微的差别,虽然在实际应用中你可能很少用到。
parent::
是一个轴(axis),它允许你在选择父节点时加上更具体的条件,比如节点类型。例如,
parent::div
会选择父节点中类型为
div
的节点。而
..
则没有这种能力,它总是选择任何类型的直接父节点。
举个例子:如果你有这样的结构:
123
如果你在
value
节点,
./..
会选中
item
。
./parent::*
也会选中
item
。但是,如果你写
./parent::data
,只有当
value
的直接父节点是
data
时才会被选中。而
..
就没法做这种类型限制。
所以,通常我们为了简洁和效率,都会优先使用
..
。只有在非常特殊、需要明确指定父节点类型的情况下,才会考虑使用
parent::
轴。这就像是,你知道要去隔壁房间,直接走过去就行(
..
),没必要非得强调“我要走去那个用木头做的、门朝东的房间”(
parent::房间类型
)。
如何在复杂的XML/HTML结构中高效使用
..
..
来定位父节点?
在复杂的文档结构里,
..
的用处可就大了。它不仅仅是简单地向上跳一步,更可以连续使用,或者与其他XPath轴和谓语(predicates)结合起来,实现非常精准的定位。
1. 连续使用
..
向上多级跳跃:如果你需要从一个深层节点跳到它的“祖父”甚至“曾祖父”节点,可以简单地连续使用
..
。比如,从
跳到
:
//span/../..这会先从
跳到它的父节点
,再从
跳到它的父节点
,然后从
跳到
。哦,等等,我这里举例有点跳跃了,应该是
->
->
->
。所以,
//span/../../..才是从
span到
div。
Item 2 (current)如果当前节点是
,
//span/..是
,
//span/../..是
,
//span/../../..是
。这种链式操作非常直观。
2. 结合谓语进行条件筛选:
..可以和谓语结合,在向上跳跃后,再对目标父节点进行筛选。例如,你想找到某个特定
的父节点
,并且这个
的
class属性是
active:
//span[text()=' (current)']/../li[@class='active']这个路径会先找到文本为
(current)的
,然后向上找到它的父节点
。注意这里我写错了,
../li[@class='active']是错的,因为
../已经到了
了,再加
li就变成找
下面的
了。正确的应该是:
//span[text()=' (current)']/..[@class='active']这样,它会找到
的父节点,并且这个父节点必须同时满足
@class='active'这个条件。如果父节点不满足这个条件,整个路径就不会匹配到任何东西。这在确定父节点是否是期望的类型或具有特定属性时非常有用。
3. 向上跳跃后再横向导航:这是非常常见的用法。你从一个子节点向上跳到它的某个祖先节点,然后从那个祖先节点再向下或者横向寻找其他兄弟节点。比如,从
出发,找到它所在
的父节点
,然后从
找到它的所有
子节点:
//span/../../li这个路径会先从
跳到
,再从
跳到
,然后从
向下寻找所有的
子节点。这在需要获取某个元素同级或父级下的其他相关元素时非常高效。
高效使用
..的关键在于,你得对文档的树形结构有清晰的认识。每次使用
..,就像是你在树上向上爬了一层,然后你可以选择在这一层停留,或者继续向上,或者从这一层开始向下寻找其他分支。
使用
..时可能遇到的常见问题及应对策略?
尽管
..语法简单直观,但在实际应用中,还是会遇到一些小麻烦,或者说,是理解上的偏差。
1. 误解
..只能选择直接父节点:这是最常见的一个“坑”。
..永远只会选择当前节点的直接父节点,不会跳过中间层级去选择祖父节点或更远的祖先。应对策略: 如果你需要选择祖父节点,就用
../..;如果需要选择更远的祖先,就连续使用更多的
..。或者,更优雅的方式是使用
ancestor::轴,例如
ancestor::div会选择所有的
div祖先节点,而
ancestor::div[1]则选择最近的那个
div祖先。根据具体需求选择最清晰的路径。
2. 路径变得过长,难以阅读和维护:当层级很深时,你可能会写出
../../../../..这样一长串的
..。这样的路径虽然有效,但可读性很差,一旦文档结构发生微小变化,就很容易失效。应对策略: 尽量从一个更稳定、更独特的祖先节点开始你的XPath路径。例如,如果你的目标元素在一个具有唯一ID的
div内部,可以从那个
div开始,比如
//div[@id='uniqueContainer']/ul/li/span/..,而不是从
span开始一路向上。这样即使
span和
li之间的层级略有调整,只要
uniqueContainer还在,你的路径就可能保持有效。有时候,适当牺牲一点点路径的“绝对性”,换取更高的鲁棒性,是值得的。
3. 对当前上下文(context node)的误判:尤其是在进行链式操作时,很多人会搞不清当前
..操作是基于哪个节点进行的。比如
//div/p/..,这个
..是基于
p节点进行的,它会选择
p的父节点
div。但如果写成
//div/p[text()='hello']/../span,这个
..是基于那个文本为
hello的
p节点,它会回到
div,然后从
div去寻找
span。应对策略: 始终在脑海中构建一个“当前节点”的概念。每执行一步XPath,当前节点集都会发生变化。在复杂的路径构建时,可以一步一步地在XPath测试工具中验证,确保每一步都符合预期。这就像编程中的调试,一步步跟踪变量状态。
理解这些常见问题,并掌握相应的应对策略,能让你在XPath的海洋中游刃有余,更高效、更准确地定位到你想要的元素。
以上就是XPath的..语法如何选择父节点?的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1430416.html赞 (0)打赏微信扫一扫
支付宝扫一扫
关于作者

相关推荐
如何在Java中比较字符串 Java字符串比较的正确方式
在java中比较字符串内容应使用equals()方法而非==运算符,因为==比较的是对象引用地址,而equals()逐字符比较内容。1. 使用equals()可确保字符内容和长度一致,如str1.equals(str2)返回true;2. 注意null值处理,推荐用objects.equals()避…
win11重装系统教程是什么_全新安装Win11系统步骤详解

通过内置恢复功能可重置Windows 11系统,保留或删除文件并从云端下载最新镜像完成重装;2. 使用U盘启动盘能实现清洁安装,完全格式化硬盘并全新部署系统,适合需完全控制的用户;3. 第三方一键重装工具提供图形化向导,自动下载系统镜像并简化安装流程,适合技术新手快速恢复设备性能。 如果您发现Win…
Pact消费者测试:为何不直接交互实时服务?设计理念与核心优势

Pact是一种契约测试工具,旨在通过模拟服务(Mock Provider)而非直接调用实时服务来验证消费者与提供者之间的API契约。这种设计确保了测试的确定性,并为API提供者提供了消费者实际使用接口的清晰视图,从而促进了API的独立演进,避免了不必要的版本升级,并提高了测试的效率和可靠性。 Pac…
composer.json的config.gitlab-domains怎么配置_教你配置gitlab-domains字段管理仓库访问
gitlab-domains 是 Composer 配置项,用于声明自定义 GitLab 域名以支持私有仓库拉取。它必须包含 gitlab.com 和企业内网域名(如 git.mycompany.com),否则 Composer 无法识别私有 GitLab 项目。配置位于 composer.json…
VSCode如何集成Redis客户端 VSCode Redis可视化工具的使用教程
在vscode中高效管理多个redis实例需通过安装如“redis explorer”类扩展,添加连接时为每个实例命名(如“开发环境redis”)以便区分;2. 切换实例可通过侧边栏下拉或点击连接名快速完成;3. 常见连接问题包括连接超时(检查redis服务与防火墙)、认证失败(核对密码)、未知主机…
win10怎么查看电脑开关机记录 win10查看系统开关机历史记录的方法
通过事件查看器筛选事件ID 6005可查看开机记录,筛选ID 6006可查看关机记录,也可使用命令提示符输入systeminfo | find “系统启动时间”快速获取本次开机时间,还可将日志导出为evtx文件用于后续分析。 如果您需要了解电脑的启动与关闭情况,但无法直接回忆…
如何用Java实现多语言网站系统变现 Java国际化模块应用案例
构建国际化基础:用java的locale和resourcebundle管理多语言资源文件(如messages_zh.properties),通过accept-language头、用户选择或url参数识别区域,并结合thymeleaf等模板引擎动态加载文本,同时使用dateformat、numberf…
满射的核心性质:值域与陪域相等
满射指函数的值域等于陪域,即对陪域中每个元素都存在定义域中的原像。这保证了函数能覆盖所有可能输出,体现为解的存在性、系统完整性及应用中的无遗漏特性,在数学与工程中具有重要意义。 满射,这个词在数学里听起来有点抽象,但它的核心性质其实非常直观,甚至可以说就是它的定义:一个函数是满射,当且仅当它的值域与…
电商平台如何高效对外提供商品库存信息?SprykerProductAvailabilitiesRestApi模块助你轻松解决!
可以通过一下地址学习composer:学习地址 想象一下,你正在负责一个快速发展的电商平台。随着业务的扩张,前端页面需要实时展示商品的库存状态,移动应用也急需一个接口来获取同样的数据,甚至你可能还需要将商品可用性信息同步给合作的第三方平台或营销工具。最初,我们团队尝试在 Spryker 内部手动构建…
UC浏览器新标签页怎么自定义_UC浏览器自定义起始页设置
可通过内置模板将UC浏览器新标签页设为空白页、常用网站等;2. 能在起始页设置中输入指定网址实现自定义跳转;3. 还可利用第三方HTML文件链接完成高级个性化定制。 如果您希望在使用UC浏览器时提升浏览效率或个性化您的上网体验,可以通过设置自定义新标签页来实现。默认情况下,新标签页可能显示的是热门资…
如何用豆包AI优化短视频脚本?分镜提示词生成攻略
使用豆包ai优化短视频脚本的核心在于生成创意分镜提示词以提升质量与效率。1. 明确主题与受众,如针对年轻女性突出美食颜值与店铺氛围;2. 利用豆包ai生成脚本大纲,例如输入“北京胡同美食探店”以获取结构框架;3. 细化分镜提示词,提供详细场景描述如“特写烤鸭金黄表皮,搭配欢快民乐”;4. 迭代优化提…
如何诊断电脑玩游戏时突然掉帧的问题?
掉帧问题通常由硬件、软件或系统配置异常引起,需逐步排查。首先检查显卡驱动是否过旧或存在兼容性问题,建议使用DDU彻底卸载后安装最新或稳定版驱动。其次监控CPU和GPU温度,过热会触发降频导致性能下降,可通过HWMonitor等工具检测,并清理灰尘、更换硅脂改善散热。后台程序如浏览器、杀毒软件、云同步…
windows10休眠功能在哪里开启_windows10开启休眠模式方法
首先通过控制面板或命令提示符启用休眠功能,再通过电源设置配置自动休眠计划,并更新显卡等驱动程序以确保兼容性,最终恢复Windows 10电源菜单中的“休眠”选项。 如果您发现Windows 10的电源菜单中缺少“休眠”选项,可能是由于系统默认未启用该功能或相关设置被关闭。以下是恢复并开启休眠模式的具…
PHP数据如何入库_PHP实现MySQL数据插入操作
使用PDO预处理语句可安全高效插入数据。首先建立数据库连接,推荐使用PDO或MySQLi;接着通过prepare()构建带占位符的SQL语句,使用execute()绑定参数执行,避免SQL注入;建议采用命名占位符提升代码可读性;同时需验证输入、设置正确字符集、检查插入行数以确保操作成功。 PHP将数…
18A工艺Panther Lake处理器稳了 Intel神优化:没发布就提升18%游戏性能
9月11日消息,在近日的ifa展会上,intel携手acer率先推出了搭载panther lake处理器的swift 16 ai轻薄本,这款产品也成为首款采用intel 18a工艺制程的代表作。 目前具体配置尚未公开,需等待正式发布后揭晓。不过可以确认的是,Panther Lake将分为两个系列:主…
composer的–dev模式和–no-dev模式的切换方法_解析–dev和–no-dev模式切换的应用场景
–dev安装开发依赖,–no-dev仅安装生产依赖;本地开发使用–dev,生产环境用–no-dev以减小体积、提升安全;CI/CD中测试阶段用–dev,构建镜像时用–no-dev优化性能。 在使用 Composer 管理 PHP…
中国科大实现真多体纠缠子空间自检验
郭光灿院士团队在量子信息领域取得关键突破,其柳必恒研究员课题组与本源量子联合攻关,在光学与超导两个量子平台上成功实现了对真实多体纠缠子空间的设备无关验证,并完成了五比特纠错码空间的自检验。该研究成果于5月14日发表于国际物理学权威期刊《物理进展报告》(reports on progress in p…
windows电脑安装python教程
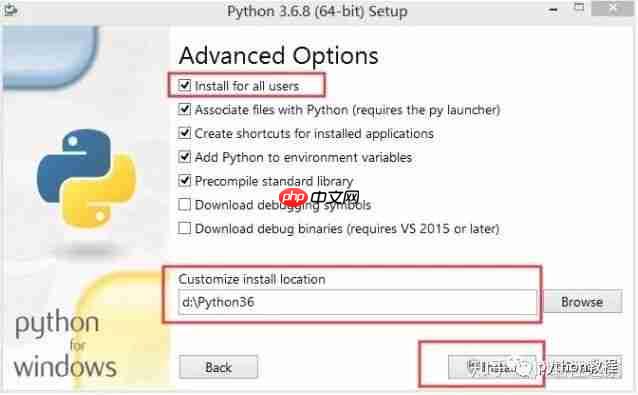
1 选择版本 建议从3.x版本开始学习Python,因为2.x版本将逐渐被淘汰。本教程使用的是Python 3.6版本。 2 下载安装包 访问Python官方网站的下载页面 https://www.php.cn/link/598e989a5706e1ab5cea5e65598d2125,选择适合的安…
Pages如何调整行距和字距 Pages文本美观排版的细节调整
调整行距、字距及段前段后间距可显著提升Pages文档排版美观度与可读性,具体操作包括:选中内容后在格式检查器中设置行距为1.15至1.5倍或自定义点值,通过字体面板调节字距增强标题视觉平衡,结合段前段后6–12 pt间距优化整体布局层次。 如果您在使用 Pages 编写文档时发现文本排版不够美观,可…
爱氏物语什么时候发售 游戏上线时间介绍
爱氏物语发售时间详情 由Mas独立开发并发行的像素风格冒险游戏《爱氏物语》将于2025年8月7日正式登陆Steam平台。这是一款融合了轻松氛围与深刻剧情的趣味作品,背景设定在一个人类与人工智能共存的未来末世,讲述了一段充满悬念与情感波折的旅程。 本作采用回合制战斗机制,节奏舒缓不累,搭配多样化的支线…