
优化XPath性能需减少遍历与回溯,优先使用ID、类名等直接定位方式,避免滥用//,限定搜索上下文,优化谓词顺序与类型,并结合CSS选择器优势,以降低引擎计算成本,提升执行效率。
优化XPath表达式性能,核心在于减少不必要的遍历和回溯,优先使用ID和类名等直接定位方式,并确保我们对DOM结构的理解足够清晰,避免在不必要的地方进行全局搜索。说到底,就是让XPath引擎的工作量尽可能小。
解决方案
谈到XPath性能,我个人觉得,这玩意儿就像一把双刃剑。它强大到可以定位几乎任何你想要的东西,但这份强大如果用不好,分分钟就能让你的程序卡顿。我的经验告诉我,很多时候性能问题并不是XPath本身有多慢,而是我们写XPath的时候,没给它“指明方向”,让它在庞大的DOM树里瞎转悠。
首先,最直接的优化就是减少
//
的使用。这个双斜杠代表着“任意后代节点”,它会强迫XPath引擎从当前上下文节点开始,遍历所有子孙节点,然后找出匹配的。想想看,如果你的HTML文档有几千甚至几万个节点,每次都全盘扫描,那效率可想而知。能用
/
(直接子节点)就用
/
,能用相对路径就用相对路径。比如,你明确知道一个
标签在某个
下面,写
//div/a就比
//a要好得多,因为它把搜索范围限定在了
div的直接子元素里。
其次,利用唯一标识符。这是老生常谈,但真的非常重要。ID是唯一的,
//*[@id='someId']这种表达式几乎是瞬间定位。如果目标元素有
class属性,或者自定义的
data-*属性,比如
//div[@class='item-card']或
//button[@data-test-id='submit-button'],这些都是非常高效的定位方式。它们提供了明确的锚点,让XPath引擎可以快速锁定目标,而不是进行大量的模式匹配。
再来,限定搜索上下文。如果你已经通过某个XPath定位到了一个父级元素,比如一个
下的
,那么在这个
div内部查找子元素时,就应该以这个
div作为上下文节点,而不是再次从整个文档的根节点开始。很多XPath库都支持从一个已定位的元素对象上继续执行XPath,这能极大缩小搜索范围,提高效率。
最后,谓词的优化也值得关注。谓词(
[]里的内容)是XPath筛选节点的重要工具。
属性谓词优于文本谓词:
[@class='active']通常比
[text()='激活']要快。因为属性是结构化的,易于索引和比较;文本内容需要更复杂的扫描和匹配。将选择性强的谓词前置:如果一个元素需要满足多个条件,把最能缩小结果集范围的条件放在前面。比如,
//div[@class='item'][position()=1]可能比
//div[position()=1][@class='item']略优,因为先按类名筛选,再取第一个,通常比先取第一个再筛选类名要高效。避免在谓词中使用复杂的函数:像
contains(text(), '部分文字')或者
normalize-space()这类函数,会增加处理的复杂性。如果可以,尽量用更直接的属性匹配或更精确的路径来替代。
这些点听起来可能有点零散,但它们都指向一个核心:给XPath引擎提供尽可能多的“线索”,让它少做无用功。
XPath性能瓶颈通常出现在哪些场景?
说实话,XPath性能瓶颈的出现,往往不是单一因素造成的,它更像是一个复杂的组合拳。我个人在实践中观察到,以下几种情况是导致XPath变慢的“重灾区”:
首先,面对超大型DOM文档。当一个HTML或XML文件内容极其庞大,DOM树的深度和广度都超乎寻常时,任何涉及全文档遍历的操作都会变得异常缓慢。想象一下,一个网页加载了几万行HTML,几十层嵌套,你还在用
//span[contains(text(), '某个关键字')]这种表达式,那简直是在大海捞针,而且是反复捞。
其次,滥用
//(descendant-or-self轴)。我之前也提过,
//是一个非常方便的语法糖,它允许你跳过中间节点直接定位。但它的代价是,XPath引擎需要检查路径中所有可能的子孙节点。如果你在深层嵌套的结构中频繁使用
//,或者在一个循环里反复执行包含
//的XPath,每次都从根节点开始搜索,那性能瓶颈几乎是必然的。
再者,复杂且低效的谓词。谓词是XPath的强大之处,但也是性能陷阱。
基于文本内容的模糊匹配:例如
[contains(text(), '部分内容')],特别是当
text()返回的内容很长时,这需要逐个节点进行文本提取和字符串匹配,计算成本很高。多条件组合谓词:
[condition1 and condition2 or condition3],尤其是当这些条件本身就不够高效时,组合起来就更慢了。位置谓词的误用:
[position()=1]本身很快,但如果用在不恰当的位置,比如
//div[1]/span,这实际上是先找到所有
div的第一个子元素,再看是不是
span,可能不是你想要的效果,也可能效率不高。
另外,频繁的回溯操作也是一个隐形杀手。XPath允许你使用
parent::、
ancestor::等轴向上查找。虽然这很方便,但每次向上回溯都意味着引擎需要沿着DOM树反向遍历,这在深层结构中同样会消耗大量资源。我见过一些代码,为了定位一个元素,写了一长串
parent::*/parent::*/following-sibling::*,虽然逻辑清晰,但执行起来简直是灾难。
最后,XPath引擎本身的实现效率也是一个不可忽视的因素。不同的编程语言或库(比如Python的
lxml、Java的
javax.xml.xpath、浏览器内置的XPath引擎)对XPath的解析和执行效率可能大相径庭。有些引擎可能对特定的优化模式有更好的支持,而有些则可能实现得比较通用,导致在特定场景下性能不佳。有时候,你写了一个“看起来”很高效的XPath,但它在某个特定的环境中就是跑不快,这可能就是引擎的锅。
如何编写更高效的XPath路径表达式?
编写高效的XPath,我觉得更像是一门艺术,需要对DOM结构有深刻的理解,并且懂得如何“引导”XPath引擎。这里有一些我个人总结的,非常实用的编写技巧:
从最具体的、最稳定的节点开始:这几乎是黄金法则。如果你的目标元素在一个有唯一ID的父元素内部,那么就从那个ID开始。例如:
id('main-content')//div[@class='item']。这比直接
//div[@class='item']要快得多,因为它直接将搜索范围锁定在一个很小的子树内。即使没有ID,也可以找一个具有独特
class或
data-*属性的祖先节点。
避免不必要的
//,尽可能使用
/:
//是“通配符”,告诉XPath引擎在任何层级查找。而
/是“直接子节点”,限定了层级关系。如果你知道
a标签是
div的直接子元素,写
//div/a比
//a更精确,也更高效。当你需要跳过几个未知层级时,
//才真正派上用场,但即使如此,也要尽量限制其作用范围,比如
id('products')//h3。
利用上下文节点,缩小搜索范围:如果你已经定位到了一个父节点,比如一个
article元素,那么在这个
article内部查找标题时,应该以这个
article为起点,而不是从整个文档的根目录重新开始。很多库都支持
element.find_element_by_xpath('./h2')这样的相对路径,这里的
.就代表当前元素。这能显著减少XPath引擎的搜索空间。
优化谓词的顺序和类型:
优先使用属性匹配:
[@attribute='value']通常比
[text()='some text']快。属性值是固定的,查找起来效率高。将最具选择性的谓词放在前面:如果一个元素需要满足多个条件,比如
//div[@class='product-card' and @data-status='available'],如果
class属性比
data-status属性更能快速过滤掉大量不相关的
div,那么把它放在前面通常会更好。避免在谓词中进行全文本扫描:
[contains(., '关键字')]虽然方便,但如果目标文本很长,或者文档中有很多相似文本,效率就会很低。如果可能,尝试匹配更具体的子元素文本,或者使用更精确的路径。使用
starts-with()代替
contains():如果你知道字符串是以前缀开头的,
starts-with(@class, 'prefix')通常比
contains(@class, 'prefix')更快,因为它不需要检查字符串的每个子串。
考虑使用
position()谓词的替代方案:虽然
[position()=1]本身很快,但有时候可以通过更精确的路径来避免它。例如,
div[1]/a比
div/a[1]更常见且可能更高效,因为它先选择第一个
div,再在该
div内找
a,而不是找到所有
div下的
a再取第一个。
善用
child::和
self::轴:
child::是默认轴,所以
div/a等同于
div/child::a。
self::轴在某些场景下也很有用,比如
//div[self::div[@class='active']],虽然这个例子可能不那么直观,但它说明了如何精确地匹配当前节点。
通过这些细致的调整,你会发现XPath的执行效率会有一个明显的提升,让你的爬虫或自动化脚本跑得更顺畅。
XPath与CSS选择器在性能上有什么区别?
这个问题我经常被问到,也思考过很多次。在我看来,XPath和CSS选择器在性能上的差异,很大程度上源于它们设计哲学和能力范围的不同,以及底层实现的优化程度。
首先从设计哲学来看,CSS选择器最初是为样式渲染而生,它的核心目标是高效地匹配DOM中的元素,以便应用样式。因此,CSS选择器在设计时就非常注重从上到下、从右到左的匹配效率,例如
div.item p,浏览器会先找到所有
p标签,然后向上查找它们的父元素是否是
div.item。这种设计在浏览器渲染大量元素时能够保持高性能。
而XPath则不同,它是一个更通用、更强大的XML/HTML文档查询语言。它不仅可以从上到下,还能从下到上(
parent::、
ancestor::)、从左到右或从右到左(
preceding-sibling::、
following-sibling::)进行遍历。它支持更复杂的谓词,比如基于文本内容的匹配、数值比较,甚至一些简单的逻辑运算。这份强大,自然也带来了更高的潜在计算成本。
其次是能力范围。CSS选择器在处理简单、直接的元素定位时(如通过ID、类名、标签名、属性)非常高效。它能覆盖绝大多数前端开发中需要定位元素的场景。但当你需要进行一些复杂操作时,比如:
向上查找父节点:CSS选择器做不到。查找兄弟节点(非紧邻的或基于特定条件的):CSS选择器能力有限。基于元素文本内容进行匹配:CSS选择器无法直接做到。复杂的多条件逻辑组合:CSS选择器会变得非常笨拙甚至无法实现。在这些场景下,XPath是不可替代的。
最后是底层实现的差异。现代浏览器对CSS选择器引擎进行了大量的优化,它们通常是高度编译和优化的C++代码,能够以极快的速度解析和匹配。这是因为CSS选择器是浏览器渲染引擎的核心组成部分,性能至关重要。而XPath引擎的实现,尤其是在一些通用库中,可能没有达到同样的优化水平。虽然像
lxml这样的库也对XPath进行了高度优化,但在某些极端复杂的查询场景下,或者与简单CSS选择器相比,其性能劣势可能会显现出来。
我的个人看法是: 在进行Web scraping或自动化时,我通常会遵循一个原则——能用CSS选择器解决的,尽量用CSS选择器;只有当CSS选择器无法满足需求时,才转向XPath。 这并不是说XPath就一定慢,而是它提供了更多的“自由度”,这种自由度也意味着更容易写出低效的表达式。对于那些简单、直接的定位任务,CSS选择器往往能提供更简洁的语法和更优异的性能。但对于那些需要跨层级、基于文本内容或复杂逻辑的定位,XPath无疑是更强大的工具,即便可能牺牲一点点性能,也是值得的。关键在于,当你选择XPath时,要清楚它的工作原理,并尽可能地优化你的表达式。
以上就是XPath表达式性能如何优化?的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1430706.html赞 (0)打赏微信扫一扫
支付宝扫一扫
关于作者

相关推荐
-
DeepSeek 的微调功能怎么用 自定义模型训练指南
deepseek 的微调功能是通过使用特定业务数据对预训练模型进行再训练,以提升其在具体任务上的表现。1. 数据准备是关键,需确保数据干净、准确、有代表性,并采用 json lines 或 csv 格式;2. 选择合适的预训练模型,如文本生成模型用于生成任务;3. 配置学习率、batch size …
-
整理桌面图标win10方法
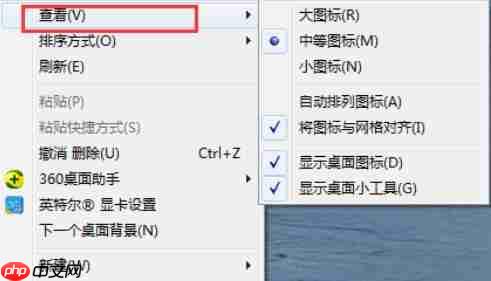

想要让自己的windows 10桌面更加整洁美观,但又不知道如何下手?别担心,接下来就为大家详细介绍如何在win10系统中整理桌面图标,让你的桌面焕然一新! 如何让Win10桌面图标整齐排列: 首先,在桌面上单击鼠标右键,然后选择顶部菜单中的“查看”选项。 在弹出的菜单中,你可以看到诸如“自动排列图…
-
Xftp6 绿色版-特别版

xftp6是一款适用于ms windows平台的sftp和ftp文件传输软件工具,旨在帮助用户在unix/linux和windows pc之间安全传输文件。软件采用了标准的windows风格向导,界面简洁,易于与其他windows应用程序无缝协作,满足初级和高级用户的传输需求,功能强大,欢迎有需要的…
-
前端验证后调用Servlet的正确方法

本文旨在解决在前端JavaScript验证后如何正确调用Servlet的问题。通过分析常见的错误原因,例如表单提交事件的阻止和页面重载,以及Servlet中HTTP方法的使用,提供了一种清晰的解决方案,确保在前端验证通过后,能够成功地向Servlet发送请求并处理用户登录。 在Web开发中,经常需要…
-
家里有网为什么手机连不上wifi

1、检查手机设置 检查状态栏中是否有WiFi图标,或者进入设置–WLAN选项,看看是否已经成功连接到WiFi。此外,进入设置–其他网络与连接–私人DNS,检查是否启用了私人DNS功能,若有开启,建议将其关闭后再尝试连接。 2、检查WiFi网络 请使用其他手机连接相…
-
360极速浏览器提示证书错误怎么办_360极速浏览器网站安全证书无效问题解决
首先调整浏览器证书设置,取消高级选项中的“客户端身份验证”和“安全电子邮件”勾选;其次检查系统时间是否准确并开启自动同步;接着清除浏览器缓存与Cookie;最后查看证书详情,确认颁发机构及有效期,确保证书链完整可信。 如果您在访问某个网站时,360极速浏览器提示证书错误或安全证书无效,这通常意味着浏…
-
快手直播带货中控台叫什么?快手直播中控台在哪里打开

近年来,直播带货作为一种新兴的电商模式,受到了广泛关注。各大电商平台纷纷布局直播领域,而快手作为国内领先的短视频和直播平台,更是将直播带货推向了高潮。在一场场精彩的直播带货活动中,有一个神秘的团队,他们负责整个直播间的后台操控,确保直播过程顺利进行。快手直播带货中控台叫什么呢?今天,就让我们一起揭开…
-
sublime怎么配置python环境_Sublime Text Python开发环境搭建指南
首先安装Sublime Text并配置Python路径,接着通过安装Package Control来管理插件,然后安装Anaconda、SublimeREPL等常用Python开发插件以实现代码补全、语法检查和交互式调试,最后通过设置缩进、语法高亮和快捷键提升编码效率。 要在Sublime Text…
-
Win7电脑制作清理垃圾工具的方法
在我们日常使用windows 7系统电脑时,相信有不少用户都想自己动手制作一个清理垃圾的小工具。那么,windows 7系统如何制作清理垃圾工具呢?接下来,小编将为大家详细介绍制作方法,感兴趣的朋友不妨一起来看看吧。 Windows 7系统制作清理垃圾工具的方法 1、打开命令提示符(CMD),输入D…
-
蔚领时代沉浸式XR影视作品《木兰2125》在京首发 以科技创新建设数字文化产业新生态
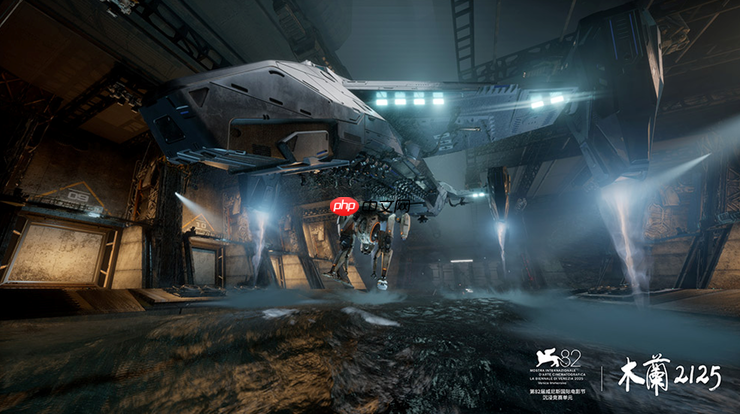
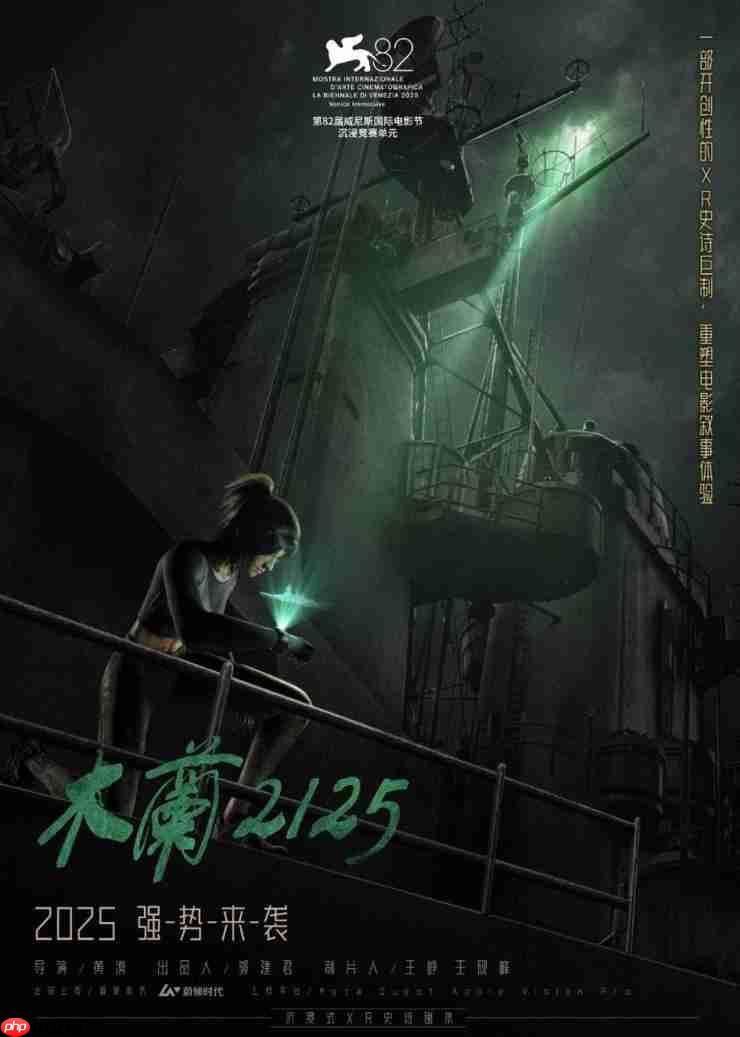

“感觉像又经历了一次迪士尼的‘飞跃地平线’!开场大海的波浪就在我眼前了!”“刚从环球影视城回来,在这里又体验了一遍像‘火种源争夺战’的沉浸感!实在没想到现在的xr内容能这么真实!”9月23日,3a级沉浸式xr影视大作《木兰2125》在北京798·751园区举行首发暨品鉴活动。现场气氛热烈,行业嘉宾齐…
-
Lucene教程:如何构建不匹配任何文档的空查询

在Lucene开发中,当需要一个不匹配任何文档的“空”查询时,直接返回null可能导致问题。本文将介绍如何利用MatchNoDocsQuery来构建一个功能上等同于“空”的查询,确保在特定业务逻辑下(如安全校验失败时)查询行为的规范性和稳定性,避免潜在的空指针异常或不确定行为。 引言:为何需要“空”…
-
信息系统的核心组成部分
1、 null 2、 信息系统是一个由计算机硬件、软件、网络设备、信息资源、用户以及管理制度共同组成的,致力于高效管理信息流动的人机协作体系,用以完成信息的采集、传递、存储与应用。 3、 系统涵盖信息输入、存储、处理、输出和控制五大核心功能,其发展历程可分为三个阶段:初始的数据处理系统、单一业务的管…
-
sublime怎么分屏对比两个文件_Sublime多窗口分屏进行文件内容对比技巧
最直接的方法是使用Sublime Text的分屏布局功能,通过View → Layout选择Columns: 2等布局,将两个文件分别拖入不同面板进行对比;为进一步提升效率,可安装SublimeFileDiffs插件实现差异高亮比对,并结合快捷键、多视图管理与项目保存优化工作流。 Sublime T…
-
宝马自动充电机器人即将推出,可实现全流程无人介入充电


☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 7月3日,宝马官方宣布,其研发的自动充电机器人已经完成测试阶段,将根据未来市场情况择机投入实际应用。 据了解,这款自动充电机器人完全不需要人工干预。当车辆停入指定的自动充电区域后,系统会利用AI…
-
Win11更新遇到错误怎么解决?Win11更新遇到错误解决方法
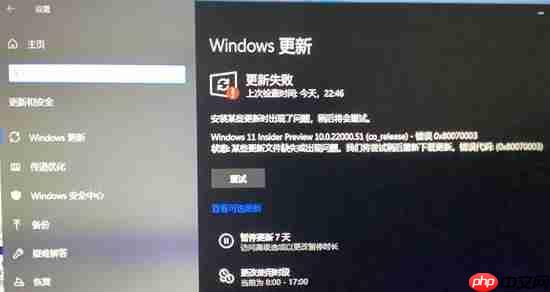
自从windows 11预览版推出以来,微软一直在积极解决系统中出现的各种问题,并陆续向用户推送了多个更新补丁。这些补丁旨在修复windows 11运行时的各类问题,然而部分用户在安装更新时却遭遇了错误提示。若在更新windows 11补丁时遇到此类问题,可以按照以下步骤操作: 首先,确保关闭或卸载…
-
Android开发:按钮点击实现Activity切换教程
本教程详细讲解了在Android应用中如何通过按钮点击实现不同活动(页面)之间的切换。我们将重点介绍如何利用Intent机制来启动目标Activity,并提供具体的代码示例,帮助开发者快速掌握页面导航的核心方法,提升用户体验。 理解Android Intent机制 在android开发中,inten…
-
天禧携手字节扣子:AI生态再扩容,开发者与用户双向赋能
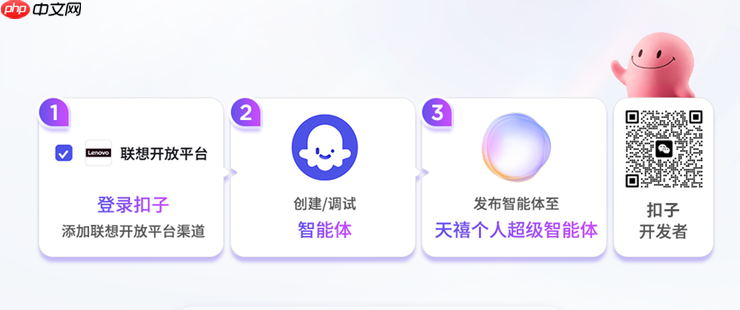
9月25日,天禧个人超级智能体正式宣布与字节跳动旗下的ai智能体开发平台“扣子”建立生态合作关系。继chatexcel凭借“对话做表”功能引发广泛关注后,此次携手扣子平台,不仅是天禧在ai能力上的又一次重要拓展,更意味着联想的ai战略已迈入平台整合与生态共建的新阶段,ai生态赋能的核心价值得到显著提…
-
sublime怎么格式化json_Sublime Text JSON代码美化与格式化插件

使用 Pretty JSON 插件可轻松格式化 JSON 文件,先通过 Package Control 安装插件,再按 Ctrl+Shift+P 调用命令实现美化与校验。 在 Sublime Text 中格式化 JSON 文件非常方便,只需借助一些轻量又实用的插件即可实现代码美化。最常用的方法是使用…
-
linux怎么运行脚本
要在 Linux 中运行脚本,请先确保脚本具有可执行权限(ls -l script_name),然后通过以下几种方法运行脚本:命令行(./script_name)、Bash 命令(bash script_name)、Python 命令(python script_name.py)。脚本可以从命令行接…
-
如何用豆包AI生成Python命令行工具


明确需求后,用豆包ai生成python命令行工具可节省时间。1. 首先清晰描述功能,如“根据关键词搜索指定目录下的文本文件”;2. 豆包ai会生成完整脚本结构,包括argparse参数解析和文件遍历逻辑;3. 可进一步要求优化,如忽略大小写、支持更多文件类型;4. 进阶可让其生成打包模板,便于pip…
