XPath函数通过字符串处理、节点筛选和逻辑判断等功能,显著提升路径表达式的灵活性与精准度。典型函数如contains()和starts-with()用于模糊匹配属性值,应对动态class或href;normalize-space()清理文本中的冗余空白,提升数据质量;count()和position()支持列表项的定量分析与索引定位;结合text()、substring-before()、translate()等可精准提取复杂文本中的目标信息,如价格、库存数字;在多语言场景中,通过关键词判断语言类型;面对不规则结构时,利用following-sibling、name()、local-name()实现相对定位与泛化选择,增强选择器的鲁棒性。

XPath函数,说白了,就是你在构建路径表达式时,用来给筛选节点、处理数据加点“魔法”的工具。它能让你在原本只能按层级、按属性找节点的基础上,进行字符串操作、数值计算、布尔逻辑判断,甚至对节点集进行更复杂的处理。在我看来,掌握这些函数,是把XPath从“能用”提升到“好用”的关键一步,尤其是在面对那些结构不那么规整,或者你需要从文本里抠出特定信息的时候。
解决方案
使用XPath函数,你通常会把它们嵌入到你的路径表达式中,无论是作为谓词(
[]
里的条件),还是作为最终选择器的一部分。基本语法是
函数名(参数)
。参数可以是节点集、字符串、数字或布尔值,具体取决于函数的需求。
我们可以大致把XPath函数分为几类,每类都有其独特的应用场景:
节点集函数 (Node Set Functions): 这类函数主要用于处理或获取节点集的信息。
count(node-set)
: 返回节点集中的节点数量。
count(//li)
会统计页面上所有
元素的数量。
position()
: 返回当前节点在节点集中的位置(从1开始)。
//div[position() = 2]
会选择第二个
元素。
last()
: 返回节点集中的最后一个节点的位置。
//p[position() = last()]
会选择最后一个
元素。
id(string)
: 根据ID属性值选择元素。
id('main-content')
会选择ID为
main-content
的元素。
字符串函数 (String Functions): 用于处理节点或属性的文本内容。
string(object)
: 将任何类型的数据转换为字符串。
string(//h1)
会获取第一个
元素的文本内容。
concat(string1, string2, ...)
: 连接多个字符串。
concat('Hello', ' ', 'World')
结果是 “Hello World”。
contains(string1, string2)
: 检查
string1
是否包含
string2
。
//a[contains(@href, 'product')]
选择所有
href
属性包含 “product” 的链接。
starts-with(string1, string2)
: 检查
string1
是否以
string2
开头。
//div[starts-with(@class, 'item-')]
选择所有
class
属性以 “item-” 开头的
。
substring(string, start, length)
: 提取字符串的子串。
substring('HelloWorld', 6, 5)
结果是 “World”。
string-length(string)
: 返回字符串的长度。
//p[string-length(text()) > 50]
选择文本内容长度超过50的
。
normalize-space(string)
: 移除字符串开头和结尾的空格,并将内部连续的空格替换为单个空格。
normalize-space(//div[@class='description']/text())
。
布尔函数 (Boolean Functions): 返回
true
或
false
,常用于谓词中。
not(boolean)
: 对布尔值取反。
//a[not(@target='_blank')]
选择所有
target
属性不为 “_blank” 的链接。
true()
/
false()
: 返回字面布尔值。
数值函数 (Number Functions): 用于执行数学计算。
number(object)
: 将对象转换为数字。
sum(node-set)
: 计算节点集中所有节点的数值之和。
floor(number)
: 向下取整。
ceiling(number)
: 向上取整。
round(number)
: 四舍五入。
这些函数可以单独使用,也可以嵌套使用,形成非常强大的表达式。比如,你想找一个
class
包含 “card” 并且文本内容里有 “优惠” 字样的
div
,你可以这样写:
//div[contains(@class, 'card') and contains(text(), '优惠')]
。这里的
and
也是一个逻辑运算符,它允许你组合多个条件。
常用XPath函数有哪些,它们各自的典型应用场景是什么?
在我日常的网页抓取和XML处理工作中,有那么几个XPath函数是我的“常客”,用得频率非常高,它们各自解决的问题也挺典型的。
首先是
contains()
和
starts-with()
,这两个简直是处理动态或模糊属性值的利器。很多网站的
class
或
id
属性会带有一些随机字符串,比如
item-12345
或
product-card-abc
。如果你只知道
item-
或
product-card-
这部分固定前缀,
starts-with(@class, 'item-')
就能帮你精准定位。而如果关键词可能出现在属性值的任何位置,比如
href
属性里包含
category=electronics
,那
contains(@href, 'category=electronics')
就派上用场了。我个人觉得,这两个函数极大地增强了XPath的鲁棒性,让它在面对前端框架生成的复杂HTML时也能游刃有余。
接着是
normalize-space()
。哦,这个函数,简直是文本清洗的救星!网页上的文本内容,特别是那些从数据库里拉出来或者用户输入的内容,经常会带着多余的空格、换行符、制表符。直接获取会很脏,影响后续的数据处理。
normalize-space(text())
可以把这些乱七八糟的空白字符清理得干干净净,只保留一个有意义的、规范化的字符串。我很多时候会直接在提取文本时就加上它,省去了后面用Python或JavaScript再做一次清洗的麻烦。
count()
和
position()
也很常用,尤其是在你需要处理列表或者重复结构时。比如,你可能想确认某个列表有多少项,或者只想选择列表中的前几项、中间某一项。
count(//ul/li)
告诉我列表项的总数,而
//ul/li[position() < 3]
就能选出前两项。有时候,网站的结构并不提供直接的索引,但你可以通过
position()
来模拟,比如找到某个特定元素后的第三个兄弟节点。
最后,不得不提
text()
。虽然它不是一个函数,但经常和函数一起使用。
//div[@class='price']/text()
就能直接抓取到价格文本。但如果文本分散在多个子节点中,或者夹杂着其他标签,你可能需要
string(.)
或者
normalize-space(.)
来获取所有子孙文本的拼接结果,这在提取段落内容时特别有效。
在实际抓取数据时,如何利用XPath函数处理复杂的文本和属性值?
在实际的数据抓取中,复杂的文本和属性值是常态,而不是例外。XPath函数在这里能发挥出巨大的作用,让你的选择器变得更加智能和灵活。
举个例子,假设你要从一个商品详情页抓取价格。价格信息可能不是一个简单的数字,它可能是“¥ 129.99起”或者“原价: 200.00,现价: 150.00”。如果你的目标是提取“129.99”,你可以先用
normalize-space()
清理文本,然后结合
substring-before()
或
substring-after()
甚至
translate()
来“切割”字符串。比如,
substring-before(normalize-space(//div[@class='price']/text()), '起')
就能帮你拿到“¥ 129.99”。如果连货币符号也想去掉,你可能需要更进一步,比如
translate(substring-before(normalize-space(//div[@class='price']/text()), '起'), '¥', '')
。
再比如,处理属性值。很多网站的图片URL可能藏在
data-src
属性里,或者一个元素的
class
属性包含多个值,如
class="product-item large active"
。如果你只想选择
active
的商品项,你可以用
//div[contains(@class, 'active')]
。但如果
active
只是其中一个状态,你可能还需要结合其他条件,比如
//div[contains(@class, 'product-item') and contains(@class, 'active')]
。
有时候,链接的
href
属性可能是一个相对路径,或者包含一些你不需要的查询参数。虽然XPath函数不能直接修改URL,但你可以用
starts-with()
筛选出你感兴趣的特定路径,或者用
substring-before()
截取URL的固定部分,比如
substring-before(@href, '?')
来去除问号后的所有参数,当然这只是一个初步的筛选,更精细的URL处理通常在抓取后进行。
我还遇到过一种情况,需要从一个混杂了文字和数字的字符串中提取纯数字。比如“库存:123件”。这时候,
translate()
函数就显得特别强大。你可以通过
translate(., '库存:件', '')
将这些非数字字符替换为空,从而只留下数字部分。然后,如果你想把它当作数字来计算,可以用
number(translate(., '库存:件', ''))
。这种组合使用,确实能解决不少让人头疼的提取问题。
XPath函数在处理多语言内容或不规则HTML结构时有哪些高级用法?
处理多语言内容和不规则HTML结构,是XPath函数真正展现其“高级”之处的场景。这不仅仅是找到元素,更是要以一种灵活且健壮的方式去适应变化。
对于多语言内容,虽然XPath 1.0中没有直接的语言检测函数(XPath 2.0+有
lang()
),但我们依然可以通过结合文本内容判断来间接处理。比如,如果你要抓取一个新闻网站的标题,而这个网站有中文和英文版,但HTML结构可能只有微小差异,甚至完全一样,只是内容不同。你可以通过检查标题文本中是否包含特定语言的关键词来筛选:
//h2[contains(text(), '新闻') or contains(text(), '最新')]
针对中文,
//h2[contains(text(), 'News') or contains(text(), 'Latest')]
针对英文。这虽然有点笨拙,但在没有
lang
属性或者其他明确语言标识时,是一个实用的方法。更进一步,如果你知道不同语言的特定日期格式或数字格式,也可以利用
matches()
(XPath 2.0+) 或
translate()
结合
string-length()
来进行模式匹配和筛选。比如,检查文本是否符合某种日期格式的正则表达式。
至于不规则HTML结构,这才是XPath函数大显身手的地方。网页开发者并不总是按照W3C标准来写HTML,或者为了快速迭代,结构会变得非常“自由”。
following-sibling::*
或
preceding-sibling::*
结合
position()
就非常有用了。
//h2[text()='产品详情']/following-sibling::p[position()=1]
就能找到标题“产品详情”后的第一个段落。这比硬编码一个绝对路径要灵活得多。
结合
name()
或
local-name()
:** 有时候,你不知道具体的标签名是什么,或者标签名可能会变(比如从
div
变成
section`),但你知道它一定是某个标题标签(h1-h6)或某个列表项。
//*[starts-with(name(), 'h')]
可以选择所有
h1
到
h6
的标题。这在处理语义化不那么严格的页面时,能帮你抓取所有层级的标题。
local-name()
函数就显得尤为重要,它会忽略命名空间前缀,只关注标签的本地名称。
//p[string-length(normalize-space(text())) > 0]
可以筛选出所有非空的
标签。这在过滤掉那些视觉上不可见但HTML里存在的空标签时非常有效。
id()
函数的妙用:
即使id
属性不在你当前路径的直接父级,你也可以通过
id('some-id')
直接跳到那个元素,然后从那里开始你的相对路径。这在处理大型、复杂且有明确ID标识的页面时,能提供一个快速的“锚点”。
总而言之,面对复杂和不规则的结构,XPath函数提供了一种“以不变应万变”的策略。它们允许你根据元素的行为、内容或相对位置来定位,而不是仅仅依赖于其静态的层级和标签名。这需要一些经验和对HTML结构的洞察,但一旦掌握,你的XPath技能会提升一个档次。
以上就是XPath函数如何使用?的详细内容,更多请关注php中文网其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1430856.html
 微信扫一扫
 支付宝扫一扫
关于作者



相关推荐
-
苹果官网正品验证入口 iPhone序列号查询真伪通道
苹果官网正品验证入口为https://checkcoverage.apple.com/cn/zh/,用户需进入页面输入设备序列号并完成验证码验证,系统将自动显示设备型号、激活状态、保修期限及技术支持信息;序列号可通过手机“设置-通用-关于本机”、包装盒标签、购买发票或Apple Watch应用获取;…
-
VSCode配置C/C++单元测试 完整VSCode开发环境搭建
要搭建#%#$#%@%@%$#%$#%#%#$%@_e2fc++805085e25c9761616c00e065bfe8中c/c++单元测试环境,需先安装c/c++扩展、test adapter for google test等必要插件,配置tasks.json和launch.json实现编译与调试…
-
处理动态数量问答数据的更新教程
本教程旨在详细阐述如何有效地管理和更新包含动态数量答案的问题数据。我们将探讨在Web表单中如何设计输入字段以捕获答案内容及其唯一标识符,并通过服务器端(以PHP为例)解析提交的数据,从而实现对现有答案的精确更新和新答案的添加,确保数据一致性和系统健壮性。 场景概述:处理动态数量的问答数据更新 在许多…
-
google浏览器播放视频没声音怎么办_google浏览器视频没声音解决方法
首先检查系统和Chrome应用音量是否开启,确认标签页未被静音,接着允许网站声音权限,排查扩展程序干扰,最后通过清除数据和重置设置解决Chrome视频无声音问题。 如果您在使用Google Chrome观看视频时遇到没有声音的问题,这可能是由于系统设置、浏览器配置或扩展程序导致的。以下是解决此问题的…
-
mysql怎么建立索引 mysql索引创建步骤及注意事项
mysql建立索引的核心操作是使用create index或alter table add index语句。1. create index适用于已存在的表添加索引,语法简洁明了,支持unique、fulltext、spatial等索引类型,并可指定索引列长度和索引类型(btree或hash)。2. …
-
小米平板6 Max 14对决苹果iPad Air 13:安卓大屏平板的生产力应用与生态体验,能否挑战iPad的霸主地位?
小米平板6 Max 14凭借14英寸大屏、PC级WPS和多任务工作台模式,在办公场景实现突破;iPad Air 13(M2版)则依托M2芯片性能与苹果生态联动,保持综合体验优势。 小米平板6 Max 14和苹果新推出的iPad Air 13(M2版)都瞄准了移动生产力市场,但走的是两条不同的路。小米…
-
gRPC rocks build your first gRPC service(part 1)
if you’re new to the scene, the complexity of using protoc to develop a grpc service might have left you feeling overwhelmed. while the protoc c…
-
悟空浏览器兼容性模式在哪里设置_悟空浏览器IE兼容模式开启方法
开启悟空浏览器IE兼容模式可解决网页显示异常问题。1、通过设置菜单进入“更多工具-兼容性设置”,开启“启用IE兼容模式”并重启浏览器;2、针对特定网站,在地址栏点击兼容性图标,选择“在此站点使用IE兼容模式”以实现局部适配;3、熟悉调试的用户可按F12打开开发者工具,切换“Document Mode…
-
VSCode 如何自定义编辑器的背景动态效果 VSCode 背景动态效果的自定义创意方法
想让vscode编辑器背景动起来,需安装“custom css and js loader”扩展,创建包含gif动图路径的自定义css文件,并在settings.json中配置该css文件路径;2. 启用扩展后重启vscode,允许其注入自定义样式以实现动态背景;3. 实现原理是利用vscode基于…
-
如何在PhotoFiltre中使用AI裁剪图片?快速掌握精准裁剪方法
PhotoFiltre无原生AI裁剪功能,需结合手动裁剪技巧与外部AI工具如Remove.bg、Cutout.pro等协同使用,先用AI完成智能抠图,再导入PhotoFiltre进行精细调整与合成,实现高效精准图像处理。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 Deep…
-
唉,一次堆外内存泄露让整个团队通宵处理到爆肝!

点击上方“芋道源码”,选择“设为星标” 管她前浪,还是后浪? 能浪的浪,才是好浪! 每天 10:33 更新文章,每天掉亿点点头发… 源码精品专栏 原创 | Java 2021 超神之路,很肝~中文详细注释的开源项目RPC 框架 Dubbo 源码解析网络应用框架 Netty 源码解析消息中…
-
Flink 1.16 Job Manager 重启后消息丢失问题排查及解决
Flink 作业在遇到异常时,会根据配置的重启策略进行自动重启。但如果整个 Job Manager 重启,可能会出现消息丢失的情况。本文旨在帮助你排查和解决 Flink 1.16 中 Job Manager 重启后消息丢失的问题,涵盖了可能的原因和相应的解决方案,确保数据处理的完整性。 问题分析 当…
-
Prestashop分类页描述与分页:SEO考量及前端行为解析
本文深入探讨Prestashop电商平台中分类页面描述在分页操作时消失的常见现象。我们将解析其背后的技术原理,重点从搜索引擎优化(SEO)角度阐述为何此行为并非核心问题,并强调确保分类描述在首页面加载时的完整性至关重要。同时,文章也提供若需自定义此行为的思路。 Prestashop分类页描述的分页行…
-
苹果11手机无法启动怎么办
确认充电状态与配件是否正常 当你的iPhone 11无法开机时,第一步应检查充电连接是否正常。请确保设备已连接至原装或经过认证的充电器,并尝试更换不同的充电线、电源适配器或插座,以判断是否为充电设备故障所致。此外,充电口容易积聚灰尘或异物,可能影响电力输入,建议用干净柔软的布料轻轻清理接口部分,确保…
-
悟空浏览器官方下载地址安全 悟空浏览器官网链接入口快速
悟空浏览器官方下载地址是https://www.wukong.com/browser,该官网提供极简界面设计、视频聚合播放、广告过滤和书签同步等功能,支持多平台使用。 悟空浏览器官方下载地址在哪里?这是不少网友都关注的,接下来由PHP小编为大家带来悟空浏览器官网链接入口,感兴趣的网友一起随小编来瞧瞧…
-
MacOS系统安装MySQL有哪些注意事项?
安装mysql在macos上通常有两种方式:使用官方dmg安装包或通过homebrew。1. 官方dmg安装需注意选择与系统架构匹配的版本(arm64适用于m系列芯片,x86, 64-bit适用于intel芯片),设置root密码并配置环境变量;2. homebrew安装自动适配架构,通过命令安装并…
-
VSCode怎样用调试控制台执行临时代码片段 VSCode 调试控制台执行临时代码的创新用法
是的,vscode调试控制台可在调试时执行代码片段并查看复杂对象。1. 启动调试会话并打开调试控制台(ctrl+shift+y);2. 直接输入代码访问或修改变量,如myvar=20;3. 执行函数调用或复杂表达式验证逻辑;4. 查看复杂对象时点击展开箭头、使用console.dir()或json.…
-
嵌入式Linux开发-根文件系统本地挂载
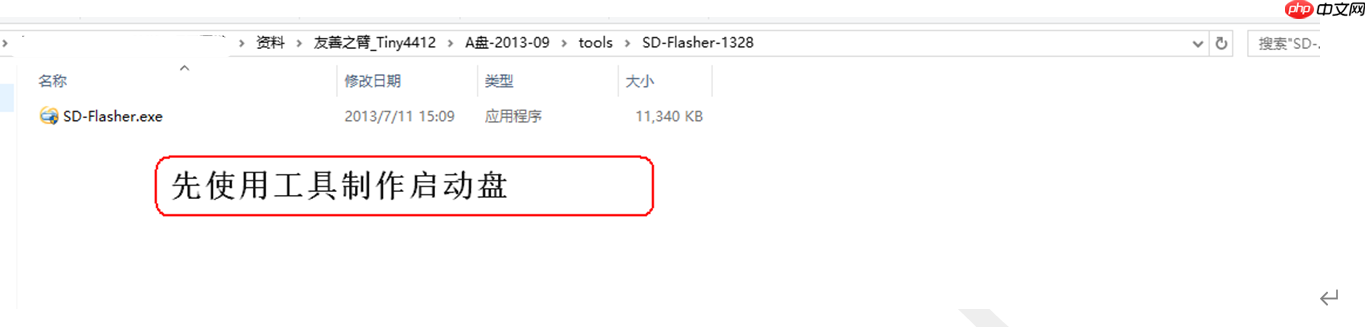
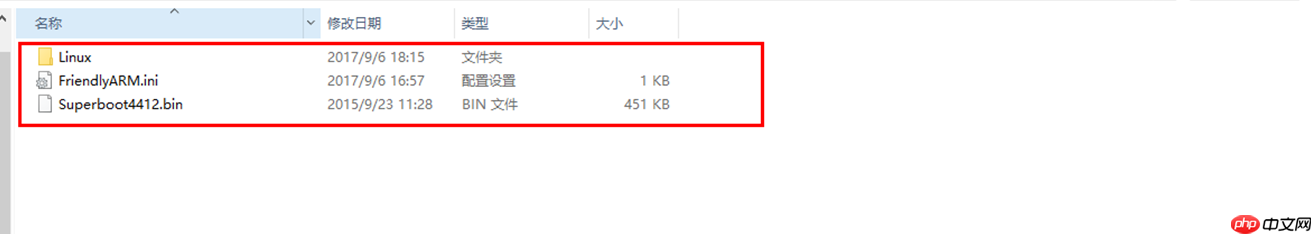
引言 前一篇文章介绍了根文件系统的制作与nfs网络挂载,本文将探讨如何通过本地挂载根文件系统来完成系统启动。本地挂载通常用于产品发布阶段,并且分为两种操作方式。 第一种方式:在PC机上制作好文件映像rootfs.img,然后通过uboot加载并直接烧写到EMMC中。这种方法最便捷,适用于产品批量生产…
-
win10无法格式化U盘怎么办_win10 U盘格式化失败解决方案
首先检查并解除U盘的物理或软件写保护,通过注册表修改WriteProtect值为0;若无效,使用磁盘管理删除卷并新建简单卷;仍无法格式化时,用diskpart命令clean后重新分区格式化;或运行chkdsk修复文件系统错误;最后可借助EaseUS等第三方工具强制处理。 如果您尝试在Windows …
-
悟空浏览器怎么设置成触屏模式_悟空浏览器开启触屏优化模式教程
开启触屏优化模式可提升悟空浏览器操作流畅度,首先通过设置菜单启用触屏模式,其次修改用户代理模拟移动设备以激活触控布局,最后通过调整页面缩放与手势设置优化触控体验。 如果您在使用悟空浏览器时发现页面操作不够流畅,或者界面元素显示不符合触控习惯,可能是由于未开启触屏优化模式。启用该模式可以提升手指操作的…