如何解决C++大数据开发中的数据标签化问题?

如何解决c++大数据开发中的数据标签化问题?

如何解决C++大数据开发中的数据标签化问题?

随着互联网和数字技术的迅猛发展,大数据已经成为当今社会的重要组成部分。在大数据开发中,如何高效地处理和管理数据成为了一个重要的问题。数据标签化是大数据开发中的一项关键任务,它可以帮助开发人员更好地理解和管理海量的数据。本文将介绍如何在C++大数据开发中解决数据标签化问题,并给出相应的代码示例。

数据标签化是将数据分成不同的类别或标签,以便更好地对数据进行管理和分析。在C++开发中,可以使用结构体、枚举或封装类等数据结构来实现数据标签化。下面是一个使用结构体实现数据标签化的示例:

#include #include struct Person {    std::string name;    int age;    double height;};int main() {    Person p1;    p1.name = "张三";    p1.age = 25;    p1.height = 1.75;    Person p2;    p2.name = "李四";    p2.age = 30;    p2.height = 1.80;    std::cout << "姓名:" << p1.name << std::endl;    std::cout << "年龄:" << p1.age << std::endl;    std::cout << "身高:" << p1.height << "m" << std::endl;    std::cout << "姓名:" << p2.name << std::endl;    std::cout << "年龄:" << p2.age << std::endl;    std::cout << "身高:" << p2.height << "m" << std::endl;    return 0;}

在上面的示例中,我们定义了一个名为Person的结构体,包含了姓名、年龄和身高三个字段。我们可以创建多个Person对象,并通过结构体的字段来标识和操作不同的数据。

立即学习“C++免费学习笔记(深入)”;

除了结构体,我们还可以使用枚举来进行数据标签化。下面是一个使用枚举实现数据标签化的示例:

#include enum class Color {    RED,    GREEN,    BLUE};int main() {    Color c = Color::RED;    switch (c) {        case Color::RED:            std::cout << "红色" << std::endl;            break;        case Color::GREEN:            std::cout << "绿色" << std::endl;            break;        case Color::BLUE:            std::cout << "蓝色" << std::endl;            break;        default:            std::cout << "未知颜色" << std::endl;            break;    }    return 0;}

在上面的示例中,我们定义了一个名为Color的枚举,包含了红色、绿色和蓝色三个取值。我们可以使用枚举来表示不同的颜色,并在程序中通过switch语句根据不同的枚举值来进行操作。

另外,封装类也是一种常用的数据标签化方法。封装类可以将数据和相关的操作封装在一起,提供更高层次的抽象和封装。下面是一个使用封装类实现数据标签化的示例:

#include class Shape {public:    virtual double area() const = 0;};class Rectangle : public Shape {public:    Rectangle(double width, double height) : width_(width), height_(height) {}    double area() const override {        return width_ * height_;    }private:    double width_;    double height_;};class Circle : public Shape {public:    Circle(double radius) : radius_(radius) {}    double area() const override {        return 3.14159 * radius_ * radius_;    }private:    double radius_;};int main() {    Rectangle rectangle(5, 10);    Circle circle(4);    std::cout << "矩形面积:" << rectangle.area() << std::endl;    std::cout << "圆形面积:" << circle.area() << std::endl;    return 0;}

在上面的示例中,我们定义了一个名为Shape的抽象基类,其中的area()函数用于计算不同形状的面积。我们派生出Rectangle和Circle两个类,分别表示矩形和圆形,并实现它们的area()函数。通过封装和继承的方式,我们可以将不同形状的数据和相关操作进行标签化,提高代码的可读性和可维护性。

在实际的大数据开发中,数据标签化非常重要。它可以帮助我们更好地理解和管理数据,提高代码的可读性和可维护性。通过合理地选择合适的数据结构和设计模式,我们可以灵活地解决C++大数据开发中的数据标签化问题,并实现高效的数据处理和管理。

以上就是如何解决C++大数据开发中的数据标签化问题?的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1443463.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何利用C++进行高性能的图像追踪和目标检测?
上一篇 2025年12月17日 20:09:59
利用C++实现嵌入式系统的实时通信功能
下一篇 2025年12月17日 20:10:15

相关推荐

  • 在Java中如何统计List中元素出现次数

    答案是使用Map或Stream API统计List元素频次最高效。通过HashMap手动遍历统计,或用Java 8的Stream结合groupingBy和counting()实现简洁计数,Collections.frequency适用于小数据量但性能较差,推荐Stream方式兼顾性能与可读性。 在J…

    2026年9月22日
    900
  • 如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧

    如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧如何在Dask中训练AI大模型?分布式数据处理的AI训练技巧

    Dask在处理超大规模数据集时的独特优势在于其Python原生的分布式计算能力,能无缝扩展Pandas和NumPy的工作流,突破单机内存限制,实现高效的数据预处理与模型训练。它通过惰性计算、分块处理和内存溢写机制,支持TB级数据的并行操作,相比Spark提供了更贴近Python数据科学生态的API和…

    2026年9月22日 用户投稿
    100
  • 如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南

    如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南如何用Filmora制作高质量AI视频?简易AI视频剪辑的实用指南

    Filmora的AI功能通过AI Copilot脚本生成、AI文本转视频、AI语音、图像生成、智能抠像及音频优化等工具,显著提升视频制作效率与专业度,尤其在视觉处理、听觉优化和创意辅助方面表现突出;关键在于将AI作为辅助起点,避免过度依赖,结合人工精修,才能实现高质量AI视频创作。 ☞☞☞AI 智能…

    2026年9月22日 用户投稿
    500
  • 如何在mysql中实现热备份

    最推荐的MySQL热备份方案是结合Percona XtraBackup全量备份与binlog增量备份,并通过主从复制实现高可用。首先使用XtraBackup对InnoDB引擎进行在线全量备份,无需锁表;备份后执行–prepare确保数据一致性,恢复时用–copy-back还原…

    2026年9月22日
    100
  • 如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤

    如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤如何在MXNet中训练AI大模型?高效构建深度学习的详细步骤

    答案是优化数据管道、采用分布式训练、应用内存优化技术、精细调参。具体包括:使用RecordIO格式和DataLoader多进程预取提升数据加载效率;通过KVStore选择device或dist_sync/dist_async实现单机或多机分布式训练;利用混合精度训练、梯度累积和模型符号化降低显存占用…

    2026年9月22日 用户投稿
    100
  • Invideo的AI混合工具怎么用?快速生成专业视频的实用教程

    Invideo的AI混合工具通过智能生成视频初稿并允许创作者精细调整,显著降低制作门槛、提升效率,其优势在于快速生成、易用性强、激发创意,用户可通过优化输入、替换素材、注入个性声音和保持风格统一来最大化潜力,同时需应对素材模式化、理解偏差等挑战。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索,…

    2026年9月22日
    500
  • 如何在MindSpore中训练AI大模型?华为AI框架的训练教程

    如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程如何在MindSpore中训练AI大模型?华为AI框架的训练教程

    答案:MindSpore通过自动并行、混合精度、优化器状态分片等技术,结合Profiler工具调试性能瓶颈,实现大模型高效分布式训练。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 在MindSpore中训练AI大模型,核心在于巧妙地利用其…

    2026年9月21日 用户投稿
    400
  • 如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程如何用PyTorch训练AI大模型?构建高效神经网络的完整教程

    PyTorch大模型训练需综合运用分布式训练、内存优化与高效计算策略。首先采用DistributedDataParallel实现多GPU并行,配合DistributedSampler确保数据均衡;通过混合精度训练、梯度累积和激活检查点缓解显存压力;使用torch.compile优化模型计算效率;选择…

    2026年9月21日 用户投稿
    100
  • 中国联通:前三季度营收2929亿 净利润同比增长5.2%

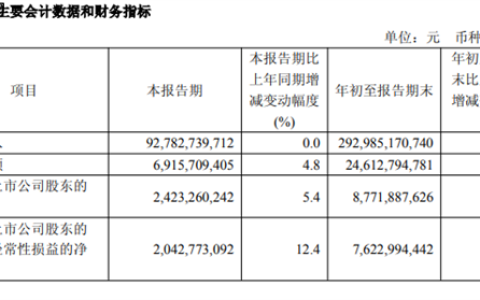
    10月22日,中国联通发布2025年第三季度业绩报告,披露前三季度公司实现营业收入2929.85亿元,同比增长1.0%;归属于母公司股东的净利润达到87.72亿元,较去年同期增长5.2%。 单季度数据显示,第三季度公司营收为927.83亿元,与上年同期持平;净利润为24.23亿元,同比增长5.4%。…

    2026年9月21日
    000
  • Java Stream 高效分组计数并获取Top N元素

    本文深入探讨了如何利用java stream api对数据进行高效的分组计数,并从中提取出现频率最高的top n元素。文章首先介绍了一种简洁的基于全排序的实现方式,该方法适用于数据集较小或top n值接近总数的情况。随后,针对大数据量和小型top n场景下的性能瓶颈,文章详细阐述了如何通过自定义`c…

    2026年9月21日
    100
  • 打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?打工人的全能 AI 搭档,就是戴尔灵越 16 Plus?

    进入2024年,无论是硬件厂商还是软件供应商,都开始加大力度,向公众宣扬ai对工作生活乃至游戏的影响。在这样的背景下,选择购买一台全新的笔记本,很难不考量它的ai能力对自身使用的影响。因此,我们可以看到办公轻薄本的 ” 常青树 ” ——戴尔灵越系列,也凭借搭载的英特尔酷睿 u…

    2026年9月21日 用户投稿
    400
  • Java并发编程中CopyOnWriteArrayList使用场景

    CopyOnWriteArrayList适用于读多写少场景,通过写时复制实现线程安全,读操作无锁并发,迭代基于快照不抛异常,适合配置列表、监听器等数据变动少且需高性能读取的并发环境。 在Java并发编程中,CopyOnWriteArrayList 是一种线程安全的List实现,适用于读多写少的并发场…

    2026年9月21日
    100
  • 抖音商城是哪个公司在运营

    抖音商城的运营主体揭晓 抖音商城由北京微播视界科技有限公司负责运营。 作为抖音背后的母公司,字节跳动通过其全资子公司——微播视界,全面掌舵抖音平台及其电商板块的日常运作。依托雄厚的技术积累与多元化的业务布局,为用户打造流畅、智能且高效的购物环境。 抖音商城究竟是什么? 抖音商城是抖音App内嵌的一站…

    2026年9月21日
    200
  • mysql如何优化日期查询

    正确使用索引和避免函数干扰是MySQL日期查询优化的核心。1. 为日期字段添加索引,确保范围查询高效执行;2. 避免在WHERE条件中对日期字段使用DATE()、YEAR()等函数,改用范围比较;3. 用order_date >= ‘2024-01-01’ AND or…

    2026年9月20日
    100
  • mysql如何设计审计表

    设计MySQL审计表需明确审计范围,优先针对核心业务表实施行级、操作行为及DDL变更审计。采用通用结构audit_log表,以JSON字段存储新旧值,记录操作类型、时间、操作者等关键信息,并建立索引提升查询效率。通过触发器自动捕获数据变更,结合应用层传递真实用户身份与客户端信息,实现完整审计链路。1…

    2026年9月20日
    100
  • 跨境电商时差大?夜班客服成本高?智能客服多语言24小时值守,人力节省70%!告别熬夜值班!智能客服全天候守护全球生意,让跨境服务更轻松

    跨境电商的时差挑战终于迎来高效解决方案!当海外客户在深夜发起咨询,您无需再依赖高成本的夜间人工团队。晓多智能客服凭借先进的多语言ai应答系统,实现全天候无缝对接全球消费者。无论是英语市场的促销询问,还是法语用户的退换货请求,我们的智能客服都能精准理解并实时回复。某知名美妆品牌接入后,彻底摆脱了夜班排…

    2026年9月20日
    200
  • mysql如何实现用户行为分析

    答案:通过设计用户行为日志表并利用SQL实现活跃度、转化率、页面跳转和留存分析,结合索引优化与外部工具,MySQL可有效支持中小规模用户行为分析。 在MySQL中实现用户行为分析,核心是利用现有数据表结构(如用户操作日志、访问记录等)进行查询和统计,提取出有价值的用户行为模式。虽然MySQL不是专门…

    2026年9月13日
    100
  • mysql如何编写插入数据的insert语句

    编写INSERT语句的核心是安全准确地向表中插入数据,基本语法为INSERT INTO 表名 (列) VALUES (值);可省略列名或使用SET子句,也可通过INSERT … SELECT批量导入;为提升效率,应采用多行VALUES批量插入或LOAD DATA INFILE加载文件;面…

    2026年9月12日
    200
  • 如何在mysql中高效使用SELECT语句

    避免SELECT *,只查询必要列以减少I/O和网络开销;2. 在WHERE条件中使用索引字段并避免函数操作以防止索引失效;3. 用主键或唯一键进行分页优化,避免大偏移量导致性能下降。 在MySQL中高效使用SELECT语句,关键在于优化查询逻辑、合理利用索引以及减少不必要的数据处理。以下是一些实用…

    2026年9月12日
    000
  • 如何在mysql中优化批量写入效率

    使用批量INSERT、显式事务、调整InnoDB参数、优先LOAD DATA INFILE及优化索引策略可显著提升MySQL写入效率,核心是减少I/O与事务开销。 在 MySQL 中进行批量写入时,如果处理不当,很容易导致性能低下。优化批量写入效率可以从多个方面入手,核心目标是减少磁盘 I/O、降低…

    2026年9月12日
    000

发表回复

登录后才能评论
关注微信