Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
在数据库管理系统中,B+树_创想鸟

在数据库管理系统中,B+树

在数据库管理系统中,b+树

A B+ tree in DBMS is a specialized version of a balanced tree, a type of tree data structure used in databases to store and retrieve data efficiently. Balanced trees are designed to maintain a roughly equal number of keys at each level, which helps to keep search times as low as possible. B+ trees are a popular choice for use in database management systems(DBMS) because they offer a number of benefits over other types of balanced trees, including faster search times and better space utilization.

What are B+ Trees?

A B+ tree is a self-balancing, ordered tree data structure that stores data in a sorted fashion. Each node in a B+ tree can have a variable number of keys and child pointers, with the exception of the leaf nodes, which only have keys and no child pointers. The keys in a B+ tree are arranged in a specific order, with all keys in a given node being less than any of the keys in its right child and greater than any of the keys in its left child.

B+树的特点是每个节点具有大量的键,这有助于保持树的高度较小和搜索时间较快。此外,B+树使用“基于指针”的结构,意味着每个节点包含一组指针,这些指针指向其子节点,而不是将子节点存储在父节点中。这有助于减小每个节点的大小,并实现更好的空间利用。

如何在C++中实现B+树?

在C++中实现B+树需要定义一个节点类,该类包含树中每个节点的键和指针。节点类还应包括一个用于将新键插入树中的函数和一个用于在树中搜索特定键的函数。

示例

下面是一个B+树节点类在C++中的实现示例 –

class BPlusTreeNode {public:   int *keys; // Array of keys   int t; // Minimum degree (defines the range for number of keys)   BPlusTreeNode **C; // An array of child pointers   int n; // Current number of keys   bool leaf; // Is true when node is leaf. Otherwise false   BPlusTreeNode(int _t, bool _leaf); // Constructor   // A function to traverse all nodes in a subtree rooted with this node   void traverse();   // A function to search a key in subtree rooted with this node.   BPlusTreeNode *search(int k); // returns NULL if k is not present.   // A function to traverse all nodes in a subtree rooted with this node   void traverse();    // A function to search a key in subtree rooted with this node.   BPlusTreeNode *search(int k);   // returns NULL if k is not present.    // A function that returns the index of the first key that is greater   // or equal to k   int findKey(int k);    // A utility function to insert a new key in the subtree rooted with   // this node. The assumption is, the node must be non-full when this   // function is called   void insertNonFull(int k);    // A utility function to split the child y of this node. i is index of y in   // child array C[].  The Child y must be full when this function is called   void splitChild(int i, BPlusTreeNode *y);    // Make BPlusTree friend of this so that we can access private members of   // this class in BPlusTree functions   friend class BPlusTree;};

接下来,可以定义B+树类,该类将包含用于在树中插入和搜索键的函数。B+树类还应包括指向树的根节点的指针,并且如果根节点不存在,则应包括创建新根节点的函数。

Example

Here is an example of how the B+ Tree class might be implemented in C++ −

class BPlusTree {   BPlusTreeNode *root; // Pointer to root node   int t; // Minimum degree   public:   // Constructor (Initializes tree as empty)   BPlusTree(int _t) {      root = NULL;      t = _t;   }   // function to traverse the tree   void traverse() {      if (root != NULL) root->traverse();   }   // function to search a key in this tree   BPlusTreeNode* search(int k) {      return (root == NULL) ? NULL : root->search(k);   }   // The main function that inserts a new key in this B+ tree   void insert(int k);};

对于B+树类的插入函数将处理新节点的创建以及在必要时分裂节点以保持树的平衡。以下是一个示例:

how the insert function might be implemented −

void BPlusTree::insert(int k) {   // If tree is empty   if (root == NULL) {      // Allocate memory for root      root = new BPlusTreeNode(t, true);      root->keys[0] = k; // Insert key      root->n = 1; // Update number of keys in root   } else // If tree is not empty   {      // If root is full, then tree grows in height      if (root->n == 2*t-1) {                  // Allocate memory for new root         BPlusTreeNode *s = new BPlusTreeNode(t, false);                 // Make old root as child of new root          s->C[0] = root;                // Split the old root and move 1 key to the new root         s->splitChild(0, root);                  // New root has two children now. Decide which of the         // two children is going to have new key         int i = 0;         if (s->keys[0] C[i]->insertNonFull(k);                 // Change root         root = s;      } else // If root is not full, call insertNonFull for root      root->insertNonFull(k);   }}

B+树相对于B树的优势

B+树相对于B树的主要优势之一是其更好的空间利用率。因为B+树使用基于指针的结构,每个节点能够存储更多的键并且使用比B树节点更少的空间。这在空间有限的大型数据库中尤其有益。

此外,B+树具有比B树更快的搜索时间,因为它们具有较小的高度,这要归功于每个节点的更多键值。这意味着需要遍历的节点较少,以找到特定的键值,这可以显著减少大型数据库中的搜索时间。

Conclusion

总之,B+树是一种专门用于在数据库中高效存储和检索数据的平衡树数据结构。与其他类型的平衡树相比,它们提供更快的搜索时间和更好的空间利用率,因此在数据库管理系统中被广泛采用。

在C++中实现B+树涉及定义一个节点类和一个B+树类,两者都包含用于在树中插入和搜索键的函数。B+树相对于B树具有许多优势,包括更好的空间利用和更快的搜索时间,使它们成为管理大型数据库的有价值工具。

以上就是在数据库管理系统中,B+树的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1443553.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
如何优化C++大数据开发中的磁盘读写速度?
上一篇 2025年12月17日 20:17:32
使用C++编写,找到N叉树中给定节点的兄弟节点数量
下一篇 2025年12月17日 20:17:43

相关推荐

  • mysql如何使用事务保证操作原子性

    答案:MySQL中事务通过START TRANSACTION开启,需使用InnoDB引擎并关闭自动提交,执行SQL后根据结果COMMIT或ROLLBACK,结合异常处理确保原子性。 在MySQL中,事务是保证数据库操作原子性的核心机制。通过事务,可以确保一组SQL操作要么全部成功执行,要么全部不执行…

    2026年9月21日
    600
  • mac怎么重建Spotlight索引_Mac重建Spotlight索引方法

    重建Spotlight索引可解决搜索结果不准确问题。方法一:通过系统设置将启动磁盘添加后移除隐私列表,触发重新索引;方法二:使用终端命令“sudo mdutil -E /”强制重建索引;方法三:重启进入安全模式,系统自动修复并清理索引,适用于前两种方法无效时。 如果您发现Mac上的Spotlight…

    2026年9月20日
    000
  • 索引如何提升mysql查询效率

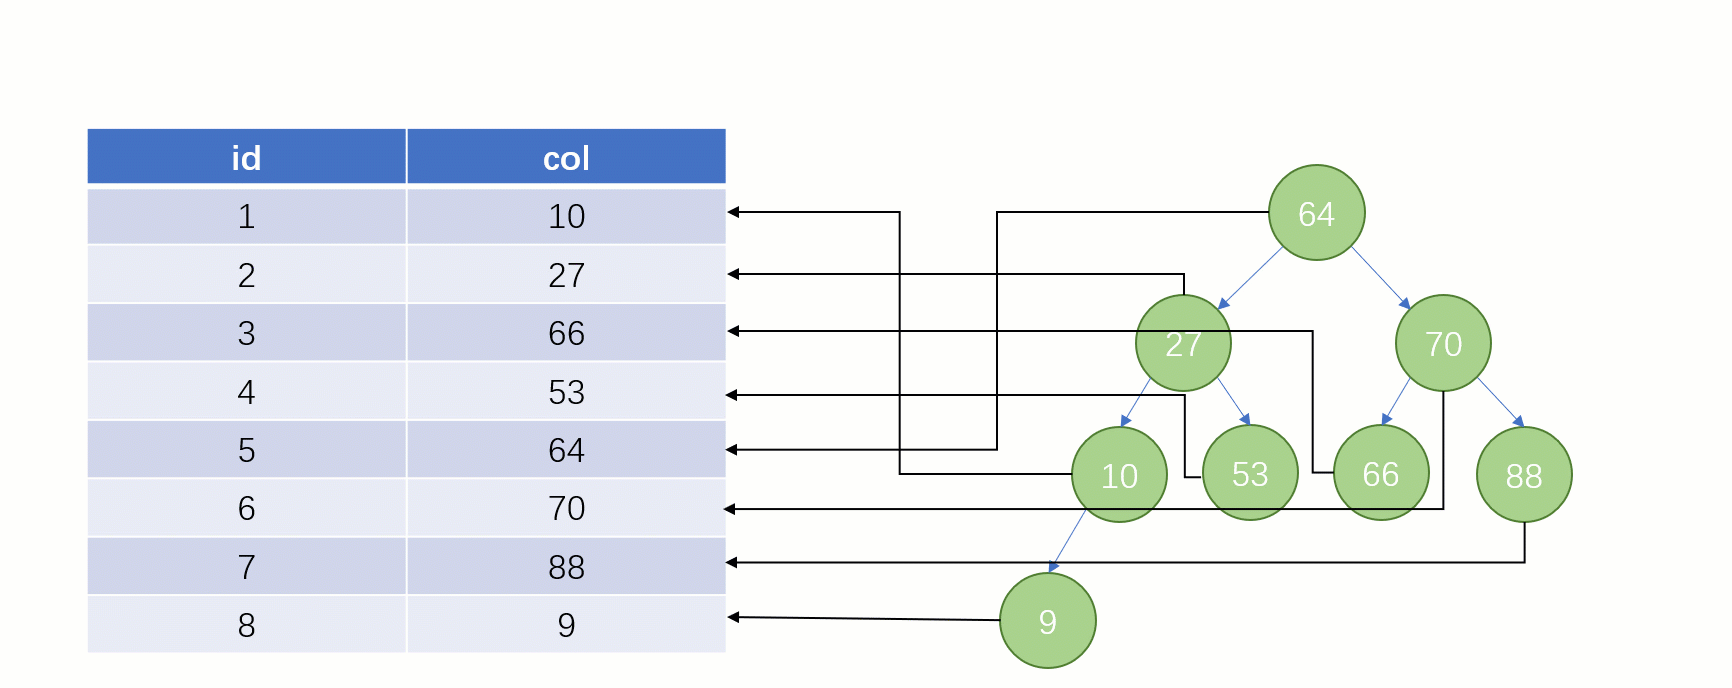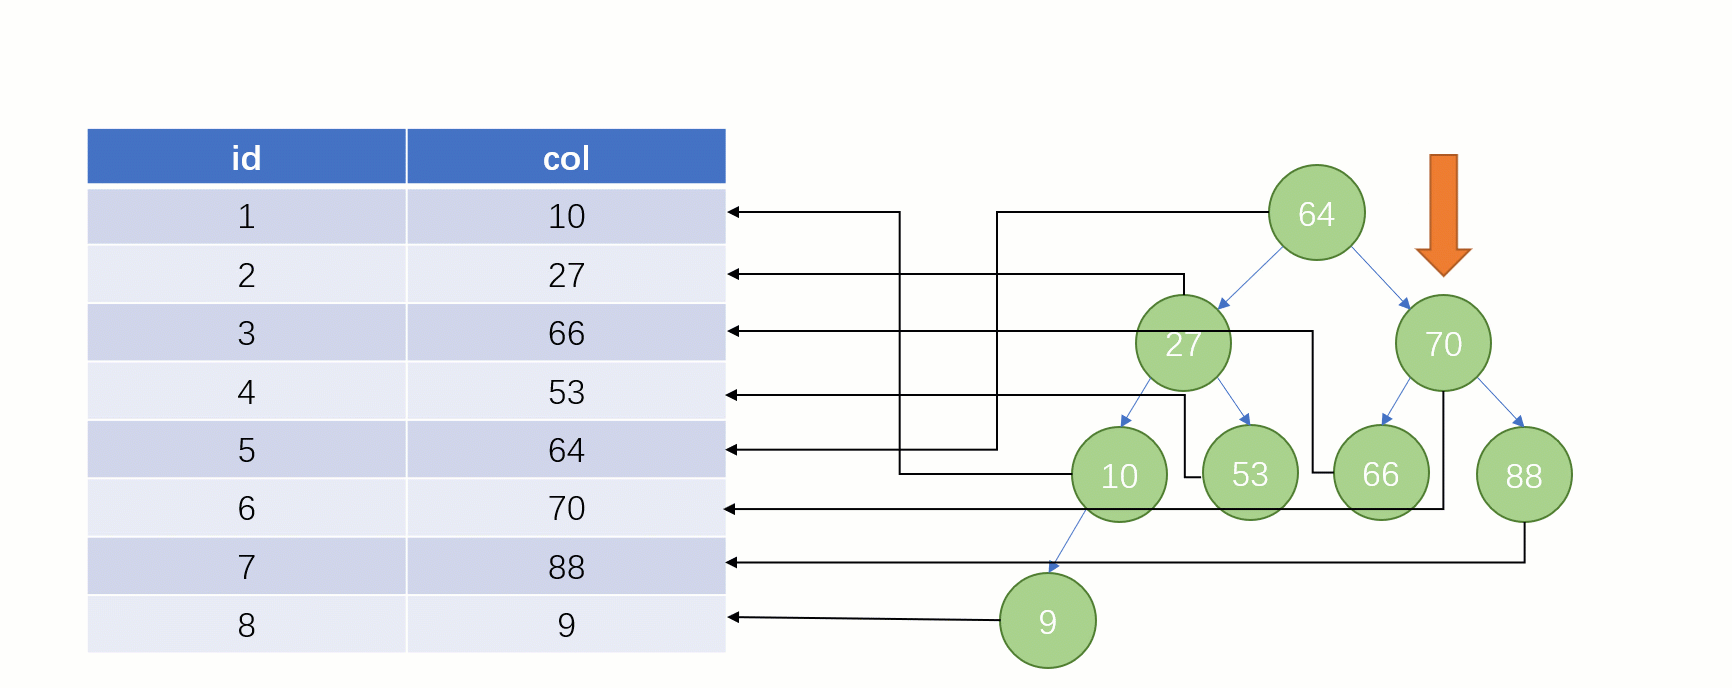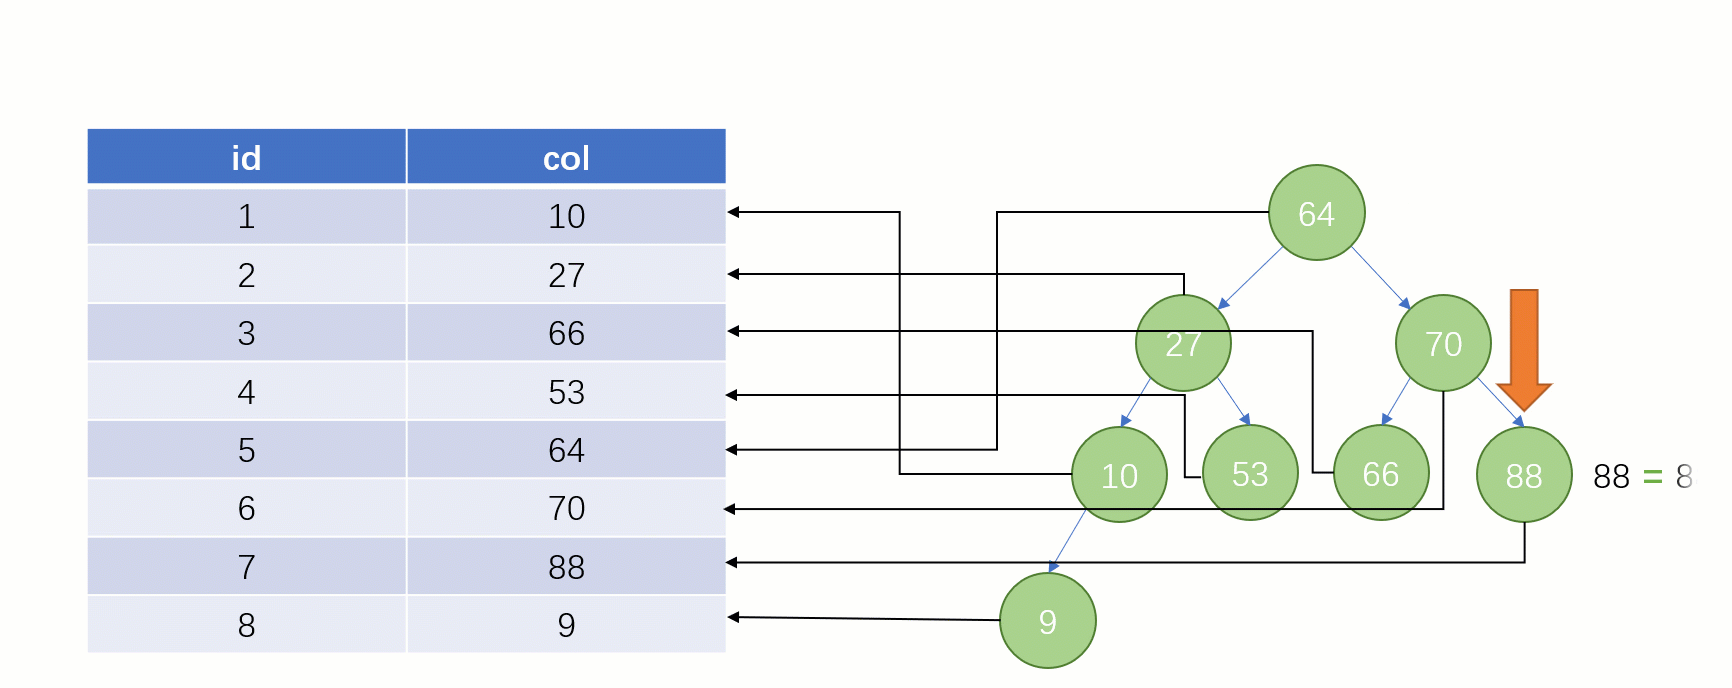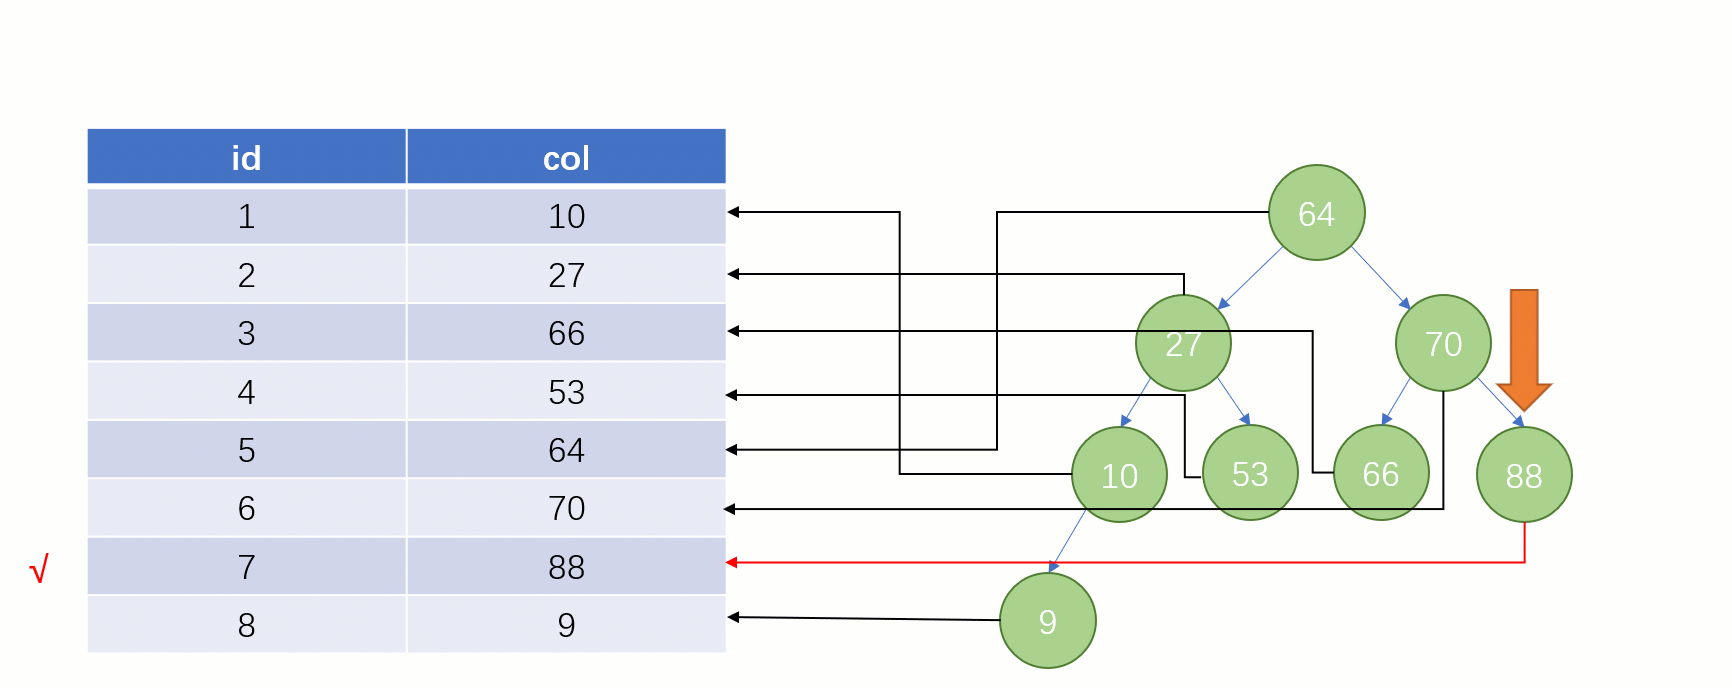
    索引通过B+树结构改变数据查找方式,使MySQL无需全表扫描即可快速定位数据。有序存储、多层结构和高扇出性让查询效率大幅提升。例如在age字段建索引后,SELECT * FROM users WHERE age = 25可直接在B+树中查找,避免逐行比对。应为高频查询字段创建索引,优先使用复合索引并…

    2026年9月13日
    300
  • 如何在mysql中分析慢查询优化索引

    答案:通过开启慢查询日志、使用EXPLAIN分析执行计划、合理创建复合索引并借助工具优化,可有效提升MySQL查询性能。 在 MySQL 中分析慢查询并优化索引,核心是找出执行效率低的 SQL 语句,定位瓶颈,然后通过合理创建或调整索引提升性能。整个过程需要结合慢查询日志、执行计划分析和实际业务场景…

    2026年9月12日
    100
  • MySQL索引提高查询效率的原因何在

    MySQL索引提高查询效率的原因何在MySQL索引提高查询效率的原因何在MySQL索引提高查询效率的原因何在MySQL索引提高查询效率的原因何在

    mysql教程栏目介绍索引提高查询效率的原因。 背景 我相信大家在数据库优化的时候都会说到索引,我也不例外,大家也基本上能对数据结构的优化回答个一二三,以及页缓存之类的都能扯上几句,但是有一次阿里P9的一个面试问我:你能从计算机层面开始说一下一个索引数据加载的流程么?(就是想让我聊IO) 我当场就去…

    2026年9月7日 用户投稿
    000
  • 终于理解 MySQL 索引要用 B+tree ,而且还这么快

    终于理解 MySQL 索引要用 B+tree ,而且还这么快终于理解 MySQL 索引要用 B+tree ,而且还这么快终于理解 MySQL 索引要用 B+tree ,而且还这么快终于理解 MySQL 索引要用 B+tree ,而且还这么快

    mysql教程栏目介绍理解索引的B+tree。 免费推荐:mysql教程(视频) 前言 当你现在遇到了一条慢 SQL 需要进行优化时,你第一时间能想到的优化手段是什么? 大部分人第一反应可能都是添加索引,在大多数情况下面,索引能够将一条 SQL 语句的查询效率提高几个数量级。 索引的本质:用于快速查…

    2026年9月7日 用户投稿
    200
  • 熟悉MySQL索引

    一、索引简介(1)索引的含义和特定 (2)索引的分类 (3)索引的设计原则 二、创建索引(1)创建表的时候创建索引 (2)在已经存在的表上创建索引 (3)删除索引 (免费学习推荐:mysql视频教程) 一、索引简介 索引用于快速找出在某列中有一特定值的行。不使用索引,MySQL必须从第1条记录开始读…

    2026年9月5日
    100
  • 深入了解MySQL中的索引(用处、分类、匹配方式)

    深入了解MySQL中的索引(用处、分类、匹配方式)深入了解MySQL中的索引(用处、分类、匹配方式)深入了解MySQL中的索引(用处、分类、匹配方式)深入了解MySQL中的索引(用处、分类、匹配方式)

    本篇文章带大家深入了解mysql中的索引,介绍一下索引的优点、用处、分类、技术名词以及匹配方式,希望对大家有所帮助! 对于高级开发,我们经常要编写一些复杂的sql,那么防止写出低效sql,我们有必要了解一些索引的基础知识。通过这些基础知识我们可以写出更高效的sql。【相关推荐:mysql视频教程】 …

    2026年9月4日 用户投稿
    100
  • 深入聊聊mysql索引为什么采用B+树结构

    深入聊聊mysql索引为什么采用B+树结构深入聊聊mysql索引为什么采用B+树结构深入聊聊mysql索引为什么采用B+树结构深入聊聊mysql索引为什么采用B+树结构

    本篇文章是mysql的进阶学习,介绍一下mysql使用b+树作为索引数据结构的原因,希望对大家有所帮助! 索引提高查询效率,就像我们看的书,想要直接翻到某一章,是不是不用一页一页的翻,只需要看下目录,根据目录找到其所在的页数即可。【相关推荐:mysql视频教程】 在计算机中我们需要一种数据结构来存储…

    2026年9月4日 用户投稿
    100
  • 浅析MySQL存储引擎中的索引

    浅析MySQL存储引擎中的索引浅析MySQL存储引擎中的索引浅析MySQL存储引擎中的索引浅析MySQL存储引擎中的索引

    本篇文章和大家聊聊mysql存储引擎中索引如何落地,希望对大家有所帮助! 我们知道不同的存储引擎文件是不一样,我们可以查看数据文件目录: show VARIABLES LIKE ‘datadir’; 每 张 InnoDB 的 表 有 两 个 文 件 ( .frm 和 .ibd ),MyISAM 的 …

    2026年9月4日 用户投稿
    200
  • mysql中主键是索引吗

    mysql中主键不是索引。主键全称“主键约束”,是对表中数据的一种约束,它是表的一个特殊字段,该字段能唯一标识该表中的每条信息;而索引是一种特殊的数据库结构,由数据表中的一列或多列组合而成,可以用来快速查询数据表中有某一特定值的记录。 本教程操作环境:windows7系统、mysql8版本、Dell…

    2026年9月3日
    100
  • mysql主键和索引的区别是什么

    区别:1、主键用于唯一标识表中某一行的属性或属性组,而索引用于快速寻找具有特定值的记录;2、一个表只能有一个主键,但可以有多个候选索引;3、主键列不允许空值,而索引列允许空值;4、主键是逻辑键,索引是物理键。 本教程操作环境:windows7系统、mysql8版本、Dell G3电脑。 关系数据库依…

    2026年9月3日
    100
  • 一文详解MySQL中的事务和 MVCC 原理

    一文详解MySQL中的事务和 MVCC 原理一文详解MySQL中的事务和 MVCC 原理一文详解MySQL中的事务和 MVCC 原理一文详解MySQL中的事务和 MVCC 原理

    本篇文章带大家了解一下mysql中的事务,并介绍一下mvcc 原理,希望能够给大家提供帮助! 01 什么是事务? 数据库事务指的是一组数据操作,事务内的操作要么就是全部成功,要么就是全部失败,什么都不做,其实不是没做,是可能做了一部分但是只要有一步失败,就要回滚所有操作,有点一不做二不休的意思。 在…

    2026年9月1日 用户投稿
    100
  • mysql事务是什么

    mysql事务是指对数据库执行一批操作,在同一个事务当中,这些操作最终要么全部执行成功,要么全部失败,不会存在部分成功的情况;事务是一个原子操作,是一个最小执行单元,可以由一个或多个SQL语句组成。 本教程操作环境:Windows10系统、MySQL5.7版本、Dell G3电脑。 事务详解 什么是…

    2026年8月28日
    100
  • 如何在HTML中创建以罗马数字索引的列表

    概述 索引是指示句子位置或位置的数字。在HTML中,我们可以通过两种方式进行索引:无序列表(ul)和有序列表(li)。在HTML中使用 标签来创建一个带有罗马数字的列表,罗马数字是按顺序编写的数字,因此我们使用有序列表而不是无序列表。要创建带有罗马数字的有序列表,我们需要定义有序列表的类型,即列表中…

    2025年12月21日
    100
  • JavaScript并发控制_javascript多任务处理

    JavaScript通过事件循环实现异步任务的并发控制,使用concurrentControl函数限制最大并发数,避免资源耗尽;该函数利用Promise和索引追踪任务执行,确保最多同时运行指定数量的任务,完成后汇总结果,适用于批量请求、文件上传等场景,提升应用稳定性。 JavaScript 是单线程…

    2025年12月21日
    000
  • 如何用JavaScript实现一个支持并发控制的请求队列?

    使用Promise和async/await实现并发控制,通过维护运行中任务数与等待队列,确保不超过最大并发数,失败请求通过catch捕获并可扩展重试机制,支持动态调整并发上限。 JavaScript 实现并发控制的请求队列,核心在于限制同时进行的请求数量,防止资源过度消耗。通常使用 Promise …

    2025年12月20日
    000
  • 如何用JavaScript实现一个支持事务的数据操作层?

    答案:通过IndexedDB和数据库事务封装实现数据操作的原子性。前端利用IndexedDB的异步事务机制,确保多个操作要么全部成功,要么全部回滚;后端借助连接池和withTransaction方法,结合Repository模式,在同一事务上下文中协调多步操作,保证数据一致性与系统可靠性。 如何用J…

    2025年12月20日
    000
  • 如何在C++中实现分布式锁_并发控制解决方案

    如何在C++中实现分布式锁_并发控制解决方案如何在C++中实现分布式锁_并发控制解决方案如何在C++中实现分布式锁_并发控制解决方案如何在C++中实现分布式锁_并发控制解决方案

    分布式锁的实现主要依赖外部系统,答案如下:1.基于redis的分布式锁:通过setnx命令结合唯一标识和过期时间保证原子性加锁;解锁时使用lua脚本验证身份并删除锁键。2.基于zookeeper的分布式锁:创建临时顺序节点,序号最小者获得锁,监听前序节点变化以实现释放锁的通知机制。3.基于etc++…

    2025年12月18日 用户投稿
    000
  • C++类设计中如何处理并发控制?

    c++++ 中的并发控制使用互斥量(一次访问临界区)、条件变量(等待条件满足)、读写锁(允许多个读者同时读,但写入只能一个)等机制,以解决共享资源并发访问导致的数据竞争和不一致状态。 C++ 类设计中的并发控制 引言 在多线程环境中,共享资源的并发访问可能会导致数据竞争和不一致的状态。为了解决这个问…

    2025年12月18日
    000

发表回复

登录后才能评论
关注微信