Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
C++电子词典程序 单词查询记忆功能_创想鸟

C++电子词典程序 单词查询记忆功能

答案:C++电子词典采用std::unordered_map存储词汇以实现O(1)查询,结合Word结构体记录词义、查询次数和时间戳,通过文件I/O持久化数据,并设计基于时间间隔的简单复习算法筛选待复习单词,支持查询、添加和复习功能,兼顾效率与学习辅助。

c++电子词典程序 单词查询记忆功能

C++电子词典程序要实现单词查询和记忆功能,其核心在于选择高效的数据结构来存储海量词汇,并配合可靠的文件I/O机制进行数据持久化,同时设计一个智能的记忆算法来辅助用户学习。

解决方案

要构建一个C++电子词典程序,实现单词查询和记忆,我的思路是这样的:首先,数据存储是基础。对于大量的词汇,我们肯定不能用简单的数组或链表。哈希表(

std::unordered_map

)是一个不错的选择,它的查询效率接近O(1)。每个单词作为键,对应的值可以是一个结构体,包含词义、例句、发音(如果能集成)、以及最重要的——一个“记忆权重”或“上次查询时间”字段。

持久化方面,我们需要将这些数据写入文件。文本文件(CSV或自定义格式)简单易行,但如果数据量大,二进制文件或SQLite数据库会更高效。我个人倾向于在小型项目中使用自定义的文本格式,方便调试和手动编辑,但实际应用中可能会考虑SQLite。

用户界面,即使是命令行界面,也要设计得清晰。主循环负责接收用户输入,解析命令(如

query 

,

add  

,

review

)。查询功能直接调用哈希表的查找方法。

立即学习“C++免费学习笔记(深入)”;

记忆功能是这个项目的亮点。我的想法是,每次用户查询一个单词,就更新它的“上次查询时间”和“查询次数”。更进一步,可以引入一个简单的间隔重复系统(Spaced Repetition System, SRS)算法,比如Leitner系统或Anki的简化版。当用户选择“复习”时,程序根据这些时间戳和查询频率,智能地选择那些“快要忘记”或“不熟悉”的单词进行展示。这意味着我们需要一个数据结构来维护待复习单词的队列,或者在每次复习时动态计算。

在代码实现上,我们会有一个

Dictionary

类,封装词汇的加载、保存、查询、添加等操作。

Word

结构体存储单词的详细信息。

UserInterface

类处理与用户的交互。

// 示例:Word结构体#include #include  // 用于获取时间戳#include #include #include #include struct Word {    std::string text;    std::string meaning;    std::string example; // 示例句子    int queryCount;      // 查询次数    long long lastQueryTime; // 上次查询的时间戳 (Unix timestamp)    // 默认构造函数    Word() : queryCount(0), lastQueryTime(0) {}    // 带参数的构造函数    Word(const std::string& t, const std::string& m, const std::string& e = "")        : text(t), meaning(m), example(e), queryCount(0), lastQueryTime(0) {}};// 示例:Dictionary类核心class Dictionary {private:    std::unordered_map words;    std::string dataFilePath;    // 获取当前时间戳    long long getCurrentTimestamp() const {        return std::chrono::duration_cast(            std::chrono::system_clock::now().time_since_epoch()).count();    }public:    Dictionary(const std::string& path) : dataFilePath(path) {        loadWords(); // 构造时加载    }    ~Dictionary() {        saveWords(); // 析构时保存    }    void loadWords() {        std::ifstream ifs(dataFilePath);        if (!ifs.is_open()) {            std::cerr << "Warning: Dictionary data file not found or cannot be opened. Starting with empty dictionary." << std::endl;            return;        }        std::string line;        while (std::getline(ifs, line)) {            // 简单解析:text,meaning,example,queryCount,lastQueryTime            size_t pos1 = line.find(',');            size_t pos2 = line.find(',', pos1 + 1);            size_t pos3 = line.find(',', pos2 + 1);            size_t pos4 = line.find(',', pos3 + 1);            if (pos1 == std::string::npos || pos2 == std::string::npos ||                pos3 == std::string::npos || pos4 == std::string::npos) {                std::cerr << "Warning: Malformed line in dictionary file: " << line << std::endl;                continue;            }            Word word;            word.text = line.substr(0, pos1);            word.meaning = line.substr(pos1 + 1, pos2 - pos1 - 1);            word.example = line.substr(pos2 + 1, pos3 - pos2 - 1);            word.queryCount = std::stoi(line.substr(pos3 + 1, pos4 - pos3 - 1));            word.lastQueryTime = std::stoll(line.substr(pos4 + 1));            words[word.text] = word;        }        ifs.close();    }    void saveWords() {        std::ofstream ofs(dataFilePath);        if (!ofs.is_open()) {            std::cerr << "Error: Cannot open dictionary data file for saving." << std::endl;            return;        }        for (const auto& pair : words) {            const Word& word = pair.second;            ofs << word.text << ","                << word.meaning << ","                << word.example << ","                << word.queryCount << ","                << word.lastQueryTime <second.queryCount++;            it->second.lastQueryTime = getCurrentTimestamp();            return &(it->second);        }        return nullptr;    }    bool addWord(const Word& newWord) {        if (words.count(newWord.text) == 0) { // 避免重复添加            words[newWord.text] = newWord;            return true;        }        return false;    }    // 记忆功能相关方法,例如 getWordsForReview()    std::vector getWordsForReview(int maxWords = 10) {        std::vector candidates;        long long currentTime = getCurrentTimestamp();        long long oneDayInSeconds = 24 * 3600; // 24小时        // 简单的复习逻辑:比如上次查询时间超过24小时,且查询次数不多        for (auto& pair : words) {            // 这是一个非常简化的判断,实际SRS会复杂得多            // 如果上次查询时间超过1天,并且查询次数小于5次(假设生词)            if (currentTime - pair.second.lastQueryTime > oneDayInSeconds && pair.second.queryCount = maxWords) { // 限制复习单词数量                break;            }        }        // 实际应用中,可能会对candidates进行更复杂的排序或随机化        return candidates;    }};

当然,这只是一个框架。实际的错误处理、输入验证、更复杂的SRS算法、以及如何优雅地处理多线程(如果需要)都是需要考虑的。我个人在处理文件I/O时,总会特别小心异常情况,比如文件不存在、读写权限问题等。

如何选择高效的数据结构来存储海量词汇?

在C++电子词典的场景下,面对海量词汇的存储和快速查询,数据结构的选择至关重要。我通常会在这几个选项中权衡:

std::unordered_map

(哈希表)、

std::map

(红黑树)、以及Trie树(前缀树)。

std::unordered_map

是我的首选,原因很简单:它的平均时间复杂度在查询、插入和删除操作上都是O(1)。这对于字典的核心功能——快速查找单词——来说是无与伦比的。它内部使用哈希函数将键映射到桶,只要哈希冲突处理得当,性能表现极佳。当然,最坏情况下可能退化到O(N),但实际应用中很少遇到。它的缺点在于内存占用可能略高,并且遍历时元素的顺序是不确定的。

std::map

,基于红黑树实现,保证了元素的有序性,查询、插入和删除的平均时间复杂度是O(logN)。如果我们需要按字母顺序遍历所有单词,或者进行范围查询,

std::map

会更有优势。但对于单纯的单词查找,它的性能不如

unordered_map

。我个人在字典应用中,如果不需要频繁的有序遍历,通常不会优先考虑它。

Trie树,或者说前缀树,是另一种非常适合字典和自动补全功能的数据结构。它的特点是能高效地进行前缀匹配。每个节点代表一个字符,从根到某个节点的路径构成一个单词。查询一个单词的时间复杂度是O(L),其中L是单词的长度,这在单词长度不大的情况下非常快。同时,Trie树还能很自然地实现“你是不是想找……”这样的模糊查询和自动补全。然而,Trie树的实现相对复杂,而且如果词汇量非常大且单词平均长度较长,它的内存消耗可能会比较显著,因为每个节点都需要存储指向其子节点的指针。

综合来看,对于一个纯粹的“单词查询”功能,

std::unordered_map

是最简单高效的选择。如果需要集成自动补全或模糊查询,那么Trie树会是更专业的

以上就是C++电子词典程序 单词查询记忆功能的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1474037.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
在C++中如何正确地初始化和遍历一个二维数组
上一篇 2025年12月18日 21:06:46
C++接口隔离原则 细化接口设计方法
下一篇 2025年12月18日 21:06:59

相关推荐

  • 生成Java中全范围正Double随机数的正确方法

    本文旨在指导开发者如何在Java中生成覆盖整个正Double范围的随机数,并解释了使用ThreadLocalRandom.nextDouble(Double.MIN_VALUE, Double.MAX_VALUE)可能产生偏差的原因。我们将提供一种基于位操作的替代方案,确保生成的随机数在Double…

    2026年9月24日
    100
  • VSCode如何配置.NET开发环境 VSCode搭建.NET项目的完整流程

    首先安装.net sdk并验证版本;2. 安装vscode及microsoft官方c#扩展,确保智能感知和调试功能正常;3. 通过dotnet new命令创建项目,并使用code .在vscode中打开项目;4. 添加构建和调试资产以生成tasks.json和launch.json文件;5. 安装n…

    2026年9月24日
    000
  • PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

    PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验PixVerse V5入围Artificial Analysis第一梯队,上线首日全球超百万用户更新并体验

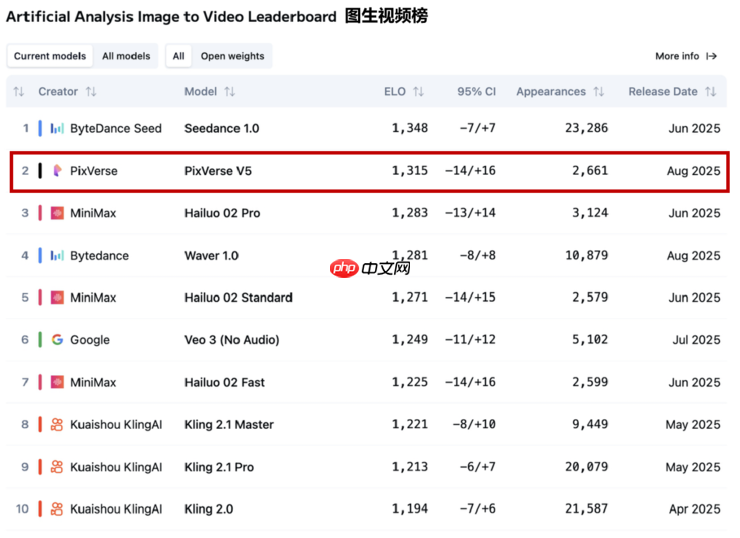
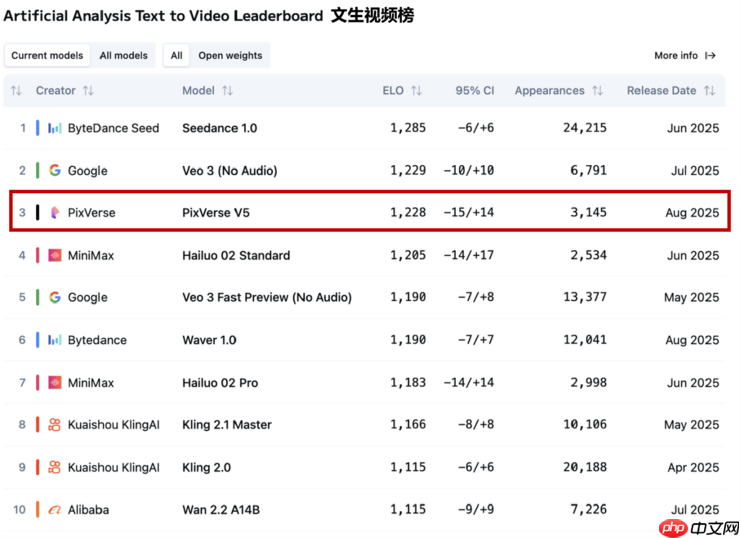
    8月27日晚,根据权威独立测评平台 artificial analysis 最新测试结果,爱诗科技发布的pixverse v5 新一代自研视频生成大模型,在图生视频(image to video)项目中排名全球 top2,在文生视频(text to video)项目中位列 top3,保持在全球第一梯…

    2026年9月24日 • 用户投稿
    100
  • hive安装配置实验

    一、安装前的准备工作 1. 配置并安装hadoop,请参考链接http://blog.csdn.net/wzy0623/article/details/50681554。 2. 下载以下安装包:mysql-5.7.10-linux-glibc2.5-x86_64.tar.gz、apache-hive…

    2026年9月24日
    600
  • 大学论文怎么写?让AI工具助你一臂之力

    大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力大学论文怎么写?让AI工具助你一臂之力

    如果要选出大学学习过程中最令人头疼的事,写论文无疑能稳居榜首。从选题开题、内容撰写,到翻译润色、查重降重,每个步骤都耗时耗力,让人焦头烂额。然而,随着 ai 技术的发展,如今写论文这件事,已经可以借助智能工具变得更高效、更轻松。 开题太难?AI 来帮你破局! 论文的第一道难关就是开题。面对浩如烟海的…

    2026年9月24日 • 用户投稿
    100
  • 使用 PHP 解析 JSON 文件并在网页上显示特定数据

    本文旨在帮助开发者学习如何使用 PHP 解析 JSON 文件,并提取其中的特定数据,将其以结构化的方式展示在网页上。我们将通过一个简单的示例,演示如何读取 JSON 数据,解析成 PHP 数组,并最终以 HTML 表格的形式呈现。 PHP 解析 JSON 数据 JSON (JavaScript Ob…

    2026年9月24日
    100
  • OriginOS 6 深度体验:当操作系统回归「体验为王」

    OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」OriginOS 6 深度体验:当操作系统回归「体验为王」

    2020 年,智能手机刚刚进入 5g 普及阶段,手机的硬件与软件都迎来了一次迭代浪潮——新形态的需求对操作系统的设计与交互都提出了诸多新的问题,originos 的首个版本,可以看作 vivo对这些问题的回答。 彼时,我曾有机会与 OriginOS 开发团队沟通,正如 OriginOS 的中文名原 …

    2026年9月24日 • 用户投稿
    100
  • 如何在PHP的require语句中传递参数并有效管理变量作用域

    本文探讨了在php中使用`require`或`include`语句时如何向被引入文件传递参数。文章详细阐述了通过直接变量作用域共享、利用`$_get`超全局变量(不推荐)以及将引入文件内容封装为函数或类(推荐最佳实践)这三种方法,并提供了相应的代码示例,旨在帮助开发者理解和选择最适合其场景的参数传递…

    2026年9月24日
    000
  • DeepArt的AI混合工具怎么操作?快速生成艺术风格图像的方法

    使用DeepArt类工具时,先选匹配的风格图与内容图,调节风格强度避免失真,推荐尝试Artbreeder、RunwayML、NightCafe等多元平台以提升创作效果。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ DeepArt的AI混合…

    2026年9月24日
    000
  • VSCode如何实现代码自动修复 VSCode智能重构与错误修正技巧

    VSCode如何实现代码自动修复 VSCode智能重构与错误修正技巧VSCode如何实现代码自动修复 VSCode智能重构与错误修正技巧VSCode如何实现代码自动修复 VSCode智能重构与错误修正技巧VSCode如何实现代码自动修复 VSCode智能重构与错误修正技巧

    vscode通过集成语言服务协议(lsp)、内置quick fixes和refactoring actions,并结合扩展如eslint、prettier等,实现代码自动修复与智能重构;2. 启用editor.formatonsave和editor.codeactionsonsave设置可在保存时自…

    2026年9月24日 • 用户投稿
    100
  • 如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项

    如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项如何用COUNT函数统计行数?处理NULL值时SUM/AVG函数的注意事项

    count函数统计行数时需注意使用方式,count(*)统计所有行包括null值,count(column_name)仅统计非null值。sum和avg函数均忽略null值,可能导致计算偏差,可通过coalesce或case语句处理。明确需求后选择合适方法,并注意数据类型与测试验证以避免错误。 CO…

    2026年9月24日 • 用户投稿
    000
  • Pages如何协作修改文档 Pages跟踪修改和建议的用法

    使用Pages的协作与修订功能可高效编辑文档,先启用共享邀请协作者,再通过建议模式提出修改,所有更改以标记形式显示,经审查后接受或拒绝,最终关闭修订模式保存定稿。 如果您正在与团队成员共同编辑一份文档,但希望保留原始内容并记录所有更改建议,可以使用 Pages 的协作与修订功能来实现高效沟通。通过这…

    2026年9月24日
    100
  • IOS17新功能大

    一、个性定制与操作体验的全面进化 在ios 17中,苹果显著提升了系统的个性化能力。用户现在可以对锁屏进行更深层次的自定义,包括自由搭配背景图像、调整色彩主题以及更换字体风格,轻松打造专属视觉风格。新增的“动态壁纸”功能让主屏幕更加生动,随着设备角度变化呈现出不同的视觉效果。同时,通知系统也更加智能…

    2026年9月24日
    400
  • Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪

    Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪Polarr的AI工具怎么裁剪图片?教你轻松实现高效图像裁剪

    Polarr的AI裁剪通过内容感知智能识别主体与构图焦点,提供如主体居中、构图优化和比例推荐等方案,操作上先导入图片,选择裁剪工具后AI即分析画面并生成多个推荐预设,用户可直接应用或手动微调,相比传统裁剪显著提升效率、辅助构图决策,尤其适用于社交媒体多平台比例适配,帮助保持视觉一致性并避免关键信息被…

    2026年9月24日 • 用户投稿
    600
  • 解决AWS S3 PHP SDK中SSL连接失败问题:证书验证与文件句柄限制

    本文旨在帮助开发者解决在使用AWS S3 PHP SDK时遇到的SSL连接失败问题,错误信息包括“fopen(): SSL operation failed with code 5”和“certificate verify failed”。文章将深入分析错误原因,并提供修改php.ini配置,指定证…

    2026年9月24日
    200
  • 在Hibernate中实现非关联实体间的ID引用与高效查询

    本教程探讨了在Hibernate应用中,如何在没有直接实体映射关系(如@OneToMany)的情况下,将一个实体(如父实体)生成的ID引用到另一个非关联实体(如日志实体)中。通过利用HQL/JPQL的JOIN…ON语法,即使没有显式ORM关系,也能实现基于共享ID字段的高效数据关联和查询…

    2026年9月24日
    600
  • mysql如何优化表结构?表结构设计方法

    设计和优化 mysql 表结构应从字段类型选择、主键与索引设计、冗余与范式处理、分表分区策略四个方面入手。1. 合理选择字段类型,如整数用 int/bigint,枚举值用 enum 或 tinyint,日期用 datetime,避免过度使用 text/blob;2. 主键建议使用自增整型,避免长字段…

    2026年9月24日
    1000
  • 有选择性地移除 WooCommerce 订单邮件中的产品购买备注

    本文将指导您如何针对特定的 WooCommerce 订单邮件通知,有选择性地移除产品购买备注,避免在所有邮件中都隐藏该信息。 使用 WooCommerce 钩子和全局变量进行控制 WooCommerce 允许开发者通过钩子(hooks)修改其核心功能。为了实现我们的目标,我们需要使用 woocomm…

    2026年9月24日
    300
  • 光追和DLSS/FSR技术,对游戏体验改变到底有多大?

    光追与DLSS/FSR结合带来颠覆性体验:光追实现真实光影,提升视觉真实感;DLSS/FSR通过AI超分技术保障高画质下的高帧率,二者协同达成电影级沉浸效果。 开启光追和DLSS/FSR后,游戏体验的变化是颠覆性的。它不只是画面更亮或帧数更高那么简单,而是从视觉真实感和操作流畅度两个维度,彻底改变了…

    2026年9月24日
    800
  • 升级Windows 10/11出现0xC1900101错误怎么办?

    错误代码0xC1900101通常由驱动冲突、磁盘空间不足或系统文件损坏引起。1、通过设备管理器更新过时驱动;2、确保C盘有20GB以上空间并清除SoftwareDistribution文件夹;3、使用SFC和DISM命令修复系统文件;4、重置Windows Update相关服务为自动启动并重启服务。…

    2026年9月24日
    200

发表回复

登录后才能评论
关注微信