Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
c++如何处理宽字符和Unicode_c++宽字符与Unicode编码处理方法_创想鸟

c++如何处理宽字符和Unicode_c++宽字符与Unicode编码处理方法

C++处理宽字符和Unicode的核心在于编码转换与类型选择,需理解wchar_t的平台依赖性及UTF-8、UTF-16、UTF-32编码差异,推荐使用std::string存储UTF-8并借助ICU或Boost.Locale进行跨平台转换。
c++如何处理宽字符和unicode_c++宽字符与unicode编码处理方法

C++在处理宽字符和Unicode时,核心在于理解字符集、编码与C++自身类型系统之间的映射关系。说实话,这事儿有点复杂,因为它不是一个“开箱即用”就能完美解决的问题,更多的是提供了一些基础工具,然后需要我们自己去搭建一个合适的处理框架。简单来说,C++提供了wchar_t这样的宽字符类型,以及C++11后引入的char16_t和char32_t,它们是用来存储Unicode码点的不同“宽度”的单元。但如何将这些单元有效地转换成特定的Unicode编码(比如UTF-8、UTF-16、UTF-32)进行存储、传输或显示,这才是关键,并且往往需要我们手动处理或借助第三方库。

解决方案

C++处理宽字符和Unicode,本质上是一个关于“编码转换”和“正确类型选择”的问题。我们得先明确,C++标准库本身对Unicode的直接支持,尤其是在跨平台和不同编码之间转换时,是相对基础的。

首先,了解C++中的字符类型:

char:通常是8位,用于存储ASCII或本地编码的单字节字符。但它也常被用于存储UTF-8编码的字节序列,因为UTF-8是变长编码,一个Unicode字符可能由1到4个char组成。wchar_t:这是所谓的“宽字符”类型。它的宽度是平台相关的,在Windows上通常是16位(常用于UTF-16),在Linux上通常是32位(常用于UTF-32)。这种平台差异性是导致很多跨平台Unicode问题的原因。char16_t(C++11起):明确表示一个16位的Unicode编码单元,通常用于UTF-16。char32_t(C++11起):明确表示一个32位的Unicode编码单元,通常用于UTF-32。

基于这些类型,我们有对应的字符串类型:

立即学习“C++免费学习笔记(深入)”;

std::string:基于char,常用于UTF-8编码的字符串。std::wstring:基于wchar_t,其内部编码取决于wchar_t的实际宽度和平台。std::u16string(C++11起):基于char16_t,用于UTF-16编码的字符串。std::u32string(C++11起):基于char32_t,用于UTF-32编码的字符串。

实际处理时,我们通常会面临以下场景和解决方案:

内部表示与外部交互:

内部统一使用UTF-8: 我个人倾向于在应用程序内部,尤其是涉及到字符串处理和存储时,尽量使用std::string来承载UTF-8编码。UTF-8的优势在于兼容ASCII,且在Web和文件系统层面非常流行。这意味着你的std::string可能包含多字节序列,需要用专门的库(如utf8-cpp、ICU)来正确处理字符迭代、长度计算和子串操作。与系统API交互: 当需要与操作系统API(例如Windows的MessageBoxW,它接受UTF-16)或特定库交互时,就需要进行编码转换。Windows平台: 使用MultiByteToWideChar和WideCharToMultiByte进行UTF-8与UTF-16(wchar_t)之间的转换。Linux/macOS: 更多依赖于iconv库或者std::locale的codecvt facet(尽管在C++17中std::codecvt被废弃,但其思想和替代方案依然存在)。C++11的编码字面量:u8"这是UTF-8字符串":生成UTF-8编码的const char[]。u"这是UTF-16字符串":生成UTF-16编码的const char16_t[]。U"这是UTF-32字符串":生成UTF-32编码的const char32_t[]。L"这是宽字符串":生成平台依赖的const wchar_t[]。

编码转换的策略:

C++11/14/17 std::codecvt (已废弃但概念重要): 曾经,std::codecvt及其特化(如std::codecvt_utf8)是标准库中进行编码转换的主要方式,配合std::wstring_convert使用。但由于其复杂性和一些设计缺陷,它在C++17中被废弃了。替代方案(推荐):Boost.Locale: 提供了一套强大且跨平台的本地化和编码转换工具。它封装了底层系统API,提供了更高级别的抽象。ICU (International Components for Unicode): 这是Unicode联盟维护的一个非常全面的库,提供了几乎所有你需要的Unicode功能,包括强大的编码转换、文本边界分析、大小写转换、排序等。如果你的项目对Unicode处理有深度需求,ICU是首选。自定义转换函数: 对于简单的UTF-8 UTF-16转换,有时也可以自己实现,但要非常小心,确保处理好代理对(surrogate pairs)和错误情况。

输入/输出流:

std::cin, std::cout, std::ifstream, std::ofstream 默认处理char类型,通常假定为本地编码或ASCII。

std::wcin, std::wcout, std::wifstream, std::wofstream 默认处理wchar_t类型。要让它们正确处理Unicode,需要设置std::locale:

#include #include  // for std::locale#include  // for std::codecvt_utf8 (if used for locale)int main() {    // 设置wcout的locale,使其能正确输出UTF-8或平台宽字符编码    // 注意:这只是一个示例,实际情况需要根据操作系统和编译器来调整    // 例如,在Linux上可能是 "en_US.UTF-8"    // 在Windows上可能需要特定的宽字符locale,或者使用SetConsoleOutputCP(CP_UTF8)    std::locale::global(std::locale("")); // 使用系统默认locale    std::wcout.imbue(std::locale("")); // 将wcout的locale设置为系统默认    // 如果要强制wcout以UTF-8输出(假设wchar_t是UTF-16),则需要更复杂的设置    // 或者直接用std::cout输出UTF-8编码的std::string    std::wcout << L"你好,世界!" << std::endl; // 输出宽字符    return 0;}

在现代C++中,直接使用std::string和UTF-8,然后用外部库进行编码转换通常是更健壮和跨平台的做法。

C++中宽字符(wchar_t)与Unicode编码的根本区别是什么?

这可能是最容易让人混淆的地方。wchar_t是C++语言提供的一个数据类型,它被设计用来存储“宽字符”。它的“宽度”(即所占字节数)以及它实际代表的编码,是平台相关的。在Windows上,wchar_t通常是16位,用来表示UTF-16编码单元。而在许多Unix-like系统(如Linux)上,wchar_t通常是32位,用来表示UTF-32编码单元。

Unicode则是一个字符集标准,它为世界上几乎所有的字符都分配了一个唯一的数字,这个数字就是“码点”(code point)。Unicode标准还定义了多种编码方式来将这些码点表示成字节序列,最常见的就是UTF-8、UTF-16和UTF-32。

所以,区别在于:

wchar_t是一个容器:它只是一个整数类型,用来容纳一个字符的码点或者一个编码单元。它本身不定义编码方式。Unicode是内容和规范:它定义了字符本身(码点)以及如何将这些字符表示成字节序列(编码方式,如UTF-8、UTF-16)。

举个例子,Unicode字符 ‘A’ 的码点是 U+0041。

在UTF-8中,它被编码成一个字节:0x41。在UTF-16中,它被编码成两个字节:0x00 0x41。在UTF-32中,它被编码成四个字节:0x00 0x00 0x00 0x41。

如果你的系统上wchar_t是16位,那么L'A'可能存储0x0041,这恰好是UTF-16的编码单元。但如果你的系统上wchar_t是32位,那么L'A'可能存储0x00000041,这又是UTF-32的编码单元。这种不确定性正是wchar_t在跨平台Unicode处理中带来麻烦的根源。C++11引入的char16_t和char32_t就是为了解决这种模糊性,它们明确地绑定到UTF-16和UTF-32的编码单元,从而提供了更清晰的语义。

在C++中处理UTF-8编码的最佳实践和常见陷阱有哪些?

处理UTF-8编码在C++中是相当普遍的需求,因为它兼顾了国际化和网络传输效率。但如果不注意,很容易踩坑。

最佳实践:

始终将UTF-8视为字节序列: std::string是存储UTF-8编码字符串的理想选择,但要记住,std::string::length()返回的是字节数,而不是字符数。std::string::operator[]访问的是字节,而不是Unicode字符。

std::string s_utf8 = u8"你好"; // u8前缀确保是UTF-8字面量// s_utf8.length() 会是6 (每个汉字在UTF-8中占3个字节)// s_utf8[0] 是第一个汉字的第一个字节

使用专门的库进行字符串操作: 对于UTF-8字符串的字符迭代、长度计算、子串提取、大小写转换等操作,不要直接使用std::string的成员函数或C风格字符串函数(如strlen、substr)。它们是字节导向的,会破坏多字节字符。

推荐: utf8-cpp库(轻量级,专注于UTF-8迭代和验证)、Boost.Locale或ICU库。这些库能正确处理变长字符编码。

#include #include #include  // 假设你使用了utf8-cpp库

int main() {std::string s_utf8 = u8″你好世界”;// 使用utf8-cpp计算字符数auto it_begin = s_utf8.begin();auto it_end = s_utf8.end();int char_count = 0;while (it_begin != it_end) {utf8::next(it_begin, it_end); // 移动到下一个UTF-8字符的开始char_count++;}std::cout


明确编码边界: 在文件I/O、网络通信或API调用时,始终明确指出你正在处理UTF-8编码。如果可能,在文件头或协议中包含编码信息。

正确配置I/O流: 当需要通过std::cout或文件流输出UTF-8时,确保终端或文件读取器能正确解析UTF-8。在某些系统上,你可能需要设置std::locale或使用特定的操作系统API来确保控制台输出UTF-8。

Windows: 可能需要调用SetConsoleOutputCP(CP_UTF8)。Linux/macOS: 确保终端的LANG环境变量包含.UTF-8(例如en_US.UTF-8)。

处理编码转换: 当需要将UTF-8与其他编码(如UTF-16 for Windows API)进行转换时,使用前述的Boost.Locale、ICU或操作系统API。

常见陷阱:

误以为std::string::length()是字符数: 这是最常见的错误。std::string::length()返回的是字节数,对于UTF-8多字节字符,它与实际可见的字符数不符。直接对UTF-8字符串进行索引或切片: s_utf8[i]会返回第i个字节,这很可能是一个多字节字符的中间部分,导致乱码或程序崩溃。s_utf8.substr(pos, len)也可能在字符中间截断。使用C风格字符串函数: strlen()、strcpy()、strcat()等函数是字节导向的,对UTF-8字符串操作同样会出问题。混合使用编码: 在同一个程序中,不加区分地混用UTF-8、本地编码和宽字符编码,这几乎是乱码的温床。不处理编码转换时的错误: 编码转换不是总能成功的,例如遇到非法字节序列时。一个健壮的程序应该捕获并处理这些转换错误。忘记设置I/O流的locale: 尤其是在使用std::wcout时,如果locale没有正确设置,输出的宽字符可能会显示为问号或乱码。

C++11及更高版本如何简化Unicode字符串的国际化与本地化?

C++11及更高版本确实在一定程度上简化了Unicode字符串的处理,主要是通过引入更明确的字符类型和字面量,让开发者能够更清晰地表达意图,而不是完全依赖平台特定的wchar_t行为。

明确的Unicode字符类型和字符串类型:

char16_t和char32_t:这两个类型的引入,使得我们可以明确地声明一个变量或字符串存储的是UTF-16或UTF-32的编码单元,而不再有wchar_t的平台依赖性。std::u16string和std::u32string:与char16_t和char32_t对应的字符串类型,提供了类型安全的容器。这消除了wchar_t带来的歧义,让代码更具可移植性。

Unicode字符串字面量:

u8"...":UTF-8编码的const char[]字面量。这使得直接在源代码中嵌入UTF-8字符串变得非常方便和安全,避免了手动编码或转义。u"...":UTF-16编码的const char16_t[]字面量。U"...":UTF-32编码的const char32_t[]字面量。这些字面量允许开发者在编译时就指定字符串的编码,减少了运行时编码转换的需求,或者至少提供了一个明确的起点。

原始字符串字面量(Raw String Literals)与UTF-8结合:

`u8R”(

以上就是c++++如何处理宽字符和Unicode_c++宽字符与Unicode编码处理方法的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1476442.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
c++中如何使用unique_ptr_C++智能指针unique_ptr用法详解
上一篇 2025年12月19日 00:25:03
c++中什么是虚析构函数_C++虚析构函数作用与必要性分析
下一篇 2025年12月19日 00:25:15

相关推荐

  • 240水冷能压住i7级别的CPU吗?

    240水冷能压住i7级别的CPU吗?240水冷能压住i7级别的CPU吗?240水冷能压住i7级别的CPU吗?240水冷能压住i7级别的CPU吗?

    240水冷能压住i7级别CPU,具体取决于型号和使用场景。对于第13、14代i7如i7-13700/14700,日常使用和游戏负载下,主流240水冷设计散热功耗普遍超200W,配合合理机箱风道可稳定控温;但若进行超频或运行AIDA64、Prime95等高负载任务,尤其是i7-14700K这类带“K”…

    2026年9月25日 • 用户投稿
    000
  • 如何检测显示器是否存在色彩准确度问题?

    如何检测显示器是否存在色彩准确度问题?如何检测显示器是否存在色彩准确度问题?如何检测显示器是否存在色彩准确度问题?如何检测显示器是否存在色彩准确度问题?

    答案:检测显示器色彩准确度需从肉眼观察、专业图卡比对到校色仪硬件校准三个层次进行,常见问题包括面板老化、出厂校准不佳、驱动设置错误等;选购时应关注专业品牌、Delta E值及出厂报告,校准后若色彩不习惯多因人眼适应性、环境光干扰或ICC文件未正确加载所致。 检测显示器色彩准确度问题,通常从肉眼观察、…

    2026年9月25日 • 用户投稿
    000
  • sublime怎么配置Angular开发环境_sublime搭建Angular开发环境步骤

    sublime怎么配置Angular开发环境_sublime搭建Angular开发环境步骤sublime怎么配置Angular开发环境_sublime搭建Angular开发环境步骤sublime怎么配置Angular开发环境_sublime搭建Angular开发环境步骤sublime怎么配置Angular开发环境_sublime搭建Angular开发环境步骤

    首先安装Sublime Text并更新至最新版,然后通过Package Control安装Emmet、TypeScript、AngularJS等插件以支持Angular开发,配置TypeScript语法识别,启用代码片段和智能提示,结合外部终端使用Angular CLI生成文件,最后通过保存项目和设…

    2026年9月25日 • 用户投稿
    100
  • win10系统命令提示符被禁用怎么办

    win10系统命令提示符被禁用怎么办win10系统命令提示符被禁用怎么办win10系统命令提示符被禁用怎么办win10系统命令提示符被禁用怎么办

    我们都知道windows系统自带命令提示符功能,日常使用中也常通过它来执行命令或快速打开某些设置界面。但若发现命令提示符被禁用了,该如何解决呢?下面为大家介绍在win10系统下恢复命令提示符的详细方法。 操作步骤如下: 1. 同时按下键盘上的“Win”键和“R”键,打开运行对话框。输入“gpedit…

    2026年9月25日 • 用户投稿
    100
  • 淘宝百亿补贴多久才能再买一次?购物技巧有哪些呢?「限购规则全破解」淘宝百亿补贴二次购买攻略+5大必学抢购技巧,手慢无!

    淘宝百亿补贴多久才能再买一次?购物技巧有哪些呢?「限购规则全破解」淘宝百亿补贴二次购买攻略+5大必学抢购技巧,手慢无!淘宝百亿补贴多久才能再买一次?购物技巧有哪些呢?「限购规则全破解」淘宝百亿补贴二次购买攻略+5大必学抢购技巧,手慢无!淘宝百亿补贴多久才能再买一次?购物技巧有哪些呢?「限购规则全破解」淘宝百亿补贴二次购买攻略+5大必学抢购技巧,手慢无!淘宝百亿补贴多久才能再买一次?购物技巧有哪些呢?「限购规则全破解」淘宝百亿补贴二次购买攻略+5大必学抢购技巧,手慢无!

    在淘宝百亿补贴活动中成功下单心仪好物后,许多用户都会面临一个共同问题:「下次还能不能继续享受补贴优惠?」。根据平台现行规则,同一账号购买相同补贴商品通常需等待7至30天不等,具体时限会因活动节奏、商品类别等因素有所调整。本文将全面解读百亿补贴的购买机制,并分享5项极具实操价值的抢购策略,助你轻松把握…

    2026年9月25日 • 用户投稿
    000
  • 豆包AI会保存聊天记录吗 隐私政策与数据管理说明

    豆包AI会保存聊天记录吗 隐私政策与数据管理说明豆包AI会保存聊天记录吗 隐私政策与数据管理说明豆包AI会保存聊天记录吗 隐私政策与数据管理说明豆包AI会保存聊天记录吗 隐私政策与数据管理说明

    豆包ai可能会保存聊天记录,但具体取决于其隐私政策和技术机制。1. 聊天记录通常会被短期或长期保存以提供连贯服务,但用途仅限于优化体验;2. 用户可通过检查隐私设置、主动删除记录或联系客服来管理数据;3. 隐私政策关键点包括数据收集范围、用途、存储保护及用户权利,建议使用前仔细阅读相关政策以确保数据…

    2026年9月25日 • 用户投稿
    000
  • Debian Tomcat日志中的慢查询如何优化

    Debian Tomcat日志中的慢查询如何优化Debian Tomcat日志中的慢查询如何优化Debian Tomcat日志中的慢查询如何优化Debian Tomcat日志中的慢查询如何优化

    本文探讨如何在Debian系统上优化Tomcat应用中的数据库慢查询。需要注意的是,Tomcat本身不记录慢查询,而是由数据库(如MySQL)负责。因此,优化过程主要针对数据库层面。 第一步:启用数据库慢查询日志 首先,确保你的数据库已启用慢查询日志记录功能。以MySQL为例,可以通过以下两种方式实…

    2026年9月25日 • 用户投稿
    000
  • Yandex网页版入口在哪?全球第二大搜索引擎使用指南!

    Yandex网页版入口在哪?全球第二大搜索引擎使用指南!Yandex网页版入口在哪?全球第二大搜索引擎使用指南!Yandex网页版入口在哪?全球第二大搜索引擎使用指南!Yandex网页版入口在哪?全球第二大搜索引擎使用指南!

    Yandex网页版入口是https://yandex.com/,该平台提供多语言搜索、图片识别、音视频索引、实时新闻及地图导航等服务,界面简洁支持深色模式,具备翻译、邮箱、应用中心等特色功能。 1、立即进入“☞☞☞☞点击yandex网页版入口☜☜☜☜”; 2、立即进入“☞☞☞☞点击全球第二大搜索引擎…

    2026年9月25日 • 用户投稿
    400
  • Linux sudo日志查看与分析方法

    sudo日志默认存储在/var/log/auth.log(Debian系)或/var/log/secure(RHEL系),可通过grep、tail等命令筛选用户操作、成功命令及失败尝试,日志包含时间、用户、命令等信息;可通过visudo配置独立日志文件及输入输出记录,结合journalctl、awk…

    2026年9月25日
    000
  • VB添加扩展控件方法

    VB添加扩展控件方法VB添加扩展控件方法VB添加扩展控件方法VB添加扩展控件方法

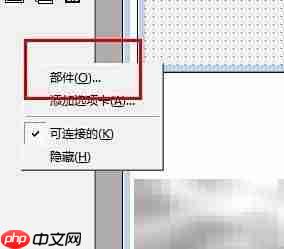
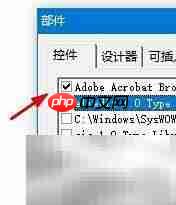
    在VB中添加扩展控件的操作步骤如下: 第一步:在工具箱的空白区域点击鼠标右键。 第二步:从弹出的菜单中选择“部件”命令,或点击对应的快捷按钮。 第三步:系统将弹出“部件”对话框,在其中可以浏览可用的控件列表。 度加剪辑 度加剪辑(原度咔剪辑),百度旗下AI创作工具 63 查看详情 第四步:找到需要添…

    2026年9月25日 • 用户投稿
    000
  • Mac如何清理系统缓存_Mac系统缓存与垃圾文件清理方法

    Mac如何清理系统缓存_Mac系统缓存与垃圾文件清理方法Mac如何清理系统缓存_Mac系统缓存与垃圾文件清理方法Mac如何清理系统缓存_Mac系统缓存与垃圾文件清理方法Mac如何清理系统缓存_Mac系统缓存与垃圾文件清理方法

    Mac运行慢或存储紧张时,系统缓存和临时文件是主因。可通过手动清理系统级缓存(/Library/Caches)、用户专属缓存(~/Library/Caches)、系统日志(~/Library/Logs 和 /var/log),使用macOS内置存储管理工具优化存储,并定期重启Mac以清除临时文件,有…

    2026年9月25日 • 用户投稿
    000
  • Win10电脑加快缩略图加载速度的操作方法?

    Win10电脑加快缩略图加载速度的操作方法?Win10电脑加快缩略图加载速度的操作方法?Win10电脑加快缩略图加载速度的操作方法?Win10电脑加快缩略图加载速度的操作方法?

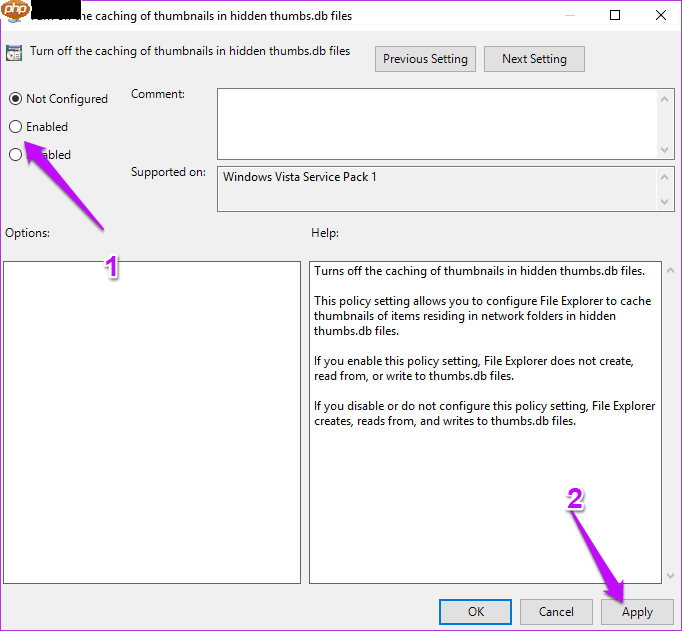
    若您的电脑配置较低,并且已经使用了较长时间,可能会发现打开资源管理器时速度较慢,绿色进度条前进得十分迟缓。此时,您可以尝试这一方法,在组策略中对其进行设置,关闭缩略图缓存功能。 Win10系统优化缩略图加载: 使用组策略 第一步:通过在“开始”菜单输入编辑组策略或者gpedit.msc来打开组策略。…

    2026年9月25日 • 用户投稿
    000
  • Debian如何回收软件许可证

    Debian如何回收软件许可证Debian如何回收软件许可证Debian如何回收软件许可证Debian如何回收软件许可证

    本文介绍如何在Debian系统中回收软件许可证,实际上就是卸载软件包并清理相关文件。 您可以使用dpkg或apt工具来完成此操作。 方法一:使用dpkg 卸载软件包: 保留配置文件卸载: sudo dpkg -r package_name (其中package_name替换为软件包名称)彻底卸载,包…

    2026年9月25日 • 用户投稿
    000
  • Java布尔方法条件逻辑解析与预期行为校正

    Java布尔方法条件逻辑解析与预期行为校正Java布尔方法条件逻辑解析与预期行为校正Java布尔方法条件逻辑解析与预期行为校正Java布尔方法条件逻辑解析与预期行为校正

    本文旨在探讨Java中布尔方法条件表达式的常见误解,通过一个具体的kindaLiked()方法案例,详细分析代码逻辑与预期行为不符的原因。我们将演示如何精确定义条件,确保方法返回结果与业务逻辑一致,并提供示例代码、调试技巧及最佳实践,以帮助开发者编写更准确、可维护的布尔判断逻辑。 理解布尔方法与条件…

    2026年9月25日 • 用户投稿
    100
  • sublime怎么快速查看函数或类列表_sublime结构导航与符号浏览技巧

    sublime怎么快速查看函数或类列表_sublime结构导航与符号浏览技巧sublime怎么快速查看函数或类列表_sublime结构导航与符号浏览技巧sublime怎么快速查看函数或类列表_sublime结构导航与符号浏览技巧sublime怎么快速查看函数或类列表_sublime结构导航与符号浏览技巧

    使用Ctrl+R或Cmd+R打开“前往符号”面板,可快速定位函数和类;通过安装SideBarEnhancements等插件,在侧边栏查看文件符号树;配合LSP插件支持,使用F12实现“转到定义”跨文件跳转;自定义快捷键如Ctrl+Shift+R优化操作效率。 在使用 Sublime Text 编辑代…

    2026年9月25日 • 用户投稿
    300
  • windows怎么查看wifi信号强度_windows系统查看wifi信号强度的方法

    首先检查Wi-Fi信号强度以判断网络问题,可通过任务栏图标查看图形化信号格数及百分比;其次使用命令提示符输入netsh wlan show interfaces获取信号强度百分比和SSID等详细信息;最后可借助Acrylic Wi-Fi Home等第三方工具扫描周边网络的RSSI值与信道占用情况,分…

    2026年9月25日
    000
  • 关闭Win10这三大新功能:系统重回Win7风

    关闭Win10这三大新功能:系统重回Win7风关闭Win10这三大新功能:系统重回Win7风关闭Win10这三大新功能:系统重回Win7风关闭Win10这三大新功能:系统重回Win7风

    发布超过3年,win10依然未能全面取代win7,反而因各类问题频繁遭到批评。 Softpedia发表文章,指出Win10目前的三项核心功能——Cortana(小娜)、Aciton Centre(操作中心)以及Timeline(时间线),其关闭方式过于繁琐且隐蔽,建议微软提供更加便捷的一键屏蔽选项。…

    2026年9月25日 • 用户投稿
    000
  • 电脑机箱风道设计对散热效率的影响有多大?

    电脑机箱风道设计对散热效率的影响有多大?电脑机箱风道设计对散热效率的影响有多大?电脑机箱风道设计对散热效率的影响有多大?电脑机箱风道设计对散热效率的影响有多大?

    合理的机箱风道设计能有效降低温度,提升硬件稳定性。判断风道是否合理可通过监控软件查看CPU、GPU温度(如满载超80℃或85℃),观察灰尘堆积情况及手触感知风量分布。理想风道为前进风、后排风的水平气流,塔式散热器应朝向后排风扇,高端显卡可加底面进风。理线也关键,杂乱线材会阻碍气流,需用扎带等整理。风…

    2026年9月25日 • 用户投稿
    000
  • 利用OSHI库监测与计算磁盘活动时间及传输速率

    利用OSHI库监测与计算磁盘活动时间及传输速率利用OSHI库监测与计算磁盘活动时间及传输速率利用OSHI库监测与计算磁盘活动时间及传输速率利用OSHI库监测与计算磁盘活动时间及传输速率

    本文详细介绍了如何利用Java OSHI库获取磁盘的活动时间与传输速率。通过HWDiskStore类的getReads()、getWrites()和getTransferTime()方法,结合时间间隔内的增量数据,可以精确计算出磁盘的活跃百分比和每秒传输次数。教程提供了示例代码,并逐步解析了数据采集…

    2026年9月25日 • 用户投稿
    000
  • 如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀

    如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀如何用豆包AI自动生成单元测试 提升代码质量的AI秘诀

    使用豆包ai可以高效生成全面的单元测试代码,首先确保函数或类逻辑清晰稳定,如定义了clean_input函数用于清理用户输入字符串;接着提示ai生成测试用例时描述功能背景,ai将自动覆盖正常值、空值、边界值及异常输入等场景;生成的测试样例包括空字符串、none、前后空格、大写字母、数字符号等情况;随…

    2026年9月25日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信