Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Prisma groupBy 结合关联数据获取:实现聚合与关联字段的查询_创想鸟

Prisma groupBy 结合关联数据获取:实现聚合与关联字段的查询

Prisma groupBy 结合关联数据获取:实现聚合与关联字段的查询

本文旨在解决Prisma中groupBy聚合查询无法直接包含关联字段的限制。通过一个实际案例,详细阐述如何利用Prisma的groupBy功能进行数据聚合,并结合二次查询和JavaScript的异步处理能力,有效地将聚合结果与相关联的实体信息(如用户姓名)合并,从而获取一个既包含聚合数据又包含关联实体详情的完整数据集。

理解 Prisma groupBy 的应用与限制

在数据库操作中,聚合查询是常见的需求,例如计算某个字段的总和、平均值或计数。prisma 提供了强大的 groupby 功能来满足这类需求。考虑以下两个关联模型:

model admins {  id        Int       @id @default(autoincrement())  name      String  last_name String  phone     String    @unique  email     String?   @unique  nic       String?   @unique  image     String?  payments  payment[]}model payment {  id          Int       @id @default(autoincrement())  amount      Int  description String?  date        DateTime? @db.Date  admin_id    Int  admins      admins    @relation(fields: [admin_id], references: [id])}

假设我们需要查询每个管理员(admin)的总支付金额。我们可以使用 prisma.payment.groupBy 进行聚合:

const data = await prisma.payment.groupBy({  by: ["admin_id"],  _sum: {    amount: true,  },});console.log(data);

上述查询将返回如下格式的结果:

[  { "_sum": { "amount": 1650 }, "admin_id": 1 },  { "_sum": { "amount": 2000 }, "admin_id": 2 }]

这个结果包含了每个 admin_id 对应的支付总额,但它缺少了管理员的 name 和 last_name 等关联信息。

核心限制:Prisma 的 groupBy 查询目前不支持直接使用 include 或 select 来获取关联模型的数据。这意味着你无法在一次 groupBy 查询中同时完成聚合和关联数据的加载。这是 Prisma 设计上的一个特点,旨在保持聚合操作的简洁和高效。

解决方案:分步查询与数据合并

为了解决 groupBy 无法直接获取关联字段的问题,我们可以采用分步查询并手动合并数据的方法。这种方法的核心思想是:

执行聚合查询: 首先,使用 groupBy 获取所需的聚合数据(例如,每个 admin_id 的总金额)。获取关联信息: 针对聚合结果中的每个唯一 admin_id,执行一次单独的查询来获取对应的管理员详细信息。合并数据: 将聚合结果与获取到的关联信息进行合并,形成最终所需的数据结构。

以下是具体的实现代码:

import { PrismaClient } from '@prisma/client';const prisma = new PrismaClient();async function getAdminPaymentTotalsWithDetails() {  // 步骤1: 执行聚合查询,获取每个管理员的支付总额  const paymentData = await prisma.payment.groupBy({    by: ["admin_id"],    _sum: {      amount: true,    },  });  // 步骤2 & 3: 遍历聚合结果,为每个admin_id获取关联的管理员信息并合并  const dataWithAdminInfo = await Promise.all(    paymentData.map(async (item) => {      // 为每个聚合项查询对应的管理员详情      const admin = await prisma.admins.findUnique({        where: { id: item.admin_id },        select: { // 仅选择需要的字段以优化性能          name: true,          last_name: true        }      });      // 合并聚合数据和管理员信息      return {        ...item, // 包含 _sum 和 admin_id        name: admin?.name, // 使用可选链操作符以防admin不存在        last_name: admin?.last_name      };    })  );  console.log(dataWithAdminInfo);  return dataWithAdminInfo;}// 调用函数getAdminPaymentTotalsWithDetails()  .catch(e => {    console.error(e);    process.exit(1);  })  .finally(async () => {    await prisma.$disconnect();  });

上述代码的输出将符合预期:

[  {    "_sum": { "amount": 1650 },    "admin_id": 1,    "name": "admin-name-1",    "last_name": "admin-last-name-1"  },  {    "_sum": { "amount": 2000 },    "admin_id": 2,    "name": "admin-name-2",    "last_name": "admin-last-name-2"  }]

注意事项与性能考量

Promise.all 的使用: 在上述解决方案中,我们使用了 Promise.all 来并发执行对每个 admin_id 的 findUnique 查询。这大大提高了效率,避免了串行查询可能导致的性能瓶颈。如果没有 Promise.all,每个 findUnique 查询都会等待上一个查询完成后再执行,这会非常慢。select 优化: 在 findUnique 查询中,我们使用了 select: { name: true, last_name: true }。这是一个重要的性能优化点,它确保我们只从数据库中检索所需的字段,而不是整个 admin 对象,从而减少了数据传输量。数据量考量: 对于聚合结果集非常庞大(例如,数万甚至数十万个不同的 admin_id)的场景,这种分步查询的方法可能会导致大量的数据库查询。在这种极端情况下,你可能需要考虑以下替代方案:数据库视图或存储过程: 在数据库层面创建视图或存储过程,直接在数据库中完成聚合和关联,然后通过 Prisma 查询该视图或调用存储过程。Prisma 原生查询 ($queryRaw): 如果复杂性超出了 Prisma ORM 的能力范围,可以直接使用 $queryRaw 或 $queryRawUnsafe 执行原生 SQL 查询,充分利用数据库的聚合和 JOIN 能力。数据缓存: 如果关联信息不经常变动,可以考虑将管理员信息缓存起来,减少对数据库的查询次数。错误处理: 在实际应用中,需要对查询结果进行更健壮的错误处理,例如当 admin 未找到时(admin 可能为 null),确保代码不会抛出异常。上述代码中使用了可选链操作符 (admin?.name) 来增强健壮性。

总结

尽管 Prisma 的 groupBy 查询在设计上不允许直接包含关联字段,但通过结合其强大的查询API和JavaScript的异步处理能力,我们能够优雅地实现聚合数据与关联信息的高效合并。这种分步查询、并发执行和精细化选择字段的策略,是处理复杂数据查询需求时一个实用且高性能的模式。在面对大规模数据时,理解并权衡不同解决方案的性能影响至关重要。

以上就是Prisma groupBy 结合关联数据获取:实现聚合与关联字段的查询的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1508877.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
Prisma 中关联字段聚合求和与数据整合的实践指南
上一篇 2025年12月20日 05:08:42
TypeScript接口与类型别名的差异:为何接口在特定场景下会报错?
下一篇 2025年12月20日 05:08:58

相关推荐

  • 怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解

    怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解怎么用豆包AI帮我解析XML数据 XML数据解析的AI实现方法详解

    xml数据解析借助豆包ai可简化为四个步骤:1. 发送xml内容让ai分析结构,明确标签层级与关键节点;2. 要求ai生成对应语言的解析代码,如python使用elementtree提取数据;3. 利用ai检查并修复格式错误,如未闭合标签或缺失引号;4. 指定需提取字段及输出格式,如json或csv…

    2026年9月28日 • 用户投稿
    100
  • 图片生成3d效果图的ai工具2025前十榜单

    2025年图片生成3D效果图的AI工具将由多模态理解、高效三维重建与用户友好性领先的平台主导,核心在于简化建模流程、提升真实感与可编辑性,融合NeRF、高斯泼溅与扩散模型等技术,实现从2D图像到高质量3D资产的智能转换,赋能设计、游戏、电商等领域。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索…

    2026年9月28日
    200
  • 如何利用Elser AI Comics批量生成漫画并提高创作效率?

    如何利用Elser AI Comics批量生成漫画并提高创作效率?如何利用Elser AI Comics批量生成漫画并提高创作效率?如何利用Elser AI Comics批量生成漫画并提高创作效率?如何利用Elser AI Comics批量生成漫画并提高创作效率?

    用elser ai comics批量生成漫画的关键在于掌握模板机制、角色统一设定和自动分镜功能。一、提前规划内容结构,明确每话大纲、角色、剧情节点和关键台词,写剧本草稿并标注重点画面,统一角色设定以节省调整时间;二、使用自定义模板保存常用构图、配色和字体,实现风格统一与快速复用,例如封面、回顾格与对…

    2026年9月28日 • 用户投稿
    300
  • 马斯克的 Grok 聊天机器人以超低价赢得美国政府合约

    马斯克的 Grok 聊天机器人以超低价赢得美国政府合约马斯克的 Grok 聊天机器人以超低价赢得美国政府合约马斯克的 Grok 聊天机器人以超低价赢得美国政府合约马斯克的 Grok 聊天机器人以超低价赢得美国政府合约

    埃隆・马斯克旗下的 xAI 公司近日宣布,已与美国联邦政府达成一项重要协议:其开发的人工智能聊天机器人 Grok 将以极低的价格向联邦机构提供服务。 根据与美国总务管理局签订的合同,各联邦部门在未来一年半内使用 Grok,每单位服务费用仅为42美分,远低于1美元的市场主流定价。这一价格显著低于目前在…

    2026年9月28日 • 用户投稿
    100
  • 告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧

    告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧告别加班:豆包AI集成DeepSeek后自动化处理Excel/Word技巧

    告别加班的核心在于利用豆包ai集成deepseek的能力实现办公自动化。1. excel数据清洗与分析可由自然语言描述规则,自动完成数据清洗、分析及图表生成;2. word文档批量处理支持文本替换、格式调整等操作,提升文档编辑效率;3. 复杂文档生成通过模板和数据自动填充,实现合同、简历等个性化文档…

    2026年9月28日 • 用户投稿
    100
  • Gemini支持材料特性预测吗 Gemini新材料研发辅助功能

    Gemini支持材料特性预测吗 Gemini新材料研发辅助功能Gemini支持材料特性预测吗 Gemini新材料研发辅助功能Gemini支持材料特性预测吗 Gemini新材料研发辅助功能Gemini支持材料特性预测吗 Gemini新材料研发辅助功能

    gemini 正在进军材料特性预测和新材料研发辅助领域,其潜力体现在三个方面:1)加速材料发现周期,通过预测材料性质缩小实验范围,显著提升效率;2)设计具有特定性质的材料,基于需求反向生成结构和组成方案;3)发现隐藏关联,从复杂数据中挖掘影响材料性能的关键因素。gemini 可预测力学、热学、电学、…

    2026年9月28日 • 用户投稿
    100
  • 用豆包AI实现GUI编程?智能设计桌面应用界面

    用豆包AI实现GUI编程?智能设计桌面应用界面用豆包AI实现GUI编程?智能设计桌面应用界面用豆包AI实现GUI编程?智能设计桌面应用界面用豆包AI实现GUI编程?智能设计桌面应用界面

    豆包ai虽非专业gui平台,但能有效辅助界面设计。它可根据自然语言描述生成控件布局、推荐技术方案(如tkinter、pyqt),并输出基础代码片段;具体步骤为:1. 明确需求,2. 用语言引导ai生成结构,3. 选择框架,4. 整合调试代码,5. 手动优化细节;该方式适合新手、原型验证者、跨框架开发…

    2026年9月28日 • 用户投稿
    100
  • Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%

    Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%Intel最强游戏CPU要涨价了!13/14代酷睿上涨超10%

    9月26日消息,据最新报道,intel拟上调其第13代和第14代酷睿(raptor lake)桌面处理器的售价,涨幅或将超过10%。 据悉,此次调价可能与供应链紧张及AI PC市场需求疲软有关。自2022年10月发布以来,Raptor Lake系列一直担当Intel产品线的主力角色。 尽管该系列已属…

    2026年9月28日 • 用户投稿
    200
  • 怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧

    怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧怎么用豆包AI帮我写Redis操作代码 Redis操作代码的AI编写技巧

    明确提问和引导是用豆包ai写好redis操作代码的关键。1. 先说明使用的编程语言和redis客户端库,如python的redis-py、node.js的ioredis或go的go-redis;2. 指定具体操作类型,如字符串、哈希、列表等,并说明是读还是写操作;3. 结合业务场景提问,例如缓存、限…

    2026年9月28日 • 用户投稿
    600
  • sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化

    sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化sublime怎么设置字体渲染_Sublime字体抗锯齿与渲染效果优化

    启用ClearType提升Windows下字体清晰度;2. 在Sublime中设置合适字体与subpixel_antialias;3. 避免非整数缩放防模糊;4. 可选Fira Code连字字体优化可读性。 Sublime Text 的字体渲染效果直接影响编码体验,清晰锐利的字体能减轻视觉疲劳。默认…

    2026年9月28日 • 用户投稿
    100
  • 华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」

    华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」华为技术专家居然把JVM内存模型讲解这么细致「建议收藏」

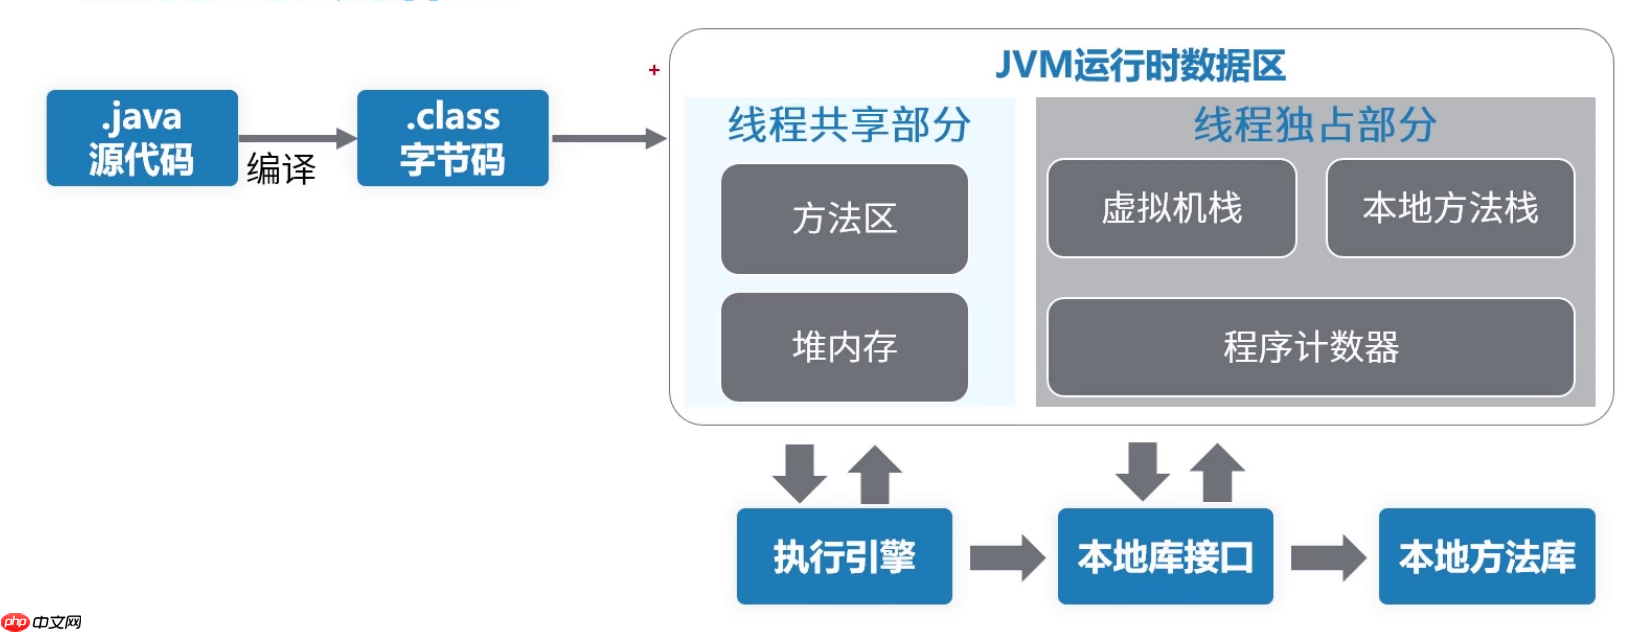
    大家好,又见面了,我是你们的朋友全栈君。 内存是非常重要的系统资源,是硬盘和CPU的中间仓库及桥梁,承载着os和应用程序的实时运行。 JVM内存布局规定了Java在运行过程中内存申请、分配、管理的策略,保证了JVM高效稳定运行。不同JVM对于内存的划分方式和管理机制存在差异。结合JVM虚拟机规范,来…

    2026年9月28日 • 用户投稿
    200
  • 360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹

    360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹360极速浏览器如何完全清除浏览数据_彻底清理缓存历史记录等上网痕迹

    首先通过设置菜单清除浏览数据,进入“更多工具”选择“清除上网痕迹”,勾选历史记录、缓存、Cookie等项后立即清除;其次手动删除用户数据文件夹,关闭浏览器后在%localappdata%360ChromeChromeUser Data路径下重命名或删除Default文件夹;再使用CCleaner等系…

    2026年9月28日 • 用户投稿
    100
  • Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力

    Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力Ollama 上线 “Web search” API,为 LLM 集成实时网络搜索能力

    ollama 正式发布“web search”api,使大语言模型具备实时获取互联网信息的能力,显著提升回答准确率并有效降低幻觉现象。 该功能以 REST API 形式开放,并已深度集成至 Ollama 的 Python 和 JavaScript SDK 中,便于开发者在各类应用中快速接入与调用。同…

    2026年9月28日 • 用户投稿
    200
  • windows怎么开启ahci模式 windows bios开启ahci模式教程

    windows怎么开启ahci模式 windows bios开启ahci模式教程windows怎么开启ahci模式 windows bios开启ahci模式教程windows怎么开启ahci模式 windows bios开启ahci模式教程windows怎么开启ahci模式 windows bios开启ahci模式教程

    首先修改注册表启用AHCI驱动,导航至msahci和iaStorV项将Start值改为0;随后进入BIOS将SATA模式从IDE更改为AHCI;若无法进系统,可通过Windows安装U盘在命令提示符中加载注册表并配置启动项,确保系统能正常识别AHCI模式,避免蓝屏或启动失败。 如果您在安装或重装Wi…

    2026年9月28日 • 用户投稿
    200
  • 怎么用豆包AI帮我优化Flutter渲染 让AI提升移动端性能的5个方案

    怎么用豆包AI帮我优化Flutter渲染 让AI提升移动端性能的5个方案怎么用豆包AI帮我优化Flutter渲染 让AI提升移动端性能的5个方案怎么用豆包AI帮我优化Flutter渲染 让AI提升移动端性能的5个方案怎么用豆包AI帮我优化Flutter渲染 让AI提升移动端性能的5个方案

    豆包ai能有效优化flutter应用的渲染性能,具体方法包括:1. 分析渲染瓶颈,识别冗余构建、过度嵌套和不必要的setstate,并建议拆分复杂widget、使用const关键字及避免在build中做耗时操作;2. 生成高效代码片段,如优化图片加载逻辑,提升内存管理和复用效率;3. 优化状态管理逻…

    2026年9月28日 • 用户投稿
    100
  • Java并发编程:掌握Future、线程安全与原子操作

    Java并发编程:掌握Future、线程安全与原子操作Java并发编程:掌握Future、线程安全与原子操作Java并发编程:掌握Future、线程安全与原子操作Java并发编程:掌握Future、线程安全与原子操作

    本教程深入探讨在Java并发编程中,如何避免将Future对象错误地用于存储可变数据,并详细指导如何正确地管理ExecutorService生命周期以及利用AtomicIntegerArray等并发工具实现线程安全的共享数组元素更新,确保数据一致性。 1. 理解Future的本质与误用 在java并…

    2026年9月28日 • 用户投稿
    100
  • 百度智能云 Qianfan-VL 系列模型重磅开源!全尺寸领域增强效果优异,全自研芯片计算!

    百度智能云 Qianfan-VL 系列模型重磅开源!全尺寸领域增强效果优异,全自研芯片计算!百度智能云 Qianfan-VL 系列模型重磅开源!全尺寸领域增强效果优异,全自研芯片计算!百度智能云 Qianfan-VL 系列模型重磅开源!全尺寸领域增强效果优异,全自研芯片计算!百度智能云 Qianfan-VL 系列模型重磅开源!全尺寸领域增强效果优异,全自研芯片计算!

    今天,百度智能云千帆正式推出全新视觉理解模型——qianfan-vl,并全面开源!该系列模型包含3b、8b和70b三个尺寸版本,是面向企业级多模态应用场景,进行了深度优化的视觉理解大模型。即日起至10月10日,用户可在百度智能云千帆平台免费体验8b、70b模型。qianfan-vl不仅具备出色的基础…

    2026年9月28日 • 用户投稿
    100
  • 并发编程中Future对象使用不当及解决方案

    并发编程中Future对象使用不当及解决方案并发编程中Future对象使用不当及解决方案并发编程中Future对象使用不当及解决方案并发编程中Future对象使用不当及解决方案

    本文针对Java并发编程中常见的set<int, Future> is not applicable to arguments (int,int)错误,深入剖析了其产生的原因,即试图将整型值直接赋值给存储Future对象的集合。文章将详细阐述Future对象的特性,并提供正确的解决方案,…

    2026年9月28日 • 用户投稿
    100
  • 苹果用户DeepSeek轻松上手操作指南

    苹果用户DeepSeek轻松上手操作指南苹果用户DeepSeek轻松上手操作指南苹果用户DeepSeek轻松上手操作指南苹果用户DeepSeek轻松上手操作指南

    苹果用户可在官网下载deepseek并手动信任安装;登录推荐用微信或邮箱;功能使用需根据需求切换模式和设置。具体步骤为:1. 访问官网下载对应ios/mac版本,前往设备管理中信任开发者证书;2. 登录时选择微信扫码或邮箱注册,团队用户可选企业账号;3. 使用前调整设置,如切换模型模式、开启历史记录…

    2026年9月28日 • 用户投稿
    200
  • DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议

    DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议DeepSeek 与 ChatGPT 有什么区别 特性对比与选型建议

    deepseek和chatgpt的主要区别在于训练数据、模型架构、擅长领域及应用场景。1. deepseek侧重代码生成与数学推理,适合编程及逻辑任务;2. chatgpt擅长自然语言处理与文本生成,适用于对话、写作等场景;3. 选型应根据项目核心需求决定,若重代码理解选deepseek,若重语言表…

    2026年9月27日 • 用户投稿
    100

发表回复

登录后才能评论
关注微信