MongoDB $lookup聚合中关联本地数组字段的技巧

MongoDB $lookup聚合中关联本地数组字段的技巧

本教程详细介绍了如何在MongoDB的$lookup聚合操作中,将本地集合(localField)中数组元素的特定字段(例如时间戳)与关联的外部集合数据进行合并。通过利用$lookup的管道功能以及后续的$set阶段,结合$map、$mergeObjects、$indexOfArray和$arrayElemAt等操作符,实现精确的数据整合,确保关联数据携带原始上下文信息,提升查询结果的完整性与实用性。

概述

在mongodb中,$lookup操作符是实现集合间左外连接(left outer join)的关键。它允许我们将一个集合的文档与另一个集合的文档进行关联,并将关联结果嵌入到源文档中。然而,当源文档包含一个数组字段,且我们需要将该数组中某个元素的特定属性(而非整个元素)与$lookup的结果进行匹配并保留时,问题就变得复杂。典型的场景是,我们有一个用户(user)集合,其中包含一个inbox数组,记录了参与者(participant)的id以及参与时间(added_at)。在使用$lookup填充participant的详细信息后,我们希望每个填充后的参与者对象都能包含其对应的added_at时间。

问题场景

假设我们有一个User集合,其文档结构如下:

{  "_id": ObjectId("123456789xx"),  "first_name": "Sam",  "last_name": "Jones",  "email": "sam.jones@example.com",  "inbox": [    {      "participant": ObjectId("1XXXXXXXXX"),      "added_at": "12:00:00 09/21/2021"    },    {      "participant": ObjectId("2XXXXXXXXX"),      "added_at": "12:00:00 11/21/2022"    }  ]}

我们的目标是使用$lookup来填充inbox数组中participant字段的详细信息(如first_name、last_name),同时,希望每个填充后的participant对象也能包含其原始对应的added_at字段。

最初的$lookup尝试可能如下:

{   from: "Users", // 假设Users集合也包含participant的详细信息   localField: "inbox.participant",   foreignField:"_id",   as: "participants",   pipeline:[      { $project: {first_name:1, last_name:1, _id: 1}}   ]}

这会得到类似如下的结果,其中participants数组只包含关联到的用户基本信息,而丢失了inbox中每个参与者对应的added_at字段:

{  "_id": ObjectId("123456789xx"),  "first_name": "Sam",  "last_name": "Jones",  "email": "sam.jones@example.com",  "inbox": [...], // 原始inbox数组  "participants": [    { "_id": ObjectId("1xxxxx"), "first_name": "John", "last_name":"Doe"},    { "_id": ObjectId("2xxxxx"), "first_name": "Jack", "last_name": "Smith"}  ]}

解决方案:结合 $set 和数组操作符

为了在$lookup结果中保留原始的added_at字段,我们需要在$lookup之后添加一个$set阶段,对participants数组进行后处理。这个后处理步骤将遍历participants数组,为每个参与者对象找到其在原始inbox数组中对应的added_at值,并将其合并到参与者对象中。

完整的聚合管道如下:

db.Users.aggregate([  {    // 第一步:执行 $lookup 操作,关联并获取参与者基本信息    $lookup: {      from: "Users", // 假设参与者信息也在Users集合中      localField: "inbox.participant", // 源文档inbox数组中的participant字段      foreignField: "_id",            // 目标集合的_id字段      as: "participants",             // 关联结果的输出字段名      pipeline: [        { $project: {first_name: 1, last_name: 1, _id: 1}} // 仅投影所需字段      ]    }  },  {    // 第二步:使用 $set 阶段修改 participants 数组    $set: {      participants: {        // 使用 $map 遍历 participants 数组中的每个元素        $map: {          input: "$participants", // 待遍历的数组          as: "participant",      // 遍历时当前元素的别名          in: {            // 使用 $mergeObjects 将当前参与者对象与 added_at 字段合并            $mergeObjects: [              "$$participant", // 当前参与者对象              {                // 查找对应的 added_at 值                added_at: {                  // 使用 $arrayElemAt 获取指定索引处的元素                  $arrayElemAt: [                    "$inbox.added_at", // 从原始 inbox.added_at 数组中取值                    {                      // 使用 $indexOfArray 查找当前 participant 的 _id 在 inbox.participant 数组中的索引                      $indexOfArray: ["$inbox.participant", "$$participant._id"]                    }                  ]                }              }            ]          }        }      }    }  }])

解释步骤:

$lookup 阶段:

此阶段首先执行标准的左外连接,将User文档的inbox.participant字段与Users集合的_id字段进行匹配。pipeline子句用于在连接时对匹配到的文档进行预处理,这里我们只保留了_id、first_name和last_name。结果存储在名为participants的新数组字段中。

$set 阶段:

此阶段用于创建一个新的participants字段,其值是通过对现有participants数组进行转换得到的。$map 操作符:它用于遍历$lookup生成的participants数组中的每一个对象。input: “$participants”:指定要迭代的数组。as: “participant”:定义一个变量$$participant,代表当前迭代到的数组元素。in: {…}:定义对每个元素执行的操作。$mergeObjects 操作符:它用于将多个文档合并成一个文档。”$$participant”:表示当前迭代到的原始参与者对象(例如{ _id: “1xxxxx”, first_name: “John”, last_name:”Doe”})。第二个参数是一个新创建的对象{ added_at: … },其中包含我们希望添加的added_at字段。added_at 值的获取:这是整个解决方案的关键。$indexOfArray: [“$inbox.participant”, “$$participant._id”]:这个表达式首先在原始文档的inbox.participant数组中查找当前$$participant._id的索引位置。这假设inbox.participant数组和inbox.added_at数组是并行且顺序对应的。$arrayElemAt: [“$inbox.added_at”, index]:一旦获取到正确的索引,$arrayElemAt就从原始文档的inbox.added_at数组中取出该索引位置的added_at值。

预期输出

经过上述聚合管道处理后,最终的文档结构将包含带有added_at字段的participants数组,满足了原始需求:

{  "_id": ObjectId("123456789xx"),  "first_name": "Sam",  "last_name": "Jones",  "email": "sam.jones@example.com",  "inbox": [...], // 原始inbox数组  "participants": [    { "_id": ObjectId("1xxxxx"), "first_name": "John", "last_name":"Doe", "added_at": "12:00:00 09/21/2021"},    { "_id": ObjectId("2xxxxx"), "first_name": "Jack", "last_name": "Smith", "added_at": "12:00:00 11/21/2022"}  ]}

注意事项

数组并行性:此解决方案依赖于inbox.participant数组和inbox.added_at数组在索引上的严格对应关系。如果这两个数组的元素顺序不一致或数量不匹配,那么$indexOfArray和$arrayElemAt的组合可能无法正确匹配数据。性能考量:对于非常大的inbox数组,$map和内部的数组操作可能会有性能开销。在大多数实际应用中,inbox数组通常不会非常庞大,因此这种方法是高效且可行的。数据模型优化:在某些情况下,如果added_at是participant的固有属性,并且participant本身就是一个文档,那么在设计数据模型时,可以直接将added_at嵌入到inbox数组的participant子文档中,从而简化查询。但对于已有的数据模型,上述聚合方法提供了一个灵活的解决方案。

总结

通过巧妙地结合$lookup的管道功能与后续的$set阶段,并利用$map、$mergeObjects、$indexOfArray和$arrayElemAt等强大的数组操作符,我们能够在MongoDB中实现复杂的文档转换和数据关联。这种方法不仅解决了将本地数组字段与关联数据合并的问题,也展示了MongoDB聚合框架在处理复杂数据转换方面的强大能力和灵活性。掌握这些技巧对于构建高效且功能丰富的MongoDB应用至关重要。

以上就是MongoDB $lookup聚合中关联本地数组字段的技巧的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1511407.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
优化React组件:如何在弹出层中精确展示单个项目数据
上一篇 2025年12月20日 06:33:09
MongoDB:在 $lookup 管道中使用 localField 添加字段
下一篇 2025年12月20日 06:33:16

相关推荐

  • Debian邮件服务器SSL证书安装方法

    在debian邮件服务器上安装ssl证书的步骤如下: 1. 安装OpenSSL工具包 首先,确保你的系统上已经安装了OpenSSL工具包。如果没有安装,可以使用以下命令进行安装: sudo apt-get updatesudo apt-get install openssl 2. 生成私钥和证书请求…

    2026年9月26日
    100
  • 多模态AI如何识别特殊符号 多模态AI符号理解能力解析

    多模态AI如何识别特殊符号 多模态AI符号理解能力解析多模态AI如何识别特殊符号 多模态AI符号理解能力解析多模态AI如何识别特殊符号 多模态AI符号理解能力解析多模态AI如何识别特殊符号 多模态AI符号理解能力解析

    多模态ai理解特殊符号主要依靠数据训练与上下文分析。首先,它通过大规模标注数据学习符号在不同场景中的常见用法,例如社交媒体中的“@”或“#”;其次,结合图像和文本的上下文进行语义推理,判断如“$”是货币单位还是情绪表达;最后,借助ocr与视觉特征识别图像中的符号,并通过跨模态联合建模提升准确性。 ☞…

    2026年9月26日 • 用户投稿
    800
  • NVIDIA RTX 4090是不是性能过剩了?

    RTX 4090是否性能过剩取决于用途:1. 游戏方面,在主流游戏如《守望先锋2》《赛博朋克2077》中性能明显溢出,多数玩家难以用满其能力;2. 生产力领域,凭借24GB显存和强大算力,它在AI训练、3D渲染等任务中仍具价值;3. 技术体验上,DLSS 3、Reflex等技术提供低延迟与未来兼容性…

    2026年9月26日
    1200
  • Debian OpenSSL如何进行数字签名验证

    在debian系统上使用openssl进行数字签名验证,可以按照以下步骤操作: 准备工作 安装OpenSSL:确保你的Debian系统已经安装了OpenSSL。如果没有安装,可以使用以下命令进行安装: sudo apt updatesudo apt install openssl 获取公钥:数字签名…

    2026年9月26日
    600
  • Claude是否能用于编写剧本 AI生成剧情内容的能力与使用体验

    Claude是否能用于编写剧本 AI生成剧情内容的能力与使用体验Claude是否能用于编写剧本 AI生成剧情内容的能力与使用体验Claude是否能用于编写剧本 AI生成剧情内容的能力与使用体验Claude是否能用于编写剧本 AI生成剧情内容的能力与使用体验

    本文将围绕利用AI工具进行剧本创作这一问题展开探讨。文章会首先介绍AI在剧情生成方面的核心能力,接着通过详细的步骤讲解,指导用户如何借助AI工具进行剧本的构思、撰写与优化,从而让用户了解整个操作流程。最后,会结合实际使用体验,分析其在创作过程中的优势与需要注意的方面,帮助创作者更有效地利用这一技术。…

    2026年9月26日 • 用户投稿
    700
  • 《流放之路2》国服98元起 9月11日开启不删档测试

    《流放之路2》国服98元起 9月11日开启不删档测试《流放之路2》国服98元起 9月11日开启不删档测试《流放之路2》国服98元起 9月11日开启不删档测试《流放之路2》国服98元起 9月11日开启不删档测试

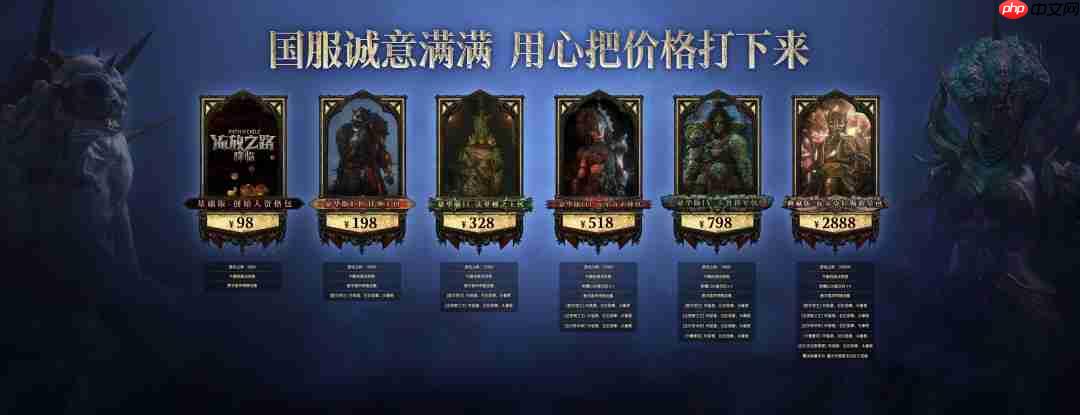
    《流放之路2》国服名为《流放之路:降临》,定价从98元起,豪华版分为四个档次,价格区间为198元至798元,另有典藏版售价2888元。目前游戏已在腾讯wegame平台开启预购,国服预充值不删档测试定于2025年9月11日正式开启! 98元“基础创始人资格包”包含9800点券、测试资格以及数字原声带。…

    2026年9月26日 • 用户投稿
    400
  • sublime如何安装monokai pro主题_sublime Monokai Pro主题安装教程

    sublime如何安装monokai pro主题_sublime Monokai Pro主题安装教程sublime如何安装monokai pro主题_sublime Monokai Pro主题安装教程sublime如何安装monokai pro主题_sublime Monokai Pro主题安装教程sublime如何安装monokai pro主题_sublime Monokai Pro主题安装教程

    确保安装Package Control,通过官网获取代码在Sublime控制台运行;2. 使用Ctrl+Shift+P打开命令面板,通过Package Control搜索并安装Monokai Pro;3. 再次打开命令面板选择“Monokai Pro: Activate Theme”启用主题,或手动…

    2026年9月26日 • 用户投稿
    200
  • MySQL中窗口函数用法 窗口函数在数据分析中的实际案例

    窗口函数是在一组数据行上执行计算并为每一行返回一个值的函数。它与普通聚合函数不同,保留原始数据行并进行行级计算。常见函数包括row_number()、rank()、dense_rank()以及结合over()使用的sum()、avg()等。例如,在计算销售排名时,使用rank() over(orde…

    2026年9月26日
    000
  • 蓝猫 AI 如何生成复古风图标?蓝猫 AI 复古风图标生图全解析

    蓝猫 AI 如何生成复古风图标?蓝猫 AI 复古风图标生图全解析蓝猫 AI 如何生成复古风图标?蓝猫 AI 复古风图标生图全解析蓝猫 AI 如何生成复古风图标?蓝猫 AI 复古风图标生图全解析蓝猫 AI 如何生成复古风图标?蓝猫 AI 复古风图标生图全解析

    蓝猫ai生成复古风图标的关键在于理解复古核心元素并精准控制生成过程。首先需准备不同时期复古图标数据集并进行风格训练,如8-bit游戏、早期网页设计等;其次通过关键词引导与风格控制,如使用“8-bit pixel art icon”等描述,并提供色彩饱和度、线条粗细等参数调整;第三步可在生成后添加噪点…

    2026年9月26日 • 用户投稿
    100
  • Java中高效校验字节数组半字节(Nibble)值是否超限的技巧

    Java中高效校验字节数组半字节(Nibble)值是否超限的技巧Java中高效校验字节数组半字节(Nibble)值是否超限的技巧Java中高效校验字节数组半字节(Nibble)值是否超限的技巧Java中高效校验字节数组半字节(Nibble)值是否超限的技巧

    本文探讨了在Java中如何高效地检查字节数组中每个字节的两个半字节(nibble)是否都小于等于9。通过比较分析常见的校验方法,重点介绍了利用位运算符进行优化的解决方案,该方法避免了昂贵的算术运算和字符串转换,从而显著提升了性能,适用于需要快速验证字节数据格式的场景。 1. 问题背景与挑战 在处理字…

    2026年9月26日 • 用户投稿
    000
  • 用豆包AI实现Python内存管理优化

    用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化用豆包AI实现Python内存管理优化

    豆包ai可通过分析内存使用模式、优化数据结构与对象创建、辅助编写内存友好代码帮助python内存管理优化。1. 发送代码片段给豆包ai,询问潜在内存问题,如循环引用或缓存未释放,并获得使用gc模块或弱引用的建议;2. 让豆包ai识别低效对象创建和不恰当数据结构,推荐生成器、itertools函数、节…

    2026年9月26日 • 用户投稿
    000
  • 如何在Debian中自定义GitLab界面

    在debian中自定义gitlab界面可以通过以下几种方式进行: 更改界面语言为中文 登录GitLab并进入设置:打开浏览器,访问GitLab的URL。使用管理员账号登录。点击右上角的用户头像,选择“Settings”(设置)。修改用户界面语言:在左侧导航栏中找到“Preferences”(偏好设置…

    2026年9月26日
    100
  • OpenAI 连丢 4 位大将!Ilya 合作者 /o1 核心贡献者加入 Meta,苏黎世三人组回应跳槽:集体做出的选择

    OpenAI 连丢 4 位大将!Ilya 合作者 /o1 核心贡献者加入 Meta,苏黎世三人组回应跳槽:集体做出的选择OpenAI 连丢 4 位大将!Ilya 合作者 /o1 核心贡献者加入 Meta,苏黎世三人组回应跳槽:集体做出的选择OpenAI 连丢 4 位大将!Ilya 合作者 /o1 核心贡献者加入 Meta,苏黎世三人组回应跳槽:集体做出的选择OpenAI 连丢 4 位大将!Ilya 合作者 /o1 核心贡献者加入 Meta,苏黎世三人组回应跳槽:集体做出的选择

    扎克伯格似乎确实对奥特曼格外关注! 又有 OpenAI 的核心研究员被 Meta 挖走,而这次涉及的正是最前沿的推理大模型领域。 最新一位加入 Meta 的是 Trapit Bansal,他在 2022 年进入 OpenAI,并与 Ilya 展开了合作,在大模型强化学习研究的启动阶段发挥了重要作用,…

    2026年9月26日 • 用户投稿
    100
  • Debian Hadoop资源隔离如何实现

    在debian上实现hadoop资源隔离主要通过**yarn的cgroups(control groups)**来进行资源管理和隔离。以下是具体的实现方式: cgroups资源隔离 概述:Hadoop YARN使用cgroups进行资源管理和隔离。cgroups是Linux内核提供的一种机制,用于限…

    2026年9月26日
    000
  • SnakeYAML映射List类型:正确配置Java类以避免转换错误

    SnakeYAML映射List类型:正确配置Java类以避免转换错误SnakeYAML映射List类型:正确配置Java类以避免转换错误SnakeYAML映射List类型:正确配置Java类以避免转换错误SnakeYAML映射List类型:正确配置Java类以避免转换错误

    本文深入探讨了使用SnakeYAML库将YAML文件中的List对象映射到Java类时可能遇到的问题。重点介绍了当YAML结构包含复杂对象列表时,如何正确定义Java类以确保数据能够被精确解析和绑定,从而避免常见的类型转换错误。通过实例代码和注意事项,帮助开发者掌握SnakeYAML处理列表的正确姿…

    2026年9月26日 • 用户投稿
    100
  • 使用SnakeYAML正确映射YAML中的列表对象

    使用SnakeYAML正确映射YAML中的列表对象使用SnakeYAML正确映射YAML中的列表对象使用SnakeYAML正确映射YAML中的列表对象使用SnakeYAML正确映射YAML中的列表对象

    本文详细介绍了在使用SnakeYAML库将YAML文件映射到Java对象时,如何正确处理和转换包含列表(List)类型的复杂数据结构。通过提供清晰的类定义和YAML配置示例,帮助开发者避免常见错误,确保列表对象能够被精确地序列化和反序列化。 1. SnakeYAML简介与基本用法 snakeyaml…

    2026年9月26日 • 用户投稿
    100
  • 《消逝的光芒:困兽》彩蛋众多!战神之斧、哈利波特关卡等

    《消逝的光芒:困兽》彩蛋众多!战神之斧、哈利波特关卡等《消逝的光芒:困兽》彩蛋众多!战神之斧、哈利波特关卡等《消逝的光芒:困兽》彩蛋众多!战神之斧、哈利波特关卡等《消逝的光芒:困兽》彩蛋众多!战神之斧、哈利波特关卡等

    现在入手《消逝的光芒:困兽》正当时,使用金币抵扣并领取专属优惠券后可享折上折,标准版仅需200.9元(立省47.1元),豪华版也低至233.2元(节省54.8元)! 由Techland倾力打造的生存恐怖新作《消逝的光芒:困兽》已正式上线,游戏一经发布便引发玩家热烈探索,大量隐藏彩蛋与神秘内容陆续被挖…

    2026年9月26日 • 用户投稿
    000
  • 行业首款!卡萨帝-60℃超低温低噪冰柜上市

    行业首款!卡萨帝-60℃超低温低噪冰柜上市行业首款!卡萨帝-60℃超低温低噪冰柜上市行业首款!卡萨帝-60℃超低温低噪冰柜上市行业首款!卡萨帝-60℃超低温低噪冰柜上市

    9月27日,主题为“智由ai起,艺从东方来”的卡萨帝c生活场景全系引领发布会盛大开启。会上,卡萨帝正式推出行业首款-60℃超低温低噪冰柜,凭借前沿原创科技突破家用冷冻技术壁垒,为高端珍稀食材的储存提供了全新方案。 此次发布的卡萨帝-60℃超低温冰柜,精准回应了消费升级趋势下的用户需求。依托国际高端家…

    2026年9月26日 • 用户投稿
    300
  • VSCode如何自定义主题和配色方案 VSCode主题与配色方案的个性化设置

    vscode自定义主题和配色方案的核心是通过内置主题、扩展主题和修改settings.json实现个性化;2. 可通过”workbench.colorcustomizations”自定义ui颜色,”editor.tokencolorcustomizations&#…

    2026年9月26日
    200
  • sublime侧边栏太宽怎么调_sublime侧边栏宽度调整教程

    sublime侧边栏太宽怎么调_sublime侧边栏宽度调整教程sublime侧边栏太宽怎么调_sublime侧边栏宽度调整教程sublime侧边栏太宽怎么调_sublime侧边栏宽度调整教程sublime侧边栏太宽怎么调_sublime侧边栏宽度调整教程

    答案:通过修改主题配置文件可调整Sublime Text侧边栏宽度。打开Default.sublime-theme文件,找到”sidebar_container”的content_margin设置,将左右边距数值调小(如[8, 16]),保存后立即生效,能扩大代码编辑区域;使…

    2026年9月26日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信