Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
将扁平化JSON数据转换为多级嵌套结构:JavaScript实现指南_创想鸟

将扁平化JSON数据转换为多级嵌套结构:JavaScript实现指南

将扁平化json数据转换为多级嵌套结构:javascript实现指南

本教程详细介绍了如何将包含层级信息的扁平化JSON数组转换为具有多级嵌套(subNav)结构的JSON对象。通过迭代处理数据并利用一个映射表追踪每个层级的最新节点,我们可以高效地构建出复杂的树形结构,从而实现数据的清晰组织和展示。

1. 理解问题:扁平化数据与目标结构

在前端开发或数据处理中,我们经常会遇到需要将扁平化数组转换为具有层级关系的数据结构。假设我们有一个JSON数组,其中每个对象都包含一个metaData.level属性,表示其在层级结构中的深度:

const content = [  { title: "Item 1", metaData: { "level": 1, "desc": "Some Desc 1", "displayOnOverview": true }},  { title: "Item 2", metaData: { "level": 2, "desc": "Some Desc 2", "displayOnOverview": true }},  { title: "Item 3", metaData: { "level": 2, "desc": "Some Desc 3", "displayOnOverview": false }},  { title: "Item 4", metaData: { "level": 3, "desc": "Some Desc 4", "displayOnOverview": true }},  { title: "Item 5", metaData: { "level": 1, "desc": "Some Desc 5", "displayOnOverview": true }}];

我们的目标是将其转换为一个嵌套的JSON结构,其中子项通过subNav属性连接,如下所示:

[  {    "title": "Item 1",    "metaData": {      "level": 1,      "desc": "Some Desc 1",      "displayOnOverview": true    },    "subNav": [      {        "title": "Item 2",        "metaData": {          "level": 2,          "desc": "Some Desc 2",          "displayOnOverview": true        }      },      {        "title": "Item 3",        "metaData": {          "level": 2,          "desc": "Some Desc 3",          "displayOnOverview": false        },        "subNav": [          {            "title": "Item 4",            "metaData": {              "level": 3,              "desc": "Some Desc 4",              "displayOnOverview": true            }          }        ]      }    ]  },  {    "title": "Item 5",    "metaData": {      "level": 1,      "desc": "Some Desc 5",      "displayOnOverview": true    }  }]

直接通过数组索引判断父子关系(如root[index – 1])在多级嵌套中是不可行的,因为它无法准确追踪任意深度的父节点。我们需要一种更灵活的机制来识别并连接父子节点。

2. 核心思路:父节点追踪与层级映射

解决这个问题的关键在于,在遍历扁平化数组时,我们需要能够快速找到当前项的直接父节点。由于层级关系由metaData.level定义,我们可以维护一个映射表来存储每个层级的“最新”父节点。

立即学习“Java免费学习笔记(深入)”;

具体步骤如下:

初始化结果数组:用于存放所有顶层(level: 1)的节点。初始化层级映射表 (itemMap):这是一个对象,键是层级(例如1, 2, 3),值是该层级的最新节点对象。当处理一个level为N的项时,itemMap[N-1]将指向其父节点。遍历扁平化数组:对每个元素执行以下操作:创建新节点:复制当前项的title和metaData到新节点,以便后续添加subNav。判断层级:如果metaData.level为1,则该项是顶层节点,直接添加到结果数组中。如果metaData.level大于1,则计算其父级parentLevel(即currentLevel – 1)。从itemMap中获取parentLevel对应的父节点。如果父节点尚未有subNav属性,则初始化一个空数组。将当前新节点添加到父节点的subNav数组中。更新层级映射表:将当前新节点存储到itemMap[metaData.level]中。这样做是为了确保后续更深层级的子节点能够找到正确的直接父节点。

3. 实现代码示例

以下是使用JavaScript实现上述逻辑的完整代码:

const content = [  { title: "Item 1", metaData: { "level": 1, "desc": "Some Desc 1", "displayOnOverview": true }},  { title: "Item 2", metaData: { "level": 2, "desc": "Some Desc 2", "displayOnOverview": true }},  { title: "Item 3", metaData: { "level": 2, "desc": "Some Desc 3", "displayOnOverview": false }},  { title: "Item 4", metaData: { "level": 3, "desc": "Some Desc 4", "displayOnOverview": true }},  { title: "Item 5", metaData: { "level": 1, "desc": "Some Desc 5", "displayOnOverview": true }}];/** * 将扁平化JSON数组转换为基于level属性的多级嵌套结构。 * @param {Array} data 包含level属性的扁平化数据数组。 * @returns {Array} 转换后的嵌套结构数组。 */function buildNestedStructure(data) {  const topLevelItems = []; // 存储所有顶层(level 1)的节点  const itemMap = {};       // 映射表,键为层级,值为该层级的最新节点  for (const item of data) {    const { title, metaData } = item;    // 创建一个新对象,包含title和完整的metaData,避免直接修改原始数据    const newItem = { title, metaData };     if (metaData.level === 1) {      // 如果是顶层节点,直接添加到结果数组      topLevelItems.push(newItem);    } else {      // 如果是子节点,找到其父节点      const parentLevel = metaData.level - 1;      const parentItem = itemMap[parentLevel]; // 从映射表中获取父节点      if (!parentItem) {        // 理论上不应该发生,除非数据顺序不正确(如level 2出现在level 1之前)        console.warn(`Warning: Parent for level ${metaData.level} not found. Item:`, item);        continue;       }      // 如果父节点还没有 subNav 数组,则初始化      if (!parentItem.subNav) {        parentItem.subNav = [];      }      // 将当前节点添加到父节点的 subNav 中      parentItem.subNav.push(newItem);    }    // 更新 itemMap,将当前节点设置为其所在层级的最新节点    // 这样,后续同一层级或更深层级的节点可以找到正确的父节点    itemMap[metaData.level] = newItem;  }  return topLevelItems;}const output = buildNestedStructure(content);console.log(JSON.stringify(output, null, 2));

4. 代码解析

topLevelItems = []: 这个数组将保存最终输出的根节点。所有level: 1的项都会直接添加到这里。itemMap = {}: 这是算法的核心。它是一个哈希表(JavaScript对象),用于存储每个层级(level)的最后一个处理过的节点。当处理一个level为N的节点时,如果它是level: 1,它会被添加到topLevelItems。如果它是level: N > 1,它的父节点应该是level: N-1的某个节点。itemMap[N-1]会保存我们最近处理过的level: N-1的节点,这正是我们需要的父节点。处理完当前节点后,无论其level是多少,我们都会用它来更新itemMap[metaData.level]。这意味着,如果后续出现与当前节点同级或更深级的节点,它们将能够正确地找到父节点。for (const item of data): 遍历输入的扁平化数组。const newItem = { title, metaData };: 创建一个新对象。这里直接复制了原始的title和metaData,确保desc和displayOnOverview等额外属性也得以保留。if (metaData.level === 1): 如果当前项是顶层节点,直接将其添加到topLevelItems。else { … }: 如果是子节点:parentLevel = metaData.level – 1;: 确定父节点的层级。parentItem = itemMap[parentLevel];: 从itemMap中获取对应的父节点。if (!parentItem.subNav) { parentItem.subNav = []; }: 如果父节点还没有subNav数组,就创建一个。parentItem.subNav.push(newItem);: 将当前节点添加到父节点的subNav中。itemMap[metaData.level] = newItem;: 关键步骤。将当前处理的newItem存入itemMap,以其metaData.level作为键。这样,如果后续有同级或更深层级的节点,它就能成为它们的父节点。

5. 注意事项与扩展

数据顺序:此方法假设输入数据是按层级顺序组织的,即一个父节点总是出现在其所有子节点之前。如果数据顺序混乱(例如,level: 2的节点出现在其level: 1的父节点之前),itemMap[parentLevel]可能无法找到正确的父节点,导致结构错误或警告。错误处理:在parentItem = itemMap[parentLevel];之后,可以添加更健壮的错误检查,例如if (!parentItem) { throw new Error(“Parent item not found for level ” + metaData.level); },以处理数据结构不一致的情况。性能:该算法对输入数组进行了一次遍历,时间复杂度为O(N),其中N是数组的长度,效率较高。灵活性:如果嵌套属性名(如subNav)或层级属性名(如metaData.level)可能变化,可以将它们作为参数传递给函数,提高代码的通用性。深拷贝:示例中newItem = { title, metaData }是浅拷贝了metaData对象。如果需要确保metaData在后续操作中不会影响原始item,可以使用JSON.parse(JSON.stringify(item))或structuredClone(item)进行深拷贝。

6. 总结

通过维护一个层级映射表,我们可以有效地将扁平化的JSON数组转换为任意深度的嵌套结构。这种方法既高效又灵活,是处理此类数据转换问题的常用模式。理解itemMap在追踪父节点和更新当前层级最新节点方面的作用,是掌握这一技巧的关键。

以上就是将扁平化JSON数据转换为多级嵌套结构:JavaScript实现指南的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1527889.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫


将扁平化的 JSON 数据转换为嵌套结构的 JSON
上一篇 2025年12月20日 19:48:40
Vue 3 v-if 不生效?深入理解响应式数据与 ref 的使用
下一篇 2025年12月20日 19:48:48

相关推荐

  • MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能

    MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能MySQL热点数据缓存策略_MySQL减少磁盘访问提升性能

    mysql热点数据缓存的核心在于将频繁访问的数据保留在内存中以减少磁盘i/o,提升查询速度并缓解数据库压力。1. innodb缓冲池是关键机制,需合理配置其大小(通常为服务器内存的70-80%)及实例数以优化性能;2. 应用层缓存如redis/memcached通过前置缓存逻辑减少对mysql的直接…

    2026年9月21日 • 用户投稿
    000
  • Laravel 8 登录后重定向到仪表盘的完整教程

    本教程详细介绍了在 Laravel 8 中实现用户登录后重定向到仪表盘的多种方法。我们将探讨如何利用 Laravel 内置的 $redirectTo 属性,以及如何通过重写 LoginController 中的 login 方法来实现自定义重定向逻辑。此外,教程还将重点讲解正确的路由配置和中间件使用…

    2026年9月21日
    000
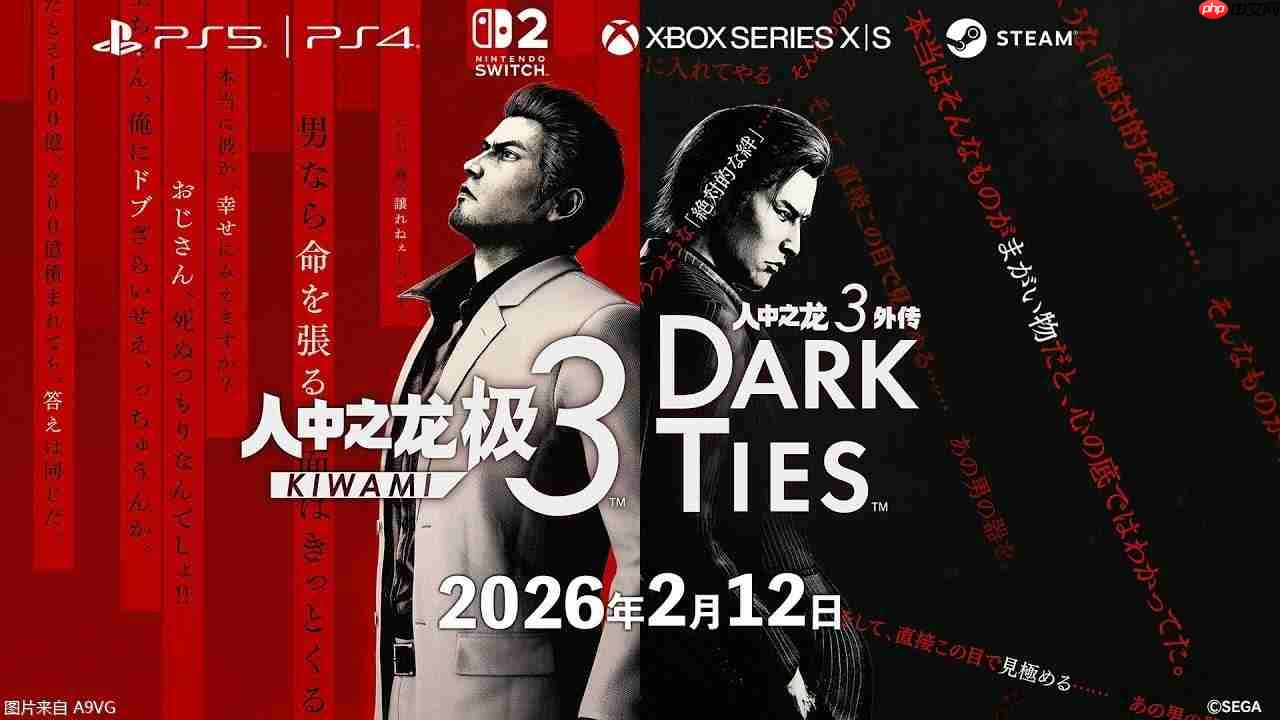
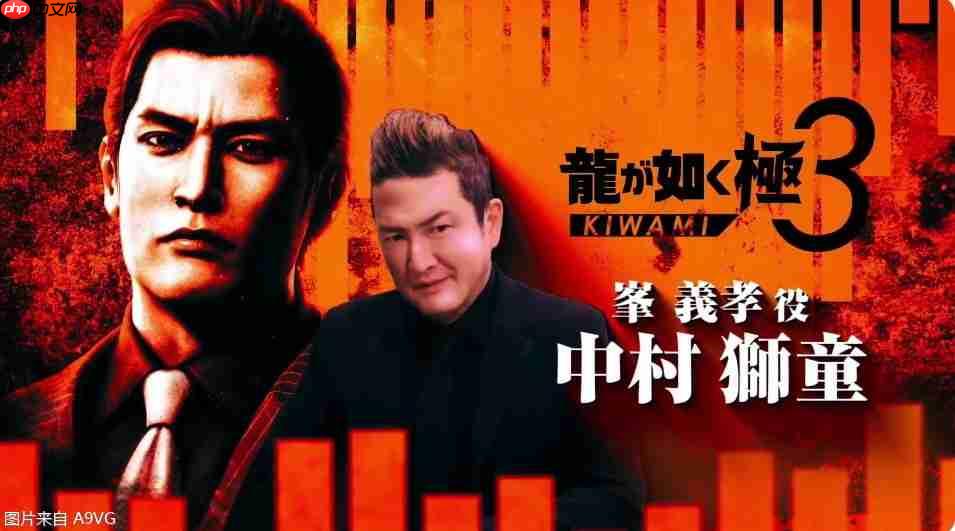
  • 《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表

    《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表《如龙 极3》与峰义孝为主角《如龙3外传》等新情报发表

    世嘉公开《如龙极3/如龙3外传  dark ties》官方中文版预告宣传片,将于2026年2月12日发售 ​​​​,登陆ps5/ps4/switch2/xbox/pc平台,全球同步推出。 ​​​ 在2009年于PS3平台发售的《如龙3》焕然重生,为您打造“极致体验”。鲜活真实的冲绳街景、震撼力升级的…

    2026年9月21日 • 用户投稿
    000
  • safari浏览器怎么把标签页固定在最左边_safari浏览器标签页固定最左设置

    Safari可通过“固定标签”功能将常用网页保持在标签栏最左并随启动恢复;2. 手动拖动标签至最左可临时调整顺序但不永久保存;3. 结合书签栏添加常用网站并固定标签,可提升访问效率。 如果您希望在使用 Safari 浏览器时将常用网页始终保持在标签栏的最左侧位置,以便快速访问,可以通过以下方法实现标…

    2026年9月21日
    000
  • 使用本地HTML文件运行JavaScript脚本失败的原因及解决方案

    本文旨在帮助开发者理解在没有Web服务器的情况下,直接通过浏览器打开本地HTML文件时,JavaScript脚本可能无法正常运行的原因,并提供相应的解决方案。文章将深入探讨浏览器安全策略、相对路径问题以及如何正确引入和执行JavaScript脚本,确保你的HTML、CSS和JavaScript代码能…

    2026年9月21日
    000
  • PHP一键环境如何配置URL重写_URL Rewrite规则设置

    开启Apache的mod_rewrite模块并配置AllowOverride All,再在.htaccess中添加重写规则,即可实现URL重写,使URL更简洁利于SEO。 在使用PHP一键环境(如XAMPP、WAMP、phpStudy等)时,开启URL重写(URL Rewrite)功能可以让网站的U…

    2026年9月21日
    100
  • 使用正则表达式检测字符串中的除零操作

    本文详细介绍了如何使用正则表达式精确检测字符串中潜在的除零操作。针对表达式中可能存在的变量引用(如<>)、数字、多余空格以及禁止包含引号等复杂情况,文章提供了一个高效的正则表达式模式,并深入解析其构成原理。通过具体的Java代码示例,读者将学习如何将此模式应用于实际编程场景,从而有效识别…

    2026年9月21日
    000
  • 构建Spring自定义Kafka配置的注解式解决方案

    本文探讨了在Spring Boot应用中通过自定义注解实现Kafka配置自动化时遇到的挑战,特别是由于Bean注册时机不当导致的依赖注入失败。我们将深入分析问题根源,并提供两种核心解决方案:利用META-INF/spring.factories实现标准化的自动配置发现,以及通过ImportBeanD…

    2026年9月21日
    1100
  • 悟空浏览器开发者工具的控制台怎么用_悟空浏览器Console控制台使用入门教程

    首先启用悟空浏览器开发者工具并进入Console标签,可查看错误、警告等日志信息,通过过滤功能定位问题;支持执行JavaScript代码实时调试,监控网络请求失败及全局异常,还可清空或保存日志以便分析。 如果您在使用悟空浏览器进行网页开发或调试时,发现页面元素未按预期工作或脚本报错,则可以借助开发者…

    2026年9月21日
    700
  • SpringBoot的定时任务

    SpringBoot的定时任务SpringBoot的定时任务SpringBoot的定时任务SpringBoot的定时任务

    大家好,我是你们的老朋友全栈君。我们又见面了。 一、基于注解(@Scheduled)的定时任务 使用SpringBoot的@Scheduled注解来创建定时任务非常简单,只需几行代码就能实现。然而,@Scheduled默认是单线程运行,这意味着当启动多个任务时,一个任务的执行时间可能会影响到下一个任…

    2026年9月21日 • 用户投稿
    400
  • 实现搜索结果的 A-Z 排序:PHP 教程

    本文档旨在指导开发者如何在 PHP 中实现搜索结果的 A-Z 排序功能。通过结合 AJAX 技术和 PHP 函数,可以方便地对通过 POST 方法获取的医生搜索结果进行 A-Z 排序,从而优化用户浏览体验。本文将详细介绍实现步骤,提供可复用的代码示例,并着重强调注意事项,旨在帮助开发者快速掌握并应用…

    2026年9月21日
    000
  • HuggingFace的AI混合工具如何使用?开发AI模型的实用操作教程

    HuggingFace的AI混合工具核心在于其生态系统设计,通过Transformers库的统一接口、Pipelines的抽象封装、Datasets与Accelerate等工具,实现多模型组合与微调。它允许开发者将复杂任务拆解,利用预训练模型如BERT、T5等,通过Python逻辑串联不同Pipel…

    2026年9月21日
    1000
  • Java中高效查找时空事件重叠的方法

    本文探讨了在Java中高效查找具有空间和时间范围定义的事件之间重叠的解决方案。核心思想是将时空事件编码为二维矩形,然后利用专业的空间索引结构(如R树、四叉树或PH树)进行快速查询。通过这种方法,可以显著提升在大规模数据集中识别事件重叠的效率,并提供了使用Tinspin索引库的示例代码和实践建议。 时…

    2026年9月21日
    000
  • PHPComposer怎么安装_PHPComposer依赖管理工具安装与使用指南

    PHPComposer是PHP的依赖管理工具,类似npm或pip。需先安装PHP,再下载并验证composer-setup.php,执行安装生成composer.phar,推荐全局安装至/usr/local/bin/composer,运行composer –version验证。使用com…

    2026年9月21日
    000
  • MySQL如何处理长时间运行的查询_避免数据库阻塞?

    MySQL如何处理长时间运行的查询_避免数据库阻塞?MySQL如何处理长时间运行的查询_避免数据库阻塞?MySQL如何处理长时间运行的查询_避免数据库阻塞?MySQL如何处理长时间运行的查询_避免数据库阻塞?

    诊断mysql慢查询需1.开启慢查询日志并设置long_query_time;2.使用explain分析sql执行情况;3.借助工具如pt-query-digest分析日志。优化涉及1.确保join字段有索引;2.优化join顺序及减少join表数;3.使用临时表、批量处理和数据分区。防止阻塞应1.…

    2026年9月21日 • 用户投稿
    000
  • 使用EventBus实现Android实时速度显示与后台保存教程

    本教程详细介绍了如何在Android应用中实现实时速度的显示与后台保存功能。通过利用前台服务(Foreground Service)获取位置数据,并结合EventBus库实现服务与UI界面(MainActivity)之间的实时数据通信,确保即使应用处于后台或屏幕关闭时,速度数据也能持续更新并显示在用…

    2026年9月21日
    000
  • laravel如何进行安全的SQL查询以防止注入_Laravel安全SQL查询防注入方法

    使用Eloquent和Query Builder并配合参数绑定可有效防止SQL注入。Laravel通过PDO预处理机制自动转义参数,确保安全;应避免拼接用户输入,尤其在whereRaw等原生语句中需使用?占位符绑定变量;所有用户输入均需验证,对ID类字段强制类型转换,并禁止将用户输入直接用于表名、字…

    2026年9月21日
    000
  • 在Java中如何分析异常堆栈性能开销

    异常堆栈在高并发场景下开销显著,因JVM需遍历调用栈、创建对象、字符串拼接及同步操作,频繁使用将增加GC压力与CPU消耗;可通过JMH测试量化影响,发现填充堆栈耗时可达清空的10倍以上;建议避免在热点代码抛异常、禁用非必要堆栈填充、按需打印日志、使用异步日志框架,并借助JFR、Profiler和GC…

    2026年9月21日
    000
  • PHP/MySQL:高效合并订单商品并按日期分组显示

    本教程将指导如何在PHP/MySQL应用中,将同一日期的订单商品合并显示在同一行,以提高数据展示的清晰度。核心解决方案是利用MySQL的GROUP_CONCAT函数在数据库层面进行高效聚合,避免复杂的PHP逻辑处理,从而简化代码并优化性能。 订单数据展示的常见挑战 在开发在线购物平台时,通常需要向用…

    2026年9月21日
    100
  • 麒麟终于回归!华为明确公布手机处理器型号 国产芯片供应链实现全链路自主可控

    9月4日消息,华为正式揭晓麒麟9020芯片,现场气氛瞬间点燃! 今天下午14:30,华为在深圳隆重举行“Mate XTs 非凡大师及全场景新品发布会”,与以往不同的是,此次华为首次在发布会舞台公开宣布新一代三折叠旗舰手机搭载麒麟9020芯片,引发全场热烈反响。 据悉,上一次麒麟芯片亮相华为发布会还是…

    2026年9月21日
    200

发表回复

登录后才能评论
关注微信