Python BeautifulSoup:从复杂HTML元素中精准提取数值

Python BeautifulSoup:从复杂HTML元素中精准提取数值

本文旨在指导读者如何使用Python的BeautifulSoup库从复杂的HTML结构中准确提取数值,特别是当目标元素包含注释、货币符号或其他非数字字符时。文章将探讨div.text的基本用法,并提供处理实际网页抓取中可能遇到的多种情况的鲁棒性策略,包括检查元素存在性、过滤非数字字符以及适应不同的HTML结构,以确保提取数据的准确性和代码的稳定性。

引言:HTML文本提取的挑战

在进行网页抓取(web scraping)时,我们经常需要从html页面中提取特定的文本信息,例如商品价格、产品名称等。然而,实际的html结构往往比我们想象的要复杂。目标文本可能被包裹在带有特殊字符(如货币符号)、html注释()甚至是空白标签的元素中。例如,从以下html片段中提取纯数字“5”:

5

直接使用BeautifulSoup的text属性有时会包含不必要的字符,或者在特定情况下,如果元素未正确找到,甚至可能导致程序错误。因此,掌握鲁棒的文本提取和清洗方法至关重要。

BeautifulSoup text 属性基础

BeautifulSoup库在处理HTML时,element.text属性是一个非常方便的工具,它会递归地获取一个标签及其所有子孙标签中的文本内容,并将它们连接成一个字符串。对于上述示例,即使中间存在一个HTML注释,div.text通常也能正确地聚合文本内容。

from bs4 import BeautifulSouphtml_doc = '
5
'soup = BeautifulSoup(html_doc, 'html.parser')div_tag = soup.find('div', class_='DrugPriceBox__price___dj2lv')if div_tag: print(f"原始文本: {div_tag.text}") # 输出: 原始文本: ₹5else: print("未找到目标div标签。")

从上述输出可以看出,div.text成功地提取了“₹5”。然而,我们的目标通常是纯粹的数字“5”,这就需要进一步的数据清洗。

构建鲁棒的网页抓取器

为了在实际的网页抓取任务中更稳定、更准确地提取数据,我们需要考虑以下几个方面:

立即学习“Python免费学习笔记(深入)”;

1. 发送HTTP请求与请求头

直接访问网页时,许多网站会检查请求的User-Agent头信息,以识别请求来源是浏览器还是自动化脚本。为避免被网站阻断,建议在requests请求中模拟浏览器行为。

import requestsheaders = {    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124124 Safari/537.36'}# requests.get(url, headers=headers)

2. 元素查找与存在性检查

soup.find()或soup.select_one()方法在未找到匹配元素时会返回None。在尝试访问None对象的属性(如.text)时,程序会抛出AttributeError。因此,在提取文本之前,务必检查找到的元素是否为None。

# ... (soup已创建)element = soup.find('div', class_='some-class')if element:    # 安全地访问element.text    text_content = element.textelse:    print("目标元素未找到。")

3. 处理多种HTML结构

网站的HTML结构可能因A/B测试、版本更新或不同页面类型而有所不同。一个健壮的抓取器应该能够适应这些变化,尝试查找多种可能的元素结构。例如,价格信息可能有时在div中,有时在span中,且类名可能不同。

# 尝试查找第一种结构element1 = soup.find('div', class_='class-A')if element1:    price_text = element1.textelse:    # 如果第一种结构未找到,尝试查找第二种结构    element2 = soup.find('span', class_='class-B')    if element2:        price_text = element2.text    else:        price_text = "未找到价格信息"

4. 提取与清洗数值

获取到原始文本后,通常需要进一步清洗以提取纯粹的数字。这包括移除货币符号、空白字符以及任何非数字字符。可以使用Python的字符串方法结合isdigit()或正则表达式来实现。

import stringraw_price_text = "₹5.50" # 假设从element.text获得acceptable_chars = set(string.digits + '.') # 允许数字和小数点cleaned_price = ''.join(char for char in raw_price_text if char in acceptable_chars)print(f"清洗后的价格: {cleaned_price}") # 输出: 清洗后的价格: 5.50

完整示例代码

下面是一个结合了上述所有最佳实践的完整示例,用于从指定URL的网页中提取药品价格,并处理多种HTML结构和数据清洗:

import requestsfrom bs4 import BeautifulSoupimport string# 定义请求头,模拟浏览器访问headers = {    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124124 Safari/537.36'}def extract_price_from_url(url):    """    从指定URL的网页中提取药品价格。    尝试多种HTML结构并过滤非数字字符。    """    try:        # 发送HTTP请求并检查响应状态        response = requests.get(url, headers=headers, timeout=10)        response.raise_for_status()  # 如果状态码不是200,则抛出HTTPError异常    except requests.exceptions.RequestException as e:        print(f"请求URL失败: {url}, 错误: {e}")        return None    # 使用BeautifulSoup解析HTML内容    soup = BeautifulSoup(response.content, "html.parser")    price_text = None    # 尝试第一种div标签的定价格式    div_price_box = soup.find('div', class_='DrugPriceBox__price___dj2lv')    if div_price_box:        price_text = div_price_box.text    else:        # 如果div格式未找到,尝试第二种span标签的定价格式        # 注意:这里的类名来源于实际网页结构分析        span_price_box = soup.find('span', class_="PriceBoxPlanOption__margin-right-4___2aqFt PriceBoxPlanOption__stike___pDQVN")        if span_price_box:            price_text = span_price_box.text    if price_text:        # 过滤非数字字符,只保留数字和小数点,以便转换为浮点数        acceptable_chars = set(string.digits + '.')        cleaned_price = ''.join(char for char in price_text if char in acceptable_chars)        return cleaned_price    else:        return "未找到价格"if __name__ == '__main__':    # 示例URL,第一个URL对应div格式,第二个对应span格式    url1 = 'https://www.1mg.com/drugs/acticort-5mg-tablet-321932'    url2 = 'https://www.1mg.com/drugs/zerodol-sp-tablet-67307'    print(f"从 {url1} 提取价格:")    price1 = extract_price_from_url(url1)    print(f"提取到的价格: {price1}")    print(f"n从 {url2} 提取价格:")    price2 = extract_price_from_url(url2)    print(f"提取到的价格: {price2}")    # 假设一个不存在价格信息的页面    url_no_price = 'https://www.example.com'    print(f"n从 {url_no_price} 提取价格:")    price_no_price = extract_price_from_url(url_no_price)    print(f"提取到的价格: {price_no_price}")

注意事项与最佳实践

动态内容(JavaScript渲染): 如果目标数据是通过JavaScript在页面加载后动态生成的,BeautifulSoup将无法直接获取。此时,需要使用Selenium等工具来模拟浏览器行为,等待JavaScript执行完毕后再抓取内容。网站结构变化: 网页结构并非一成不变。网站更新可能导致类名、ID或标签结构发生变化,从而使抓取代码失效。定期检查并更新抓取逻辑是必要的。反爬机制: 频繁或异常的请求可能会触发网站的反爬机制,导致IP被封禁、出现验证码或返回错误信息。可以考虑使用代理IP池、设置请求延迟、限制请求频率等策略。合法合规: 在进行网页抓取前,务必查阅网站的robots.txt文件,了解允许抓取的范围。同时,遵守当地法律法规,尊重网站所有者的权益,避免对网站服务器造成过大负担。

总结

通过本文的介绍,我们学习了如何使用Python的BeautifulSoup库从包含特殊字符或注释的HTML元素中准确提取数值。关键在于理解element.text的工作原理,并通过引入请求头、进行元素存在性检查、适应多种HTML结构以及对提取到的文本进行清洗,来构建一个鲁棒且高效的网页抓取解决方案。遵循这些最佳实践,将大大提高您在实际网页抓取项目中的成功率和代码的稳定性。

以上就是Python BeautifulSoup:从复杂HTML元素中精准提取数值的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1578998.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

在React Redux应用中计算购物车商品总价的指南
上一篇 2025年12月22日 20:15:16
CSS技巧:实现父元素模糊而子元素清晰的布局
下一篇 2025年12月22日 20:15:28

相关推荐

  • 163邮箱官网手机免费入口 163免费邮箱移动登录

    163邮箱官网手机免费入口 163免费邮箱移动登录163邮箱官网手机免费入口 163免费邮箱移动登录163邮箱官网手机免费入口 163免费邮箱移动登录163邮箱官网手机免费入口 163免费邮箱移动登录

    163邮箱官网手机免费入口可通过访问mail.163.com自动跳转至移动版,或在应用商店下载“网易邮箱”App登录,支持多账号管理、邮件收发、附件添加、消息推送及多设备同步,并提供登录保护、主题自定义和垃圾邮件过滤等安全与个性化功能。 163邮箱官网手机免费入口在哪里?这是不少网友都关注的,接下来…

    2026年9月24日 用户投稿
    000
  • Chrome浏览器书签栏怎么一直显示_设置Chrome书签栏永久显示教程

    Chrome浏览器书签栏怎么一直显示_设置Chrome书签栏永久显示教程Chrome浏览器书签栏怎么一直显示_设置Chrome书签栏永久显示教程Chrome浏览器书签栏怎么一直显示_设置Chrome书签栏永久显示教程Chrome浏览器书签栏怎么一直显示_设置Chrome书签栏永久显示教程

    通过点击Chrome右上角三点菜单,选择“书签”>“显示书签栏”可恢复书签栏;2. 使用Ctrl+Shift+B(Windows)或Command+Shift+B(Mac)快捷键快速切换显示;3. 在设置页面的“外观”中确保“显示书签栏”设为“始终显示”;4. 若无效,可重置浏览器设置以恢复默…

    2026年9月24日 用户投稿
    000
  • sublime的session文件是做什么用的_sublime会话文件作用与恢复机制

    sublime的session文件是做什么用的_sublime会话文件作用与恢复机制sublime的session文件是做什么用的_sublime会话文件作用与恢复机制sublime的session文件是做什么用的_sublime会话文件作用与恢复机制sublime的session文件是做什么用的_sublime会话文件作用与恢复机制

    Sublime Text的session文件记录了打开的文件、光标位置、代码折叠状态、窗口布局及未保存内容等信息,位于系统特定目录下的Local文件夹中,以JSON格式存储,通过自动保存机制在重启后恢复编辑状态。 Sublime Text 的 session 文件主要用于保存用户当前编辑环境的状态信…

    2026年9月24日 用户投稿
    000
  • windows10的gpedit.msc组策略打不开_windows10组策略编辑器打不开修复方法

    windows10的gpedit.msc组策略打不开_windows10组策略编辑器打不开修复方法windows10的gpedit.msc组策略打不开_windows10组策略编辑器打不开修复方法windows10的gpedit.msc组策略打不开_windows10组策略编辑器打不开修复方法windows10的gpedit.msc组策略打不开_windows10组策略编辑器打不开修复方法

    首先检查系统文件完整性,运行sfc /scannow修复损坏文件;若为家庭版系统,使用DISM命令安装组策略组件;接着通过注册表编辑器修改MMC相关限制策略;最后尝试直接从System32目录运行gpedit.msc文件。 如果您尝试通过运行命令打开Windows 10的组策略编辑器(gpedit.…

    2026年9月24日 用户投稿
    000
  • 这套5000元的主机配置能战未来吗?

    5000元台式机可战未来3-4年,适合大学生主流游戏与学习。搭配R5 5600+RTX 4060级配置,1080P高画质流畅运行3A大作,2K需降特效但支持DLSS/FSR;6核12线程CPU加16GB内存满足办公、编程、视频剪辑需求;B550/B650主板和550W以上电源预留升级空间,支持后续提…

    2026年9月24日
    000
  • DeepSeek能不能帮我写代码 简单编程任务如何交给DeepSeek完成

    DeepSeek能不能帮我写代码 简单编程任务如何交给DeepSeek完成DeepSeek能不能帮我写代码 简单编程任务如何交给DeepSeek完成DeepSeek能不能帮我写代码 简单编程任务如何交给DeepSeek完成DeepSeek能不能帮我写代码 简单编程任务如何交给DeepSeek完成

    很多用户好奇,像DeepSeek这样的AI模型能否帮助完成编程任务,特别是那些相对简单的编程需求。答案是肯定的。DeepSeek具备理解自然语言描述并尝试生成相应代码的能力,这使得它成为完成一些简单编程任务的有力工具。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepS…

    2026年9月24日 用户投稿
    100
  • ubuntu如何mount网络驱动器

    在ubuntu中挂载网络驱动器有多种方法,以下是一些常见的方法: 方法一:使用mount命令 确定网络驱动器的地址:例如,如果是Samba共享,地址可能是smb://server/share。如果是NFS共享,地址可能是nfs://server/share。安装必要的软件包:对于Samba共享,安装…

    2026年9月24日
    000
  • Java中双精度浮点数的小数位控制技巧

    Java中双精度浮点数的小数位控制技巧Java中双精度浮点数的小数位控制技巧Java中双精度浮点数的小数位控制技巧Java中双精度浮点数的小数位控制技巧

    本文深入探讨了在Java中有效控制double类型数值小数位数的方法。通过Math.round()函数结合乘除操作,可以实现数值本身的四舍五入并改变其精度;而String.format()则提供了灵活的字符串格式化功能,用于在不修改原始数值的情况下精确控制显示的小数位数。这两种方法分别适用于不同的业…

    2026年9月24日 用户投稿
    000
  • windows11便笺功能在哪里_windows11自带便笺打开方法

    windows11便笺功能在哪里_windows11自带便笺打开方法windows11便笺功能在哪里_windows11自带便笺打开方法windows11便笺功能在哪里_windows11自带便笺打开方法windows11便笺功能在哪里_windows11自带便笺打开方法

    Windows 11便笺可通过开始菜单、搜索、固定任务栏、开机自启和桌面嵌入五种方式打开。首先点击开始菜单在S分类下找到便笺应用;或使用Win+S搜索“便笺”快速启动;右键便笺图标可固定到任务栏实现一键访问;通过运行shell:startup并创建快捷方式设置开机自启;最后在设置中登录Microso…

    2026年9月24日 用户投稿
    300
  • mysql中rand的用法 mysql随机函数使用教程

    mysql 的 rand() 函数返回 0 到 1 之间的随机浮点数,用于随机选择和排序数据。1)随机排序:select from your_table order by rand()。2)随机抽取记录:select from your_table order by rand() limit 10。…

    2026年9月24日
    200
  • 高质量免费logo设计网站 国产免费logo生成工具推荐

    国产免费Logo设计网站推荐即时设计、DesignEvo、牛人设计等,这些平台提供海量模板、支持中文输入与AI智能生成,具备全中文界面、本土化元素和矢量导出功能,适合零基础用户快速制作高质量Logo。 高质量免费logo设计网站国产免费logo生成工具推荐这是不少网友都关注的接下来由PHP小编为大家…

    2026年9月24日
    200
  • 如何通过BIOS调整CPU电压实现节能?

    答案:CPU降压通过BIOS调整Vcore电压,采用Offset模式在保证稳定前提下降低功耗与温度,提升能效;需结合HWiNFO64等工具监控温度、功耗,并用Prime95等压力测试验证稳定性,避免蓝屏或崩溃,合理设置可使CPU在更低温度下维持更高睿频,实现节能且不牺牲性能。 通过BIOS调整CPU…

    2026年9月24日
    700
  • 为什么GPU显存带宽比容量更重要?

    显存带宽比容量更重要,因其直接决定数据传输速度,影响GPU计算单元的利用率。在AI训练和高分辨率渲染中,高带宽可避免“数据饥饿”,确保海量数据高效流转,而HBM技术凭借3D堆叠和宽接口提供远超GDDR的带宽,成为高性能计算的关键。 GPU显存带宽比容量更重要,核心在于现代GPU的工作模式和其处理的数…

    2026年9月24日
    100
  • VSCode如何实现代码热重载 VSCode实时预览开发的高效配置方案

    使用live server扩展实现静态文件的实时预览,保存后浏览器自动刷新;2. 利用现代前端框架(如react、vue)内置的开发服务器(如vite、webpack dev server)实现hmr热模块替换,修改代码后仅更新变动模块而不刷新页面;3. 结合browsersync等工具实现多设备同…

    2026年9月24日
    000
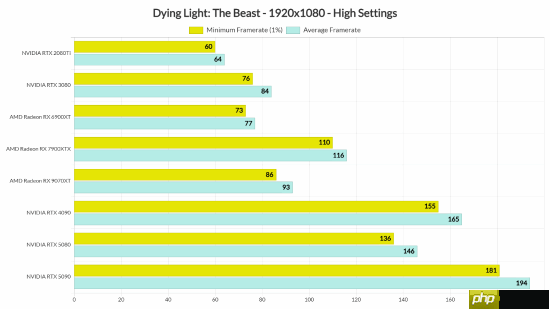
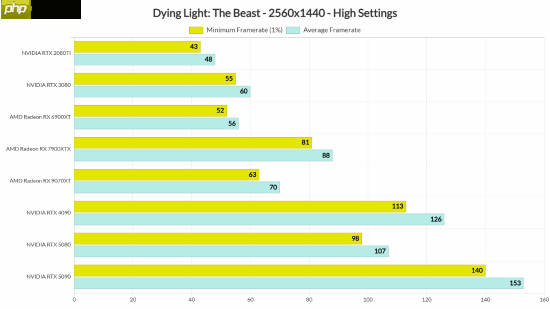
  • 外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀

    外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀外媒测试《消逝的光芒:困兽》PC性能:运行表现相当优秀

    来入手《消逝的光芒:困兽》吧!现享金币优惠叠加专属优惠券折上折,标准版仅需200.9元(共节省47.1元);豪华版233.2元(总计立减54.8元)。 由Techland打造的《消逝的光芒》系列新作《消逝的光芒:困兽》已正式上线。本作背景设定在曾经风景如画、如今却尸横遍野的河狸谷。玩家将在此组建临时…

    2026年9月24日 用户投稿
    000
  • UC浏览器怎么查看和清除LocalStorage数据 UC浏览器LocalStorage数据管理方法

    可通过隐私设置清除或开发者工具查看LocalStorage。①在UC浏览器设置中选择“隐私与安全”→“清除浏览数据”,勾选“Cookie及其他网站数据”即可批量删除LocalStorage;②打开uc://inspect启用开发者工具,通过电脑Chrome远程调试查看具体键值对;③root设备后使用…

    2026年9月24日
    200
  • Java语法基础中static关键字可以修饰哪些内容

    static关键字用于定义类成员,包括静态变量(如计数器)、静态方法(如工具方法)、静态代码块(类加载时执行)和静态内部类(不依赖外部类实例),均属于类而非对象,通过类名访问,提升成员至类级别实现共享与提前使用。 static 关键字在 Java 中主要用于定义与类相关而非与对象实例相关的成员。它不…

    2026年9月24日
    100
  • 抖音怎么看注册时间?怎么看百度网盘注册时间

    抖音已然成为国内炙手可热的短视频平台之一。凭借其独特的智能推荐系统,用户能够在短时间内找到自己喜爱的内容。你是否知道,你的抖音注册时间实际上隐含了许多关于你的社交轨迹的信息呢?本文将带领大家一同揭秘抖音注册时间背后的故事。 一、抖音注册时间的意义 1. 用户活跃程度的体现 抖音注册时间能够帮助我们判…

    2026年9月24日
    100
  • mysql中*是什么意思 mysql星号通配符解析

    在 mysql 中,星号()最常用于 select 语句中代表所有列,但应谨慎使用。1)它方便查看所有数据,但可能返回不必要的数据,影响性能。2)使用可能降低代码可维护性,建议明确列出所需列。3)在like操作符中,不是通配符,需用regexp。4)在视图中使用可能导致定义失效。5)可结合limit…

    2026年9月24日
    000
  • 为什么要4k对齐

    早期硬盘的每个扇区以512字节为标准,而新一代硬盘的扇区容量则为4096个字节,即所谓的4k扇区。虽然硬盘标准已经更新,但操作系统仍然使用512字节扇区的标准。为了确保兼容性,硬盘制造商将4k扇区模拟成了512字节扇区。文件系统的块(簇)通常是512字节的倍数,而新系统大多设定为4k的倍数,例如li…

    2026年9月24日
    000

发表回复

登录后才能评论
关注微信