REDIPS.drag中处理大尺寸可拖拽元素:利用单元格合并技术

REDIPS.drag中处理大尺寸可拖拽元素:利用单元格合并技术

redips.drag库中,单个可拖拽的div元素无法直接跨越多个表格单元格(td)。当需要放置尺寸较大的元素时,其会受限于单个td的高度。解决此问题的方法是利用redips.table库,预先合并相邻的td单元格,形成一个更大的目标区域。本文将详细介绍如何通过动态合并单元格来适应大尺寸可拖拽元素,并提供相应的代码示例。

REDIPS.drag与表格结构的基础理解

REDIPS.drag库的核心设计理念是基于HTML表格的栅格系统。这意味着每一个可拖拽的DIV元素都被视为占据一个独立的表格单元格(TD)。因此,一个DIV元素无法天然地在垂直方向上占据多个TD单元格的空间,即使其内容高度超过了单个TD的默认高度,也只会导致TD自身高度的增加,而不是跨越到相邻的TD。

当用户尝试将一个内容丰富或尺寸较大的DIV元素(例如,包含40px或70px高图像的DIV)拖放到表格中时,如果期望它能像rowspan或colspan那样占据多个单元格的视觉空间,REDIPS.drag本身并不能直接实现。这种限制源于库的底层结构,即它将每个可拖拽项与一个具体的TD关联。

解决方案:利用REDIPS.table合并单元格

为了解决单个DIV元素无法跨越多个TD的问题,我们需要在REDIPS.drag处理拖放事件之前,预先对表格的结构进行调整。这可以通过引入REDIPS.table库来实现单元格的动态合并。REDIPS.table是一个与REDIPS.drag互补的库,专门用于在运行时对HTML表格单元格进行合并和拆分操作。

通过合并相邻的TD单元格,我们可以创建一个更大的目标TD区域。一旦这些单元格被合并成一个逻辑上的大单元格,REDIPS.drag就可以将大尺寸的DIV元素拖放到这个合并后的TD中,从而在视觉上实现元素占据多行或多列的效果。

如何动态合并单元格

REDIPS.table库提供了一个merge方法,允许我们根据需要合并单元格。通常,这个过程包括以下几个步骤:

标记待合并的单元格: 用户可以通过点击或程序化方式选择需要合并的相邻单元格。调用合并方法: 使用REDIPS.table.merge()方法执行合并操作。重新初始化REDIPS.drag: 由于表格结构发生了变化,需要通知REDIPS.drag库重新识别新的表格布局。

以下是一个示例函数,展示了如何通过JavaScript代码合并单元格:

// 定义一个用于合并表格单元格的方法redips.merge = function () {    // 1. 首先水平合并单元格,并保持被合并的单元格处于标记状态(false表示不清除标记)    // 这允许我们在水平合并后,继续基于这些标记进行垂直合并    REDIPS.table.merge('h', false);    // 2. 接着垂直合并单元格,并清除所有标记的单元格    // 'v' 表示垂直合并,默认会清除标记    REDIPS.table.merge('v');    // 3. 单元格合并完成后,需要重新初始化REDIPS.drag库    // 这一步至关重要,它会更新REDIPS.drag内部对表格结构的理解,    // 使其能够识别新合并的单元格,并允许将可拖拽元素放置到这些新的大单元格中。    REDIPS.drag.initTables();};

代码解析:

REDIPS.table.merge(‘h’, false): 这个调用会水平合并所有被标记的相邻单元格。第二个参数false表示在合并完成后,不清除这些单元格上的标记,以便后续进行垂直合并。REDIPS.table.merge(‘v’): 在水平合并之后,此调用会垂直合并所有当前被标记的相邻单元格。默认情况下,垂直合并操作完成后会清除所有标记。REDIPS.drag.initTables(): 这是最关键的一步。每当HTML表格的结构(如单元格合并、添加或删除行/列)发生变化时,REDIPS.drag库需要被告知这些变化。调用initTables()会强制REDIPS.drag重新扫描其管理的表格,并更新其内部的单元格索引和可放置区域信息。如果没有这一步,REDIPS.drag将无法识别合并后的单元格,并可能导致拖放行为异常。

注意事项

引入REDIPS.table库: 要使用上述合并功能,您必须在项目中引入REDIPS.table库。该库通常与REDIPS.drag一起使用,可以从REDIPS.table官方页面获取。合并时机: 单元格合并操作应在拖放动作发生之前完成。您可以选择让用户手动标记并点击按钮合并,或者在页面加载时根据特定逻辑自动合并。动态合并与拆分: 虽然可以实现更复杂的逻辑,例如在拖拽元素进入或离开某个区域时动态合并或拆分单元格,但这会大大增加实现的复杂性。这通常需要监听REDIPS.drag的事件(如redips.event.dropped或redips.event.moved),并在事件处理函数中调用REDIPS.table的合并/拆分方法,同时确保每次结构变化后都调用REDIPS.drag.initTables()。这种高级用法超出了REDIPS.drag库的直接范围,需要开发者自行编写复杂的逻辑。CSS样式: 合并单元格后,可能需要调整CSS样式以确保合并后的单元格及其内部的可拖拽元素显示正常。

总结

REDIPS.drag库在处理单个DIV元素占据多个TD单元格的需求时,其设计限制要求我们采取额外的步骤。通过结合使用REDIPS.table库进行单元格的预合并,我们可以有效地为大尺寸可拖拽元素创建更大的目标放置区域。核心在于利用REDIPS.table.merge()方法进行单元格合并,并在每次结构变化后务必调用REDIPS.drag.initTables()来更新REDIPS.drag的内部状态。虽然动态的合并/拆分逻辑更为复杂,但预先合并单元格是一个直接且有效的解决方案,能够极大地增强REDIPS.drag在处理复杂表格布局时的灵活性。

以上就是REDIPS.drag中处理大尺寸可拖拽元素:利用单元格合并技术的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1585371.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
html在线表单验证方法 html在线用户输入校验技术
上一篇 2025年12月23日 01:43:14
解决Flask应用中常见的404错误:IP地址与端口配置指南
下一篇 2025年12月23日 01:43:27

相关推荐

  • 基于PHP实现登录用户专属文件下载访问控制

    本教程旨在解决用户登录后才能下载特定文件,而未登录用户即使知晓文件路径也无法访问的问题。通过介绍一种基于PHP脚本的解决方案,替代传统.htaccess的限制,实现对文件下载的精细化权限控制,确保只有经过身份验证的用户才能获取指定资源。 引言:登录用户文件下载的挑战 在web应用中,我们经常需要提供…

    2026年9月4日
    000
  • 渗透测试安全检测漏洞

    最近由于渗透测试任务繁重,笔者一直未能抽出时间撰写文章。今天,我们sine安全的渗透主管将为大家普及java安全测试的基础知识。许多客户希望了解具体的javascript调用漏洞、提交payload的过程,以及如何获取最高权限、绕过登录等执行命令漏洞的安全检测方法。 4.4.1.1. 显式原型和隐式…

    2026年9月4日
    000
  • 使用本地化资源动态配置 Java Switch 语句

    本文探讨了在 Java 中如何根据不同的区域设置,动态地配置 `switch` 语句。由于 `switch` 语句的 `case` 标签必须是常量表达式,直接使用资源文件中的字符串值是不允许的。本文提供了两种解决方案:使用 `if-else if` 语句替代 `switch`,以及使用 `Map` …

    2026年9月4日
    000
  • ​​无法定位程序输入点于动态链接库?错误修复指南​​

    重新安装或修复出错程序,确保安装完整且无残留;2. 运行sfc++ /scannow和dism命令修复系统文件,必要时手动替换受损dll;3. 更新或重装microsoft visual c++ redistributable和.net framework等运行库;4. 更新驱动程序和系统补丁,确保…

    2026年9月4日
    300
  • Spryker Elasticsearch 日志监控:提升应用可观测性

    在 spryker 电商平台的开发过程中,我们经常与 elasticsearch 交互进行搜索和数据检索。然而,在早期版本中,我们缺乏对 elasticsearch api 调用细节的有效监控机制。当出现搜索异常或性能问题时,定位问题根源变得异常困难,这严重影响了我们的开发效率和运维效率。 日志信息…

    用户投稿 2026年9月4日
    000
  • LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析

    LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析LLM自主发现发表在Nature上的科学假设?ICLR 2025 论文MOOSE-Chem深度解析

    人工智能的下一个前沿:引领科学发现 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 编辑 | ScienceAI 人工智能(AI)在自然语言处理和计算机视觉领域的成功有目共睹,但它能否推动科学理论的突破性发现? ICLR 2025 接收论文《…

    2026年9月4日 用户投稿
    100
  • Karate框架中构建包含复杂嵌套参数的GET请求指南

    本教程详细介绍了如何在Karate API测试框架中正确处理包含复杂嵌套参数(如filters[key])的GET请求。当直接使用JSON对象定义此类参数时,Karate可能无法正确解析URL。文章将演示如何利用* param关键字逐一设置这些参数,确保生成的请求URL格式符合预期,并提供示例代码和…

    2026年9月4日
    200
  • 安全基线检查平台

    安全基线检查平台安全基线检查平台安全基线检查平台安全基线检查平台

    0x01 介绍 最近我在进行安全基线检查相关的工作,网络上的一些代码比较零散;也有一些比较完整的项目,比如OWASP中的安全基线检查项目,但需要付费;还有一些开源且完整的,比如Lynis,但这些都不符合我的需求。 我的需求如下: 最终的效果是什么呢?最好能够达到阿里云里的安全基线检查的样子,即使差一…

    2026年9月4日 用户投稿
    100
  • 70年AI研究得出了《苦涩的教训》:为什么说AI创业也在重复其中的错误?

    70年AI研究得出了《苦涩的教训》:为什么说AI创业也在重复其中的错误?70年AI研究得出了《苦涩的教训》:为什么说AI创业也在重复其中的错误?70年AI研究得出了《苦涩的教训》:为什么说AI创业也在重复其中的错误?70年AI研究得出了《苦涩的教训》:为什么说AI创业也在重复其中的错误?

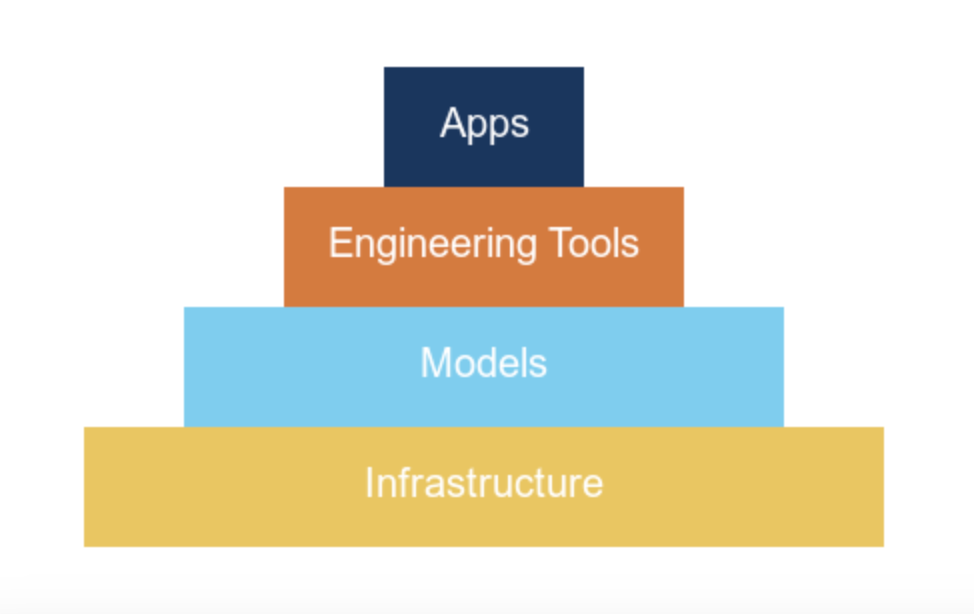
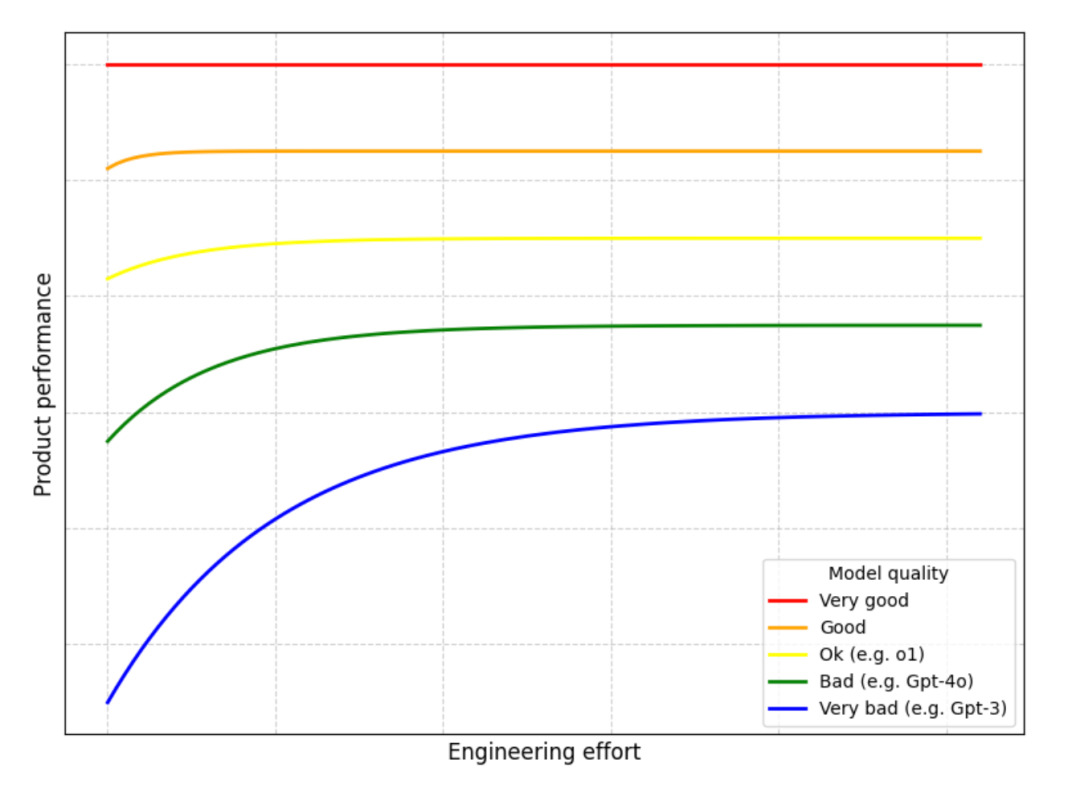
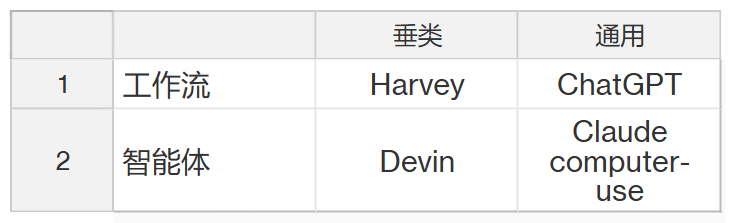
    人人都在做垂直 AI 产品,为什么要反其道而行? Scaling Laws 是否失灵,这个话题从 2024 年年尾一直讨论至今,也没有定论。 Ilya Sutskever 在 NeurIPS 会上直言:大模型预训练这条路可能已经走到头了。上周的 CES 2025,黄仁勋有提到,在英伟达看来,Scal…

    2026年9月4日 用户投稿
    200
  • 高效掌控色彩:BaseKit/ColorWorks 库的实际应用

    作为一名php开发者,我经常需要处理图像和颜色相关的任务。最近在开发一个图片编辑器功能模块时,遇到了一个棘手的问题:需要支持多种颜色格式(rgb, cmyk, hex, hsv等)的相互转换,并且需要能够方便地进行颜色调整,例如改变色相、饱和度和亮度。如果手动编写这些转换和调整函数,不仅工作量巨大,…

    用户投稿 2026年9月4日
    100
  • Java中toString方法默认输出什么 为什么建议重写

    默认的toString()方法返回“类名@哈希码的十六进制形式”,如com.example.Person@6b4c47ba;建议重写toString()以提升调试、日志输出和代码可读性,便于查看对象实际内容,尤其是在集合打印时能清晰展示对象状态,符合开发规范。 Java中每个类都继承自Object类…

    2026年9月4日
    200
  • 告别缓慢的GraphQL查询:使用Graphpinator Persisted Queries提升性能

    最近,我负责维护一个使用graphql的api,随着用户数量的增加,api的响应速度逐渐变慢。分析后发现,许多用户都在重复发送相同的查询,导致服务器在解析和验证这些查询上浪费了大量资源。虽然我的解析器函数本身效率很高,但graphql本身的解析和验证过程却成为了瓶颈。为了解决这个问题,我尝试了多种方…

    用户投稿 2026年9月4日
    100
  • Piti插件如何集成高清图库站点_Piti插件集成高清图库站点教程

    通过API、RSS或自定义代理可实现Piti插件对接高清图库。①使用图库API需获取密钥并配置服务信息;②通过RSS订阅导入公开资源,设置更新频率与解析规则;③无标准接口时搭建Node.js代理服务,解析网页数据为JSON供插件调用,提升素材获取效率。 如果您希望在使用Piti插件时能够快速访问和调…

    2026年9月4日
    100
  • 如何在Java中实现对象缓存机制

    答案:Java对象缓存通过减少重复创建和远程调用提升性能,常用HashMap或ConcurrentHashMap实现简单缓存,结合TTL和LRU策略控制内存,推荐使用Guava Cache或Caffeine进行高级管理,并在分布式环境下采用Redis集成,配合Spring Cache注解简化开发,核…

    2026年9月4日
    100
  • VSCode调试路径怎么写_VSCode配置调试工作目录与路径映射教程

    答案是通过在launch.json中正确配置cwd和路径映射字段。具体来说,program指定入口文件,cwd设置程序运行时的工作目录以确保相对路径正确,sourceMapPathOverrides或pathMappings则解决本地与远程/容器内路径不一致问题,从而实现断点命中和源码映射。排查时需…

    2026年9月4日
    100
  • win10steam错误代码105怎么解决

    win10steam错误代码105怎么解决win10steam错误代码105怎么解决win10steam错误代码105怎么解决win10steam错误代码105怎么解决

    在steam这一平台中,部分用户遇到了错误代码105的情况,也就是windows 10系统下的steam出现错误代码105的问题。其实这是由于网页访问出现了异常,但服务器却能正常访问,那么该如何解决呢?下面跟随小编一起来看看具体的操作步骤吧。 如何解决Windows 10中的Steam错误代码105…

    2026年9月4日 用户投稿
    300
  • Celery实现定时任务crontab

    Celery实现定时任务crontabCelery实现定时任务crontabCelery实现定时任务crontabCelery实现定时任务crontab

    定时任务在开发中应用广泛,几乎所有开发人员都会接触到。实现定时任务的方法有很多,其中celery的定时任务功能强大且使用简便,只需安装celery即可。以下是使用celery实现定时任务的详细步骤。 一. 搭建Celery定时任务架构 在项目中合适的位置新建一个定时任务目录 celery_cront…

    2026年9月4日 用户投稿
    200
  • 告别支付集成难题:Judopay PHP SDK 助力快速支付

    在最近的一个项目中,我们需要为一个电商平台集成在线支付功能。起初,我们尝试直接调用支付api,但很快发现这需要处理大量的细节,包括请求参数的构建、安全认证、错误处理等等,这不仅耗费了大量的时间和精力,而且代码的可维护性也极差。 为了解决这个问题,我们决定寻找一个合适的php sdk。在一番搜索之后,…

    用户投稿 2026年9月4日
    000
  • LSM-Tree查询是如何实现的?

    深入理解 LSM-Tree 查询过程 LSM-Tree (Log-Structured Merge-tree) 数据库将新数据写入内存中的 MemTable,历史数据则存储在多个 Level 中。查询过程如下: 第一步:MemTable 查找 系统首先在 MemTable 中搜索目标数据。如果找到,…

    2026年9月4日
    100
  • Java语法基础中this关键字的用法有哪些

    this是Java中指向当前对象的关键字,用于区分成员变量与局部变量(如this.name = name)、在构造器中调用其他构造器(this()且需位于首行)等。 this 是 Java 中的一个关键字,表示当前对象的引用。它在类的实例方法和构造器中使用,用来指向调用该方法或正在创建的那个对象。t…

    2026年9月3日
    100

发表回复

登录后才能评论
关注微信