本文旨在详细讲解如何利用c#的htmlagilitypack库,精确地从html文档中选择并解析特定的表格。我们将探讨常见的解析误区,并提供正确的xpath表达式和编程实践,确保您能够准确地定位到所需表格,并仅对其内部的行和单元格进行数据提取,从而避免不必要的全文档遍历,提高数据处理的效率和准确性。
在使用C#进行HTML解析时,HtmlAgilityPack是一个功能强大且广泛使用的库。它允许开发者像操作XML文档一样操作HTML,通过XPath表达式轻松定位各种HTML元素。然而,在处理包含多个相似元素的HTML文档时,例如多个表格,精确选择并解析特定元素可能会遇到一些挑战。本文将重点解决如何从多个表格中,根据其在文档中的位置,准确地选择并提取指定表格的数据。
理解问题:常见的解析误区
许多初学者在使用HtmlAgilityPack时,可能会遇到一个常见的误区:即使已经通过XPath选择了特定的表格节点,但在后续遍历行(
)时,仍然从整个文档中查找所有行,而非仅限于已选择的表格内部。
例如,以下代码片段试图选择文档中的第一个表格,但随后遍历
时却使用了doc.DocumentNode.SelectNodes(“//tr”),这将导致遍历文档中的所有表格行,而不仅仅是第一个表格的行:
HtmlAgAgilityPack.HtmlDocument doc = new HtmlAgilityPack.HtmlDocument();doc.LoadHtml(htmlContent); // 假设htmlContent是您的HTML字符串// 尝试选择第一个表格HtmlNode table = doc.DocumentNode.SelectSingleNode("//table[1]");// 错误:这里仍然从整个文档中选择所有的,而不是从上面选定的'table'节点中选择foreach (var row in doc.DocumentNode.SelectNodes("//tr")){ // ... 解析行数据}
这种做法的问题在于,doc.DocumentNode.SelectNodes(“//tr”)中的//表示从文档的根节点开始,查找所有匹配的
元素,无论它们位于哪个表格内。
立即学习“前端免费学习笔记(深入)”;
解决方案:相对路径与节点限定
要解决上述问题,关键在于理解XPath的相对路径概念,并确保在选择子节点时,操作是基于已选定的父节点进行的。换句话说,一旦您选择了特定的表格节点,后续对行和单元格的遍历操作,都应该以这个表格节点作为上下文(context node)。
正确的方法是:
选择特定的表格节点: 使用XPath表达式,如//table[1]选择第一个表格,或//table[2]选择第二个表格。从已选择的表格节点中选择子节点: 使用该表格节点作为起点,调用其SelectNodes()方法,并使用相对XPath表达式(如”tr”或”.//tr”)来查找其内部的行。
下面是修正后的代码示例,演示如何根据用户选择(例如下拉列表)来解析第一个或第二个表格:
using System;using System.Data;using HtmlAgilityPack;public class HtmlTableParser{ public DataTable ParseSpecificTable(string htmlContent, string tableName) { HtmlDocument doc = new HtmlDocument(); doc.LoadHtml(htmlContent); HtmlNode targetTable = null; if (tableName.Equals("Table1", StringComparison.OrdinalIgnoreCase)) { // 选择文档中的第一个表格 targetTable = doc.DocumentNode.SelectSingleNode("//table[1]"); } else if (tableName.Equals("Table2", StringComparison.OrdinalIgnoreCase)) { // 选择文档中的第二个表格 targetTable = doc.DocumentNode.SelectSingleNode("//table[2]"); } else { Console.WriteLine("指定的表格名称无效。"); return null; } if (targetTable == null) { Console.WriteLine($"未找到 {tableName}。"); return null; } DataTable dt = new DataTable(); // 假设表格有3列:id, inserted_at, DisplayName dt.Columns.Add("id", typeof(string)); dt.Columns.Add("inserted_at", typeof(string)); dt.Columns.Add("DisplayName", typeof(string)); // 关键:从已选择的'targetTable'节点中选择所有的 // "tr" 或 ".//tr" 都可以,表示查找当前节点下的所有tr元素 foreach (var row in targetTable.SelectNodes("tr")) { // 从当前行中选择所有的 var nodes = row.SelectNodes("td"); if (nodes != null && nodes.Count >= 3) // 确保有足够的td节点 { var id = nodes[0].InnerText.Trim(); var inserted_at = nodes[1].InnerText.Trim(); var DisplayName = nodes[2].InnerText.Trim(); dt.Rows.Add(id, inserted_at, DisplayName); } else if (nodes != null && nodes.Count > 0) { // 处理可能存在的表头行或其他不完整行 Console.WriteLine("跳过不完整的行或表头行。"); } } return dt; } public static void Main(string[] args) { string htmlDocument = @" This is where first table starts
head1 head2 head3 data1_1 data1_2 data1_3 data1_4 data1_5 data1_6
This is where second table starts
headA headB headC data2_1 data2_2 data2_3
"; HtmlTableParser parser = new HtmlTableParser(); Console.WriteLine("--- Parsing Table 1 ---"); DataTable table1Data = parser.ParseSpecificTable(htmlDocument, "Table1"); if (table1Data != null) { foreach (DataRow row in table1Data.Rows) { Console.WriteLine($"ID: {row["id"]}, InsertedAt: {row["inserted_at"]}, DisplayName: {row["DisplayName"]}"); } } Console.WriteLine("n--- Parsing Table 2 ---"); DataTable table2Data = parser.ParseSpecificTable(htmlDocument, "Table2"); if (table2Data != null) { foreach (DataRow row in table2Data.Rows) { Console.WriteLine($"ID: {row["id"]}, InsertedAt: {row["inserted_at"]}, DisplayName: {row["DisplayName"]}"); } } }}
在上述代码中,targetTable.SelectNodes(“tr”)是核心所在。它确保了
元素的查找范围仅限于targetTable节点内部,而不是整个HTML文档。
注意事项与最佳实践
XPath表达式的鲁棒性://table[1]和//table[2]通过索引选择表格在文档中的位置。如果HTML结构发生变化,索引可能会失效。更健壮的方法是,如果表格有唯一的id属性或特定的class属性,可以使用这些属性来定位,例如://table[@id=’myTableId’] 或 //table[contains(@class, ‘specific-table’)]。空值检查:在使用SelectSingleNode()或SelectNodes()的结果之前,务必进行空值检查(if (node != null) 或 if (nodes != null && nodes.Count > 0)),以避免NullReferenceException。数据清洗:从HTML节点提取的文本通常包含额外的空白字符(如换行符、空格)。使用Trim()方法可以清理这些空白。表头处理:在遍历时,通常需要区分表头行(
)和数据行(
)。在示例中,我们假设所有行都包含,但实际应用中可能需要更精细的判断,例如检查row.SelectNodes(“th”)是否存在。异常处理:在实际应用中,应考虑将解析逻辑包裹在try-catch块中,以处理可能出现的HTML结构不符合预期或XPath表达式错误等异常情况。
总结
通过HtmlAgilityPack精确解析HTML文档中的特定表格,关键在于正确理解XPath的上下文和相对路径。首先,使用DocumentNode.SelectSingleNode()定位到目标表格节点,然后,所有后续针对表格内部元素(如行
、单元格)的查找操作,都应该基于这个已定位的表格节点进行,而非再次从DocumentNode开始全局查找。遵循这些原则和最佳实践,可以显著提高HTML解析代码的准确性、健壮性和可维护性。
以上就是使用HtmlAgilityPack精确解析HTML文档中的指定表格的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1587747.html
赞 (0)
打赏
 微信扫一扫
 支付宝扫一扫
关于作者

相关推荐
-
《消逝的光芒:困兽》彩蛋众多!战神之斧、哈利波特关卡等
现在入手《消逝的光芒:困兽》正当时,使用金币抵扣并领取专属优惠券后可享折上折,标准版仅需200.9元(立省47.1元),豪华版也低至233.2元(节省54.8元)! 由Techland倾力打造的生存恐怖新作《消逝的光芒:困兽》已正式上线,游戏一经发布便引发玩家热烈探索,大量隐藏彩蛋与神秘内容陆续被挖…
-
行业首款!卡萨帝-60℃超低温低噪冰柜上市


9月27日,主题为“智由ai起,艺从东方来”的卡萨帝c生活场景全系引领发布会盛大开启。会上,卡萨帝正式推出行业首款-60℃超低温低噪冰柜,凭借前沿原创科技突破家用冷冻技术壁垒,为高端珍稀食材的储存提供了全新方案。 此次发布的卡萨帝-60℃超低温冰柜,精准回应了消费升级趋势下的用户需求。依托国际高端家…
-
VSCode如何自定义主题和配色方案 VSCode主题与配色方案的个性化设置
vscode自定义主题和配色方案的核心是通过内置主题、扩展主题和修改settings.json实现个性化;2. 可通过”workbench.colorcustomizations”自定义ui颜色,”editor.tokencolorcustomizations&#…
-
sublime侧边栏太宽怎么调_sublime侧边栏宽度调整教程

答案:通过修改主题配置文件可调整Sublime Text侧边栏宽度。打开Default.sublime-theme文件,找到”sidebar_container”的content_margin设置,将左右边距数值调小(如[8, 16]),保存后立即生效,能扩大代码编辑区域;使…
-
DeepSeek-R1 超级外挂!“人类最后的考试”首次突破 30 分,上海交大等开源方案碾压 OpenAI、谷歌
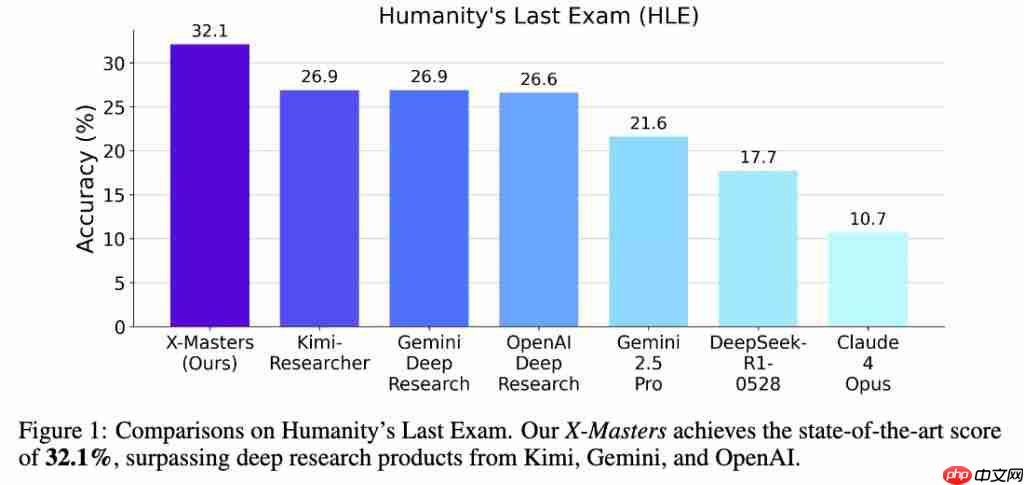
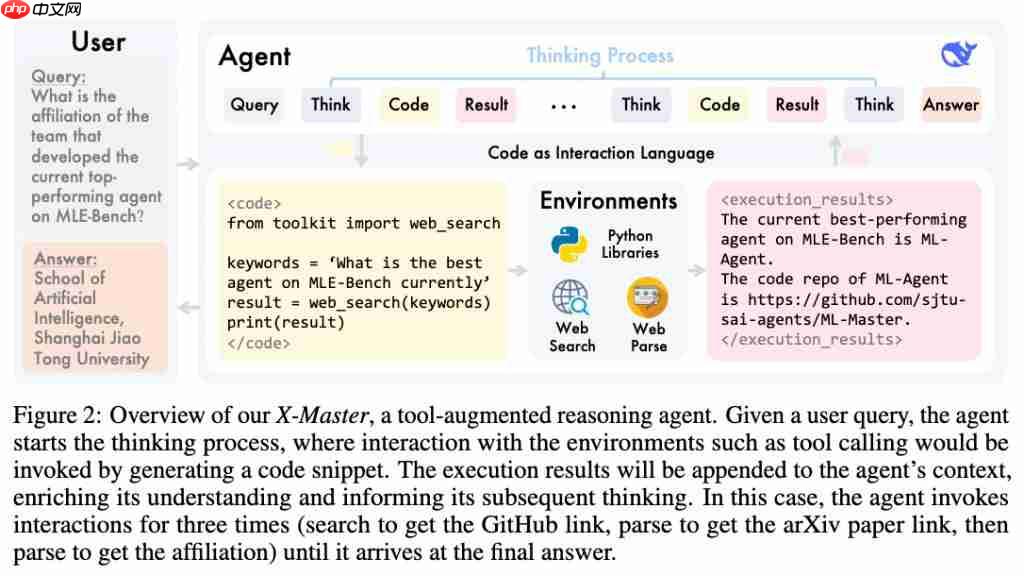
” 人类最后的考试 ” 首次突破 30 分,还是咱国内团队干的! 该测试集是出了名的超难,刚推出时无模型得分能超过 10 分。 直到最近,最高分也不过 26.9,由 Kimi-Research 和 Gemini Deep Research 并列取得。 现在,上海交大联合深势科…
-
ChatGPT能否生成交互式博物馆 ChatGPT文化遗产数字展陈
chatgpt虽不能直接创建交互式博物馆,但可在数字展陈构建中发挥辅助作用。1. chatgpt可生成展品解说词、翻译多语种内容、设计互动问答、辅助策展思路整理;2. 其输出可集成进语音导览、聊天机器人、ar/vr讲解及动态内容更新系统以实现交互体验;3. 实际应用中需注意内容准确性、文化敏感性、版…
-
百家号视频如何加字幕_百家号视频添加字幕的工具与方法

为提升理解与推荐,需为百家号视频添加字幕。一、剪映专业版可智能识别语音生成字幕,支持手动修改与样式调整,导出高清成品;二、百度智能云提供AI驱动的批量处理方案,通过语音识别与字幕叠加工作流实现高精度合成;三、百家号创作中心支持上传后自动生成或手动编辑字幕,便于及时修正并重新发布。 如果您在百家号上传…
-
怎么用豆包AI帮我生成React组件 用AI快速构建高质量React组件的秘诀
使用豆包ai生成react组件的关键在于明确需求、利用ai生成基础结构并手动优化。1. 明确需求,提供清晰指令,包括功能、props、状态管理及ui库偏好;2. 让ai生成组件结构和基础逻辑,如表单、列表渲染和简单交互;3. 审查代码质量,检查默认值、性能问题、组件命名和样式冲突,并根据需要进一步优…
-
Spring Security中自定义过滤器与JWT认证过滤器的执行顺序控制

在Spring Security应用中,确保自定义过滤器(如多租户过滤器)在JWT认证/授权过滤器之前正确执行至关重要。本文将深入探讨如何通过@Order注解和SecurityFilterChain配置,精确控制自定义OncePerRequestFilter的执行顺序,使其优先于Spring Sec…
-
如何优化debian readdir的性能
在Debian系统中,readdir系统调用用于读取目录内容。如果其性能表现不佳,可尝试以下优化策略: 精简目录文件数量: 尽可能将大型目录拆分成多个小型目录,降低每次readdir调用处理的项目数量。 启用目录内容缓存: 构建缓存机制,定期或在目录内容变更时更新缓存,减少对readdir的频繁调用…
-
抖音账号如何提升权重_抖音账号提升权重的关键步骤
账号权重低影响抖音推荐,需通过强化垂直度、优化发布节奏、提升互动率、提高完播率及利用AI工具五步改善。一、明确内容领域并保持视觉统一,前五视频聚焦定位;二、每日发布间隔6小时以上,选7-9点、12-1点、6-8点高峰时段,每周更新至少5条;三、开头设问引导评论,结尾提示收藏,100%回复评论提升粘性…
-
2025年真实动态视频生成AI工具排行榜前十名
2025年最值得关注的动态视频生成AI工具包括RunwayML Gen-3、Pika Labs、Luma AI Dream Machine、Google Imagen Video、Meta Make-A-Video、Synthesia IO、D-ID、DeepMotion Animate 3D、Ho…
-
MySQL中正则表达式应用 REGEXP在复杂条件查询中的用法
mysql 中 regexp 可用于模糊匹配不确定的字符串结构,比 like 更强大。1. 使用 | 匹配多个可能值,如 ‘apple|orange’ 表示“或”关系;2. 用 ^ 和 $ 分别匹配开头和结尾内容,如 ‘^user_’ 或 ‘…
-
Java微服务分布式事务实战:TCC模式与Seata框架深度整合
TCC模式结合Seata框架是微服务中实现分布式事务的可靠方案,通过Try-Confirm-Cancel机制将事务控制提升至业务层,Seata以@GlobalTransactional和@TwoPhaseBusinessAction注解简化事务协调,实现资源的预留、确认与回滚,解决数据一致性难题。 …
-
豪鹏科技H1预计营收26.8亿元-28亿元,净利润同比预增228.03%–271.77%
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 7月8日,豪鹏科技披露了2025年上半年业绩预告。预计上半年实现营业收入268,000万元至280,000万元,同比增长15.72%至20.9%;归属于上市公司股东的净利润预计为9,000万元至…
-
Java加密输出长度限制的策略与实践
本文探讨了在Java中将可变长度文本加密并严格限制输出长度在100字符以内的方法。由于加密本身并非压缩,且现代密码学算法会引入IV和认证标签等额外开销,直接加密难以满足短输出要求。教程将提供预加密优化(编码与压缩)、最小化密文表示开销、充分利用存储字符集以及分段传输等策略,以平衡安全性与长度限制。 …
-
Java加密输出长度限制:挑战与多维策略

本文探讨了在Java中对文本进行加密并严格限制输出长度(例如100字符)的挑战。由于现代加密算法通常会增加而非压缩数据,文章将介绍如何通过优化编码、数据压缩、最小化加密开销、高效字符存储以及分段传输等多种策略来应对这一特殊需求,确保在满足长度限制的同时兼顾安全性。 在许多应用场景中,对数据进行加密是…
-
win8时间不准怎么同步_Win8时间同步教程
1、启用自动时间同步:通过“Internet 时间”选项卡勾选同步并选择服务器,点击“立即更新”完成校准;2、手动调整时间:在“日期和时间”选项卡中修改具体数值;3、检查时区:选择对应地理区域的时区并设置夏令时。 如果您发现Windows 8系统的日期和时间显示不正确,这可能会导致程序运行异常、文件…
-
如何配置Tomcat日志轮转

本文介绍如何利用Linux系统自带的logrotate工具实现Tomcat日志的自动轮转。 步骤一:创建或修改logrotate配置文件 在/etc/logrotate.d/目录下,创建或修改名为tomcat的配置文件(或其他你选择的名称)。使用以下命令: sudo vim /etc/logrota…
-
windows激活失败错误0x8007007b怎么办_激活错误0x8007007b问题解决流程
0x8007007b错误通常由系统时间不准、激活服务异常或注册表问题引起。首先检查并同步系统时间和时区,确保网络通畅;接着以管理员身份运行命令提示符,依次执行slmgr.vbs /upk、/ipk输入有效密钥和/ato尝试激活;若问题依旧,运行sfc /scannow修复系统文件,并在服务中确认“软…