Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $YECBGYFECGEAFWHA as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2

Deprecated: imwpcache\f884414bce24ee67f\f73723ec7b1919fa5::__construct(): Implicitly marking parameter $BBWFDDBHHYHDXXAB as nullable is deprecated, the explicit nullable type must be used instead in /www/wwwroot/www.chuangxiangniao.com/wp-content/plugins/imwpcache-dist/build/f884414bce24ee67ff73723ec7b1919fa5.php on line 2
Python lxml Etree与XPath:可靠地提取HTML元素内文本_创想鸟

Python lxml Etree与XPath:可靠地提取HTML元素内文本

Python lxml Etree与XPath:可靠地提取HTML元素内文本

本教程将指导您如何使用python的lxml库和xpath表达式,从html元素中可靠地提取文本内容,特别是链接文本。我们将重点介绍如何构建更健壮的xpath,避免脆弱的绝对路径,并利用`//text()`函数准确捕获目标文本,从而提升网页数据抓取的稳定性和准确性。

在使用Python进行网页数据抓取时,lxml库配合XPath表达式是解析HTML和XML内容的强大工具。然而,构建一个既准确又健壮的XPath表达式是成功的关键。许多初学者常遇到的问题是,他们使用的XPath表达式过于依赖HTML文档的层级结构(即绝对路径),这导致一旦网页结构稍有变化,XPath就会失效。本文将详细介绍如何构建更可靠的XPath,并高效地提取目标元素的文本内容。

一、理解XPath的脆弱性:为什么应避免绝对路径

原始问题中,用户尝试使用类似/html/body/div[5]/div[4]/div[5]/div[*]的XPath表达式来定位元素。这种XPath是基于元素在HTML文档树中的精确位置和顺序。虽然在特定时刻可能有效,但它存在严重的缺陷:

易受页面结构变化影响: 网页前端的任何微小改动(例如增加或删除一个div,调整元素顺序)都可能导致路径中的索引发生变化,从而使XPath失效。可读性差: 这样的路径难以理解其所代表的实际内容,维护起来非常困难。通用性差: 如果页面上存在多个结构相似但内容不同的元素,这种XPath很难进行区分。

为了克服这些问题,我们应该优先使用那些基于元素属性(如class、id、name等)的XPath表达式,因为这些属性通常比层级结构更稳定、更具描述性。

二、构建健壮的XPath:利用属性进行定位

在构建XPath时,推荐使用以下策略:

立即学习“Python免费学习笔记(深入)”;

使用双斜杠//: //表示从文档的任何位置开始匹配,而不是从根节点开始,这增加了XPath的灵活性。利用元素属性: 优先使用id、class、name等属性来定位元素。例如,如果目标div有一个class=”tag”,我们可以使用//div[@class=”tag”]来定位。使用contains()函数进行部分匹配: 当class属性包含多个值,或者我们只需要匹配其中的一部分时,可以使用contains()函数。例如,//div[contains(@class, “tag”)]会匹配所有class属性包含”tag”字符串的div元素。

回到原始问题中的HTML片段:

为了提取标签内的文本,我们可以首先定位到包含它的div元素。由于这个div有一个class=”tag”,我们可以使用以下XPath来定位它:

//div[contains(@class, 'tag')]

这个表达式将查找文档中所有class属性包含”tag”的div元素,这比绝对路径要可靠得多。

三、精确提取文本内容:使用//text()函数

一旦我们定位到了目标元素(例如上述的div或其内部的a标签),下一步就是提取其内部的文本内容。XPath提供了text()函数来获取当前节点的直接文本子节点。然而,更强大的方式是使用//text()。

text(): 获取当前节点的直接文本子节点。如果文本分布在多个子标签中,text()可能只返回一部分。//text(): 获取当前节点及其所有子孙节点的文本内容。这对于提取包含嵌套标签的元素的完整文本非常有用。

在我们的例子中,目标文本”Former United States Secretary Of State”是标签的直接文本内容。如果我们要获取div内所有文本,或者a标签的文本,都可以使用//text()。

将定位和文本提取结合起来,一个完整的XPath表达式可以是:

//div[contains(@class, 'tag')]//text()

这个表达式的含义是:查找所有class属性包含”tag”的div元素,然后获取这些div元素内部(包括其子孙元素)的所有文本节点。

四、示例代码

下面是一个完整的Python示例,演示如何使用lxml和健壮的XPath来提取目标文本:

from lxml import etree# 模拟的HTML内容html_content = """
Header content

This is some other text.

Another Link Text
"""# 将HTML字符串解析为lxml树结构tree = etree.HTML(html_content)# 定义健壮的XPath表达式# 1. 定位到class包含'tag'的div# 2. 获取该div内部所有子孙节点的文本内容xpath_expression = "//div[contains(@class,'tag')]//text()"# 执行XPath查询selection = tree.xpath(xpath_expression)# selection会返回一个包含所有匹配文本节点的列表# 在本例中,只有一个文本节点,所以我们取第一个元素if selection: extracted_text = selection[0].strip() # 使用strip()去除可能的空白字符 print(f"提取到的文本: '{extracted_text}'")else: print("未找到匹配的文本内容。")# 示例:提取另一个标签的文本xpath_another_link_text = "//div[contains(@class, 'another_tag_section')]//a//text()"another_selection = tree.xpath(xpath_another_link_text)if another_selection: extracted_another_text = another_selection[0].strip() print(f"提取到的另一个链接文本: '{extracted_another_text}'")else: print("未找到另一个链接文本。")

输出:

提取到的文本: 'Former United States Secretary Of State'提取到的另一个链接文本: 'Another Link Text'

五、注意事项与最佳实践

处理XPath结果列表: xpath()方法总是返回一个列表,即使只有一个匹配项或没有匹配项。如果确定只有一个结果,可以直接使用selection[0]。在访问列表元素之前,务必检查列表是否为空(if selection: 或 if len(selection) > 0:),以避免IndexError。如果//text()返回多个文本节点(例如,元素内部有多个子元素,每个子元素都有文本),你可能需要将它们拼接起来,例如”.join(selection).strip()。strip()去除空白: 提取到的文本可能包含前导或尾随的空格、换行符等,使用.strip()方法可以清除这些不必要的空白。调试XPath: 在浏览器开发者工具(F12)的Console中,可以使用$x(“YourXPathHere”)来测试XPath表达式,这对于快速验证XPath的准确性非常有帮助。避免过度依赖特定索引: 尽量避免在XPath中使用[index]来定位元素,除非该索引是语义上固定的(例如表格的某一行或某一列)。组合使用XPath函数: XPath提供了丰富的函数(如starts-with()、ends-with()、normalize-space()等),可以根据实际需求灵活组合使用,以构建更强大的选择器。

总结

通过本教程,我们学习了如何使用Python的lxml库和XPath表达式,以一种更健壮和可靠的方式从HTML中提取文本内容。核心思想是优先使用基于元素属性(如class、id)的XPath表达式来定位目标元素,并结合//text()函数来精确捕获其内部的文本内容。这种方法不仅提高了数据抓取代码的稳定性,也使其更易于维护和理解,是进行高效网页解析的推荐实践。

以上就是Python lxml Etree与XPath:可靠地提取HTML元素内文本的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1593199.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
解决iOS设备上输入框聚焦时意外滚动与缩放问题
上一篇 2025年12月23日 08:21:29
JavaScript实现动态API数据搜索与表格动态展示教程
下一篇 2025年12月23日 08:21:39

相关推荐

  • sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置

    sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置sublime怎么设置markdown的图片预览_sublime Markdown图片预览设置

    Sublime Text需安装插件实现Markdown图片预览:1. 通过Package Control安装MarkdownEditing、MarkdownPreview或OmniMarkupPreviewer;2. 使用MarkdownPreview在浏览器中预览,确保图片路径正确;3. Omni…

    2026年9月24日 • 用户投稿
    000
  • 马斯克第六次起诉 OpenAI,指控窃取商业机密

    马斯克第六次起诉 OpenAI,指控窃取商业机密马斯克第六次起诉 OpenAI,指控窃取商业机密马斯克第六次起诉 OpenAI,指控窃取商业机密马斯克第六次起诉 OpenAI,指控窃取商业机密

    马斯克再度将 openai 告上法庭,这是他在过去十八个月内第六次针对这家人工智能公司发起法律行动。此次,由马斯克创立的人工智能企业 xai 已向加利福尼亚北区联邦法院提交诉状,指控 openai 大规模挖角其关键技术人才,并涉嫌非法获取商业机密。 随着双方矛盾不断升级,诉讼内容也从最初的合同纠纷逐…

    2026年9月24日 • 用户投稿
    000
  • VibeVoice— 微软推出的开源文本转语音模型

    VibeVoice— 微软推出的开源文本转语音模型VibeVoice— 微软推出的开源文本转语音模型VibeVoice— 微软推出的开源文本转语音模型VibeVoice— 微软推出的开源文本转语音模型

    ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 微软文字转语音 微软文本转语音,支持选择多种语音风格,可调节语速。 0 查看详情 VibeVoice是什么 vibevoice 是微软最新推出的文本到语音(tts)模型,能够生成具有丰富情感、支…

    2026年9月24日 • 用户投稿
    700
  • sublime怎么在Windows右键菜单添加”用Sublime打开”_sublime资源管理器右键集成方法

    sublime怎么在Windows右键菜单添加”用Sublime打开”_sublime资源管理器右键集成方法sublime怎么在Windows右键菜单添加”用Sublime打开”_sublime资源管理器右键集成方法sublime怎么在Windows右键菜单添加”用Sublime打开”_sublime资源管理器右键集成方法sublime怎么在Windows右键菜单添加”用Sublime打开”_sublime资源管理器右键集成方法

    通过修改注册表可为Windows右键菜单添加Sublime Text打开选项,首先确认Sublime安装路径,然后创建包含指定键值的.reg文件,修改路径后双击导入,即可在右键任意文件或文件夹时使用“用Sublime打开”功能。 在Windows系统中,想通过右键菜单直接用Sublime Text打…

    2026年9月24日 • 用户投稿
    200
  • 如何断开mysql数据库连接

    如何断开mysql数据库连接如何断开mysql数据库连接如何断开mysql数据库连接如何断开mysql数据库连接

    为了断开 MySQL 数据库连接,需要按以下步骤进行:创建连接对象获取连接游标关闭游标关闭连接 如何断开 MySQL 数据库连接 要断开 MySQL 数据库连接,可以使用以下步骤: 1. 创建连接对象 首先,使用 connect() 函数创建到数据库的连接对象,该函数需要一个数据库连接参数字符串作为…

    2026年9月24日 • 用户投稿
    100
  • AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”

    AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”AI 赋能硬件!荣耀宣布 Magic8 系列拥有“八大行业领先”

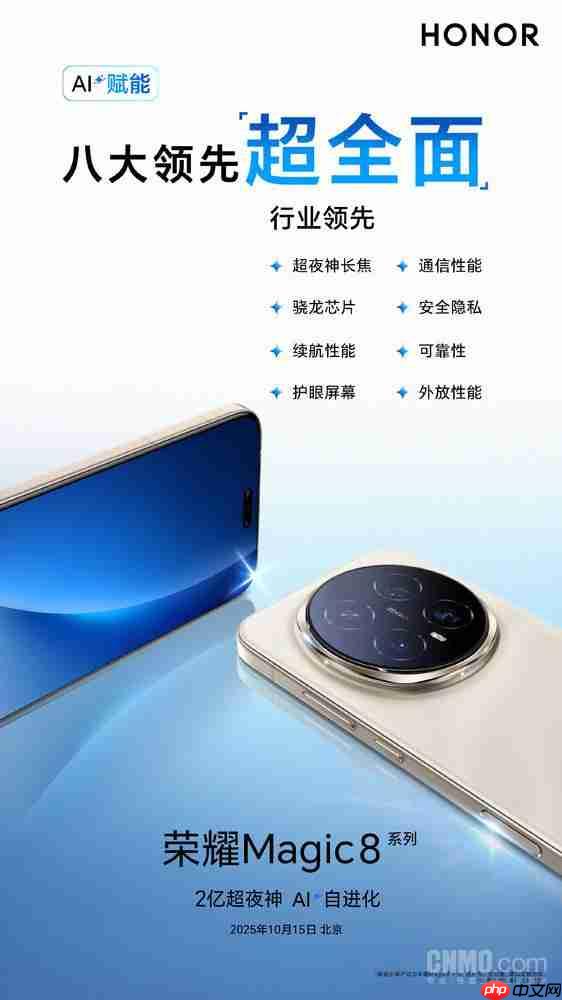
    10 月 15 日,荣耀即将正式推出 magic8 系列新机。在发布会前夕,官方持续释放预热信息。据 cnmo 获悉,最新一轮预热中,荣耀强调:magic8 系列配备品牌史上最强的硬件组合,通过 ai 深度赋能硬件系统,打造八大行业领先技术,树立新一代旗舰标杆。 荣耀 Magic8 系列 那么,这“…

    2026年9月24日 • 用户投稿
    100
  • 创建包含列表对象的Java对象时,避免列表为空的技巧

    创建包含列表对象的Java对象时,避免列表为空的技巧创建包含列表对象的Java对象时,避免列表为空的技巧创建包含列表对象的Java对象时,避免列表为空的技巧创建包含列表对象的Java对象时,避免列表为空的技巧

    在Java中,如果一个类的属性是列表类型,在创建该类的实例时,如果没有显式地初始化该列表,那么该属性的默认值将会是null。这可能会导致在后续操作中出现空指针异常。为了避免这种情况,我们需要确保在创建对象时,列表属性被初始化为一个空列表,而不是null。 解决方案一:显式初始化列表 最直接的方法是在…

    2026年9月24日 • 用户投稿
    000
  • ubuntu compton提高分辨率技巧

    在ubuntu系统中,compton是一个常用的合成器,用于实现窗口的透明度和阴影效果。然而,compton本身并不直接提供调整分辨率的功能。分辨率的调整通常与显示管理器(如lightdm)或桌面环境(如gnome)的显示设置相关。以下是一些提高分辨率的技巧: 通过显示管理器调整分辨率 使用Ligh…

    2026年9月24日
    000
  • windows11的emoji表情面板快捷键是什么_windows11打开emoji表情的方法

    windows11的emoji表情面板快捷键是什么_windows11打开emoji表情的方法windows11的emoji表情面板快捷键是什么_windows11打开emoji表情的方法windows11的emoji表情面板快捷键是什么_windows11打开emoji表情的方法windows11的emoji表情面板快捷键是什么_windows11打开emoji表情的方法

    可通过快捷键Win+.调出表情符号面板,在任务栏设置中开启“表情符号及更多”按钮,或通过触摸屏长按输入区、鼠标右键菜单等方式快速插入表情符号和特殊字符。 如果您想在Windows 11中快速插入表情符号或特殊字符,但不确定如何调出相关面板,则可以通过系统提供的多种方式实现。以下是具体的操作方法: 本…

    2026年9月24日 • 用户投稿
    000
  • UC浏览器下载的压缩包怎么打开_UC浏览器直接解压ZIP或RAR文件教程

    UC浏览器下载的压缩包怎么打开_UC浏览器直接解压ZIP或RAR文件教程UC浏览器下载的压缩包怎么打开_UC浏览器直接解压ZIP或RAR文件教程UC浏览器下载的压缩包怎么打开_UC浏览器直接解压ZIP或RAR文件教程UC浏览器下载的压缩包怎么打开_UC浏览器直接解压ZIP或RAR文件教程

    首先尝试用UC浏览器预览压缩包内容,若需完整解压则安装ZArchiver等工具,或使用系统文件管理器自带的ZIP解压功能。 如果您在使用UC浏览器下载了ZIP或RAR格式的压缩包,但无法直接查看其中的内容,可能是因为浏览器本身不支持完整的解压功能。此时需要借助系统自带或第三方工具完成解压操作。 本文…

    2026年9月24日 • 用户投稿
    200
  • 蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0

    蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0蚂蚁百灵大模型团队开源高性能思考模型 Ring-flash-2.0

    蚂蚁百灵大模型团队宣布正式开源 ring-flash-2.0,这是一款基于 ling-flash-2.0-base 深度优化的高效思考模型。与 ling-flash-2.0 一致,ring-flash-2.0 拥有总计 100b 参数,但在每次推理过程中仅激活 6.1b 参数,显著提升计算效率。 R…

    2026年9月24日 • 用户投稿
    000
  • 多模态AI如何处理射电望远镜数据 多模态AI深空探测应用

    多模态AI如何处理射电望远镜数据 多模态AI深空探测应用多模态AI如何处理射电望远镜数据 多模态AI深空探测应用多模态AI如何处理射电望远镜数据 多模态AI深空探测应用多模态AI如何处理射电望远镜数据 多模态AI深空探测应用

    多模态ai通过融合多种数据提升射电望远镜数据分析能力。它将无线电信号转化为频谱图、时间序列等形式,并结合光学图像等信息综合判断信号频率、强度、出现时间与方向;1.时空对齐匹配不同设备数据;2.特征级融合提取关键特征;3.决策级融合综合多个模型结果;实际应用于“突破聆听计划”筛选射电信号,面临数据格式…

    2026年9月24日 • 用户投稿
    200
  • sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法

    sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法sublime怎么处理SQL文件并高亮_sublime SQL语法高亮设置方法

    首先手动设置SQL语法高亮,点击右下角语言模式选择SQL;接着将.sql文件默认关联为SQL语法打开;然后通过Package Control安装SQLTools等插件增强功能;最后可自定义颜色主题优化显示效果。 Sublime Text 默认支持多种编程语言的语法高亮,但对 SQL 文件的支持可能不…

    2026年9月24日 • 用户投稿
    000
  • 二手车视频号直播怎么挂载?直播挂载有影响吗?

    二手车视频号直播怎么挂载?直播挂载有影响吗?二手车视频号直播怎么挂载?直播挂载有影响吗?二手车视频号直播怎么挂载?直播挂载有影响吗?二手车视频号直播怎么挂载?直播挂载有影响吗?

    视频号直播中的挂载功能,是推动二手车销售转化的核心利器。通过精准配置商品链接、小程序或留资表单,主播可高效引导观众完成从观看到咨询、下单的全过程。那么,具体该如何操作呢? 一、二手车视频号直播如何实现挂载? 开通直播权限 确保你的视频号已完成实名认证,并满足平台对粉丝数或活跃度的基本要求。进入视频号…

    2026年9月24日 • 用户投稿
    300
  • MAC外接显示器没有反应_Mac外接显示器连接与故障排除

    首先检查连接线缆和接口是否正常,确认显示器电源及输入源设置正确;通过系统设置中的“检测显示器”功能强制识别;调整分辨率与刷新率为显示器兼容值;重置NVRAM/SMC以清除错误配置;使用安全模式排除软件冲突;最后更新macOS和显示器固件至最新版本。 如果您已将Mac连接至外接显示器,但屏幕显示“无信…

    2026年9月24日
    000
  • sublime的snippet(代码片段)怎么用_sublime代码片段创建与调用技巧

    sublime的snippet(代码片段)怎么用_sublime代码片段创建与调用技巧sublime的snippet(代码片段)怎么用_sublime代码片段创建与调用技巧sublime的snippet(代码片段)怎么用_sublime代码片段创建与调用技巧sublime的snippet(代码片段)怎么用_sublime代码片段创建与调用技巧

    输入触发词按Tab可快速插入代码。通过Tools > Developer > New Snippet创建,设置content、tabTrigger和scope,保存至Packages/User目录,使用$1、$2等定义光标位,支持多行与变量如文件名、选中内容,适用于JS等特定语言环境。 …

    2026年9月24日 • 用户投稿
    000
  • 手机淘宝怎么上拍品?手机淘宝怎么上拍品视频

    手机淘宝怎么上拍品?手机淘宝怎么上拍品视频手机淘宝怎么上拍品?手机淘宝怎么上拍品视频手机淘宝怎么上拍品?手机淘宝怎么上拍品视频手机淘宝怎么上拍品?手机淘宝怎么上拍品视频

    首先打开手机淘宝进入“我是商家”,通过“发布宝贝”填写信息并上传图片完成商品发布;接着在“素材中心”上传不超过500MB的MP4格式视频,并将视频链接插入商品详情;也可使用千牛App,在发布商品时直接添加视频,确保封面清晰,最后提交发布即可。 如果您想在手机淘宝上发布商品或上传拍品视频,但不清楚具体…

    2026年9月24日 • 用户投稿
    200
  • UC浏览器如何设置默认下载工具_UC浏览器调用第三方下载器设置方法

    UC浏览器如何设置默认下载工具_UC浏览器调用第三方下载器设置方法UC浏览器如何设置默认下载工具_UC浏览器调用第三方下载器设置方法UC浏览器如何设置默认下载工具_UC浏览器调用第三方下载器设置方法UC浏览器如何设置默认下载工具_UC浏览器调用第三方下载器设置方法

    首先开启UC浏览器的第三方下载权限,进入设置→下载设置→启用“使用第三方下载工具”;然后在默认下载工具中选择目标应用如IDM+或ADM;若未显示可选应用需确认安装并刷新列表;还可通过系统设置→应用管理→默认应用→下载管理器中指定默认下载器;对于不支持直接绑定的版本,可用Tasker或Auto.js等…

    2026年9月24日 • 用户投稿
    100
  • 怎样备份和恢复Debian邮件服务器数据

    备份和恢复debian邮件服务器数据的方法取决于邮件服务器的具体配置和使用的软件。以下是一些通用的步骤和建议: 壁纸样机神器 免费壁纸样机生成 0 查看详情 备份步骤 确定备份内容:首先,确定需要备份的数据类型,例如邮件内容、用户信息、配置文件等。使用备份工具:根据邮件服务器的软件选择合适的备份工具…

    2026年9月24日
    100
  • 怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型

    怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型怎么用豆包AI帮我实现CQRS模式 3步教你用AI分离读写模型

    实现cqrs模式可通过三步借助豆包ai快速完成:一、理清业务场景,将写操作(如用户下单)与读操作(如查看订单列表)分离,可复制代码给豆包ai分析归类;二、让豆包ai生成基础结构代码,输入类似“基于cqrs的订单管理系统,用python flask实现”的指令,获取命令处理器、查询处理器等模块模板;三…

    2026年9月24日 • 用户投稿
    000

发表回复

登录后才能评论
关注微信