本文旨在指导读者如何使用Python高效抓取网页中的表格数据。我们将对比传统的BeautifulSoup手动解析方法与Pandas库中强大的`read_html`函数。通过具体案例,展示`read_html`如何以极简代码实现表格数据的自动识别、提取并保存为CSV文件,显著提升数据抓取效率,是处理结构化网页表格数据的首选方案。
在数据分析和处理领域,从网页抓取结构化数据是一项常见任务。特别是当数据以HTML表格形式呈现时,如何高效、准确地提取这些数据成为关键。本教程将深入探讨两种主要的Python网页表格抓取方法,并通过实例对比它们的效率和适用场景。
传统网页表格抓取方法:BeautifulSoup实践
BeautifulSoup是一个功能强大的Python库,用于从HTML或XML文件中提取数据。它通过解析文档并提供导航、搜索和修改解析树的方法,使得从网页中定位和提取特定元素变得相对容易。
当使用BeautifulSoup抓取网页表格时,基本步骤如下:
立即学习“Python免费学习笔记(深入)”;
发送HTTP请求:使用requests库获取目标网页的HTML内容。解析HTML:将获取到的HTML内容传递给BeautifulSoup进行解析,生成一个可操作的解析树。定位表格元素:通过find_all()或select()等方法查找标签,然后进一步定位(表格行)和(表格数据单元格)标签。遍历并提取数据:迭代每个,再迭代其内部的,提取所需的文本内容。通常需要处理文本的空格和换行符。数据存储:将提取到的数据整理成列表或字典,最终保存到CSV文件或其他格式。
以下是一个使用BeautifulSoup抓取NCAA女子足球RPI排名的示例代码:
@@######@@
这种方法提供了高度的灵活性,允许开发者精确控制数据提取的每一个细节。然而,对于结构规范的HTML表格,代码量相对较大,且需要手动处理数据的清洗和组织。
高效解决方案:利用Pandas.read_html
pandas是Python中一个流行的数据分析库,以其强大的数据结构(如DataFrame)和数据操作功能而闻名。pandas提供了一个极其便捷的函数read_html(),专门用于从HTML网页中自动识别并提取表格数据。
pandas.read_html()的工作原理是:
发送HTTP请求:在后台自动完成网页内容的获取。解析HTML并识别表格:它会扫描整个HTML文档,自动查找所有标签,并尝试将它们解析成DataFrame对象。返回DataFrame列表:由于一个网页可能包含多个表格,read_html()会返回一个DataFrame对象的列表,每个DataFrame对应网页中的一个表格。数据结构化:自动将表格的行和列转换为DataFrame的结构,包括自动识别表头。
以下是使用pandas.read_html()抓取相同NCAA排名的示例代码:
@@######@@
可以看到,使用pandas.read_html(),代码量大大减少,且逻辑更为清晰。它将复杂的HTML解析和数据结构化过程封装起来,极大地提高了开发效率。
方法对比与选择
代码简洁性相对较高,需要手动遍历和提取极简,通常一行代码即可完成表格提取开发效率较低,需要更多代码实现解析逻辑极高,自动化程度高灵活性高,可处理复杂、非标准HTML结构,与Selenium结合处理动态内容较低,依赖于标准HTML表格结构,不直接支持动态内容数据结构化需要手动整理为列表、字典等,再转换为DataFrame自动解析为DataFrame,结构清晰依赖requests, BeautifulSouppandas (内部可能依赖lxml, html5lib)适用场景网页结构复杂、非标准,需要精细控制,或动态加载内容网页包含结构良好、静态加载的HTML表格
总结:
对于结构良好且静态加载的HTML表格,pandas.read_html()是毋庸置疑的首选。它以其简洁高效的特点,能够迅速完成数据抓取和结构化。对于网页结构复杂、表格非标准、或者数据通过JavaScript动态加载的情况,BeautifulSoup结合requests(或配合Selenium模拟浏览器行为)则提供了更高的灵活性和控制力,能够应对更具挑战性的抓取任务。
注意事项
在使用Python进行网页表格数据抓取时,无论选择哪种方法,都应注意以下几点:
依赖安装:确保所有必要的库已正确安装。对于pandas.read_html,通常需要安装lxml或html5lib作为HTML解析器:pip install pandas lxml html5lib。表格定位:pandas.read_html()返回的是一个DataFrame列表。如果网页中存在多个表格,务必仔细检查列表中的每个DataFrame,以确定所需表格的正确索引。可以通过打印df.head()或df.shape来辅助判断。动态加载内容:requests和pandas.read_html()直接处理的是服务器返回的原始HTML。如果表格数据是通过JavaScript在浏览器端动态生成的,这些方法将无法直接获取到完整数据。此时,可能需要引入Selenium等工具来模拟浏览器行为,等待页面加载完成后再提取数据。网站Robots协议与爬虫道德:在抓取任何网站数据之前,请务必查看该网站的robots.txt文件,了解其爬虫政策。遵守网站的使用条款,避免对服务器造成过大负担,并尊重数据所有者的权益。错误处理:网络请求和HTML解析过程中可能会出现各种错误(如网络中断、URL错误、网页结构变化等)。在实际应用中,应加入健壮的错误处理机制(如try-except块),以提高程序的稳定性和鲁棒性。
总结
Python在网页数据抓取方面提供了丰富的工具。对于HTML表格数据,pandas.read_html()无疑是处理结构良好、静态加载表格的首选利器,它以其极简的代码和卓越的效率,极大地简化了数据提取流程。而当面对更为复杂、非标准或动态生成的表格时,BeautifulSoup则提供了更为精细的控制,能够满足更高级的定制化需求。理解并灵活运用这两种方法,将使您在网页数据抓取的实践中游刃有余。
from bs4 import BeautifulSoupimport requestsimport csvurl = 'https://www.ncaa.com/rankings/soccer-women/d1/ncaa-womens-soccer-rpi'# 1. 发送HTTP请求获取网页内容print("正在使用BeautifulSoup抓取数据...")result = requests.get(url)# 2. 使用BeautifulSoup解析HTMLsoup = BeautifulSoup(result.text, 'html.parser')# 3. 查找所有表格行 ()# 注意:通常第一行是表头,实际数据从第二行开始table_rows = soup.find_all('tr')names_lst = []conference_lst = []record_lst = []# 4. 遍历表格行,提取所需数据# 排除表头行 (table_rows[0])for row in table_rows[1:]: # 查找当前行中的所有单元格 () details = row.find_all('td') # 根据索引提取并清理文本 # 假设数据结构是:Rank, School, Conference, Record... # School 在索引1,Conference 在索引2,Record 在索引3 if len(details) > 3: # 确保有足够的列 name = details[1].text.strip() conference = details[2].text.strip() record = details[3].text.strip() names_lst.append(name) conference_lst.append(conference) record_lst.append(record)# 打印提取的数据预览print("nBeautifulSoup提取数据预览 (前5条):")print("学校名称列表:", names_lst[:5])print("联盟列表:", conference_lst[:5])print("记录列表:", record_lst[:5])# 5. 将数据保存到CSV文件with open('ncaa_rankings_bs4.csv', 'w', newline='', encoding='utf-8') as ncaa_file: csv_writer = csv.writer(ncaa_file) # 写入表头 csv_writer.writerow(['School', 'Conference', 'Record']) # 写入数据 for name, conference, record in zip(names_lst, conference_lst, record_lst): csv_writer.writerow([name, conference, record])print("n数据已使用BeautifulSoup保存到 ncaa_rankings_bs4.csv")
import pandas as pdurl = "https://www.ncaa.com/rankings/soccer-women/d1/ncaa-womens-soccer-rpi"print("n正在使用Pandas.read_html抓取数据...")# 1. 使用pandas.read_html直接读取网页中的表格# read_html会返回一个DataFrame列表,因为一个网页可能包含多个表格try: dataframes = pd.read_html(url) # 通常,我们感兴趣的表格是列表中的第一个(索引0) # 实际情况可能需要检查列表中的每个DataFrame来确定 df = dataframes[0] # 2. 打印前几行数据进行验证 print("Pandas.read_html提取数据预览 (前5条):") print(df.head()) # 3. 将DataFrame保存为CSV文件 # index=False 避免将DataFrame的索引写入CSV df.to_csv("w_soccer_rpi_pandas.csv", index=False, encoding='utf-8') print("n数据已使用Pandas保存到 w_soccer_rpi_pandas.csv")except Exception as e: print(f"读取网页表格时发生错误: {e}") print("请检查URL是否正确,或网页内容是否包含可解析的HTML表格。")
以上就是Python高效抓取网页表格数据:Pandas.read_html实战指南的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1593402.html
赞 (0)
打赏
 微信扫一扫
 支付宝扫一扫
关于作者

相关推荐
-
尽管投资创纪录,但仅有 12% 的 AI 项目实现全面部署
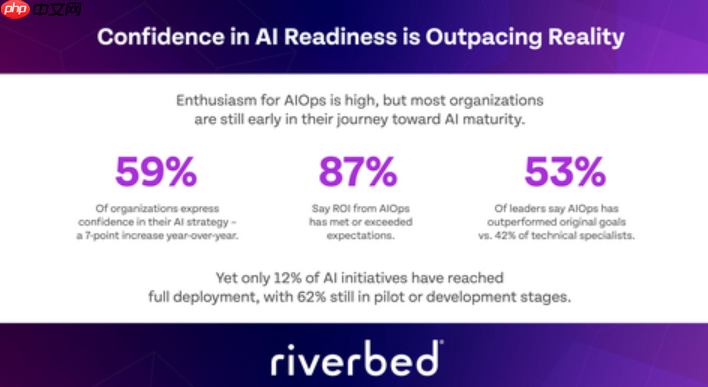


根据 Riverbed 最新发布的全球调查报告,企业在人工智能(AI)采用方面展现出强烈承诺,并正在对 IT 运营进行战略性重塑以支撑 AI 发展。尽管整体 AI 投资额几乎翻倍,且高达 87% 的组织表示其 AIOps 项目的投资回报已达到或超出预期,但仅有 12% 的 AI 项目实现了全企业范围…
-
京东短信营销的短信管理功能是什么?如何使用?解析京东短信管理功能!


在电商运营中,精准触达用户是提升转化率的关键手段之一。京东短信营销中的短信管理功能,作为连接商家与消费者的高效沟通桥梁,不仅支持活动推广、复购提醒、优惠券发放等多种营销场景,还能通过系统化的规则控制避免对用户造成骚扰。本文将全面剖析该功能的核心优势、操作流程及实用技巧,助力商家掌握低成本、高效益的精…
-
本机IP地址获取教程—实用步骤解析本机网络IP检查方式

通过命令提示符输入ipconfig可查Windows本机IP;2. macOS在系统设置网络选项中查看;3. Linux使用ip a命令查找inet地址;4. 浏览器访问ip.cn等网站可查公网IP。 想知道自己的本机IP地址?无论是排查网络问题,还是设置局域网设备,获取本机IP是基础操作。下面介绍…
-
Bukkit插件开发:正确处理物品显示名称与玩家识别
本文旨在解决Bukkit插件开发中,从BlockPlaceEvent获取物品显示名称并将其用于玩家识别时常见的“乱码”问题。我们将深入探讨Component对象与纯文本字符串的区别,并提供两种核心解决方案:直接获取放置方块的玩家名称,以及如何正确地将Component转换为纯文本字符串,以避免不必要…
-
云上书阁app如何绑定手机号_云上书阁app提升账户安全性操作
绑定手机号可提升云上书阁App账户安全性,支持通过“我的”页面或设置菜单操作:进入账号与安全选项,输入手机号并验证短信验证码即可完成绑定。 如果您希望为云上书阁App的账户增加一层保护,绑定手机号是一项关键的安全措施。完成绑定后,您将能更方便地找回密码、接收安全提醒,并提升账户的整体安全性。 本文运…
-
sublime怎么折叠所有代码_sublime代码折叠快捷方法
Sublime Text 支持多种代码折叠快捷键,Windows/Linux 使用 Ctrl + Shift + [/] 折叠/展开代码块,Ctrl + K, Ctrl + 1 展开所有用 Ctrl + K, Ctrl + J,macOS 用户将 Ctrl 替换为 Command。 在 Sublim…
-
vivo Z5的GPU是什么
vivo Z5 搭载了 Adreno 612 GPU,与前代相比,其性能提升 35%,能效更高,支持 HDR10+,兼容 Vulkan 和 OpenGL ES,并集成了 Qualcomm AI Engine,可加速机器学习任务。 vivo Z5 的 GPU vivo Z5 智能手机搭载了 Adren…
-
华硕TUF RTX 4090显卡拆解 19相供电设计分析
华硕tuf rtx 4090显卡的19相供电设计相比其他显卡具有更稳定、更纯净的电流输出优势。1. 降低纹波电压,提高gpu核心稳定性;2. 提高供电效率,降低mosfet温度;3. 增强超频潜力,提供更大性能提升空间;4. 延长显卡寿命,降低工作温度。判断其供电设计是否优秀,可从元件选择、pwm控…
-
Win10电脑亮度调节按钮怎么显示出来?
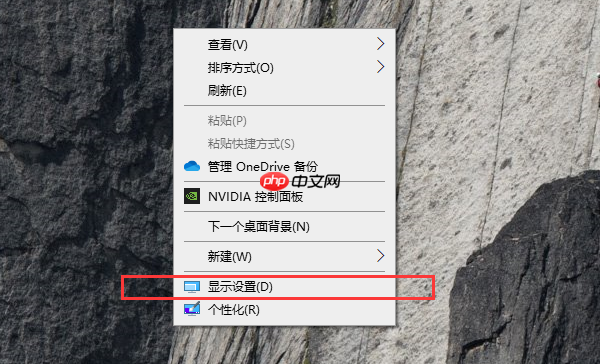
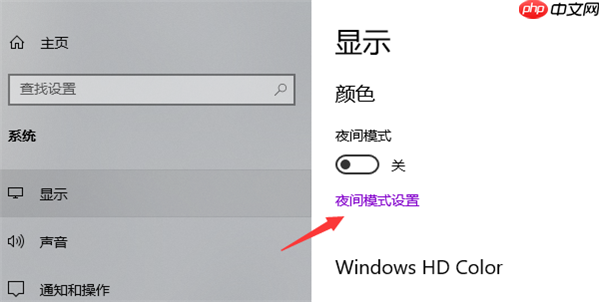
很多用户在使用电脑时常常会遇到屏幕亮度过低的问题,这会对使用体验造成影响。实际上,我们可以通过一些方法自行调整屏幕亮度。那么,如果台式电脑没有亮度调节按钮该怎么办呢?下面将为大家详细介绍解决办法。 Win10 台式电脑无亮度调节按钮的解决方法 一、显示设置 在 Win10 桌面的空白区域右键,选择“…
-
想将 AI 模型组装工具与豆包联用完成模型组装?方法详解
ai模型组装工具与豆包联用是可行且高效的,关键在于接口兼容性、数据流转和部署方式。具体步骤如下:1. 理解豆包的模型接入规范,包括支持的模型格式、api调用方式及资源需求;2. 在组装工具中完成模型构建、训练与导出,确保符合平台要求;3. 如需转换模型格式(如pytorch转onnx),使用相应工具…
-
Debian Apache日志对服务器性能有何影响

Debian系统下Apache日志对服务器性能的影响是双刃剑,既有积极作用,也有潜在的负面影响。 积极方面: 问题诊断利器: Apache日志详细记录服务器所有请求和响应,是快速定位故障的宝贵资源。通过分析错误日志,可以轻松识别配置错误、权限问题及其他异常。 安全监控哨兵: 访问日志能够追踪潜在安全…
-
荣耀 X70 开售 内置 8300mAh 超大电池 128GB 售 1399 元
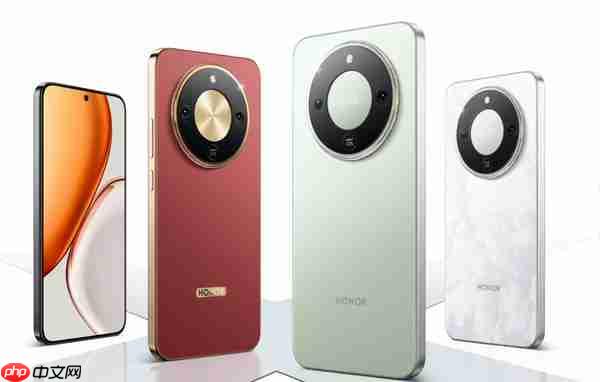
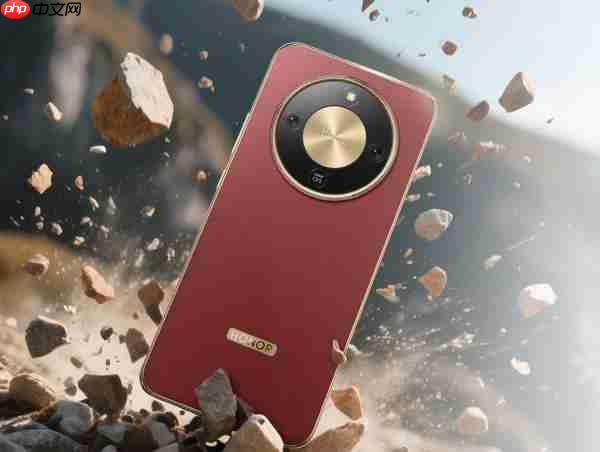
荣耀手机官方宣布,其最新千元机型——荣耀 x70 将于 7 月 18 日上午 10 点 08 分正式上市。目前该机起售价为 1399 元,叠加国家补贴后价格低至 1189 元。 核心性能方面,荣耀 X70 搭载了第四代骁龙 6 移动平台,该平台采用八核 CPU 架构,具体为 1 × A720*2.3…
-
AI Overviews如何实现数据自动备份 AI Overviews备份策略设置
ai overviews可以辅助制定数据备份策略,但不直接执行备份。1. 使用关键词搜索可获取不同平台的备份设置步骤;2. 汇总备份频率、存储位置及安全加密建议;3. 可学习选择合适工具、设定备份路径与启用加密机制;4. 避免忽略日志检查、空间预留、版本控制与单一备份依赖;5. 建议结合手动验证、通…
-
解析音调调整指令:一个Java教程
本文旨在提供一个清晰易懂的Java教程,用于解析包含音调调整指令的字符串。通过使用正则表达式,我们可以从复杂的输入字符串中提取乐器名称、调整方向和调整量。本教程将详细解释代码实现,并提供示例,帮助读者理解如何在Java中处理这类问题。 使用正则表达式解析音调调整指令 在音乐领域,音调的微调至关重要。…
-
如何利用Debian Apache日志提升网站性能

本文将阐述如何通过分析Debian系统下的Apache日志来提升网站性能。 一、日志分析基础 Apache日志记录了所有HTTP请求的详细信息,包括IP地址、时间戳、请求URL、HTTP方法和响应代码等。在Debian系统中,这些日志通常位于/var/log/apache2/access.log和/…
-
京东商智品牌版流量、交易、商品数据下载体验升级,具体升级了哪些内容? 商家必看!京东商智数据下载大升级,时段对比+滞销预警功能上线!

在数字化运营的新纪元,数据获取的精准度已成为影响商业决策的核心要素。2023年3月,京东商智品牌版正式启动对流量、交易与商品数据下载功能的全面优化升级,推出四级渠道细分维度、sku查询容量提升至100个、时间筛选更精细化等一系列关键更新,并同步完成54项服务权益的迭代升级,标志着电商平台数据分析服务…
-
货拉拉司机版怎样设置自动抢单参数_货拉拉司机版自动抢单的配置优化方法
开启自动抢单并设置合理接单范围、筛选目标订单类型、匹配出车时间段及启用顺路单优先功能,可显著提升货拉拉司机接单效率。 如果您希望在货拉拉司机版中提升接单效率,合理配置自动抢单参数是关键。系统默认设置可能无法满足高峰时段或特定区域的接单需求,因此需要根据实际运营情况调整相关选项。以下是优化自动抢单配置…
-
小熊电器回应“养生壶爆炸致一岁孩童烫伤”:正在调查当中

感谢网友 Snailwang 的线索投递! 9 月 28 日消息,9 月 27 日,一位济南网民称,当月 20 日家中使用的小熊电器玻璃养生壶突然发生爆裂,导致一名仅一岁的幼儿全身40%遭受大面积烫伤。目前该事件已引发广泛关注,小熊电器相关负责人向第一财经记者回应表示,“事件正在调查当中”。 针对此…
-
TPM 2.0芯片除了加密还有哪些实用功能?
TPM 2.0不仅是加密工具,更是硬件级安全基石,通过构建信任链确保系统启动完整性,支持安全启动、设备健康证明、凭据保护及远程认证,广泛应用于企业零信任架构、虚拟化安全与身份验证(如Windows Hello、FIDO2),实现从固件到操作系统的全流程防护。 TPM 2.0芯片远不止是加密的工具,它…
-
Java字符串高级解析:使用正则表达式处理复杂指令模式

本教程演示如何使用Java的java.util.regex包,通过正则表达式高效解析包含多条调音指令的复杂字符串。我们将学习构建匹配特定模式的正则表达式,并利用Pattern和Matcher类从输入字符串中准确提取乐器名称、调音方向和数值,从而将原始指令转换为清晰可读的输出格式。 1. 问题背景与挑…