本文旨在解决使用BeautifulSoup进行HTML元素查找时,因标签选择不当或查找范围错误而导致返回`None`的问题。通过分析常见误区,提供精准定位目标元素的策略,并结合示例代码,指导开发者如何高效、准确地从HTML内容中提取所需数据,避免常见的查找失败和程序异常。
引言:理解BeautifulSoup的元素查找机制
BeautifulSoup是一个强大的Python库,用于从HTML或XML文件中提取数据。它提供了两种主要的查找方法:
find(name, attrs, recursive, string, **kwargs):查找并返回第一个匹配的标签。如果未找到任何匹配项,则返回None。find_all(name, attrs, recursive, string, limit, **kwargs)(或旧版中的findAll):查找并返回所有匹配的标签列表。如果未找到任何匹配项,则返回一个空列表[]。
理解这两种方法在未找到元素时的返回值差异至关重要,因为None值在后续操作中如果不加以处理,很容易导致AttributeError。
常见问题:错误的标签选择与查找范围
在进行网页数据抓取时,开发者常遇到的一个问题是,即使确信目标元素存在于HTML内容中,BeautifulSoup的查找方法却返回None或空列表。这通常源于以下几个原因:
立即学习“前端免费学习笔记(深入)”;
标签名称不准确: 目标标签名拼写错误,或与HTML实际结构不符。查找范围过大或过小: 在整个文档中查找一个特定子元素,或者在一个不包含目标元素的父元素中查找。误解HTML结构: 混淆了父子标签关系,例如,试图直接在soup对象上查找一个通常嵌套在其他标签内部的元素,而没有先定位其父级。
考虑以下示例代码,它试图从一个网页中提取表格数据:
import requests, bs4, html5libfrom bs4 import BeautifulSoupurl = "https://trouver-ip.com"ip = input("Choisissez une IP : ")response = requests.post(url, data={"ip": ip})soup = BeautifulSoup(response.text, "html.parser")def compare(): if soup.find("tbody"): # 检查是否存在 标签 tableau = soup.findAll("html") # 接着查找所有的 标签 return tableau else: print("Aucun résultat, foirage de code masturbin")tableau = compare()print(tableau)
这段代码的问题在于,尽管它首先通过if soup.find(“tbody”)检查了
是否存在,但紧接着的tableau = soup.findAll(“html”)却试图查找整个文档的根标签。这意味着:即使存在,findAll(“html”)也只会返回一个包含根标签的列表,而不是表格内部的数据。如果期望获取的是表格内容,这种查找方式显然是错误的。findAll(“html”)几乎总是返回整个文档的根标签,与表格数据无关。因此,最终的结果往往不是开发者所期望的表格信息,甚至可能因为后续对tableau的操作不当而引发错误。
解决方案:精准定位目标元素
解决上述问题的关键在于精准定位。如果我们的目标是表格数据,那么应该直接查找
标签,然后在其内部进一步查找、(行)、(单元格)等。
以下是优化后的代码示例,展示了如何正确地查找和提取表格数据:
import requestsfrom bs4 import BeautifulSoupimport html5lib # 导入html5lib,可用于更健壮的解析,尽管示例中使用html.parserdef extract_table_data(url: str, ip_address: str): """ 从指定URL获取内容,解析HTML,并尝试提取表格数据。 Args: url (str): 目标网页的URL。 ip_address (str): 用于POST请求的IP地址数据。 Returns: bs4.Tag or None: 如果找到表格元素则返回该BeautifulSoup标签对象,否则返回None。 """ try: # 发送POST请求获取网页内容 response = requests.post(url, data={"ip": ip_address}) response.raise_for_status() # 检查HTTP请求是否成功,如果状态码不是200,则抛出异常 # 使用BeautifulSoup解析HTML内容 # 可以选择 "html.parser" (Python内置) 或 "lxml", "html5lib" (需要额外安装,更健壮) soup = BeautifulSoup(response.text, "html.parser") # 核心改进:直接查找 'table' 标签 # 如果页面中存在多个表格,可以通过属性(如 class, id)进行更精确的查找, # 例如:soup.find("table", class_="data-table") 或 soup.find(id="main-table") target_table = soup.find("table") if target_table: print("成功找到表格元素。") # 如果需要进一步提取表格内部的行或单元格,可以在这里继续操作 # 例如: # table_body = target_table.find("tbody") # if table_body: # table_rows = table_body.find_all("tr") # for row in table_rows: # cells = row.find_all(["td", "th"]) # 查找行内的所有数据单元格和表头单元格 # row_data = [cell.get_text(strip=True) for cell in cells] # print(row_data) return target_table else: print("未找到任何表格元素,请检查HTML结构或目标标签。") return None except requests.exceptions.RequestException as e: print(f"请求失败: {e}") return None except Exception as e: print(f"解析或处理错误: {e}") return None# 示例用法if __name__ == "__main__": target_url = "https://trouver-ip.com" user_ip = input("请输入要查询的IP地址:") # 调用函数提取数据 extracted_table = extract_table_data(target_url, user_ip) if extracted_table: print("\n--- 提取到的表格内容片段 (前200字符) ---") # 为了避免输出过长,只打印表格内容的前200个字符 print(str(extracted_table)[:200] + "...") # 可以在这里继续处理 extracted_table,例如解析行和单元格 else: print("\n未能成功提取表格数据。")
在上述代码中,我们将查找逻辑封装在extract_table_data函数中,并进行了以下改进:
直接查找: 不再使用soup.findAll(“html”),而是直接使用soup.find(“table”)来定位目标表格。None值检查: 在使用target_table之前,通过if target_table:进行检查,确保其不为None,从而避免AttributeError。异常处理: 增加了try…except块来处理requests请求可能出现的网络错误,以及BeautifulSoup解析可能遇到的其他异常,使程序更加健壮。清晰的注释: 解释了代码的意图和可能的扩展方向。
注意事项与最佳实践
明确目标标签和属性: 在编写BeautifulSoup代码之前,务必使用浏览器开发者工具(F12)检查目标网页的HTML结构。确定要查找的精确标签名(如div, p, a, table)、类名(class)或ID(id)。例如,如果表格有id=”data-table”,则使用soup.find(“table”, id=”data-table”)会更精确。缩小查找范围(链式查找): 一旦找到一个父元素,可以在该父元素内部继续查找其子元素,而不是每次都从整个soup对象开始。这不仅提高了查找效率,也减少了误匹配的可能性。例如:
main_div = soup.find("div", class_="content")if main_div: table_in_div = main_div.find("table") # 在 main_div 内部查找 table
始终检查find()的返回值: find()方法在找不到元素时返回None。在尝试访问None对象的属性(如None.text)或调用其方法(如None.find())之前,务必进行None值检查。选择合适的解析器:“html.parser”:Python内置,速度适中,不需要额外安装。”lxml”:速度最快,但需要pip install lxml。对格式不规范的HTML有较好的容错性。”html5lib”:最健壮的解析器,能够处理极度不规范的HTML,模仿浏览器解析行为,但速度最慢,需要pip install html5lib。根据项目的需求和HTML的质量选择合适的解析器。处理空列表: find_all()在找不到元素时返回空列表[]。在遍历或访问列表元素之前,可以检查列表是否为空,例如if my_list:。善用get_text()和strip=True: 提取标签内的文本内容时,使用tag.get_text(strip=True)可以去除文本前后的空白字符和换行符,使数据更干净。
总结
在使用BeautifulSoup进行HTML元素查找时,核心在于理解其查找机制并精准定位目标元素。避免因标签选择错误、查找范围不当或未处理None返回值而导致的程序异常。通过结合浏览器开发者工具分析HTML结构、采用链式查找、严格进行None值检查以及选择合适的解析器,可以大大提高数据抓取的效率和代码的健壮性。掌握这些技巧,将使您在Python爬虫开发中更加得心应手。
以上就是BeautifulSoup中正确查找HTML元素:解决‘None’返回值问题的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/1602010.html
赞 (0)
打赏
 微信扫一扫
 支付宝扫一扫
关于作者

相关推荐
-
谷歌浏览器如何备份登录网址和账号密码
备份谷歌浏览器中保存的所有登录网址和账号密码,是一项预防数据丢失或方便迁移数据的重要操作。通过浏览器内置的导出功能,您可以将所有这些敏感信息打包成一个文件,保存在您的本地计算机上。本文将详细介绍完成这一备份过程的每一个步骤,并提供相关的安全建议。 立即进入“高清国产电影网站合集☜☜☜☜☜点击保存”;…
-
NVIDIA App 测试版发布!耕升教你如何轻松上手
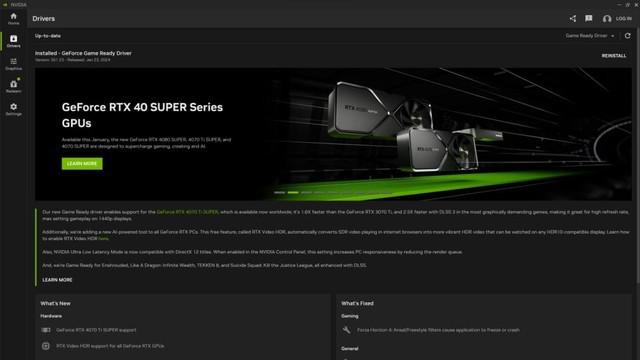
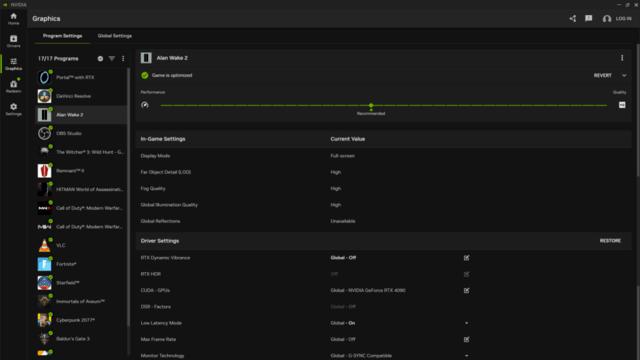
2024年2月22日晚上10点,nvidia发布了nvidiaapp测试版。这一应用将取代geforce experience,为玩家和内容创作者提供新的工具,助力他们的生活。搭载英伟达geforce rtx显卡的电脑性能将得到全面提升。 各位用户现在只需前往 NVIDIA 官网,即可轻松下载该 A…
-
苹果手机声音太小怎么解决
一、确认音量调节是否到位 遇到苹果手机声音偏小的情况,首先应检查设备的音量设置是否已调至合适水平。可通过机身侧面的音量加减键,或从屏幕右上角下滑打开控制中心,分别调节铃声、媒体播放和闹钟的音量。确保各项音量已提升到最大,避免因误操作导致音量过低。 二、清洁扬声器与听筒部位 随着使用时间增长,手机的扬…
-
Tailwind CSS自定义变体失效了,为什么我的hover效果没生效?
Tailwind CSS自定义变体失效的排查与解决 Tailwind CSS的自定义变体功能十分强大,但有时会遇到失效的情况。本文通过一个案例分析,讲解自定义变体失效的常见原因及解决方法。 案例:开发者尝试创建一个自定义变体,用于在元素悬停时改变文本颜色。在tailwind.config.js中定义…
-
卢伟冰:小米将推出首款AI PC产品
小米发布首款ai pc,续航强劲可登机!小米集团总裁卢伟冰在2月22日晚的小米15 ultra爆料直播中重磅宣布,小米将推出其首款ai个人电脑产品。 ☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 免费无限量使用 DeepSeek R1 模型☜☜☜ 这款AI PC的一大亮点是其搭载的99Wh超…
-
win11打印机显示脱机怎么解决_修复Win11打印机脱机无法打印的问题
首先检查并取消“脱机使用打印机”模式,通过控制面板进入设备和打印机界面,右键点击打印机选择查看正在打印的内容,在打印机菜单中取消勾选脱机使用打印机;随后可运行系统自带的打印机疑难解答,打开“获取帮助”工具并搜索打印机问题,按向导自动修复;若仍无效,需重新配置TCP/IP端口连接,添加标准TCP/IP…
-
如何解决PHP邮件处理中的IMAP问题?使用webklex/php-imap可以!
最近在开发一个需要处理邮件的PHP项目时,我遇到了一个棘手的问题:由于服务器环境的限制,无法启用php-imap模块,这使得我无法进行IMAP操作。尝试了多种方法后,我最终通过使用webklex/php-imap库成功解决了这个问题。 可以通过以下地址学习composer:学习地址 webklex/…
-
谷歌账号广告投放费用详解_谷歌广告投放的成本与预算规划
谷歌广告成本受竞价机制、关键词竞争度、质量得分、广告排名、行业特性、地理位置、广告类型和匹配方式等多因素影响;2. 合理规划预算需明确营销目标、从小预算测试开始、使用关键词规划师、持续监控优化、精准定位受众并善用再营销;3. 提升roi的关键策略包括优化质量得分、进行a/b测试、采用自动化出价、精细…
-
OneDrive存储空间怎么查看_OneDrive剩余空间查询方法
通过网页端登录onedrive.com,在设置中查看存储摘要可获取已用空间和总容量;2. 在Windows桌面客户端右键任务栏OneDrive图标,进入账户设置可跳转查看存储详情;3. 使用手机应用在设置中查找存储选项,可查看剩余容量与使用分布。 如果您无法确定OneDrive云存储的使用情况,可能…
-
win10怎么解决麦克风没声音_win10电脑麦克风没有声音的解决方法
首先检查麦克风权限设置,确保系统和应用允许访问;接着在声音设置中将麦克风设为默认录制设备并观察输入电平;然后通过设备管理器更新或重新安装音频驱动;运行Windows音频疑难解答工具检测并修复问题;最后检查物理连接、静音开关及硬件状态,排除外部故障。 如果您在使用Windows 10电脑时发现麦克风没…
-
如何解决浏览器驱动安装的烦恼?使用Composer和dbrekelmans/bdi可以轻松搞定!
可以通过以下地址学习 Composer:学习地址 在自动化测试中,浏览器驱动的安装和配置常常是一个令人头疼的问题。我最近在开发一个项目时,遇到了一系列麻烦:不同版本的浏览器需要不同的驱动,安装过程繁琐且容易出错,导致测试环境的搭建变得异常艰难。每次更新浏览器版本后,都需要重新下载和配置驱动,这不仅浪…
-
React中Promise和箭头函数大括号:异步操作的返回值为何不同?
react异步操作中promise与箭头函数大括号的差异 本文探讨React中使用Promise和箭头函数时,大括号的使用如何影响异步操作的返回值。 核心问题在于箭头函数的隐式返回机制。 我们以get函数为例,对比两种不同的实现方式: 正确写法 (隐式返回): get: () => new P…
-
如何管理谷歌浏览器插件 Chrome浏览器扩展安装使用教程
管理Chrome扩展能提升浏览器性能、保障隐私安全并避免功能冲突。通过Chrome网上应用店安装扩展时需注意权限请求,定期在chrome://extensions页面启用、禁用或移除不必要扩展,防止资源占用和潜在风险。使用隐身模式测试、逐一禁用扩展、更新或重新安装可解决冲突与故障,确保浏览流畅稳定。…
-
MediaCodec解码视频导致闪退或重启,如何优化内存问题?
MediaCodec解码视频导致闪退或重启的内存优化策略 使用MediaCodec解码播放视频时,长时间运行可能导致内存问题,引发应用闪退或设备重启。这通常与内存泄漏或内存管理不善有关。以下是一些优化建议: 1. 优化ByteBuffer管理: 代码中直接分配的ByteBuffer ( ByteBu…
-
MAC系统怎么查看当前占满内存的程序_MAC查看占用内存程序方法
使用活动监视器可实时查看内存占用情况,通过“内存”标签页排序并强制退出高占用程序;2. 在系统设置的储存空间中分析应用体积,识别可能消耗大量内存的程序;3. 终端输入top -o mem命令,快速列出按内存使用排序的进程,便于精准定位资源占用源。 如果您发现Mac运行缓慢或提示内存不足,很可能是某些…
-
浏览器指纹的危害是什么呢 用户隐私泄露风险深度分析
浏览器指纹通过收集设备和浏览器特征生成唯一标识,比Cookie更难清除,威胁隐私。它利用用户代理、屏幕分辨率、字体、Canvas渲染等信息构建“数字DNA”,即使清除Cookie、切换IP或使用隐身模式也难以摆脱。与传统Cookie不同,指纹追踪无需存储数据,而是基于设备固有属性,实现隐蔽、持久的跨…
-
Blender如何找到对齐物体功能
在blender中,对齐物体是一项极为实用的功能,能够帮助用户快速、精确地调整物体的位置与方向。那么,这个功能究竟该如何调用呢? 首先,启动Blender并进入你正在工作的场景。选中需要对齐的物体后,有多种方式可以访问对齐工具。 其一,可通过顶部菜单栏的“视图”选项进行操作。点击“视图”后,在下拉菜…
-
windows蓝屏解决方案
蓝屏主因是驱动冲突、硬件故障或系统文件损坏,解决需按顺序排查:先记录错误代码,回溯最近操作并回滚驱动或使用系统还原;进入安全模式卸载新软件或更新;检查设备管理器中的驱动问题,用DDU清理显卡驱动;运行sfc /scannow和DISM修复系统文件;通过MemTest86测内存、CrystalDisk…
-
点击进入ao3网页版网站 ao3网页版无删减内容开放
AO3通过非营利运营、社区驱动和精细内容标签系统实现内容开放,用户可利用分级与标签筛选无删减作品。 要访问AO3网页版并体验其无删减的丰富内容,最直接的方式就是通过其官方网址:archiveofourown.org。这是一个全球性的、由粉丝运营的非营利性网站,致力于提供一个开放、包容的创作和分享平台…
-
悟空浏览器打开网页显示不安全_悟空浏览器“不安全”提示原因及解决
悟空浏览器提示“不安全”通常因连接未加密或证书异常。首先检查网址是否为HTTPS,手动将http://改为https://并确认锁形图标显示;若支持HTTPS则可安全使用。其次查看SSL证书信息,确认有效期及域名匹配,避免访问证书过期或无效的网站。注意混合内容问题,即网页主连接为HTTPS但子资源通…