1.COUNT(1)、COUNT(*)与COUNT(字段)哪个更快?
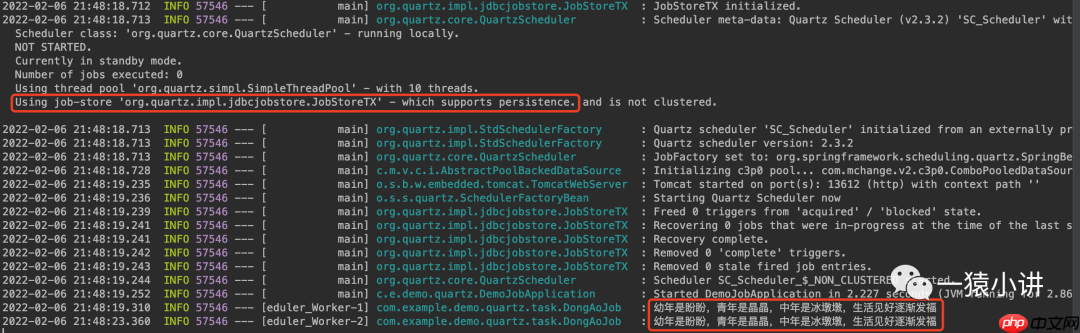
执行效果:
COUNT(*)MySQL 对count(*)进行了优化,count(*)直接扫描主键索引记录,并不会把全部字段取出来,直接按行累加。
COUNT(1)InnoDB引擎遍历整张表,但不取值,server 层对于返回的每一行,放一个数字“1”进去,按行累加。
COUNT(字段)如果这个“字段”是定义为NOT NULL,那么InnoDB 引擎会一行行地从记录里面读出这个字段,server 层判断不能为NULL,按行累加;如果这个“字段”定义允许为NULL,那么InnoDB 引擎会一行行地从记录里面读出这个字段,然后把值取出来再判断一下,不是 NULL才累加。
实验分析
本文测试使用的环境:
[root@zhyno1 ~]# cat /etc/system-releaseCentOS Linux release 7.9.2009 (Core)[root@zhyno1 ~]# uname -aLinux zhyno1 3.10.0-1160.62.1.el7.x86_64 #1 SMP Tue Apr 5 16:57:59 UTC 2022 x86_64 x86_64 x86_64 GNU/Linux
测试数据库采用的是(存储引擎采用InnoDB,其它参数默认):
(Mon Jul 25 09:41:39 2022)[root@GreatSQL][(none)]>select version();+-----------+| version() |+-----------+| 8.0.25-16 |+-----------+1 row in set (0.00 sec)
实验开始:
#首先我们创建一个实验表CREATE TABLE test_count ( `id` int(10) NOT NULL AUTO_INCREMENT PRIMARY KEY, `name` varchar(20) NOT NULL, `salary` int(1) NOT NULL, KEY `idx_salary` (`salary`)) ENGINE=InnoDB DEFAULT CHARSET=utf8;#插入1000W条数据DELIMITER //CREATE PROCEDURE insert_1000w()BEGIN DECLARE i INT; SET i=1; WHILE i<=10000000 DO INSERT INTO test_count(name,salary) VALUES('KAiTO',1); SET i=i+1; END WHILE;END//DELIMITER ;#执行存储过程call insert_1000w();
接下来我们分别来实验一下:
COUNT(1)花费了4.19秒
(Sat Jul 23 22:56:04 2022)[root@GreatSQL][test]>select count(1) from test_count;+----------+| count(1) |+----------+| 10000000 |+----------+1 row in set (4.19 sec)
COUNT(*)花费了4.16秒
(Sat Jul 23 22:57:41 2022)[root@GreatSQL][test]>select count(*) from test_count;+----------+| count(*) |+----------+| 10000000 |+----------+1 row in set (4.16 sec)
COUNT(字段)花费了4.23秒
(Sat Jul 23 22:58:56 2022)[root@GreatSQL][test]>select count(id) from test_count;+-----------+| count(id) |+-----------+| 10000000 |+-----------+1 row in set (4.23 sec)
我们可以再来测试一下执行计划
COUNT(*)
(Sat Jul 23 22:59:16 2022)[root@GreatSQL][test]>explain select count(*) from test_count;+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+| 1 | SIMPLE | test_count | NULL | index | NULL | idx_salary | 4 | NULL | 9980612 | 100.00 | Using index |+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+1 row in set, 1 warning (0.01 sec)(Sat Jul 23 22:59:48 2022)[root@GreatSQL][test]>show warnings;+-------+------+-----------------------------------------------------------------------+| Level | Code | Message |+-------+------+-----------------------------------------------------------------------+| Note | 1003 | /* select#1 */ select count(0) AS `count(*)` from `test`.`test_count` |+-------+------+-----------------------------------------------------------------------+1 row in set (0.00 sec)
COUNT(1)
(Sat Jul 23 23:12:45 2022)[root@GreatSQL][test]>explain select count(1) from test_count;+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+| 1 | SIMPLE | test_count | NULL | index | NULL | idx_salary | 4 | NULL | 9980612 | 100.00 | Using index |+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+1 row in set, 1 warning (0.00 sec)(Sat Jul 23 23:13:02 2022)[root@GreatSQL][test]>show warnings;+-------+------+-----------------------------------------------------------------------+| Level | Code | Message |+-------+------+-----------------------------------------------------------------------+| Note | 1003 | /* select#1 */ select count(1) AS `count(1)` from `test`.`test_count` |+-------+------+-----------------------------------------------------------------------+1 row in set (0.00 sec)
COUNT(字段)
(Sat Jul 23 23:13:14 2022)[root@GreatSQL][test]>explain select count(id) from test_count;+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+| 1 | SIMPLE | test_count | NULL | index | NULL | idx_salary | 4 | NULL | 9980612 | 100.00 | Using index |+----+-------------+------------+------------+-------+---------------+------------+---------+------+---------+----------+-------------+1 row in set, 1 warning (0.00 sec)(Sat Jul 23 23:13:29 2022)[root@GreatSQL][test]>show warnings;+-------+------+-----------------------------------------------------------------------------------------------+| Level | Code | Message |+-------+------+-----------------------------------------------------------------------------------------------+| Note | 1003 | /* select#1 */ select count(`test`.`test_count`.`id`) AS `count(id)` from `test`.`test_count` |+-------+------+-----------------------------------------------------------------------------------------------+1 row in set (0.00 sec)
需要注意的是COUNT里如果是非主键字段的话
(Tue Jul 26 14:01:57 2022)[root@GreatSQL][test]>explain select count(name) from test_count where id <100 ;+----+-------------+------------+------------+-------+---------------+---------+---------+------+------+----------+-------------+| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |+----+-------------+------------+------------+-------+---------------+---------+---------+------+------+----------+-------------+| 1 | SIMPLE | test_count | NULL | range | PRIMARY | PRIMARY | 4 | NULL | 99 | 100.00 | Using where |+----+-------------+------------+------------+-------+---------------+---------+---------+------+------+----------+-------------+1 row in set, 1 warning (0.00 sec)
实验结果
1.从上面的实验我们可以得出,COUNT(*)和COUNT(1)是最快的,其次是COUNT(id)。
2.count(*)被MySQL查询优化器改写成了count(0),并选择了idx_salary索引。
3.count(1)和count(id)都选择了idx_salary索引。
实验结论
总结:COUNT(*)=COUNT(1)>COUNT(id)
MySQL的官方文档也有说过:
InnoDB handles SELECT COUNT(*) and SELECT COUNT(1) operations in the same way. There is no performance difference
翻译: InnoDB以相同的方式处理SELECT COUNT(*)和SELECT COUNT(1)操作。没有性能差异
所以说明了对于COUNT(1)或者是COUNT(*),MySQL的优化其实是完全一样的,没有存在没有性能的差异。
但是建议使用COUNT(*),因为这是MySQL92定义的标准统计行数的语法。
2.COUNT(*)与TABLES_ROWS
在InnoDB中,MySQL数据库每个表占用的空间、表记录的行数可以打开MySQL的information_schema数据库。在该库中有一个TABLES表,这个表主要字段分别是:
TABLE_SCHEMA : 数据库名
TABLE_NAME:表名
ENGINE:所使用的存储引擎
TABLES_ROWS:记录数
DATA_LENGTH:数据大小
INDEX_LENGTH:索引大小
TABLE_ROWS用于显示这个表当前有多少行,这个命令执行挺快的,那这个TABLE_ROWS能代替count(*)吗?
我们用TABLES_ROWS查询一下表记录条数:
(Sat Jul 23 23:15:14 2022)[root@GreatSQL][test]>SELECT TABLE_ROWS -> FROM INFORMATION_SCHEMA.TABLES -> WHERE TABLE_NAME = 'test_count';+------------+| TABLE_ROWS |+------------+| 9980612 |+------------+1 row in set (0.03 sec)
可以看到,记录的条数并不准确,因为InnoDB引擎下TABLES_ROWS行计数仅是大概估计值。
3.COUNT(*)是怎么样执行的?
首先要明确的是,MySQL有多种不同引擎,在不同的引擎中,count(*)有不同的实现方式,本文主要介绍的是在InnoDB引擎上的执行流程
在InnoDB存储引擎中,count(*)函数是先从内存中读取表中的数据到内存缓冲区,然后扫描全表获得行记录数的。简单来说就是全表扫描,一个循环解决问题,循环内: 先读取一行,再决定该行是否计入count循环内是一行一行进行计数处理的。
在MyISAM引擎中是把一个表的总行数存在了磁盘上,因此执行count(*)的时候会直接返回这个数,效率很高。
之所以InnoDB 不跟 MyISAM一样把数字存起来,是因为即使是在同一个时刻的多个查询,由于多版本并发控制(MVCC)的原因,InnoDB表应该返回多少行也是不确定的。无论在事务支持、并发能力还是数据安全方面,InnoDB都比MyISAM表现更优。
虽然如此,InnoDB对于count(*)操作还是做了优化的。InnoDB是索引组织表,主键索引树的叶子节点是数据,而普通索引树的叶子节点是主键值。所以,普通索引树比主键索引树小很多。对于count(*)这样的操作,遍历哪个索引树得到的结果逻辑上都是一样的。因此,MySQL 优化器会找到最小的那棵树来遍历。
需要注意的是我们在这篇文章里讨论的是没有过滤条件的count(*),如果加了WHERE条件的话,MyISAM引擎的表也是不能返回得这么快的。
4.总结
1.COUNT(*)=COUNT(1)>COUNT(id)
2.COUNT函数的用法,主要用于统计表行数。主要用法有COUNT(*)、COUNT(字段)和COUNT(1)
3.因为COUNT(*)是SQL92定义的标准统计行数的语法,所以MySQL对他进行了很多优化,MyISAM中会直接把表的总行数单独记录下来供COUNT(*)查询,而InnoDB则会在扫表的时候选择最小的索引来降低成本。这些优化的前提是没有进行WHERE和GROUP的条件查询。
4.在InnoDB中COUNT(*)和COUNT(1)实现上没有区别,而且效率一样,但是COUNT(字段)需要进行字段的非NULL判断,所以效率会低一些。
5.因为COUNT(*)是SQL92定义的标准统计行数的语法,并且效率高,所以还是建议使用COUNT(*)查询表的行数。
6.正如前面COUNT(name)的用例那样,在建表过程中需要根据业务需求建立性能较高的索引,同时也要注意避免建立不必要的索引。
以上就是MySQL COUNT(*)性能原理是什么的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/160550.html
 微信扫一扫
 支付宝扫一扫