深入学习MySQL中的逻辑查询

查询是mysql中的最频繁操作,它也是用于构建delete、update的基础;而查询处理可分为逻辑查询和物理查询。今天我们就来给大家详细介绍一下逻辑查询,希望对大家有所帮助!

深入学习MySQL中的逻辑查询

在MySQL中,查询是用于构建DELETE、UPDATE的基础,因为你要删除或者更新他们时,首先就是要查出这些记录,所以SELECT显的尤为重要,对于查询处理,可以分为逻辑查询和物理查询,逻辑查询表示执行SELECT语句时应该产生什么样的结果,而物理查询表示MySQL如何得到这个结果的。【相关推荐:mysql视频教程】

本章来说一下逻辑查询。

在SQL语句中,最先处理的就是FROM语句,最后执行的是LIMIT语句,如果把所有的语句都用上,如GROUP BY、ORDER BY,那么大致可以分为10个步骤,如下所示,每个操作都会产生一张虚拟表。

(7) select (8)distinct(1) from (3)  join (2)    on(4) where (5) group by(6) having(9) order by(10) limit

下面通过一个实际例子来分析一下,首先创建两张表,用户和订单。

mysql> create table user (userId int(11),userName varchar(255),city varchar(255), primary key (userId));Query OK, 0 rows affected, 1 warning (0.05 sec)mysql> create table orders(orderId int(11) ,userId int(11) ,primary key (orderId));Query OK, 0 rows affected, 2 warnings (0.05 sec)

插入数据。

insert user values(1,"张三","内蒙");insert user values(2,"李四","内蒙");insert user values(3,"王五","北京");insert user values(4,"迪迦","西藏");insert user values(5,"金甲战士","内蒙");insert orders values(10001,1);insert orders values(10002,1);insert orders values(10003,4);insert orders values(10004,1);insert orders values(10005,1);insert orders values(10006,4);insert orders values(10007,2);

好,现在来查询一下来自内蒙,且订单数量小于3的用户,SQL如下。

mysql> select userName,count(orders.orderId) as total from user left join orders on user.userId = orders.userId where city="内蒙" group by user.userId having count(orders.orderId)<3 order by total desc;+--------------+-------+| userName     | total |+--------------+-------+| 李四         |     1 || 金甲战士     |     0 |+--------------+-------+2 rows in set (0.00 sec)

有数据有SQL,下面分析一下具体流程。

1. 笛卡尔乘积

首先要做的是对FROM语句前后的两张表进行笛卡尔乘积,那么什么是笛卡尔乘积?举个例子来说,假设集合A={a, b},集合B={0, 1, 2},则两个集合的笛卡尔积为{(a, 0), (a, 1), (a, 2), (b, 0), (b, 1), (b, 2)}。

所以,对应上面的数据,最终会产生一张虚拟表VT1,他将包含35行数据,具体数据如下所示。

userId userName city orderId userId

1张三内蒙1000111张三内蒙1000211张三内蒙1000341张三内蒙1000511张三内蒙1000611张三内蒙1000541张三内蒙100072………………

5金甲战士内蒙1000115金甲战士内蒙100021

2. ON过滤器

下一步,通过ON后面的添加过滤掉不需要的数据,在上述SQL中,条件是user.userId = orders.userId ,所以通过上面生成的虚拟表VT1,除去不相关的数据,生成新的虚拟表VT2,最终的结果如下。

+--------+--------------+--------+---------+--------+| userId | userName     | city   | orderId | userId |+--------+--------------+--------+---------+--------+|      1 | 张三         | 内蒙   |   10005 |      1 ||      1 | 张三         | 内蒙   |   10004 |      1 ||      1 | 张三         | 内蒙   |   10002 |      1 ||      1 | 张三         | 内蒙   |   10001 |      1 ||      2 | 李四         | 内蒙   |   10007 |      2 ||      3 | 王五         | 北京   |    NULL |   NULL ||      4 | 迪迦         | 西藏   |   10006 |      4 ||      4 | 迪迦         | 西藏   |   10003 |      4 ||      5 | 金甲战士     | 内蒙   |    NULL |   NULL |+--------+--------------+--------+---------+--------+

3.添加外部行

这一步只有在连接类型为OUTER JOIN才发生。

LEFT OUTER JOIN把左表记为保留表,RIGHT OUTER JOIN把右表作为保留表,FULL OUTER JOIN表示都作为保留表,添加外部行的工作就是在上一步的基础上添加保留表中被过滤条件过滤掉的数据,非保留表的数据被赋值NULL。

最终生成下面的结果,记为虚拟表VT3。

+--------+--------------+--------+---------+--------+| userId | userName     | city   | orderId | userId |+--------+--------------+--------+---------+--------+|      1 | 张三         | 内蒙   |   10005 |      1 ||      1 | 张三         | 内蒙   |   10004 |      1 ||      1 | 张三         | 内蒙   |   10002 |      1 ||      1 | 张三         | 内蒙   |   10001 |      1 ||      2 | 李四         | 内蒙   |   10007 |      2 ||      3 | 王五         | 北京   |    NULL |   NULL ||      4 | 迪迦         | 西藏   |   10006 |      4 ||      4 | 迪迦         | 西藏   |   10003 |      4 ||      5 | 金甲战士     | 内蒙   |    NULL |   NULL |+--------+--------------+--------+---------+--------+

4. WHERE过滤器

这一步很简单,条件为city="内蒙" ,即只保留下city为内蒙的列,并生成新的虚拟表VT4。最终结果如下。

+--------+--------------+--------+---------+--------+| userId | userName     | city   | orderId | userId |+--------+--------------+--------+---------+--------+|      1 | 张三         | 内蒙   |   10005 |      1 ||      1 | 张三         | 内蒙   |   10004 |      1 ||      1 | 张三         | 内蒙   |   10002 |      1 ||      1 | 张三         | 内蒙   |   10001 |      1 ||      2 | 李四         | 内蒙   |   10007 |      2 ||      5 | 金甲战士     | 内蒙   |    NULL |   NULL |+--------+--------------+--------+---------+--------+

5. GROUP BY 分组

这步将上一个步骤进行分组,并生成新的虚拟表VT5,结果如下。

+--------+--------------+--------+| userId | userName     | city   |+--------+--------------+--------+|      1 | 张三         | 内蒙   ||      2 | 李四         | 内蒙   ||      5 | 金甲战士     | 内蒙   |+--------+--------------+--------+

6.HAVING筛选

分完组,我们就可以筛选了,选出count(orders.orderId)<3 的数据即可,最终结果如下。

| userId | userName     | city   | count(orders.orderId) |+--------+--------------+--------+-----------------------+|      2 | 李四         | 内蒙   |                     1 ||      5 | 金甲战士     | 内蒙   |                     0 |+--------+--------------+--------+-----------------------+

7.处理SELECT列表

虽然SELECT是查询中最先被指定的部分,但是直到这里才真正进行处理,在这一步,将SELECT中指定的列从上一步产生的虚拟表中选出。

8.应用DISTINCT

如果查询语句中存在DISTINCT子句,则会创建一张内存临时表,这张内存临时表的表结构和上一步产生的虚拟表一样,不同的是对进行DISTINCT操作的列增加了一个唯一索引,以此来去除重复数据。

另外对使用了GROUP BY语句的查询,再使用DISTINCT是多余的,因为已经进行了分组,不会移除任何行。

9.排序和LIMIT

最后就是排序,返回新的虚拟表。结果如下。

+--------------+-------+| userName     | total |+--------------+-------+| 李四         |     1 || 金甲战士     |     0 |+--------------+-------+

但是在本例子中没有使用到LIMIT,如果使用到了,那么则从选出指定位置开始的指定行数,

原文地址:https://juejin.cn/post/7000739902937628679作者:i听风逝夜

更多编程相关知识,请访问:编程视频!!

以上就是深入学习MySQL中的逻辑查询的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/185074.html

赞 (0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫
上一篇 2026年9月4日 17:49:42
前捷豹路虎高管加入FF 担任FF Par销售和售后高级总监
下一篇 2026年9月4日 17:53:42

相关推荐

  • MySQL如何压缩数据库 表空间压缩与备份压缩方案

    MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案MySQL如何压缩数据库 表空间压缩与备份压缩方案

    mysql数据库压缩需求评估需先明确数据类型与业务场景。1.文本数据压缩率高,图片、视频等二进制数据压缩效果差;2.频繁读写数据压缩可能影响性能,冷数据压缩收益更高;3.通过查询information_schema分析大表与低频更新表;4.使用监控工具评估压缩前后性能影响。表空间压缩方法包括:1.使…

    2026年9月30日 • 用户投稿
    200
  • Sublime进行数据库索引优化分析_提升数据查询性能与响应速度

    Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度Sublime进行数据库索引优化分析_提升数据查询性能与响应速度

    使用sublime text辅助数据库索引优化分析,一、通过慢查询日志定位瓶颈,利用多行选择和正则表达式筛选耗时sql;二、结合执行计划判断索引使用情况,关注type和extra字段;三、检查表结构与索引定义,优化复合索引顺序及删除冗余索引。 在处理大量数据时,数据库的查询性能直接影响到系统的响应速…

    2026年9月30日 • 用户投稿
    100
  • 服务器上安装Mysql8.0

    服务器上安装Mysql8.0服务器上安装Mysql8.0服务器上安装Mysql8.0服务器上安装Mysql8.0

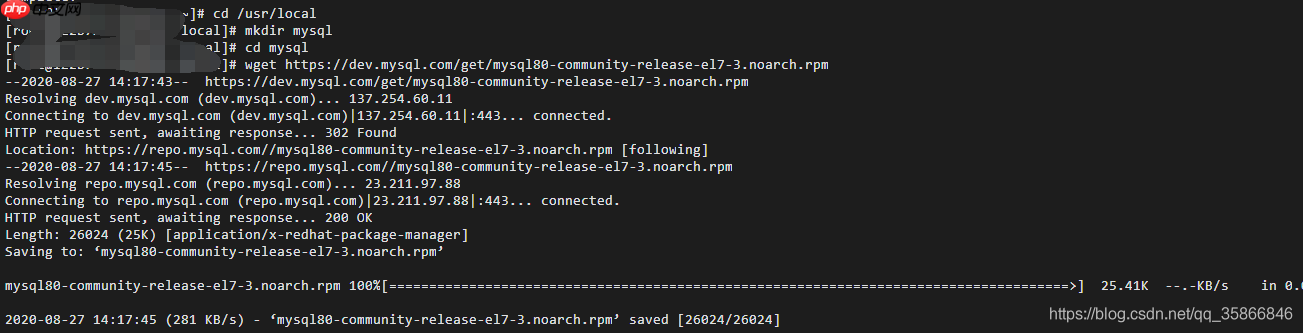
    本教程适用于社区版mysql,供日常学习交流使用,不得用于商业用途。如需商业用途,请通过官方渠道购买正版产品。 第一步,准备好连接工具。我直接使用了控制台的远程连接。如果不是在自己电脑上操作,通常会使用xshell进行连接,操作流程基本相同。 连接到ECS后,需移除默认的MariaDB数据库: yu…

    2026年9月30日 • 用户投稿
    500
  • sublime如何优化SQL编写体验 sublime数据库查询的高效技巧

    sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧sublime如何优化SQL编写体验 sublime数据库查询的高效技巧

    安装package control后,通过其安装sqltools及对应数据库驱动插件以实现语法高亮、代码片段和数据库连接;2. 配置sqltools用户设置中的数据库连接信息,并利用内置或自定义代码片段快速生成sql语句;3. 安装sql beautifier进行代码格式化,结合sublimelin…

    2026年9月30日 • 用户投稿
    400
  • Linux下MySQL 8.0 二进制安装

    mysql社区版:开源且免费,但不提供技术支持,需搭配其他开源工具使用。 MySQL企业版:与社区版代码相同,通过插件提供额外功能,如线程插件、审计插件等。 MySQL Cluster CGE集群商业版:实时开源事务数据库,设计用于高吞吐量环境下快速、持久地访问数据。支持并行分布式查询引擎、自动分区…

    2026年9月30日
    100
  • 如何在Red Hat 8上配置MySQL高可用集群的详细步骤?

    如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?如何在Red Hat 8上配置MySQL高可用集群的详细步骤?

    配置MySQL高可用集群,说白了就是让你的数据库扛得住压力,不怕宕机。Red Hat 8上搞这个,其实挺考验运维功底的,但也不是啥高不可攀的事儿。 解决方案 准备环境: 至少三台Red Hat 8服务器。 别想着一台机器玩转高可用,那是耍流氓。确保服务器之间网络互通,防火墙放行MySQL和集群通信端…

    2026年9月30日 • 用户投稿
    100
  • MySQL如何实现跨库事务 XA分布式事务处理方案

    MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案MySQL如何实现跨库事务 XA分布式事务处理方案

    有,更轻量级方案包括柔性事务,如1.tcc(try-confirm-cancel)由应用层实现,通过预扣、确认或回滚操作处理分布式事务;2.saga模式将事务拆分为多个本地事务并配有补偿机制;3.基于消息队列实现最终一致性,这些方案以牺牲强一致性换取性能与可用性提升。 MySQL实现跨库事务,通常会…

    2026年9月30日 • 用户投稿
    100
  • 如何在mysql中创建数据库 mysql数据库创建方法详解

    在 mysql 中创建数据库的命令是 create database mydatabase;。1. 数据库名大小写不敏感,除非使用引号,且不能包含空格和特殊字符。2. 可以指定字符集和排序规则,如 create database mydatabase character set utf8mb4 co…

    2026年9月30日
    100
  • Sublime结合命令行自动执行数据任务_构建轻量化分析流水线

    Sublime结合命令行自动执行数据任务_构建轻量化分析流水线Sublime结合命令行自动执行数据任务_构建轻量化分析流水线Sublime结合命令行自动执行数据任务_构建轻量化分析流水线Sublime结合命令行自动执行数据任务_构建轻量化分析流水线

    sublime text在数据任务自动化中扮演高效的幕后推手角色,它作为轻量级代码编辑与管理界面,提供快速启动、多光标编辑、多文件管理及丰富的插件生态(如anaconda增强python开发),使用户能高效编写模块化脚本(如clean_data.py、run_pipeline.sh);随后通过命令行…

    2026年9月30日 • 用户投稿
    1000
  • mysql实现递归查询的方法有哪些

    mysql实现递归查询的方法有哪些mysql实现递归查询的方法有哪些mysql实现递归查询的方法有哪些mysql实现递归查询的方法有哪些

    实现递归查询的方法有:1、使用存储过程来实现递归查,存储过程可以使用循环或递归调用来实现递归查询;2、使用WITH RECURSIVE语句,通过在递归表达式中指定递归的终止条件和递归的迭代操作,可以实现递归查询;3、通过将表与自身连接,并使用连接条件来限制连接的深度,可以实现递归查询;4、通过在临时…

    2026年9月30日 • 用户投稿
    200
  • 参加PHP+MySQL培训后获得行业认证的情况

    参加php+mysql培训后获得行业认证的情况非常正面。1)培训课程教授技术技能并帮助准备认证考试,如zend php和mysql认证。2)培训包括核心概念、最佳实践和实战项目。3)提供模拟考试等资源,提升考试通过率。4)认证提升职场竞争力和职业发展机会。通过努力和正确学习方法,你能在这一领域取得成…

    2026年9月30日
    100
  • 如何在MySQL中使用PHP编写自定义存储过程、触发器和函数

    如何在MySQL中使用PHP编写自定义存储过程、触发器和函数如何在MySQL中使用PHP编写自定义存储过程、触发器和函数如何在MySQL中使用PHP编写自定义存储过程、触发器和函数如何在MySQL中使用PHP编写自定义存储过程、触发器和函数

    如何在MySQL中使用PHP编写自定义存储过程、触发器和函数 作为一个常用的关系型数据库管理系统,MySQL提供了许多功能强大的特性,如存储过程、触发器和函数,可以帮助我们更好地组织和管理数据库。本文将介绍如何使用PHP来编写自定义的存储过程、触发器和函数,并结合具体代码示例进行说明。 一、自定义存…

    2026年9月30日 • 用户投稿
    200
  • 如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统

    如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统

    如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统 概述:本文将介绍如何使用MySQL和Ruby on Rails开发一个简单的博客管理系统。博客管理系统是一个常见的Web应用程序,它允许用户创建、编辑和管理博客文章。我们将使用Ruby on Rails作为开发框架,MySQL…

    2026年9月30日 • 用户投稿
    100
  • 如何利用MySQL和JavaScript开发一个简单的任务管理器

    如何利用MySQL和JavaScript开发一个简单的任务管理器如何利用MySQL和JavaScript开发一个简单的任务管理器如何利用MySQL和JavaScript开发一个简单的任务管理器如何利用MySQL和JavaScript开发一个简单的任务管理器

    如何利用MySQL和JavaScript开发一个简单的任务管理器 概述:任务管理器是一种常见的应用程序,它可以帮助我们组织和跟踪日常任务的完成情况。在本文中,我们将学习如何利用MySQL和JavaScript来开发一个简单的任务管理器。该管理器将具有添加、编辑和删除任务的功能,同时具有任务列表的显示…

    2026年9月30日 • 用户投稿
    200
  • 如何在MySQL中使用Python编写自定义触发器

    如何在MySQL中使用Python编写自定义触发器如何在MySQL中使用Python编写自定义触发器如何在MySQL中使用Python编写自定义触发器如何在MySQL中使用Python编写自定义触发器

    如何在MySQL中使用Python编写自定义触发器 触发器是MySQL中的一种强大的功能,它可以在数据库中的表上定义一些自动执行的操作。而Python则是一种简洁而强大的编程语言,能够方便地与MySQL进行交互。本文将介绍如何使用Python编写自定义触发器,并提供具体的代码示例。 首先,我们需要安…

    2026年9月29日 • 用户投稿
    100
  • PHP与SQL实现高效预约时间冲突检测教程

    本教程旨在详细指导如何在php应用程序中,利用sql查询高效检测预约时间冲突。通过构建包含精确时间重叠逻辑的`count(*)`查询,能够准确判断新提交的预约请求是否与数据库中现有预约发生冲突。这有助于避免重复预订,确保预约系统的准确性、可靠性及用户体验。 引言:预约系统中的时间冲突挑战 在开发任何…

    2026年9月29日
    100
  • 如何利用MySQL和Python开发一个简单的问答网站

    如何利用MySQL和Python开发一个简单的问答网站如何利用MySQL和Python开发一个简单的问答网站如何利用MySQL和Python开发一个简单的问答网站如何利用MySQL和Python开发一个简单的问答网站

    如何利用MySQL和Python开发一个简单的问答网站 引言:问答网站是目前互联网上非常受欢迎的在线社交平台之一,它提供了一个可以让用户提问问题并获取其他用户解答的平台。本文将详细介绍如何使用MySQL数据库和Python编程语言开发一个简单的问答网站,并提供具体的代码示例。 一、环境搭建在开始之前…

    2026年9月29日 • 用户投稿
    200
  • 如何使用MySQL和Java实现一个简单的订阅功能

    如何使用MySQL和Java实现一个简单的订阅功能如何使用MySQL和Java实现一个简单的订阅功能如何使用MySQL和Java实现一个简单的订阅功能如何使用MySQL和Java实现一个简单的订阅功能

    如何使用MySQL和Java实现一个简单的订阅功能 随着互联网的发展,订阅功能成为了许多网站和应用程序的常见特性。订阅功能允许用户获取他们感兴趣的内容的更新和通知。在本文中,我将向您介绍如何使用MySQL和Java来实现一个简单的订阅功能。 为了实现订阅功能,我们需要考虑以下几个关键点: 数据库设计…

    2026年9月29日 • 用户投稿
    200
  • SQL查询中JOIN、WHERE和ORDER BY子句的正确使用与顺序

    本文详细阐述了在SQL查询中同时使用JOIN、WHERE和ORDER BY子句的正确方法。重点介绍了JOIN子句中ON条件的精确放置,强调每个JOIN操作后应立即跟上其对应的ON条件。此外,文章还明确了WHERE子句必须位于ORDER BY子句之前,以确保数据先被筛选再进行排序。通过示例代码和注意事…

    2026年9月29日
    200
  • 如何在MySQL中使用C#编写自定义存储过程、触发器和函数

    如何在MySQL中使用C#编写自定义存储过程、触发器和函数如何在MySQL中使用C#编写自定义存储过程、触发器和函数如何在MySQL中使用C#编写自定义存储过程、触发器和函数如何在MySQL中使用C#编写自定义存储过程、触发器和函数

    如何在MySQL中使用C#编写自定义存储过程、触发器和函数 MySQL 是一种广泛使用的开源关系型数据库管理系统,而 C# 是一种强大的编程语言,对于需要与数据库进行交互的开发任务来说,MySQL 和 C# 是很好的选择。在 MySQL 中,我们可以使用 C# 编写自定义存储过程、触发器和函数,来实…

    2026年9月29日 • 用户投稿
    200

发表回复

登录后才能评论
关注微信