推荐(免费):mysql视频教程
目录
1. 介绍2. Explain 结果列详解2.1 id2.2 select_type2.3 table2.4 partitions2.5 type(非常重要)2.6 possible_keys2.7 key2.8 key_len2.9 ref3.10 rows2.11 filtered2.12 Extra
【注】
当前系统环境: MySQL 5.7,其他版本略有不同,后期会抽时间单独说明。只介绍常见的场景,其他少见的场景暂不研究,如有需要可以去官方文档中查找。非入门,需要对 MySQL 的底层数据结构 B+ 树有一定的了解。
文档参考:MySQL 官方 Explain 文档
1. 介绍
使用 EXPLAIN 关键字可以模拟优化器执行 SQL 语句,并分析查询语句的性能瓶颈。
2. Explain 结果列详解
2.1 id
id 列的编号是 select 的序列号,一般有几个 select 就有几个 id(联表查询会有重复的 id),并且 id 的顺序是按 select 出现的顺序增长的。id 越大则表示执行的优先级越高,id 相同(一般出现在联表查询)则从上往下执行,id 为 NULL 最后执行。
2.2 select_type
select_type 表示对应行是简单的还是复杂的查询。常见的值有:
simple:简单查询,查询不包含子查询和union。
primary:复杂查询中最外层的 select 。
subquery:包含在 select 中的子查询(不在 from 子句中)
derived:包含在 form 子句中的子查询,MySQL 会将结果放在一个临时表中,也称为派生表。
union:在 union 中的第二个或之后的 select。
【注】在 MySQL 5.7 中,会对衍生表进行合并优化,如果要直观的查看 select_type 的值,需要临时关闭该功能(默认是打开的),下面的介绍中凡是涉及到衍生表的都需要该操作。
# 关闭衍生表的合并优化(只对该会话有效)set session optimizer_switch='derived_merge=off'; # 打开衍生表的合并优化(只对该会话有效)set session optimizer_switch='derived_merge=on';
2.3 table
对应行查询的表。
【注】
当 from 子句中有子查询时,table 列为是 的格式,表示这一行的执行的是 id = N 行的查询。当有 union 时,table 的数据为 的格式,M 和 N 表示参与 union 的 select 行id。
2.4 partitions
未完待续。。。
2.5 type(非常重要)
type 表示这行查询的关联类型(访问类型,或查询类型),通过该值可以了解该行查询数据记录的大概范围。常见的值依次从最优到最差分别为:system > const > eq_ref > ref > range > index > ALL;一般我们要保证效率的话,要优化我们的语句至少使其达到 range 级别,如果可能的话做好优化到 ref;range 一般用于范围查找,所以换句话说除了范围查找,其他的查询语句我们最好是优化到 ref 级别。
常见值说明:
NULL : 表示 MySQL 能够在优化阶段分解查询语句,在执行阶段不用访问表和索引。
system / const: MySQL 能对某个查询部分进行优化并将其转化成一个常量(可以通过 show warnings 查看优化的结果),主要是查询主键(Primary Key)或唯一键索引(Unique Key)对应的记录,因为不存在重复,所以最多只能查询出一条记录,所以速度比较快。system 是 const 的特例,当临时表里只有一条记录时为 system 。
# 表里有一个主键id为1的记录 - constexplain select * from student where id = 1# 派生表里面只有一条记录 - systemexplain select * from (select * from student where id = 1) tmp# 注: 如果查询的列中有 text 类型,那么在这里 type 会变为 ALL ,# 因为无法使用内存临时表,只能在磁盘上创建临时表,所以性能上会有所损耗,效果等同于全表查询 ALL。
req_ref:当主键或唯一键索引的相关列并联接使用时(联表查询),最多匹配一条符合条件的记录。这是除了 const之外的最好的联接类型,简单的 select 查询不会出现 req_ref,更多出现在联表查询。
# 虽然返回结果中有多条记录,但是在查询中一个学生id只对应一个班级,所以查询班级的时候为 req_ref,# 但是查询 student 的时候是 ALL,全表查询explain select * from student left join banji on student.id = banji.student_id
【注】在查询的过程中的返回结果如下: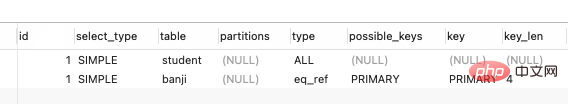
当联接表查询时候会看作是一条查询 SQL,所以它们对应的 id 是一样的,当 id 都是一样的时候,按照从上到下的顺序依次执行,这里是先查询班级所有的学生(全表查询 ALL),然后根据学生id查找出学生对应的班级信息(req_ref)。
ref:当使用普通索引(Normal)或者是联合索引的部分前缀时,索引要和某个值进行比较,可能会找到多个符合条件的记录行,从辅助索引的根节点开始对比并找到相应的记录。
# 简单的 select 查询,name 是普通索引(Normal Index)explain select * from student where name = '张三';# 简单 select 查询,banji_id (第一个) 和 student_id (第二个) 的联合索引EXPLAIN SELECT * FROM banji_student WHERE banji_student.banji_id = 3# 关联表查询# 包含 banji 表,banji_student 是班级与学生的关系表# 关系表中有 banji_id (第一个) 和 student_id (第二个) 的联合索引 idx_banji_stu_id 索引,# 以下查询只用到了联合索引的 banji_id (第一个)explain select * from banji_id from banji left join banji_student on banji.id = banji_student.banji_id
range:范围扫描,通常出现在 in,between,>,= 等操作中,使用一个索引来检索给定范围的行。
# 查询 id 大于 1 的学生信息explain select * from student where id > 2;
index:
扫描全索引就能拿到结果,一般是扫描某个二级索引(辅助索引,除了主键之外的索引)。这种索引不会从主键索引树根节点开始查找,而是直接对二级索引的叶子节点遍历和扫描,从而查找出相应的记录行,速度比较慢;这种查询方式一般为使用覆盖索引,查询所需的所有结果集在二级索引与主键索引中都有的情况下,由于二级索引一般比较小(因为二级索引是非聚集的,其叶子节点是存放的主键索引相应的地址,而主键索引是聚集的,其叶子节点存放的是完整的数据集),所以优先走二级索引,这种情况通常比 ALL 快一些。在某些情况下,如果表的列数特别多,这个时候通过辅助索引查询的性能就不如直接使用主键索引效率高(如果查询了辅助索引的话,还会返回到主键索引中进行查找更多的字段,也就是回表查询,当然在某些情况下使用回表查询的性能也会比只使用主键索引的性能高),这个时候会走主键索引,这种情况也比 ALL 快。
# student 表只有id主键,name 普通索引select * from student;# 这个时候会走 name 索引# 因为 name 是普通索引,所以如果加 where 的话可以达到 ref 级别select * from student where name = 'Ana'
覆盖索引定义:覆盖索引一般针对于辅助索引,并不是真正的索引,只是索引查找的一种方式。如果 select 查询的字段都在辅助索引树中全部拿到,这种情况一般是使用了覆盖索引,不需要通过辅助索引树找到主键,再通过主键去主键索引树里获取其它字段值。
ALL:全表扫描,扫描主键(聚簇、聚集)索引树的所有叶子节点,通常这种情况下要根据业务场景来增加其他索引进行优化。
# id 为主键的 student 表,没有其他索引,该查询为 ALL.select * from student
2.6 possible_keys
possible_keys 主要显示查询可能用到哪些索引来查找,只是可能会使用,并不代表一定会使用。
常见值说明:
NULL: 没有相关索引,如果是 NULL 的话,可以考虑在 where 子句中创建一个适当的索引来提高查询性能,然后继续用 explain 查看其效果;也有可能出现 possible_keys 为 NULL,但是 key 有值,实际走了索引。有列值:如果显示表中的某列,则表示可能会走这一列对应列值的索引;如果 possible_keys 有值,但是 key 显示 NULL,这种情况一般存在于表中数据量不大的情况,因为 MySQL 语句优化器认为索引对此查询的帮助不大,从而选择了全表查询。
2.7 key
key 表示 MySQL 实际采用哪个索引来优化对该表的查询。如果没有使用索引,则该列为 NULL,如果想强制 MySQL 使用或忽略 possible_keys 列中的索引,可以在查询中使用 force index 或 ignore index.
2.8 key_len
显示了 MySQL 索引所使用的字节数,通过这个数值可以计算具体使用了索引中的哪些列(主要用于联合索引的优化)。
【注】索引最大长度是 768 字节,当字符串过长时,MySQL 会做一个类似左前缀索引的处理,将前半部分的字符提取出来做索引。
示例:一个学生与班级的关系表:
banji_student,存在使用banji_id与student_id两个列组合的联合索引,并且每个索引int都是4字节,通过key_len值为4可以知道只使用了联合索引的第一列:banji_id来执行索引查找。
# 只使用了联合索引的第一列select * from banji_student where banji_id = 2
key_len 的计算规则如下:
字符串:常见的是 char(n) 和 varchar(n),从 MySQL 5.0.3 之后,n 均表示字符数,而不是字节数,如果是 UTF-8,一个数字或字母占1个字节,一个汉字占3个字节。
char(n)非汉字长度为 n,如果存放汉字长度为 3n 字节varchar(n)非汉字长度为 n+2,如果存放汉字长度为 3n+2 字节;因为 varchar 是可变长字符串,需要 2 字节来存储字符串长度
数值类型:
tinyint长度为 1 字节smallint长度为 2 字节int长度为 4 字节bigint长度为 8 字节
时间类型:
date长度为 3 字节timestamp长度为 4 字节datetime长度为 8 字节
NULL
如果字段允许设置为 NULL,则需要 1 字节来记录是否为 NULL; Not NULL 的列则不需要。
2.9 ref
显示了在使用 key 列中实际的索引时,表查找时所用到的列名和常量;常见的为 const 常量或索引关联查询的字段(列)名。
# 使用了常量 2,所以在查询的时候 ref 为 constselect * from student where id = 2# 关联表查询# 包含 banji 表,banji_student 是班级与学生的关系表# 关系表中有 banji_id (第一个) 和 student_id (第二个) 的联合索引 idx_banji_stu_id 索引# 这里的 ref 为 test.id ,也就是指的是 banji.idexplain select * from banji_id from banji left join banji_student on banji.id = banji_student.banji_id
3.10 rows
显示预计查询的结果数,并不是真正的结果集中的记录(行)数,仅供参考。
2.11 filtered
未完待续。。。
2.12 Extra
这一列展示的是额外的信息,存在很多值,且在不同的场景下以及不同版本的 MySQL 所表示的意思也不同,只能是表示大概的意思并且仅做优化参考,这里只介绍常见的值。
Using index:使用覆盖索引,在 type 相同的情况下, Extra 的值为 Using index 要比为 NULL 性能高。
比如 banji 表,存在 id,name,create_time 列,存在 id 主键与 name 普通索引。
# 覆盖索引,直接查询 name 对应的索引树就可以满足 select 后面的查询列select id,name from banji# 非覆盖索引,虽然也走了索引,但是进行了回表查询,以查询出 create_time 字段。select * from banji where name = '二年级'
Using where:使用 where 关键字来查询,并且对应的列没有设置索引,对应的 key 为 NULL。
这种情况一般要对查询的列添加相对应的索引来进行优化。
Using index condition:非覆盖索引查询并进行了回表,并且辅助索引使用了条件查询语句(where 或其他)。
比如 banji_student 关系表,存在 id,banji_id,student_id,create_time 列,存在 id 主键 和 banji_id 与 student_id 的组合(联合)索引。
# 进行了回表查询,以查询出 create_time 列,并且组合索引进行了范围查找select * from banji_student where banji_id > 3
Using temporary:MySQL 需要创建创建一个临时表来处理查询,出现这种情况一般要添加索引进行优化处理。
# 如果 name 没有添加普通索引的话,则需要创建一个临时表来进行去重,Extra 值为 Using temporary# 如果添加了索引,则会走 name 对应的索引树,并且是覆盖索引,Extra 值为 Using indexexplain select distinct name from student
Using filesort:使用外部排序而不是索引排序,当数据较小的时候采用的是内存排序,当数据量较大的时候会频繁的访问磁盘,并将排序后的数据写入磁盘。
# 如果 name 没有添加普通索引的话,则需要创建一个临时表来进行去重,Extra 值为 Using filesort# 如果添加了索引,则会走 name 对应的索引树,并且是覆盖索引,Extra 值为 Using indexexplain select name from student order by name
Select tables optimized away:使用聚合函数(例如 max、min等)来访问存在索引的字段时,只访问索引树中已排好序的叶子,节点性能很高。
# 比如使用聚合函数 min 查询最小的学生 id(主键)explain select min(id) from student
以上就是详解 MySQL 5.7 优化:Explain 执行计划的详细内容,更多请关注创想鸟其它相关文章!
版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/189716.html
 微信扫一扫
 支付宝扫一扫