终于理解 MySQL 索引要用 B+tree ,而且还这么快

mysql教程栏目介绍理解索引的B+tree。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

免费推荐:mysql教程(视频)

前言

当你现在遇到了一条慢 SQL 需要进行优化时,你第一时间能想到的优化手段是什么?

大部分人第一反应可能都是添加索引,在大多数情况下面,索引能够将一条 SQL 语句的查询效率提高几个数量级

索引的本质:用于快速查找记录的一种数据结构

索引的常用数据结构

二叉树红黑树Hash 表B-tree (B树,并不叫什么B减树)B+tree

数据结构图形化网址:https://www.cs.usfca.edu/~galles/visualization/Algorithms.html

索引查询

大家知道 select * from t where col = 88 这么一条 SQL 语句如果不走索引进行查找的话,正常地查就是全表扫描:从表的第一行记录开始逐行找,把每一行的 col 字段的值和 88 进行对比,这明显效率是很低的。
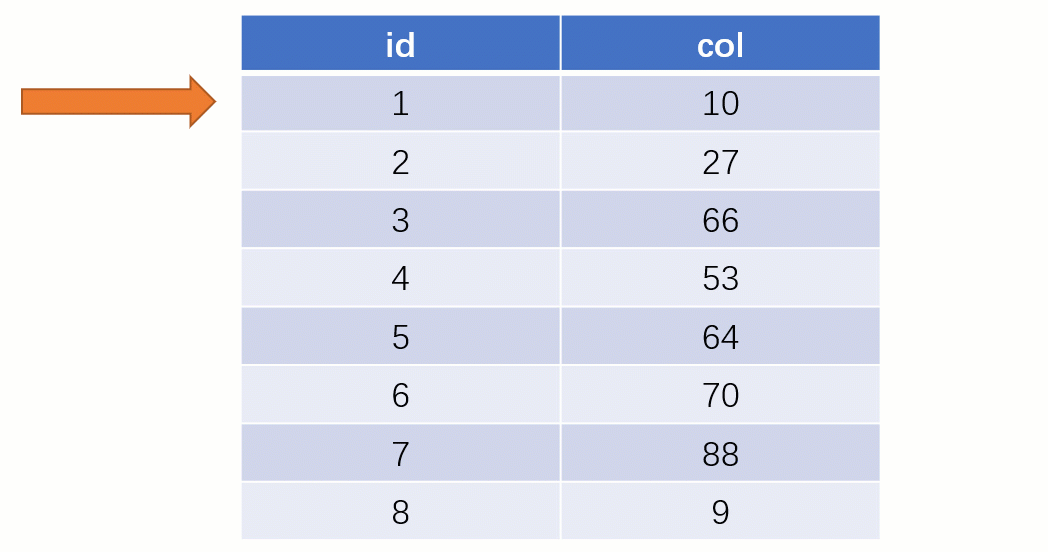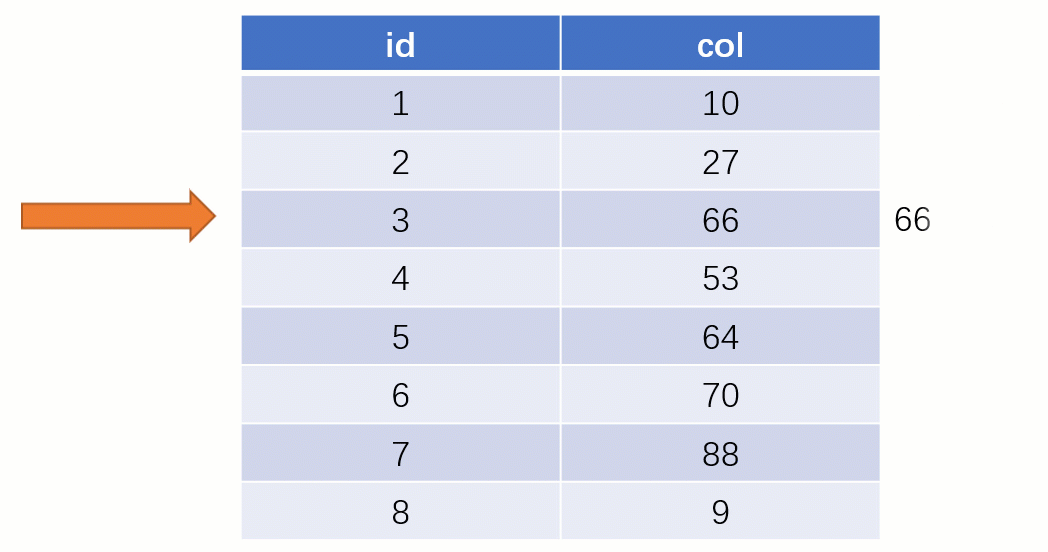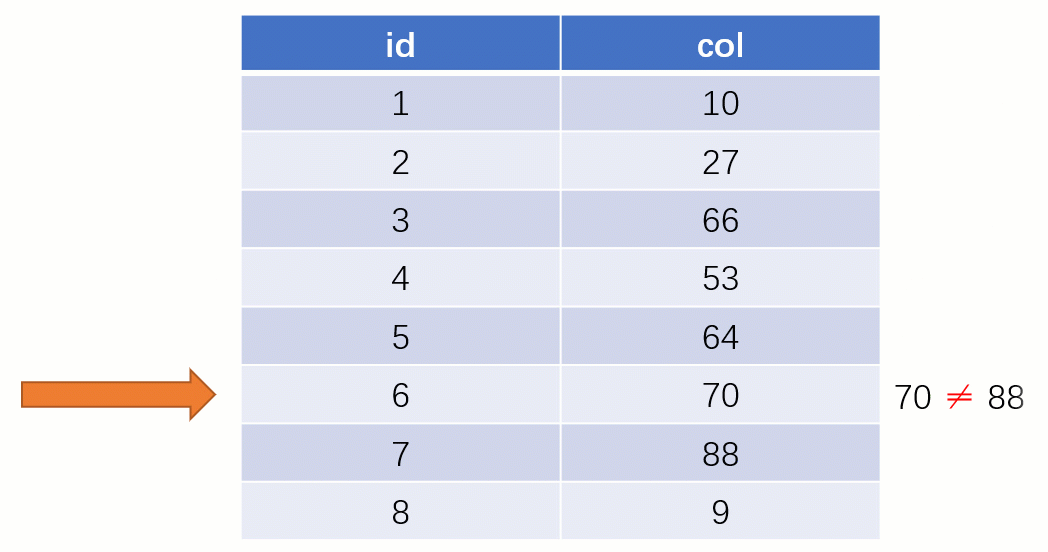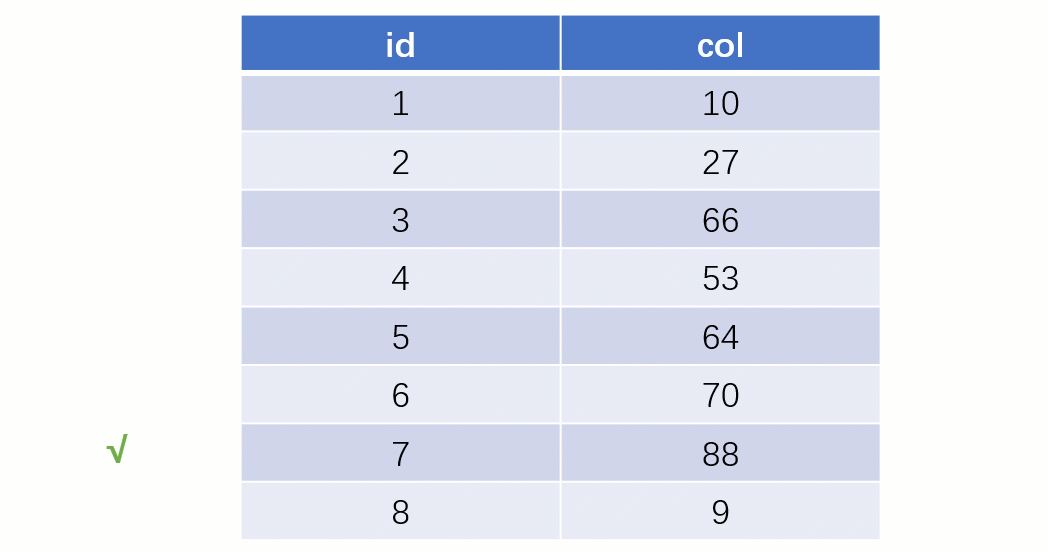
终于理解 MySQL 索引要用 B+tree ,而且还这么快

而如果走索引的话,查询的流程就完全不一样了(假设现在用一棵平衡二叉树数据结构存储我们的索引列)

此时该二叉树的存储结构(Key – Value):Key 就是索引字段的数据,Value 就是索引所在行的磁盘文件地址。

当最后找到了 88 的时候,就可以把它的 Value 对应的磁盘文件地址拿出来,然后就直接去磁盘上去找这一行的数据,这时候的速度就会比全表扫描要快很多。
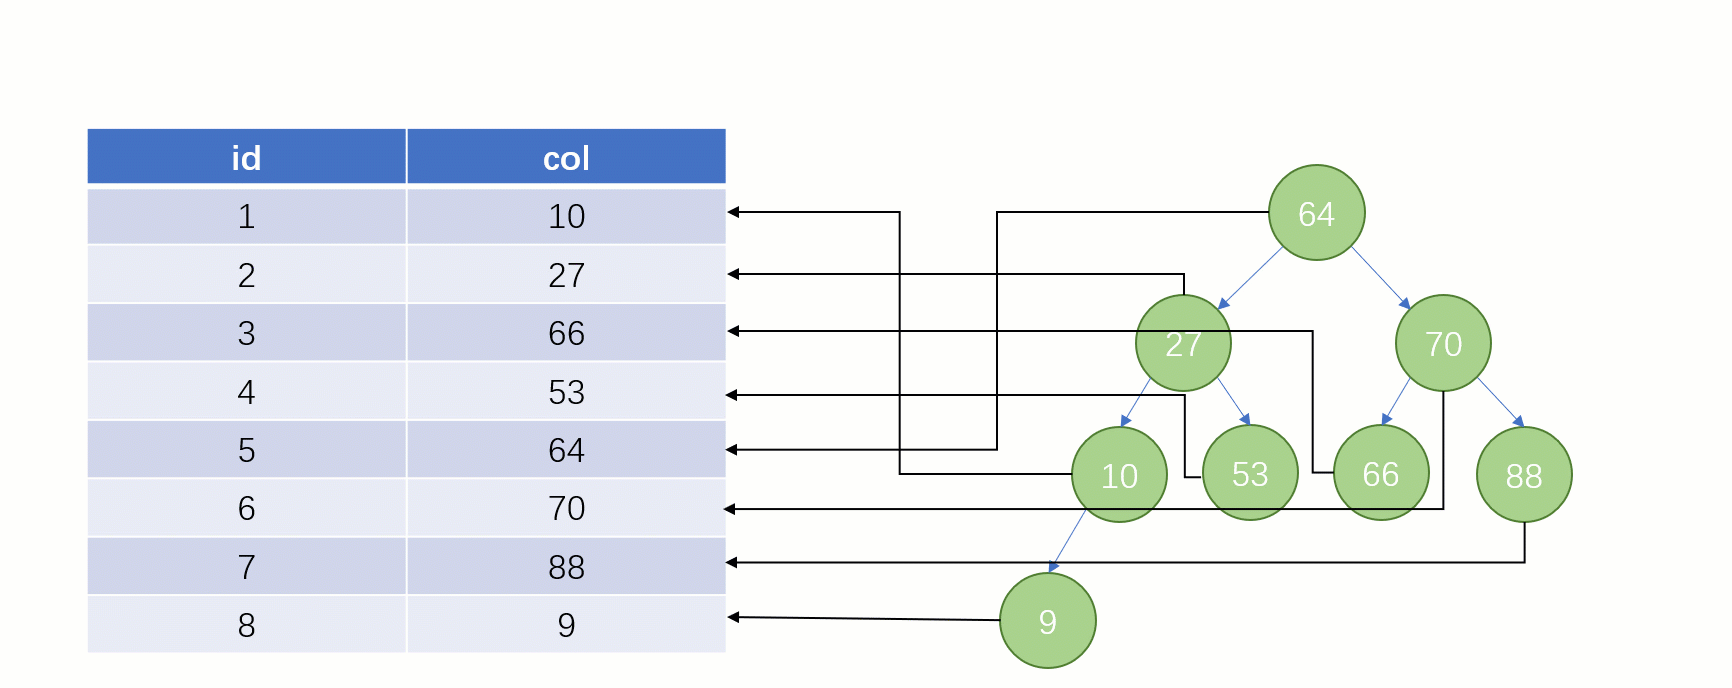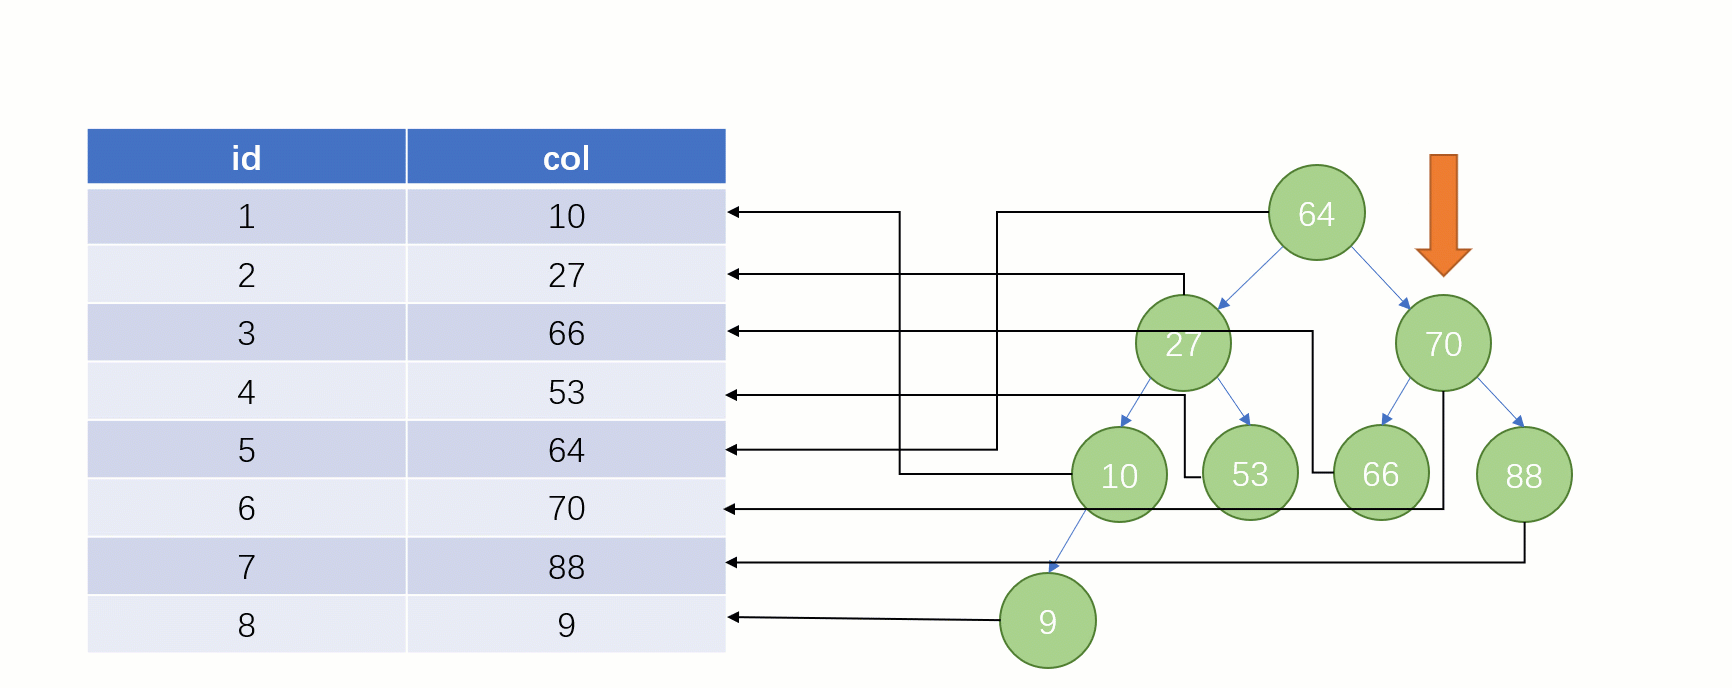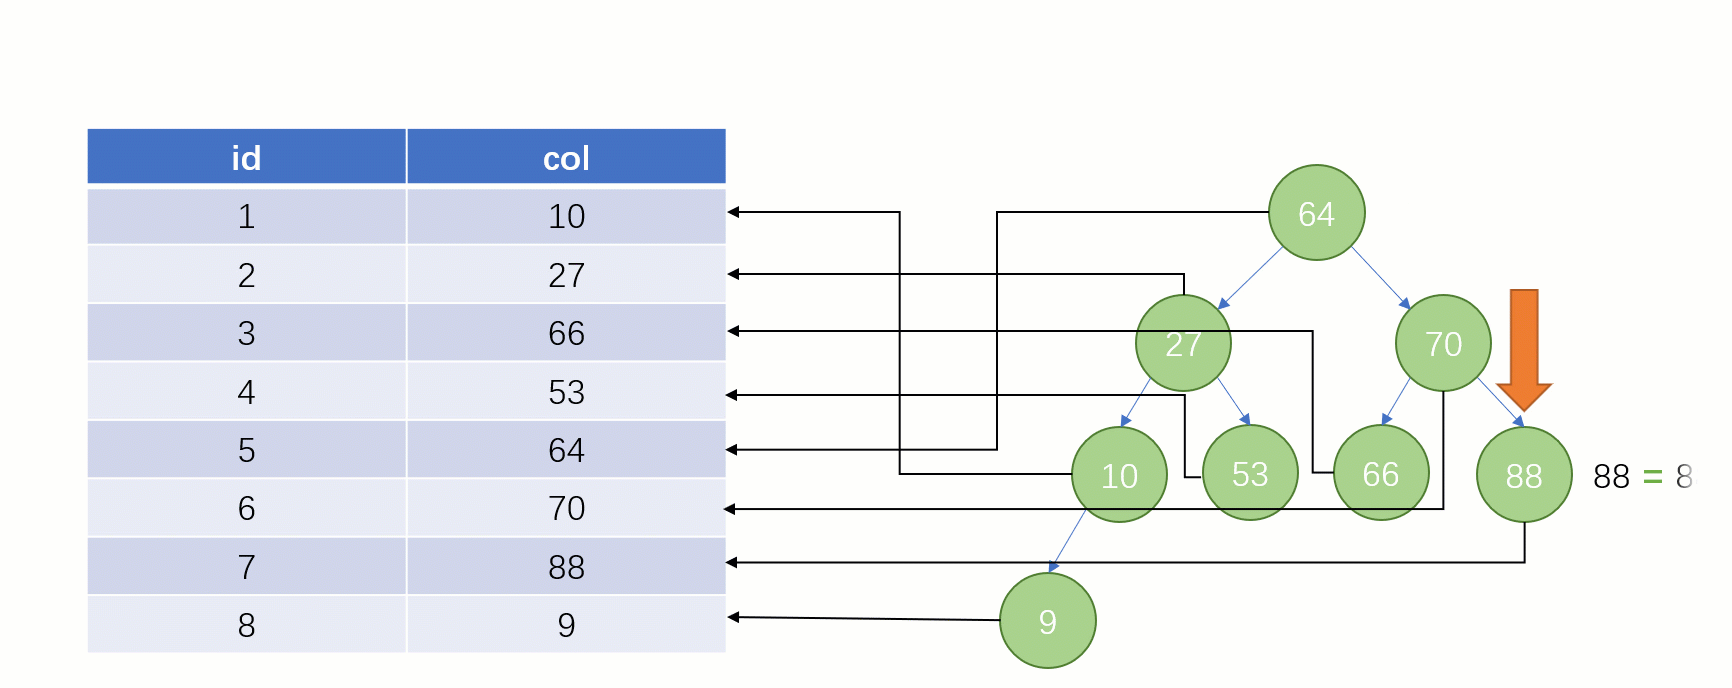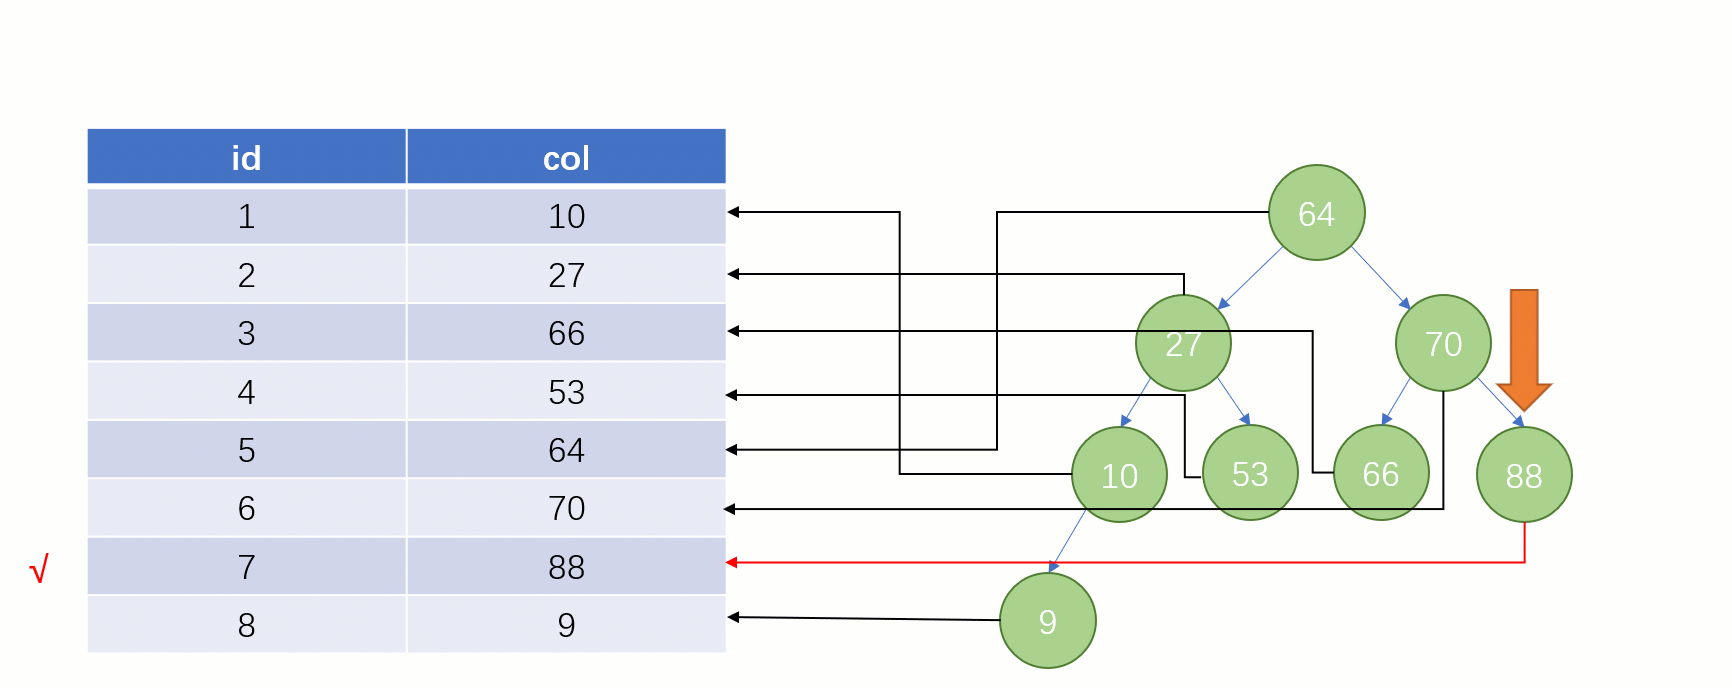
终于理解 MySQL 索引要用 B+tree ,而且还这么快

实际上 MySQL 底层并没有用二叉树来存储索引数据,是用的 B+tree(B+树)

为什么不采用二叉树

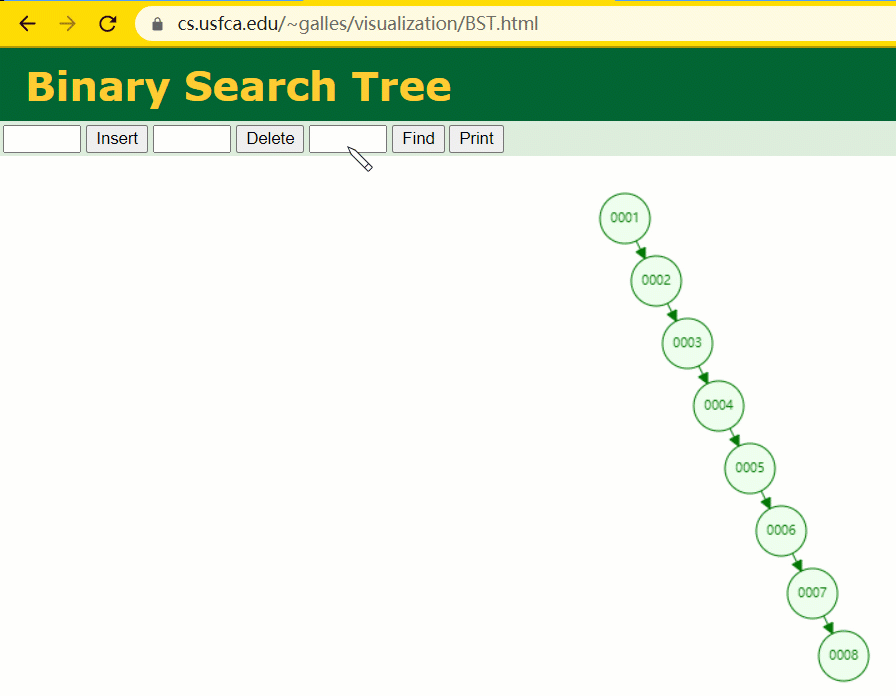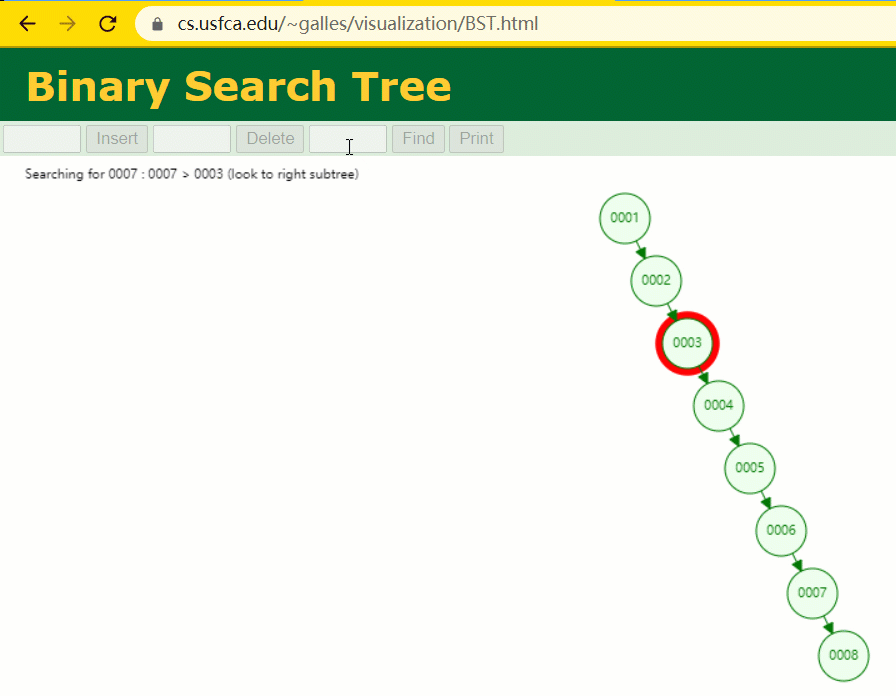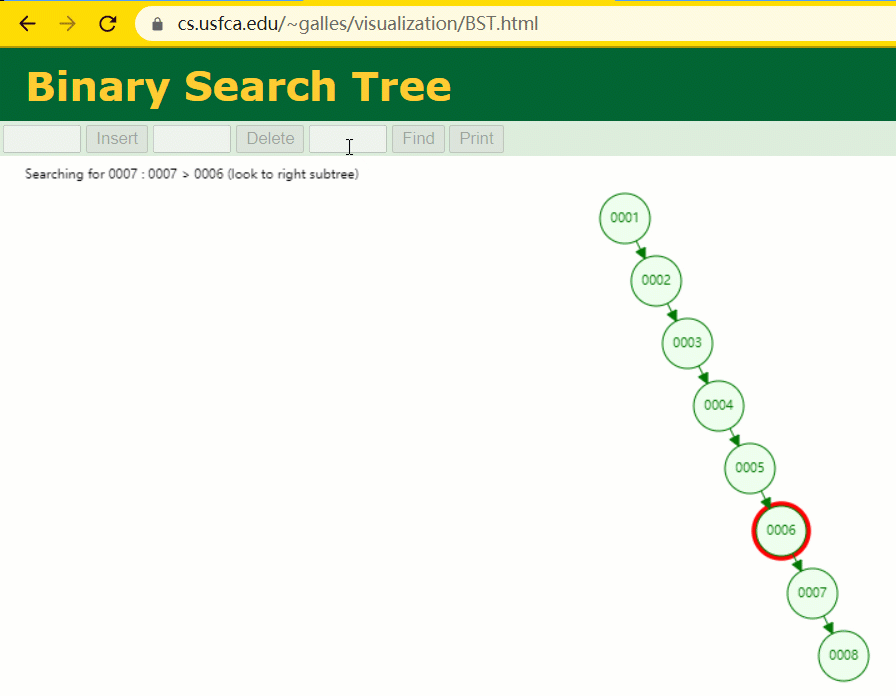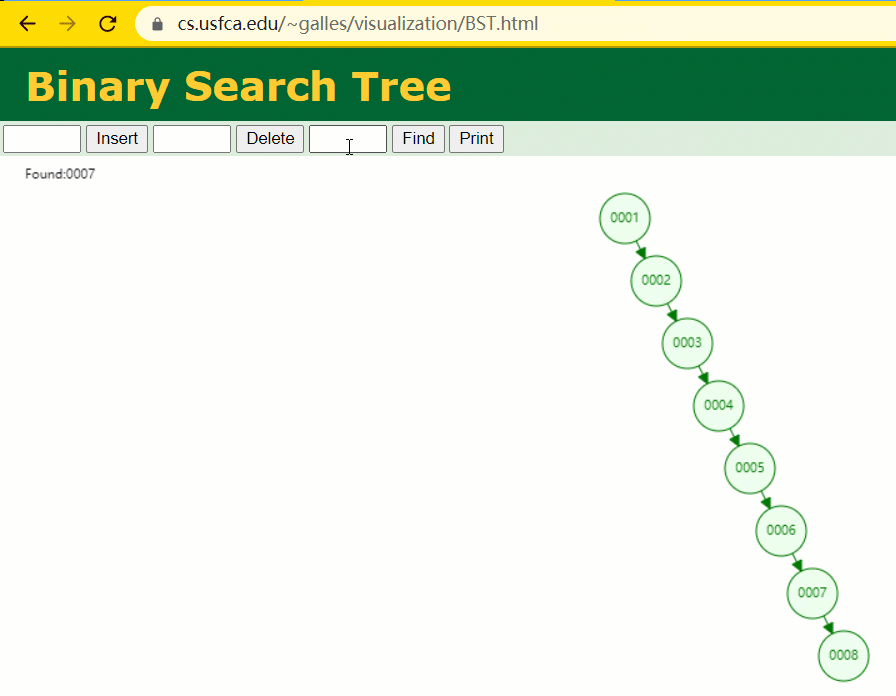
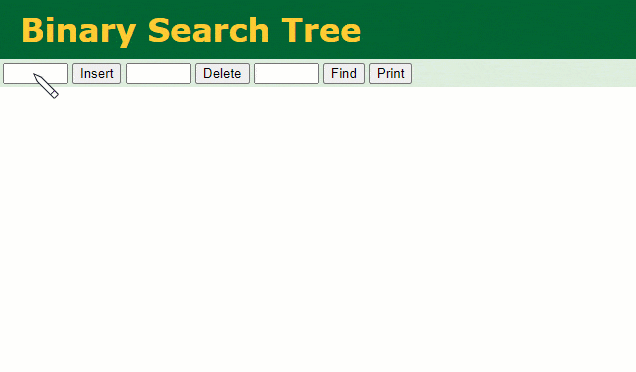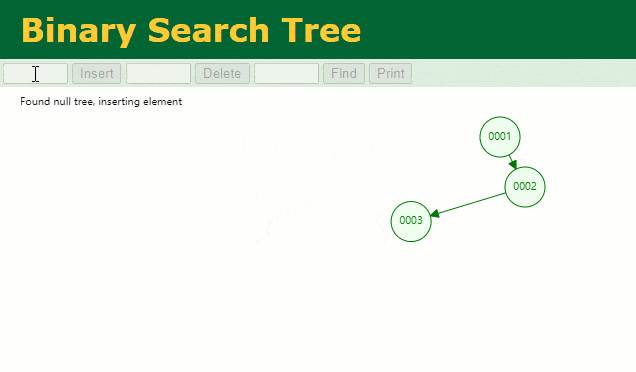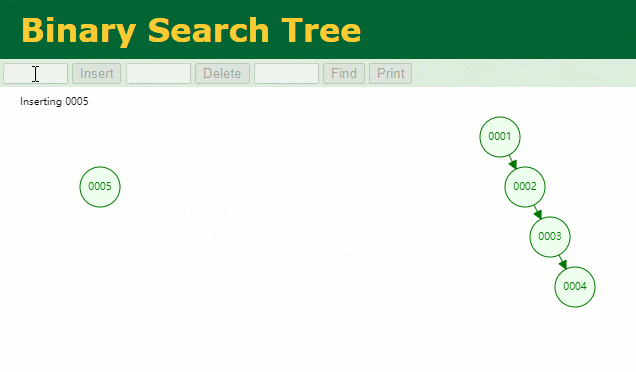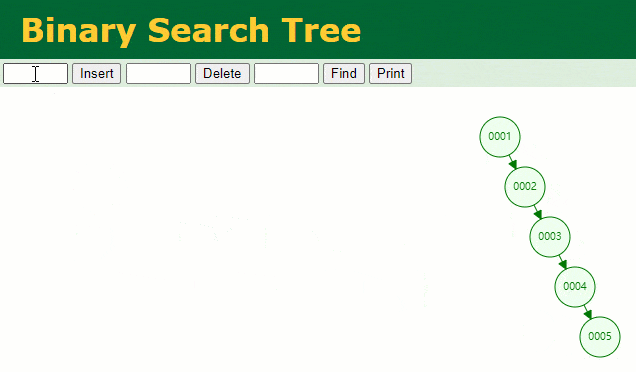
假设此时用普通二叉树记录 id 索引列,我们在每插入一行记录的同时还要维护二叉树索引字段。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

此时当我要找 id = 7 的那条数据时,它的查找过程如下:

终于理解 MySQL 索引要用 B+tree ,而且还这么快

此时找 id = 7 这一行记录时找了 7 次,和我们全表扫描也没什么很大区别。显而易见,二叉树对于这种依次递增的数据列其实是不适合作为索引的数据结构。

为什么不采用 Hash 表

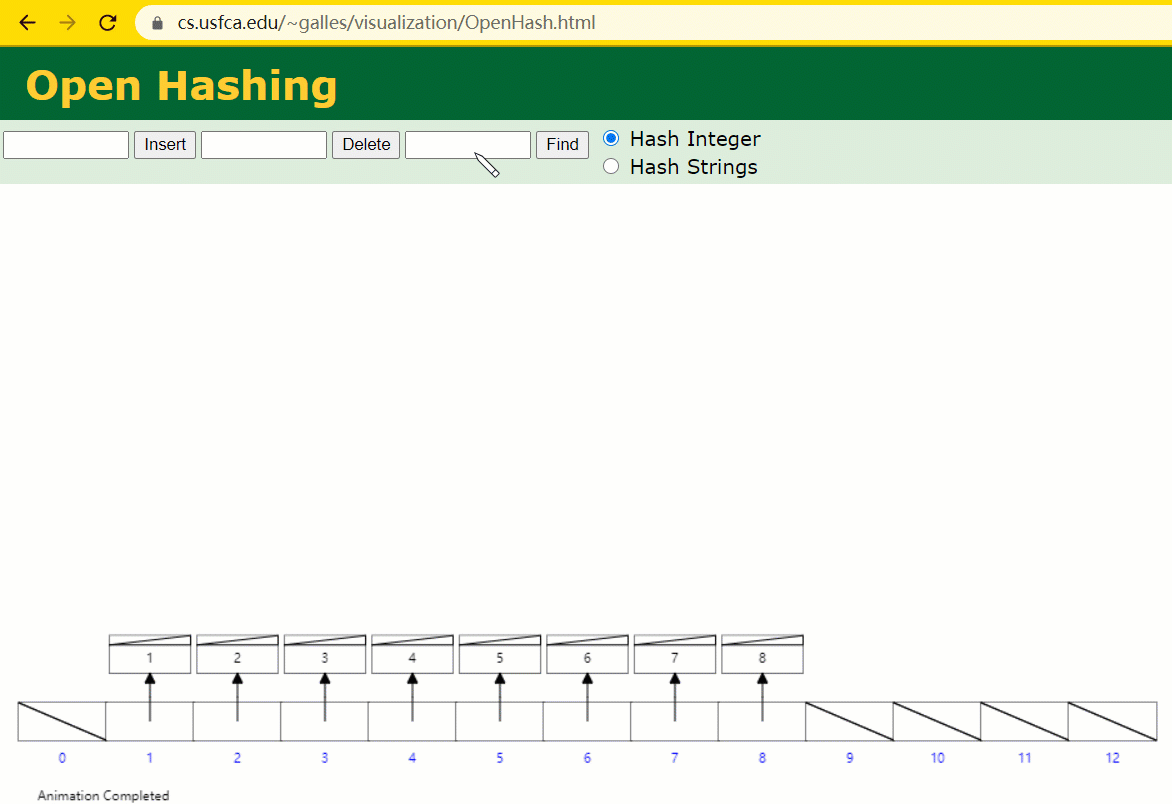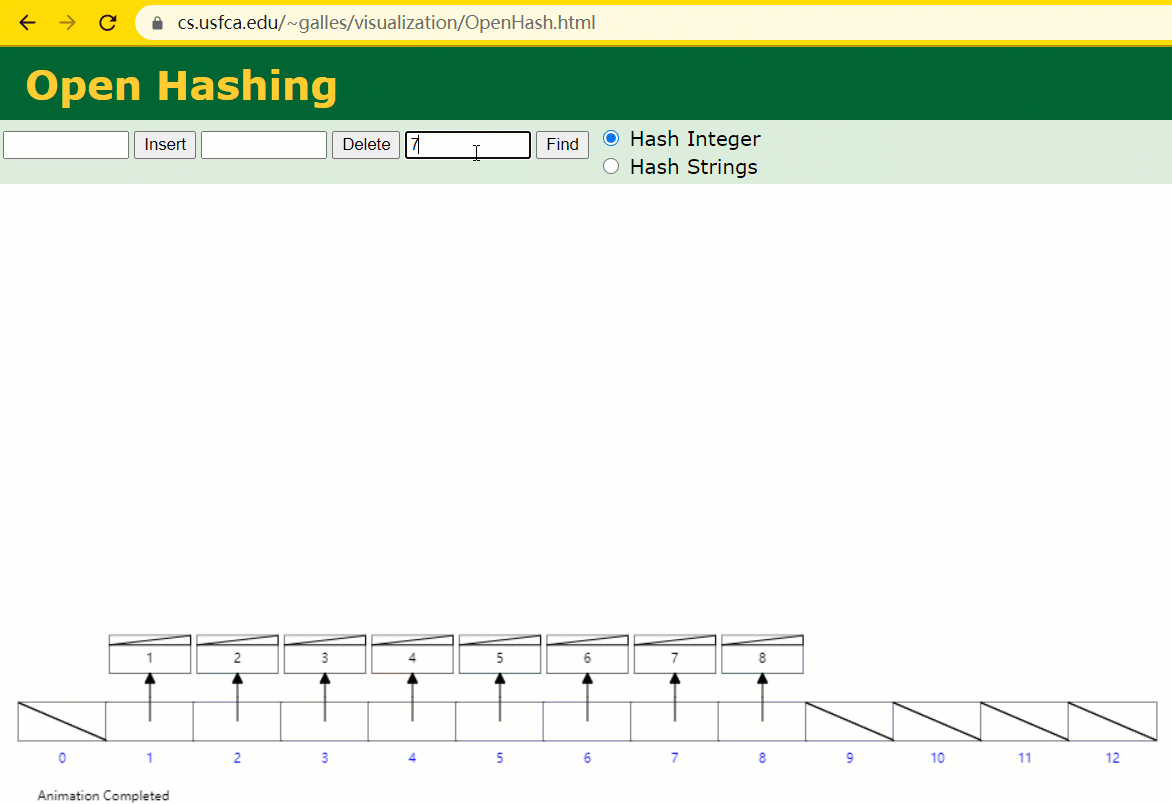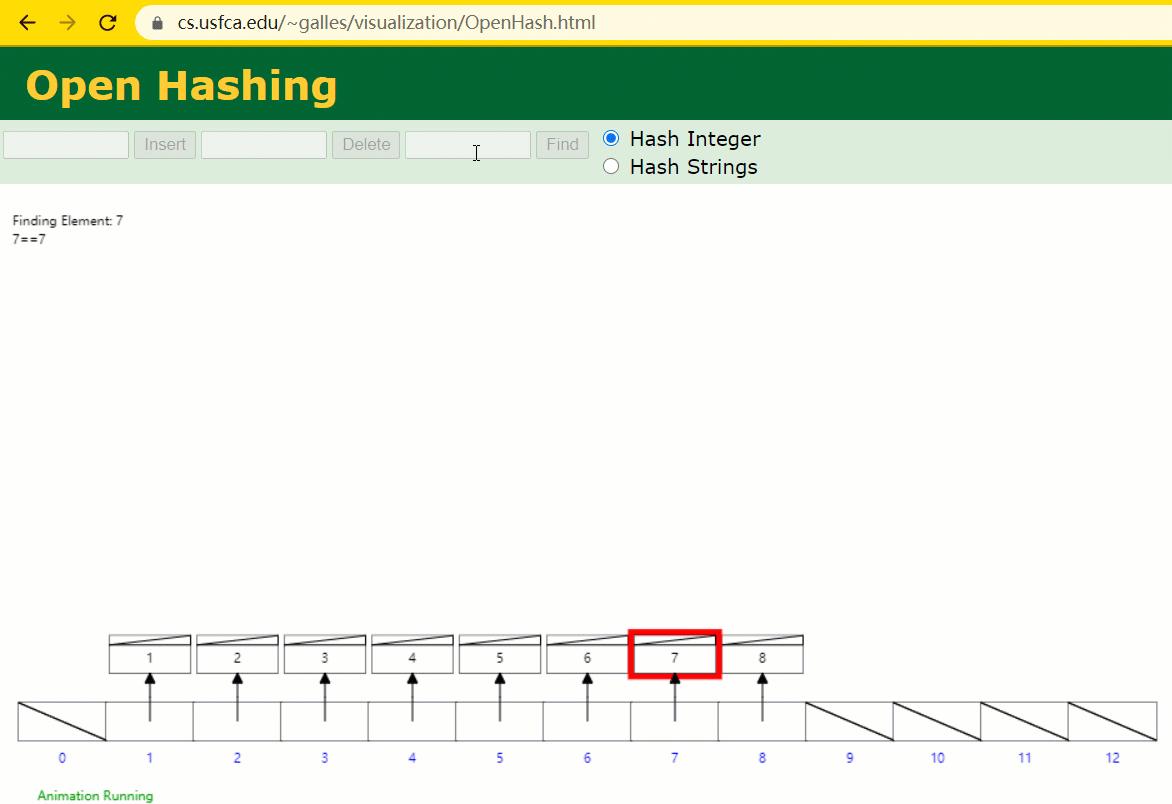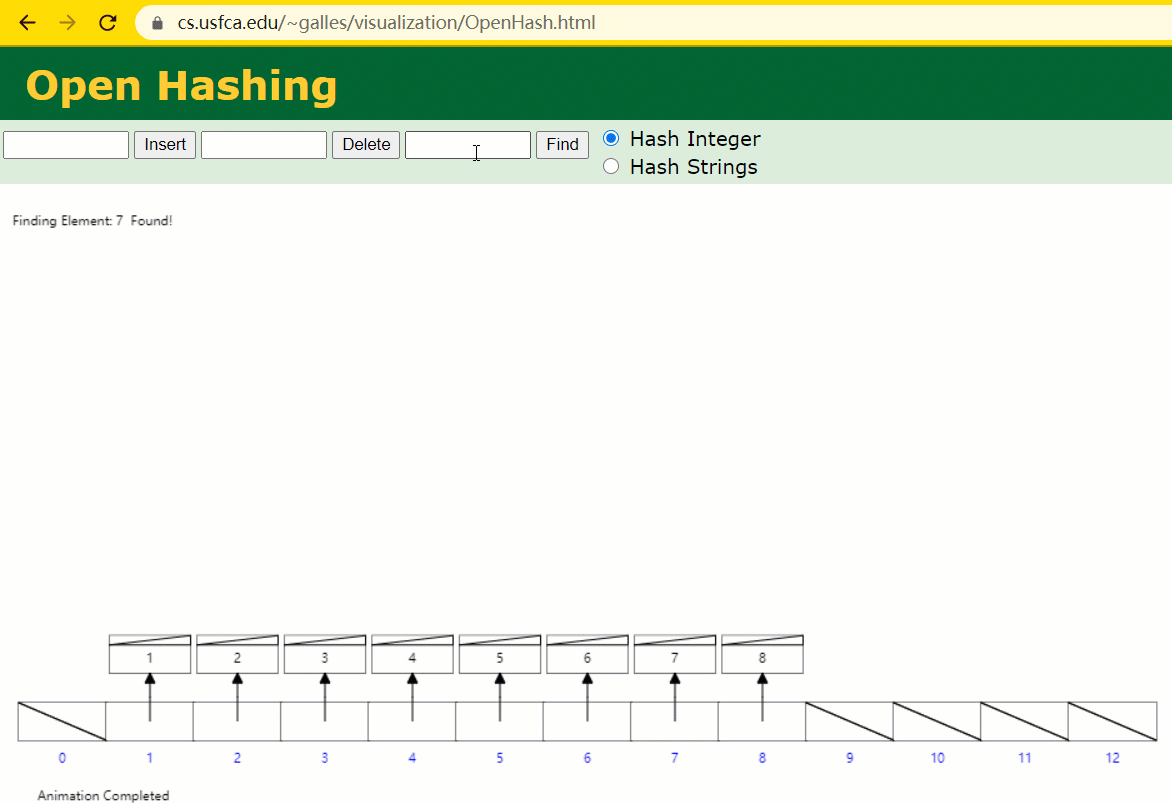
Hash 表:一个快速搜索的数据结构,搜索的时间复杂度 O(1)Hash 函数:将一个任意类型的 key,可以转换成一个 int 类型的下标

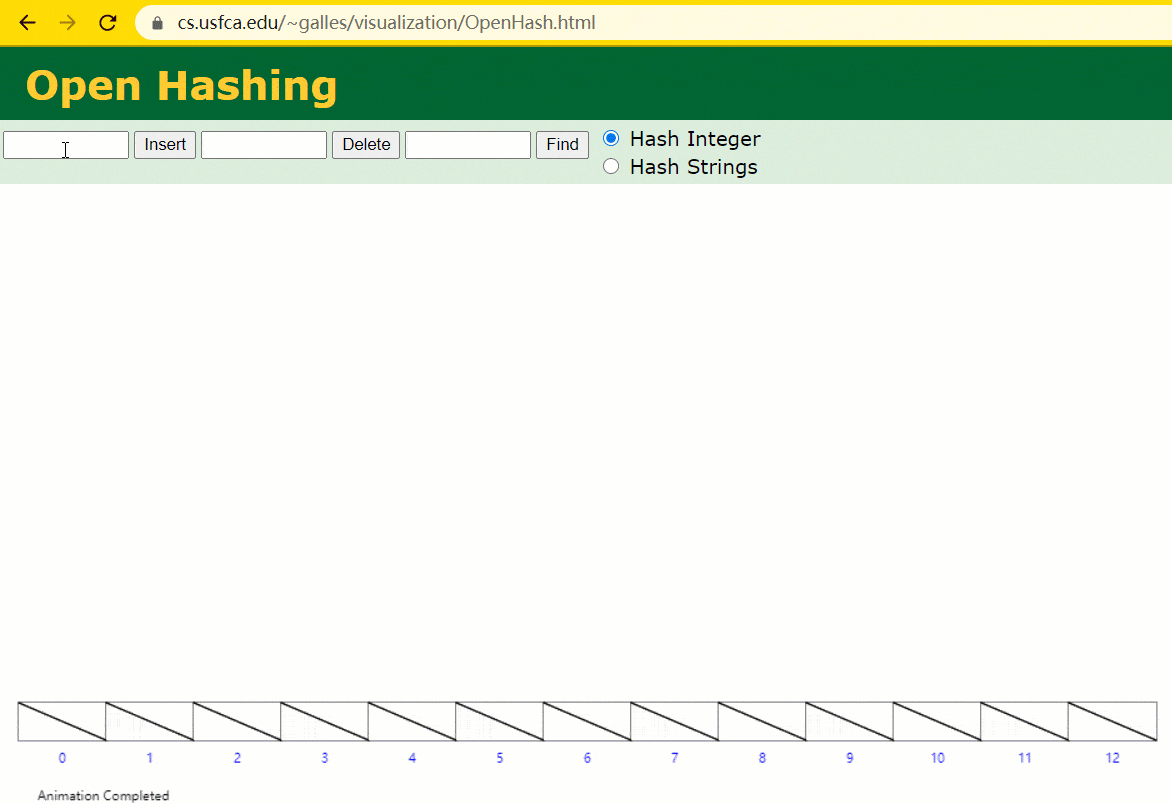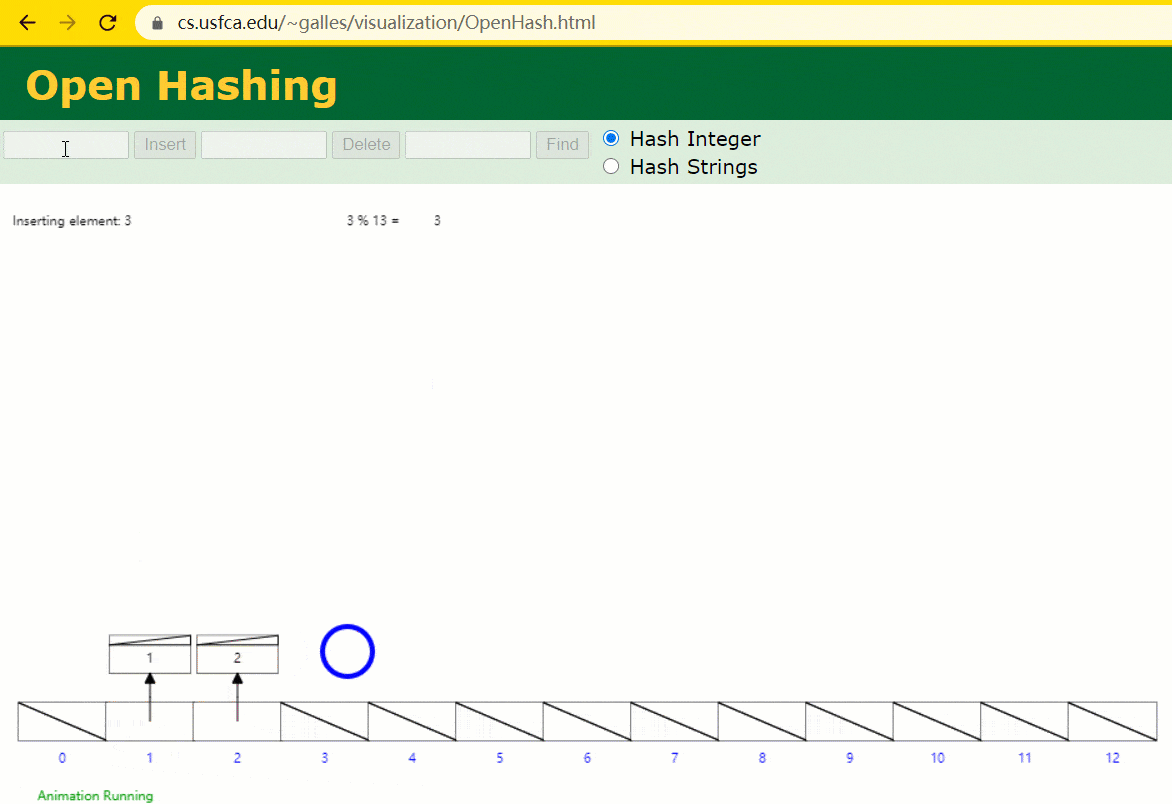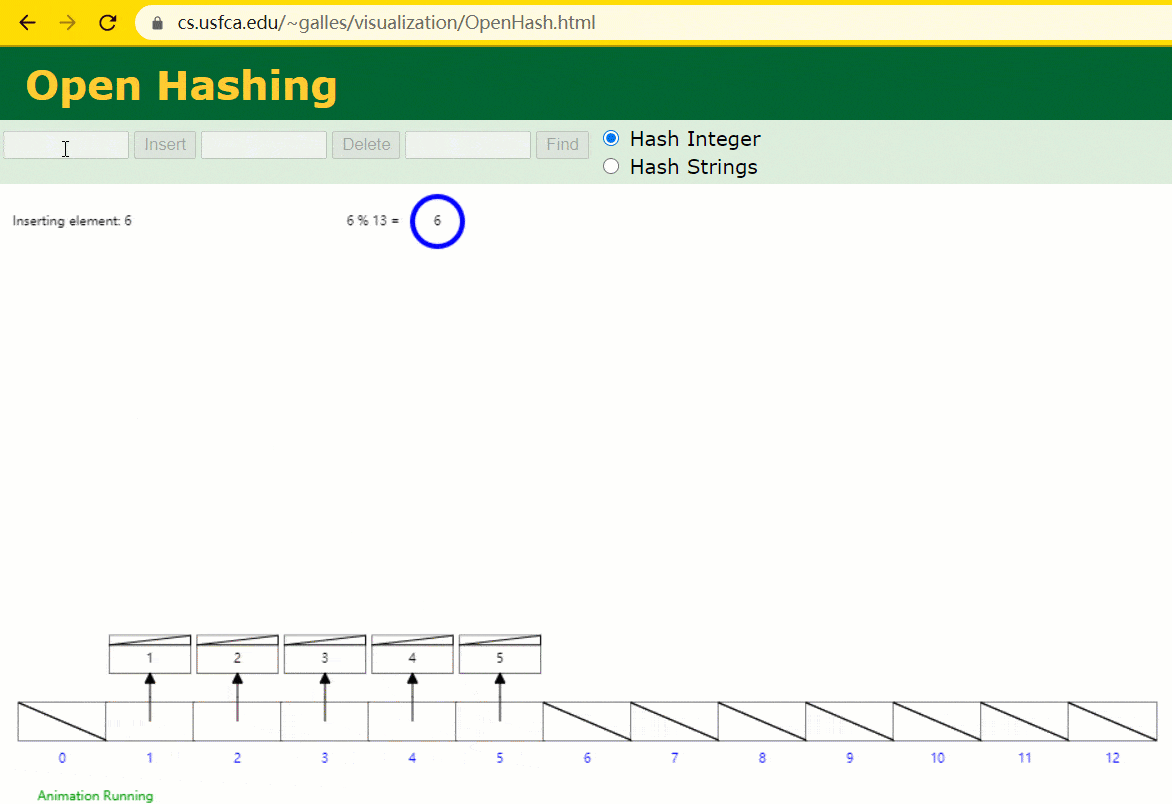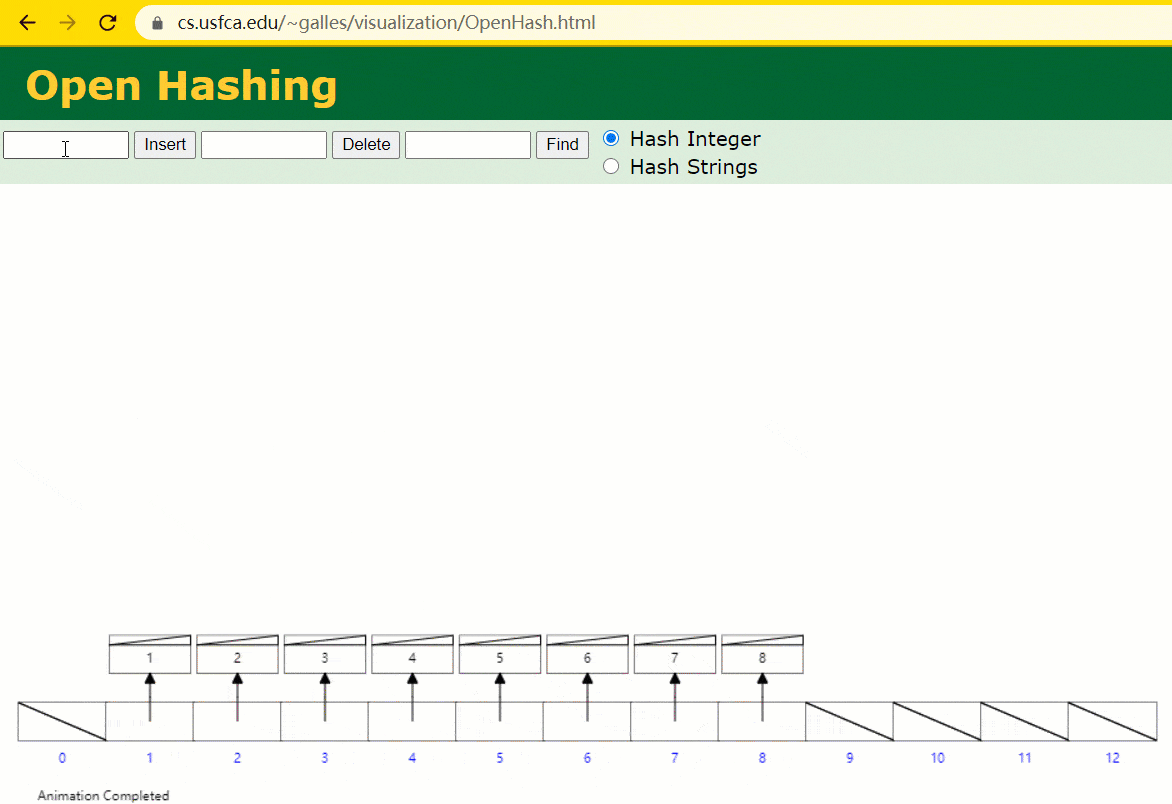
假设此时用 Hash 表记录 id 索引列,我们在每插入一行记录的同时还要维护 Hash 表索引字段。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

这时候开始查找 id = 7 的树节点仅找了 1 次,效率非常高了。

终于理解 MySQL 索引要用 B+tree ,而且还这么快

MySQL 的索引依然不采用能够精准定位的Hash 表。因为它不适用范围查询

为什么不采用红黑树

红黑树是一种特化的 AVL树(平衡二叉树),都是在进行插入和删除操作时通过特定操作保持二叉查找树的平衡;

若一棵二叉查找树是红黑树,则它的任一子树必为红黑树。

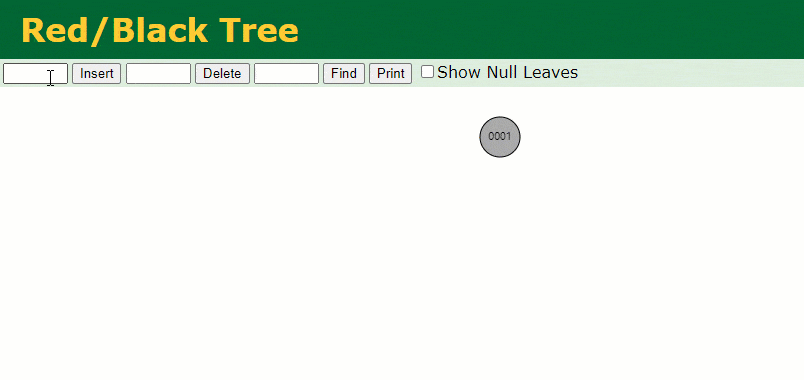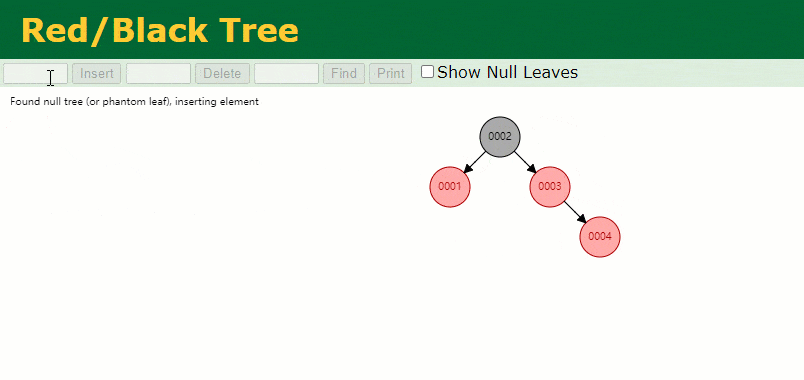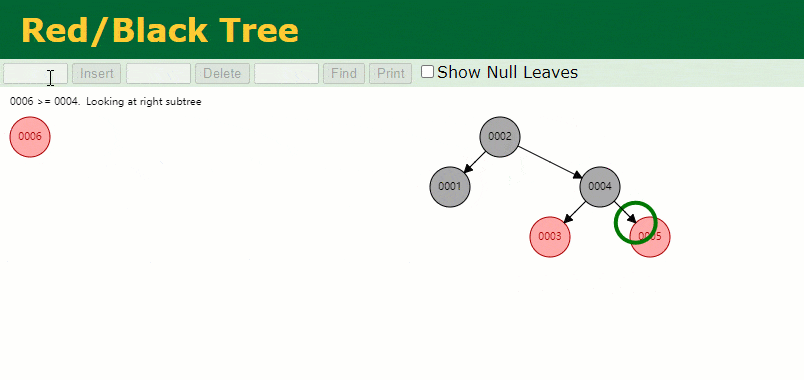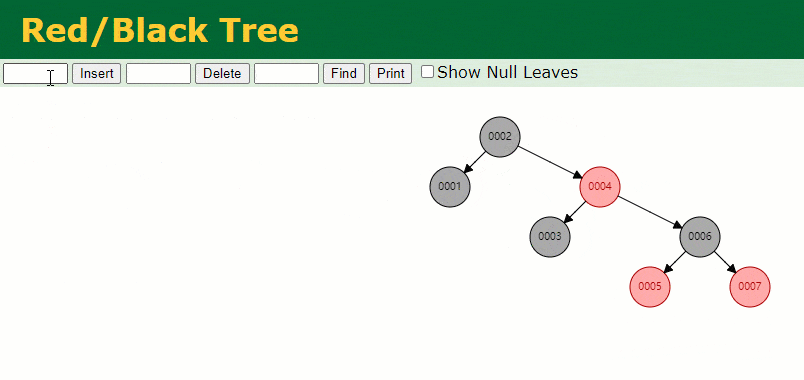
假设此时用红黑树记录 id 索引列,我们在每插入一行记录的同时还要维护红黑树索引字段。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

插入过程中会发现它与普通二叉树不同的是当一棵树的左右子树高度差 > 1 时,它会进行自旋操作,保持树的平衡。

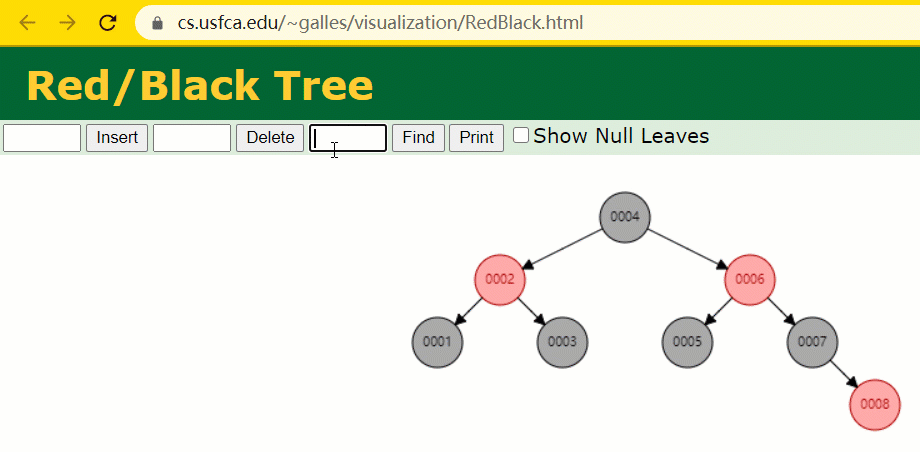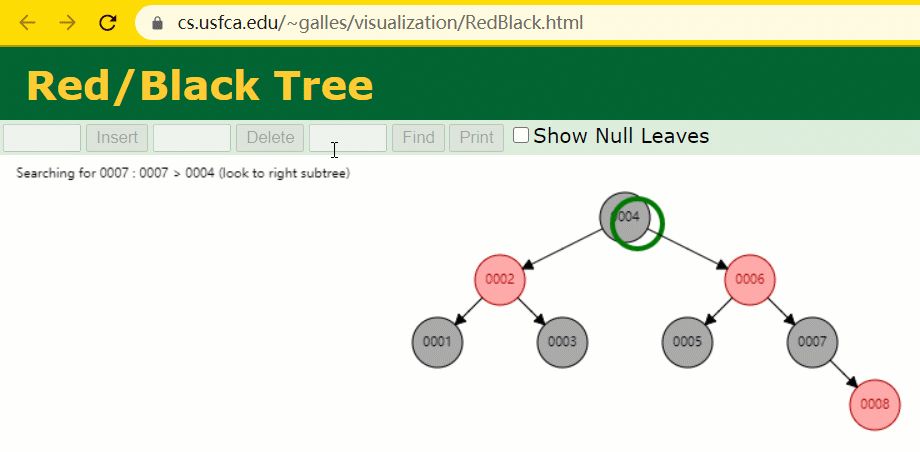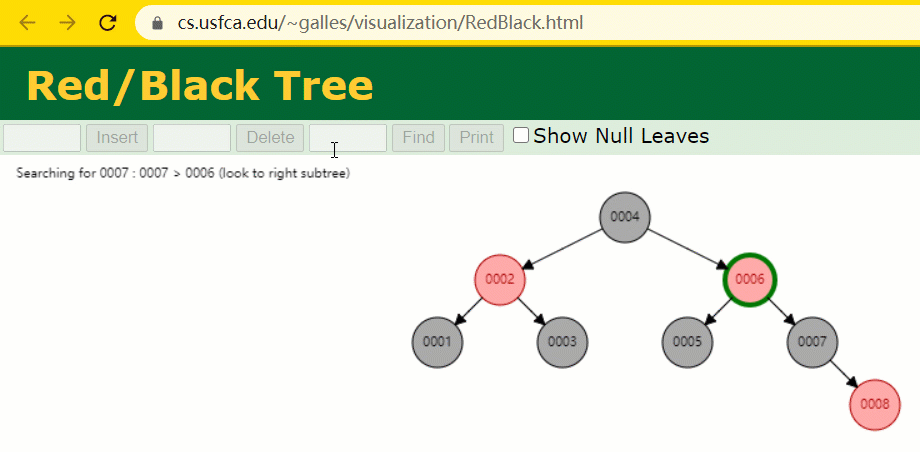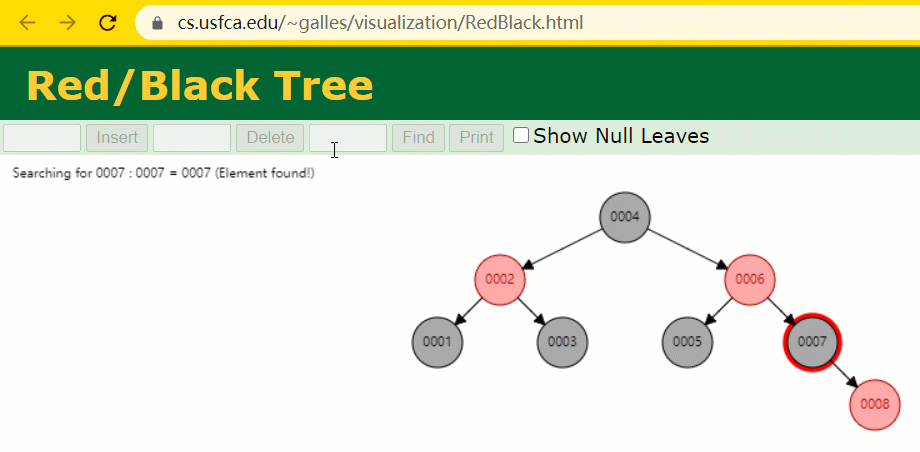
这时候开始查找 id = 7 的树节点只找了 3 次,比所谓的普通二叉树还是要更快的。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

MySQL 的索引依然不采用能够精确定位和范围查询都优秀的红黑树

因为当 MySQL 数据量很大的时候,索引的体积也会很大,可能内存放不下,所以需要从磁盘上进行相关读写,如果树的层级太高,则读写磁盘的次数(I/O交互)就会越多,性能就会越差。

B-tree

红黑树目前的唯一不足点就是树的高度不可控,所以现在我们的切入点就是树的高度

目前一个节点是只分配了一个存储 1 个元素,如果要控制高度,我们就可以把一个节点分配的空间更大一点,让它横向存储多个元素,这个时候高度就可控了。这么个改造过程,就变成了 B-tree

终于理解 MySQL 索引要用 B+tree ,而且还这么快

B-tree 是一颗绝对平衡的多路树。它的结构中还有两个概念

度(Degree):一个节点拥有的子节点(子树)的数量。(有的地方是以来说明 B-tree 的,这里解释一下)

阶(order):一个节点的子节点的最大个数。(通常用 m 表示)

关键字:数据索引。

一棵 m 阶 B-tree 是一棵平衡的 m 路搜索树。它可能是空树,或者满足以下特点:

除根节点和叶子节点外,其它每个节点至少有 ⌈m2⌉lceil dfrac{m}{2}rceil⌈2m⌉ 个子节点;

⌈m2⌉lceil dfrac{m}{2}rceil⌈2m⌉ 为 m / 2 然后向上取整

每个非根节点所包含的关键字个数 j 满足:⌈m2⌉lceil dfrac{m}{2}rceil⌈2m⌉ – 1 ≤ j ≤ m – 1;

节点的关键字从左到右递增排列,有 k 个关键字的非叶子节点正好有 (k + 1) 个子节点;

所有的叶子结点都位于同一层。

名字取义(题外话,放松一下)

以下摘自维基百科

鲁道夫·拜尔(Rudolf Bayer)和 艾华·M·麦克雷(Ed M. McCreight)于1972年在波音研究实验室(Boeing Research Labs)工作时发明了 B-tree,但是他们没有解释 B 代表什么意义(如果有的话)。

道格拉斯·科默尔(Douglas Comer)解释说:两位作者从来都没解释过 B-tree 的原始意义。我们可能觉得 balanced, broad 或 bushy 可能适合。其他人建议字母 B 代表 Boeing。源自于他的赞助,不过,看起来把 B-tree 当作 Bayer 树更合适些。

高德纳(Donald Knuth)在他1980年5月发表的题为 “CS144C classroom lecture about disk storage and B-trees” 的论文中推测了 B-tree 的名字取义,提出 B 可能意味 Boeing 或者 Bayer 的名字。

查找

B-tree 的查找其实和二叉树很相似:

二叉树是每个节点上有一个关键字和两个分支,B-tree 上每个节点有 k 个关键字和 (k + 1) 个分支。

二叉树的查找只考虑向左还是向右走,而 B-tree 中需要由多个分支决定。

B-tree 的查找分两步:

首先查找节点,由于 B-tree 通常是在磁盘上存储的所以这步需要进行磁盘IO操作;查找关键字,当找到某个节点后将该节点读入内存中然后通过顺序或者折半查找来查找关键字。若没有找到关键字,则需要判断大小来找到合适的分支继续查找。

操作流程

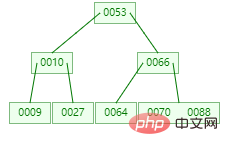
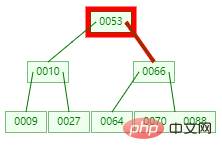
现在需要查找元素:88

第一次:磁盘IO
终于理解 MySQL 索引要用 B+tree ,而且还这么快

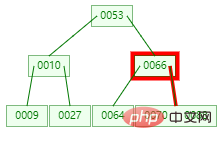
第二次:磁盘IO

终于理解 MySQL 索引要用 B+tree ,而且还这么快

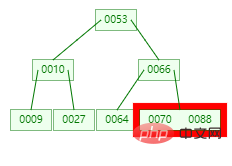
第三次:磁盘IO

然后这有一次内存比对,分别跟 70 与 88 比对,最后找到 88。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

从查找过程中发现,B-tree 比对次数和磁盘IO的次数其实和二叉树相差不了多少,这么看来并没有什么优势。

但是仔细一看会发现,比对是在内存中完成中,不涉及到磁盘IO,耗时可以忽略不计。

另外 B-tree 中一个节点中可以存放很多的关键字(个数由阶决定),相同数量的关键字B-tree 中生成的节点要远远少于二叉树中的节点,相差的节点数量就等同于磁盘IO的次数。这样到达一定数量后,性能的差异就显现出来了。

插入

B-tree 要进行插入关键字时,都是直接找到叶子节点进行操作。

根据要插入的关键字查找到待插入的叶子节点;因为一个节点的子节点的最大个数(阶)为 m,所以需要判断当前节点关键字的个数是否小于 (m – 1)。是:直接插入否:发生节点分裂,以节点的中间的关键字将该节点分为左右两部分,中间的关键字放到父节点中即可。

操作流程

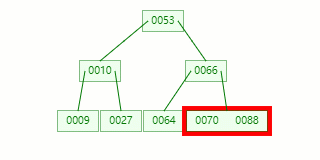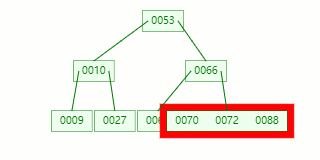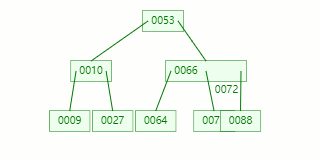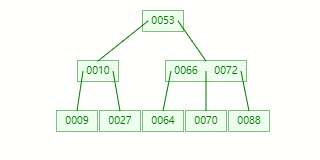
比如我们现在需要在 Max Degree(阶)为 3 的 B-tree 插入元素:72

查找待插入的叶子节点
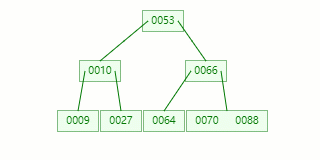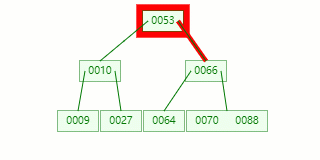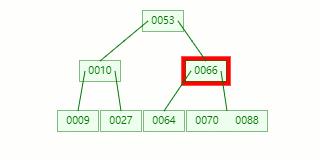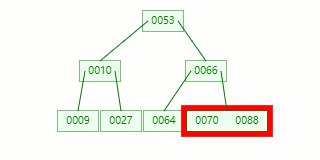
终于理解 MySQL 索引要用 B+tree ,而且还这么快

节点分裂:本来应该和 [70,88] 在同一个磁盘块上,但是当一个节点有 3 个关键字的时候,它就有可能有 4 个子节点,就超过了我们所定义限制的最大度数 3,所以此时必须进行分裂:以中间关键字为界将节点一分为二,产生一个新节点,并把中间关键字上移到父节点中。
终于理解 MySQL 索引要用 B+tree ,而且还这么快

Tip : 当中间关键字有两个时,通常将左关键字进行上移分裂。

删除

删除操作就会比查找和插入要麻烦一些,因为要被删除的关键字可能在叶子节点上,也可能不在,而且删除后还可能导致 B-tree 的不平衡,又要进行合并、旋转等操作去保持整棵树的平衡。

随便拿棵树(5 阶)举例子

以上就是终于理解 MySQL 索引要用 B+tree ,而且还这么快的详细内容,更多请关注创想鸟其它相关文章!

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 chuangxiangniao@163.com 举报,一经查实,本站将立刻删除。
发布者:程序猿,转转请注明出处:https://www.chuangxiangniao.com/p/190862.html

(0)
打赏 微信扫一扫 微信扫一扫 支付宝扫一扫 支付宝扫一扫

一加9pro怎样设置透明壁纸_一加9pro设置透明壁纸方法
上一篇 2026年9月7日 05:52:47
下一篇 2026年9月7日 05:56:39

相关推荐

  • mysql如何排查排序异常

    排查MySQL排序异常需先确认ORDER BY是否生效,检查子查询、UNION及应用层逻辑是否覆盖排序;通过EXPLAIN分析是否使用索引排序,避免Using filesort;确保字段类型、字符集和排序规则(collation)符合预期,处理NULL值和大小写敏感性;关注sort_buffer_s…

    2026年9月21日
    000
  • avg计算平均值在mysql中如何使用

    AVG()是MySQL中计算列平均值的聚合函数,忽略NULL值。基本语法为SELECT AVG(列名) FROM 表名;可结合WHERE筛选条件,如SELECT AVG(score) FROM students WHERE subject = ‘math’ AND score…

    2026年9月21日
    000
  • Flyway配置中安全使用环境变量的实践指南

    flyway配置中直接暴露数据库连接参数存在安全隐患。本文详细阐述了如何通过命令行参数和api调用两种主要方式,将环境变量安全地集成到flyway配置流程中。通过外部化管理敏感信息,可以有效提升数据库迁移配置的安全性、灵活性和可维护性,避免将凭证硬编码到配置文件中。 在数据库迁移实践中,将敏感的数据…

    2026年9月21日
    100
  • MySQL缓存机制对性能提升的作用_MySQL缓存配置及调优方案

    MySQL缓存机制对性能提升的作用_MySQL缓存配置及调优方案MySQL缓存机制对性能提升的作用_MySQL缓存配置及调优方案MySQL缓存机制对性能提升的作用_MySQL缓存配置及调优方案MySQL缓存机制对性能提升的作用_MySQL缓存配置及调优方案

    mysql的缓存机制主要包括innodb缓冲池、查询缓存和操作系统文件系统缓存等,其中innodb缓冲池是性能优化的核心。1. innodb缓冲池缓存表数据和索引页,减少磁盘i/o,提升读写效率;2. 查询缓存因失效频繁及锁竞争问题,在高并发场景下易成瓶颈,已在mysql 8.0中移除;3. 操作系…

    2026年9月21日 用户投稿
    100
  • MySQL全文搜索如何与外部引擎结合_提升搜索体验?

    MySQL全文搜索如何与外部引擎结合_提升搜索体验?MySQL全文搜索如何与外部引擎结合_提升搜索体验?MySQL全文搜索如何与外部引擎结合_提升搜索体验?MySQL全文搜索如何与外部引擎结合_提升搜索体验?

    mysql 的全文搜索在中文分词和复杂查询上存在局限,常结合外部引擎提升性能。1. 使用 elasticsearch,通过 logstash 或 canal 同步数据,安装中文分词插件并利用布尔查询等优化搜索。2. 利用 sphinx,从 mysql 直接构建索引,通过 sql-like 接口和中文…

    2026年9月21日 用户投稿
    100
  • 如何在Java中配置与数据库连接环境

    答案:Java中配置数据库连接需引入JDBC驱动,如MySQL在Maven中添加对应依赖;通过DriverManager或连接池(如HikariCP)获取Connection,使用try-with-resources管理资源;建议将连接参数存入properties文件,并处理常见问题如驱动加载、权限…

    2026年9月21日
    000
  • MySQL的binlog格式有哪些类型_它们有什么区别和影响?

    MySQL的binlog格式有哪些类型_它们有什么区别和影响?MySQL的binlog格式有哪些类型_它们有什么区别和影响?MySQL的binlog格式有哪些类型_它们有什么区别和影响?MySQL的binlog格式有哪些类型_它们有什么区别和影响?

    mysql的binlog有三种格式:statement-based(sbl)、row-based(rbl)和mixed-based(mbl),它们分别记录sql语句、行变更和智能混合方式。1. sbl记录执行的sql,优点是日志小、可读性强,但存在不确定性导致主从不一致;2. rbl记录每行的具体变…

    2026年9月21日 用户投稿
    300
  • MySQL性能模式监控资源_MySQL瓶颈定位精确工具

    MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具MySQL性能模式监控资源_MySQL瓶颈定位精确工具

    mysql性能模式通过事件记录精准定位瓶颈,核心步骤包括:1.启用并配置performance schema,选择性开启消费者和仪器;2.监控等待事件、sql语句、阶段、i/o、内存及锁等关键指标;3.分析events_waits_summary_global_by_event_name等表识别资源…

    2026年9月21日 用户投稿
    000
  • PHP PDO lastInsertId() 返回 0 的原因与解决方案

    在使用 PHP PDO 的 lastInsertId() 方法时,如果意外返回 0,通常是因为在执行 INSERT 语句后,又创建了一个新的数据库连接实例来调用 lastInsertId()。lastInsertId() 依赖于在同一数据库会话中获取最后插入的自增 ID。本文将深入解析此问题,并提供…

    2026年9月21日
    500
  • 如何使用mysql设计客户信息管理项目

    答案:设计客户信息管理系统需先明确功能需求,再合理规划数据库结构。1. 根据客户需求划分模块,包括客户基本信息、分类、状态、跟进记录等;2. 创建核心表如customers、company_info、follow_ups和users,确保字段完整且符合业务逻辑;3. 在关键字段上建立索引以提升查询效…

    2026年9月21日
    400
  • Linux查看系统日志的常用命令

    答案是查看Linux日志需综合使用journalctl、dmesg、tail、grep等工具。journalctl用于systemd系统集中查询服务及内核日志,支持时间、优先级、字段等多维度过滤;dmesg专注内核启动与硬件问题;tail -f实时监控日志动态;cat、grep、less结合正则和管…

    用户投稿 2026年9月21日
    000
  • mysql如何实现后台管理系统

    答案:基于MySQL的%ignore_a_1%需设计用户、权限、日志等表结构,通过后端语言实现安全的CRUD接口与JWT认证,前端展示数据并控制权限,确保系统安全稳定。 实现一个基于 MySQL 的后台管理系统,核心是构建一个安全、稳定、可扩展的系统架构,将数据库作为数据存储层,配合后端语言和前端界…

    2026年9月21日
    000
  • mysql常用存储引擎有哪些

    InnoDB是现代MySQL应用的首选存储引擎,因其支持事务(ACID)、行级锁、外键约束、崩溃恢复和MVCC,适用于高并发、数据完整性要求高的OLTP场景;MyISAM虽读取快但仅支持表级锁且无事务和外键,适用于读多写少的简单场景,已逐渐被淘汰;Memory引擎将数据存于内存,速度快但易失,适合临…

    2026年9月21日
    000
  • MySQL数据库日志审计与合规性实现_保护敏感数据与满足法规需求

    MySQL数据库日志审计与合规性实现_保护敏感数据与满足法规需求MySQL数据库日志审计与合规性实现_保护敏感数据与满足法规需求MySQL数据库日志审计与合规性实现_保护敏感数据与满足法规需求MySQL数据库日志审计与合规性实现_保护敏感数据与满足法规需求

    mysql日志审计是合规性的基石,因为它提供了数据库操作的完整证据链,记录用户身份、操作类型和时间戳等关键信息,满足gdpr、hipaa等法规要求,并支持事后追溯与事前震慑。1. mysql自身提供错误日志、通用查询日志、慢查询日志和二进制日志,其中通用查询日志记录所有sql语句,二进制日志用于数据…

    2026年9月21日 用户投稿
    100
  • MySQL执行计划中的Extra字段代表什么_怎么看优化空间?

    MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?MySQL执行计划中的Extra字段代表什么_怎么看优化空间?

    在 mysql 查询优化中,执行计划的 extra 字段用于说明查询执行时的额外操作,常见的值包括:1. using filesort 表示需要额外排序,应尽量通过建立索引避免;2. using temporary 表示使用了临时表,常见于 group by 或复杂 join,需优化减少其使用;3.…

    2026年9月21日 用户投稿
    100
  • MySQL数据分库分表如何设计_避免性能瓶颈的方法?

    MySQL数据分库分表如何设计_避免性能瓶颈的方法?MySQL数据分库分表如何设计_避免性能瓶颈的方法?MySQL数据分库分表如何设计_避免性能瓶颈的方法?MySQL数据分库分表如何设计_避免性能瓶颈的方法?

    分库分表设计需注意分片键选择、分片数量控制、避免跨库查询及完善运维体系。一,优先选择高频查询字段作为分片键,如用户id,避免使用时间戳以防写热点;二,初期合理分片(如4~8库,每库4~8表),预留扩容空间并根据数据总量反推分片数;三,尽量避免跨库查询,可通过冗余数据、异步汇总或强制路由优化;四,配套…

    2026年9月21日 用户投稿
    100
  • MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本

    MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本MySQL用户权限体系配置思路_Sublime中编辑多用户分权管理脚本

    最小权限原则是mysql用户权限配置的核心,确保每个用户仅拥有必要权限以提升安全性与可维护性。1.明确需求:根据用户角色分配如只读、增删改查或结构修改权限;2.创建用户并编写sql脚本进行权限管理,替代手动输入命令,提高效率与一致性;3.使用sublime text等编辑器提升脚本编写效率,利用语法…

    2026年9月21日 用户投稿
    100
  • 事务隔离级别在mysql中如何应用

    MySQL提供四种事务隔离级别:READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ(默认)、SERIALIZABLE,依次增强数据一致性,分别用于平衡并发性能与脏读、不可重复读、幻读等问题;通过SELECT @@tx_isolation等命令可查看级别,S…

    2026年9月21日
    300
  • mysql数据库和表的关系是怎样

    数据库是表的集合,一个MySQL数据库可包含多个表,表依赖数据库存在,需先创建数据库才能建表,如CREATE DATABASE school;USE school;CREATE TABLE students;数据库实现数据隔离与管理,不同项目使用不同数据库,便于组织与权限控制。 MySQL数据库和表…

    2026年9月21日
    000
  • mysql如何调整字符集和排序规则

    答案是调整MySQL字符集和排序规则需分层级操作:先修改数据库默认设置,再转换表和字段,最后配置服务器参数。具体步骤为:使用ALTER DATABASE更改数据库默认字符集;用ALTER TABLE CONVERT TO转换表中所有字符型字段;通过MODIFY修改特定字段的字符集;在my.cnf中设…

    2026年9月21日
    000

发表回复

登录后才能评论
关注微信